
GPUMD NEP与GNEP训练流程
NEP与GNEP训练流程,包含终端命令、完整输入与集群实际算例。
阅读本篇目录
本文使用鸢算科技集群GPUMD 5.9.1实际运行结果。先下载全部实例与绘图脚本并解压,进入gpumd-examples目录。参考结果在cases,新运行放在work;不要在参考目录重复运行,让输出不断追加。
本篇做什么#
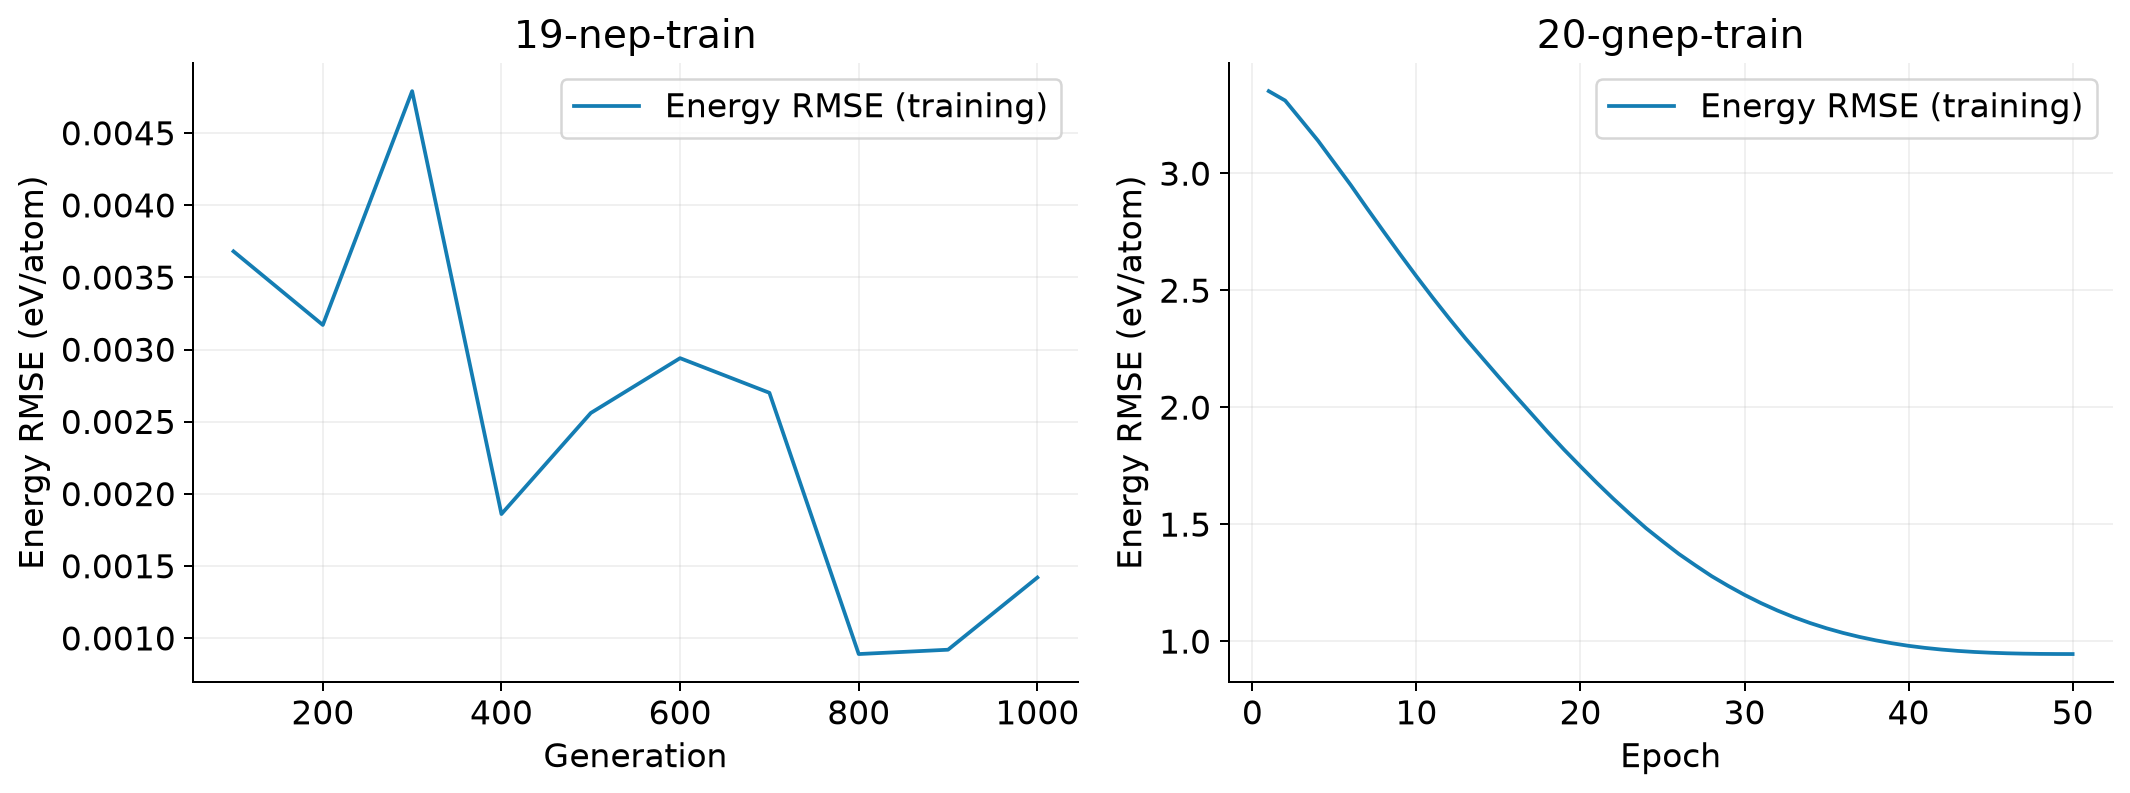
以同一Pb–Te数据展示nep和gnep两种训练入口,NEP运行1000代、GNEP运行50个epoch并绘制损失曲线。
1 准备算例#
python new-case.py 19-nep-train
cd work/19-nep-train
ls
附件中已包含结构与势文件,不需要自己输入几百行坐标。若要从自己的结构开始,请先阅读建模与输入文件。
本篇对应以下算例,每个都可以用python new-case.py 目录名单独建立工作副本。
| 目录 | 用途或变化 |
|---|---|
19-nep-train |
目录名标明温度、尺寸、随机种子或应变;完整输入见下方与附件 |
20-gnep-train |
目录名标明温度、尺寸、随机种子或应变;完整输入见下方与附件 |
2 查看和修改输入#
NEP的generation 1000用于短教程,GNEP改用gnep.in及epoch 50,type 2 Te Pb保持与数据和模型一致。训练前划分独立测试集并检查数据覆盖;本例演示训练流程,未建立独立泛化评估。
19-nep-train / nep.in
type 2 Te Pb
generation 1000
batch 1000
20-gnep-train / gnep.in
type 2 Te Pb
cutoff 8 4
n_max 4 4
basis_size 4 4
l_max 4
neuron 20
batch 16
epoch 50
seed 12345
NEP读取nep.in,GNEP读取gnep.in。GNEP示例的test.xyz与训练集相同,只用于演示输出流程;图中的误差不代表独立测试精度。
3 提交并检查进度#
sbatch run.sh
squeue -u "$USER"
tail -n 20 run.log
默认脚本用于V100核时队列。P100或套餐用户先运行yskit,选择复制Slurm脚本及匹配的用户类型、GPUMD版本、GPU型号。单进程启动,不要再套mpirun启动多个相同实例。
本例在计算节点执行的命令为:
nep > run.log 2>&1
这条命令已经在提交脚本内,平时只需sbatch run.sh。等待任务结束、查看日志,再读取结果。
4 查看结果和本次数据#
nep.txt是本次生成模型,loss.out记录训练误差。损失下降只说明优化过程,不代表势已适合生产。两种入口的随机初始化与算法细节不同,不用单次短训练结果作优劣排名。
head -n 12 loss.out
| 本次集群算例 | 实际数值摘要 |
|---|---|
19-nep-train |
能量RMSE (eV/atom):0.00141795;力RMSE (eV/Å):0.0703856 |
20-gnep-train |
能量RMSE (eV/atom):0.945539;力RMSE (eV/Å):0.309411 |
本次loss.out开头的数据(完整文件在附件中):
100      0.15566     0.02013     0.02390     0.00368       0.10795       0.00000       0.00000       0.00000       0.00000
200      0.15103     0.02112     0.02550     0.00317       0.10123       0.00000       0.00000       0.00000       0.00000
300      0.15198     0.02194     0.02680     0.00479       0.09845       0.00000       0.00000       0.00000       0.00000
400      0.14227     0.02275     0.02809     0.00186       0.08956       0.00000       0.00000       0.00000       0.00000
优先使用GPUMDkit工具#
任务完成后,在本篇算例输出目录执行:
module load gpumdkit/1.5.8
gpumdkit.sh -plt train save
gpumdkit.sh -plt train_density save
gpumdkit.sh -plt restart save
分别查看训练损失/对角线、误差密度与nep.restart参数分布。图示是本篇短训练数据,不能代表独立测试精度。
工具的其他用法见GPUMDkit专题。本篇自带plot.py用于结构图、统一版式和多个算例对照,保留原始数据与符号。
5 用自己的输出重新画图#
回到附件根目录,加载绘图环境:
cd ../..
module load ase/3.29.0
python plot.py --chapter nep-train --root work
本篇包含多个目录,需先完成上表全部算例,才能画完整对照图。
如果想先查看附件里的参考数据,执行python plot.py --chapter nep-train。生成的图片在相应根目录的figures中,脚本只读取数据,不修改结果。
换成自己的体系时#
先确认结构、元素和势函数适用范围,再确定温度、边界条件、时间步长与统计长度。随机初速度会使短程数值不同;复现时先比较数量级、趋势、能量稳定性和输出维度。正式研究应做势函数可靠性、尺寸与时间收敛检查。