
VASP GPU 加速专题五:加速参数选择
以六种Si规模比较KPAR与NSIM。
阅读本篇目录
申请更多 GPU 后,VASP 是否会更快,取决于能否把计算工作合理分配到每张卡。KPAR 决定 k 点怎样分组,NSIM 调整能带的批量处理;两者都需要结合实际 k 点数、能带数和 GPU 数量选择。
本指南用 Si 的 8、32、64、96、144、216 原子算例,展示 P100 和 V100 在单/双/四/八卡上的实测结果。覆盖 Γ 单点、较疏网格和较密网格三种常见工作量,提供 12 张时间图、结果讨论、参数速查表和可直接使用的操作方法。
1. 提交计算前,先确定这三件事#
先确定科学精度,再调并行参数。 结构、赝势、ENCUT、k 点密度和收敛要求应由研究问题决定;KPAR 和 NSIM 用来缩短完成这些计算所需的时间。不能为了让 GPU 更快而把所需的 k 点精度降低。
第一,查看 VASP 实际使用的 NKPTS 和 NBANDS,不要只看 KPOINTS 的网格乘积。
第二,明确本次使用几张 GPU:本集群标准 GPU 模板每卡对应 1 个 MPI 进程和 1 个 CPU 核心。
第三,按下表选择少量参数候选,再用自己的体系比较。
| 计算负载 | KPAR 的起始候选 | NSIM 的起始候选 | 优先观察什么 |
|---|---|---|---|
| Γ 单点,NKPTS=1 | 1 | 16、32;很小体系加测 4、8,大体系单卡加测 64 | 增加卡数是否仍能缩短时间 |
| k 点较多、单个 k 点的能带工作量较小 | 先试 KPAR=GPU 数量,再试较小的合法分组 | 16、32;小批量工作也可加测 8 | 分开计算 k 点能否减少组内通信 |
| k 点较少、能带工作量较大 | 四/八卡优先比较 1、2、4;条件允许再测 8 | 16、32,再按结果扩展到 8 或 64 | 每个 k 点组是否仍有足够的 GPU 共同计算 |
| 改了卡数、k 网格、材料或算法 | 按新工作量重新选择 | 在较优 KPAR 上重新比较 | 旧参数是否仍适合新的计算 |
表中的数值是试算候选。例如八卡、NKPTS=8 并不自动对应 KPAR=8:本指南的较大 Si 体系中,八卡经常以 KPAR=2 更快。NSIM=32 是方便比较的起点,也不是每个体系的最佳值。
2. KPAR 与 NSIM 怎样影响计算#
2.1 KPAR:把 MPI 进程分成若干 k 点组#
对于本文讨论的普通电子自洽计算,KPAR 表示 k 点并行组数。总 MPI 进程数为 P 时,每组包含 P/KPAR 个进程。VASP 将 k 点依次分配给这些组;同组进程共同处理分到的 k 点。
以八卡、八个 MPI 进程为例,KPAR=1 表示八个进程处于同一组;KPAR=2 表示两组、每组四个进程;KPAR=4 表示四组、每组两个进程;KPAR=8 表示八组、每组一个进程。增加 KPAR 可以让更多 k 点组同时推进,但也会减少每组参与计算的进程数。
| 使用 GPU 数量 | MPI 进程数 | 可整除进程数的 KPAR 候选 |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 1、2 |
| 4 | 4 | 1、2、4 |
| 8 | 8 | 1、2、4、8 |
选择时还要结合 NKPTS:Γ 单点使用 KPAR=1;普通多 k 点计算优先考虑不超过 NKPTS 的候选。KPAR 必须整除 MPI 进程数;NKPTS 能否整除 KPAR 则影响负载均衡。 例如 NKPTS=27、八卡时,KPAR=4 或 8 可以运行,但各组分到的 k 点数量不完全一致,不能把“不均分”理解为“参数非法”。
实际最优值是“多组同时推进”与“保留足够的组内计算能力”之间的选择。小晶胞、较多 k 点通常更适合较大的 KPAR;单个 k 点工作量较大时,保留多个 GPU 在同一组内协作可能更有利。第 4、6 节会用时间对照说明这种差异。
2.2 NSIM:调整同时处理的能带批量#
NSIM 控制同时处理的轨道/能带批量。它主要用于 RMM-DIIS,也参与 blocked-Davidson 的部分环节和力计算;本文 ALGO=Normal 的结果同样会受它影响。批量处理有助于使用矩阵运算,GPU 通常需要比较更大的 NSIM 候选。
NSIM 不是 MPI 进程数,也不是 CPU 线程数。增大它并不会增加 GPU 数量。较大的批量可能让 GPU 更有效地计算,也可能使当前分组下的批量安排和工作空间不再合适,所以耗时不一定随 NSIM 增大而持续下降。
对本文的 P100/V100 算例,16 和 32 是多数工作量值得先试的候选;小负载可比较 4、8,大体系的 Γ 单点单卡还值得比较 64。具体应该选哪个,需要在同一卡数、同一 KPAR下比较,不能把不同分组的时间差都归因于 NSIM。
2.3 查不可约 k 点:以 VASP 的输出为准#
6×6×6 网格有 216 个完整网格点,但经过对称性约简后,实际计算的 NKPTS 可能远小于 216。不同晶胞形状、原子位置、磁性和对称性设置都会改变约简结果。
已有同一计算设置的 OUTCAR 时,在计算目录执行:
grep -m1 -E 'NKPTS[[:space:]]*=' OUTCAR
grep -m1 -E 'NBANDS[[:space:]]*=' OUTCAR
也可以查看 IBZKPT 的第二行:
awk 'NR==2 {print "不可约k点数:", $1}' IBZKPT
应读取当前 POSCAR、POTCAR、KPOINTS 和磁性/对称性设置对应的输出。更换这些设置后,旧 OUTCAR 中的 NKPTS 不再能直接代表新计算。
3. 测试条件与读图方法#
3.1 这些时间对应怎样的计算#
| 项目 | 设置 |
|---|---|
| VASP 程序 | 普通版 6.6.1,vasp_std |
| 结构 | 金刚石 Si 的 8 原子常规晶胞扩胞,xyz 分别缩放 0.99/1/1.01,固定结构 |
| GPU | gcn001-8p100:P100 PCIe 16GB;gcn001-8v100-16g:V100 SXM2 16GB |
| 编译环境 | NVHPC 25.3、MKL 2023.2 和配套 MPI |
| 资源配置 | 1/2/4/8 卡,每卡 1 个 MPI 进程、1 个 CPU 核心,NCORE=1 |
| 运行条件 | 默认 GPU 通信设置;P100 250W、V100 300W 默认功耗上限 |
| 科学参数 | PAW_PBE Si 05Jan2001;ENCUT=350eV;ALGO=Normal;ISMEAR=0;SIGMA=0.1;LREAL=Auto;ISYM=2;非磁性、无 SOC |
| 比较工作量 | 固定结构静态计算,NELM=NELMIN=30,完成 30 个电子步 |
| 能带 | 同一原子规模的实际 NBANDS 保持一致;小体系保留了用于比较并行布局的额外空带 |
| 计时 | OUTCAR 中该次静态计算的 LOOP+ real time,包含电子自洽及力等后处理阶段,单位秒 |
图中的时间不是从程序启动到退出的总墙钟时间,也不是单个电子步时间。固定 30 步用于让参数比较具有一致工作量;生产计算仍应采用自己的收敛要求,不需要照搬 NELMIN=30。Γ 单点也使用 vasp_std,本指南不代表专用 vasp_gam 的性能。
3.2 原子数、k 点数和能带数需要一起看#
| 原子数 | 实际 NBANDS | Γ 网格 | Γ NKPTS | 疏网格 | 疏 NKPTS | 密网格 | 密 NKPTS |
|---|---|---|---|---|---|---|---|
| 8 | 56 | 1×1×1 | 1 | 6×6×6 | 64 | 8×8×8 | 125 |
| 32 | 112 | 1×1×1 | 1 | 6×3×3 | 16 | 8×4×4 | 45 |
| 64 | 168 | 1×1×1 | 1 | 3×3×3 | 8 | 4×4×4 | 27 |
| 96 | 280 | 1×1×1 | 1 | 3×3×2 | 8 | 4×4×3 | 18 |
| 144 | 392 | 1×1×1 | 1 | 3×2×2 | 8 | 4×3×3 | 12 |
| 216 | 560 | 1×1×1 | 1 | 2×2×2 | 8 | 3×3×3 | 8 |
较疏网格各方向 k×a 约 32.25~32.91Å,作为结构优化用途的采样示例;较密网格约 43.01~49.36Å,作为电子结构用途的采样示例。这两个范围用于说明测试工作量,不能代替具体材料的 k 点收敛测试。这里比较的是固定结构 SCF 阶段,并非一次完整结构优化或完整 DOS/能带工作流。
扩胞后原子数增加,但保持近似 k 点密度时,所需网格会变小,因此 NKPTS 不会与原子数一起增长。判断 GPU 是否有足够工作量时,应该同时看原子数、NBANDS 和 NKPTS。这也是 8 原子多 k 点算例与 8 原子 Γ 单点算例表现很不一样的原因。
3.3 怎样从图里选参数#
- 每张图包含六个原子规模;面板标题列出实际 NKPTS 和 NBANDS。
- KPAR 图固定 NSIM=32:横轴 KPAR、纵轴卡数,在同一行比较分组。Γ 单点图只有 KPAR=1,展示固定参数下的卡数变化。
- NSIM 图固定每行的卡数与 KPAR:例如“4卡/K2”表示四卡、KPAR=2,横向比较 NSIM=4/8/16/32/64。
- 数字和线性色标都表示秒,越浅表示越快。各面板独立设置色标范围,跨原子规模比较时应读数字,不能只比颜色深浅。
- 橙框表示该行已测有效候选中的最短时间;只有一个有效候选的行不框选。灰格“未测”没有数据,红格“失败”未通过完整计算检查,“—”表示该 KPAR 不适用于对应进程数。
以下讨论使用 992 条有效测量。每组配置只有一次有效测量,没有统计误差条;接近的时间应当视为近优候选。疏、密网格采用分阶段搜索,没有测遍所有组合,所以第 8 节给出的是最快已测候选,不是所有可能设置中的绝对最优值。
4. 较疏网格:大体系不必把每张卡都分成独立 k 点组#
这一档六种规模的 NKPTS 分别为 64、16、8、8、8、8。小晶胞有较多独立 k 点,而 64~216 原子体系只有八个实际 k 点,较大的工作量集中在每个 k 点的能带计算中。
4.1 KPAR 的结果:从大分组转向保留组内协作#
图 A1:P100 较疏网格 KPAR 实测耗时#
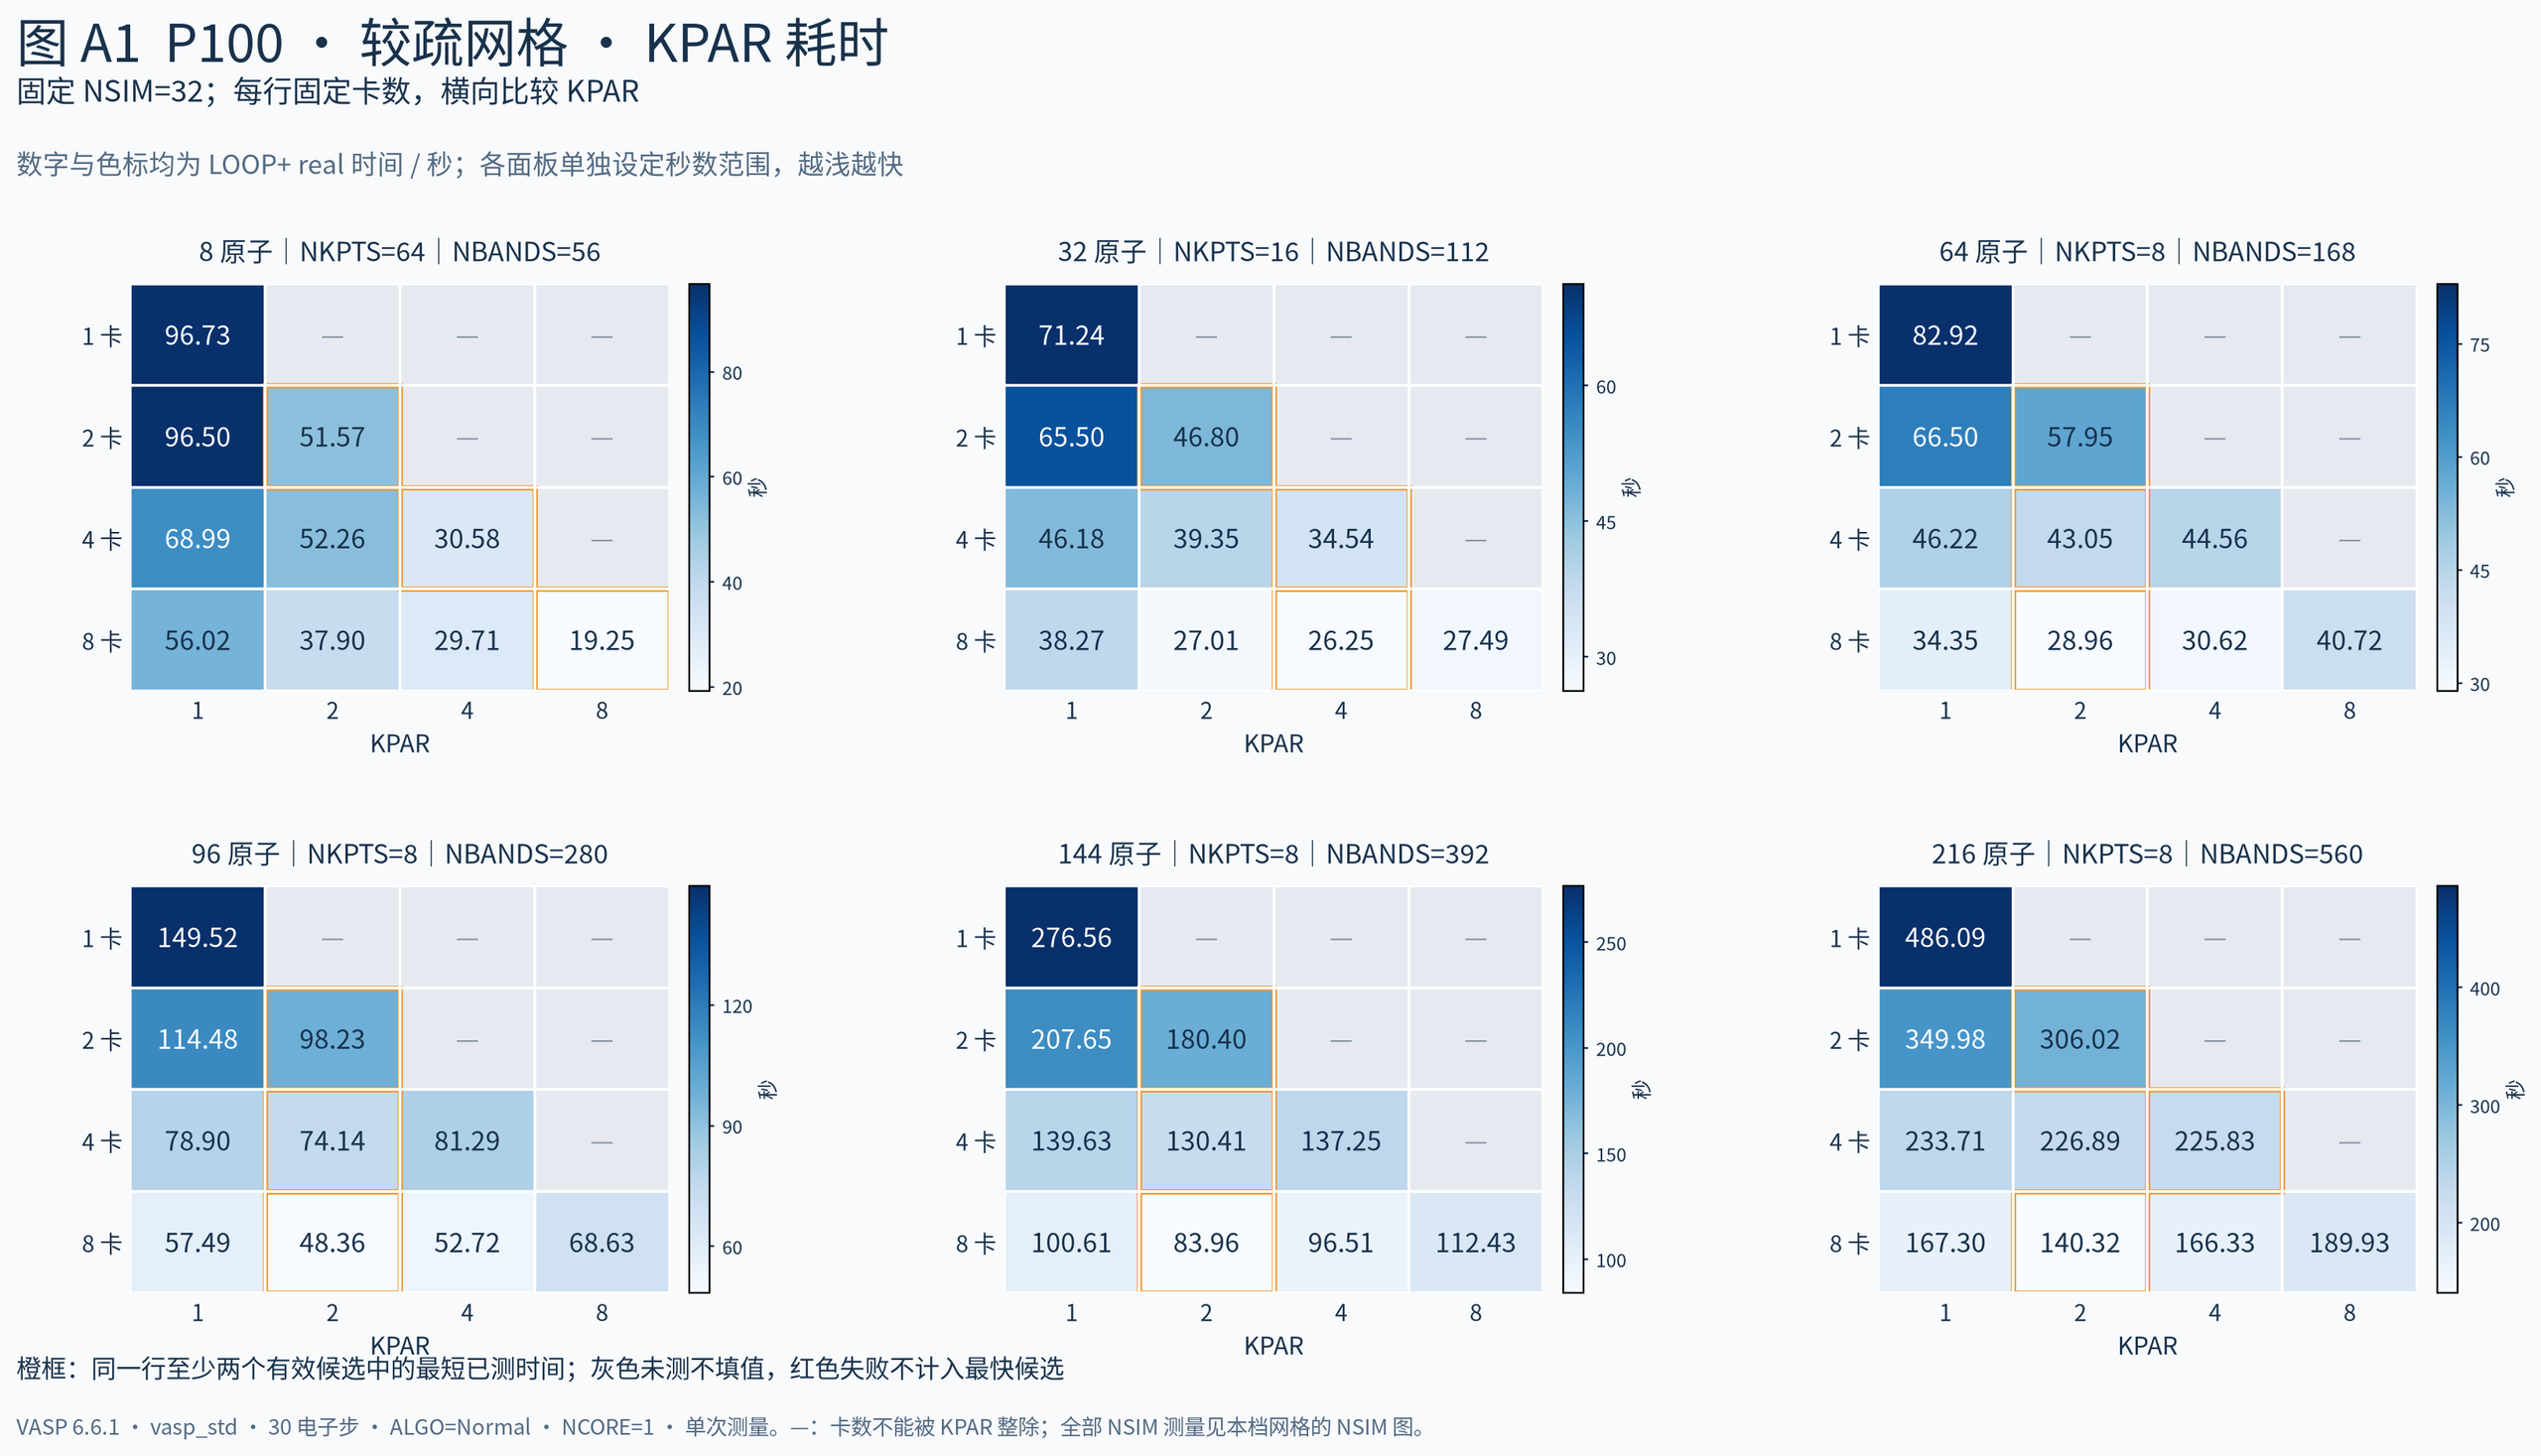
固定 NSIM=32,同一行比较不同 KPAR;数字与色标单位均为秒。
图 A2:V100 较疏网格 KPAR 实测耗时#
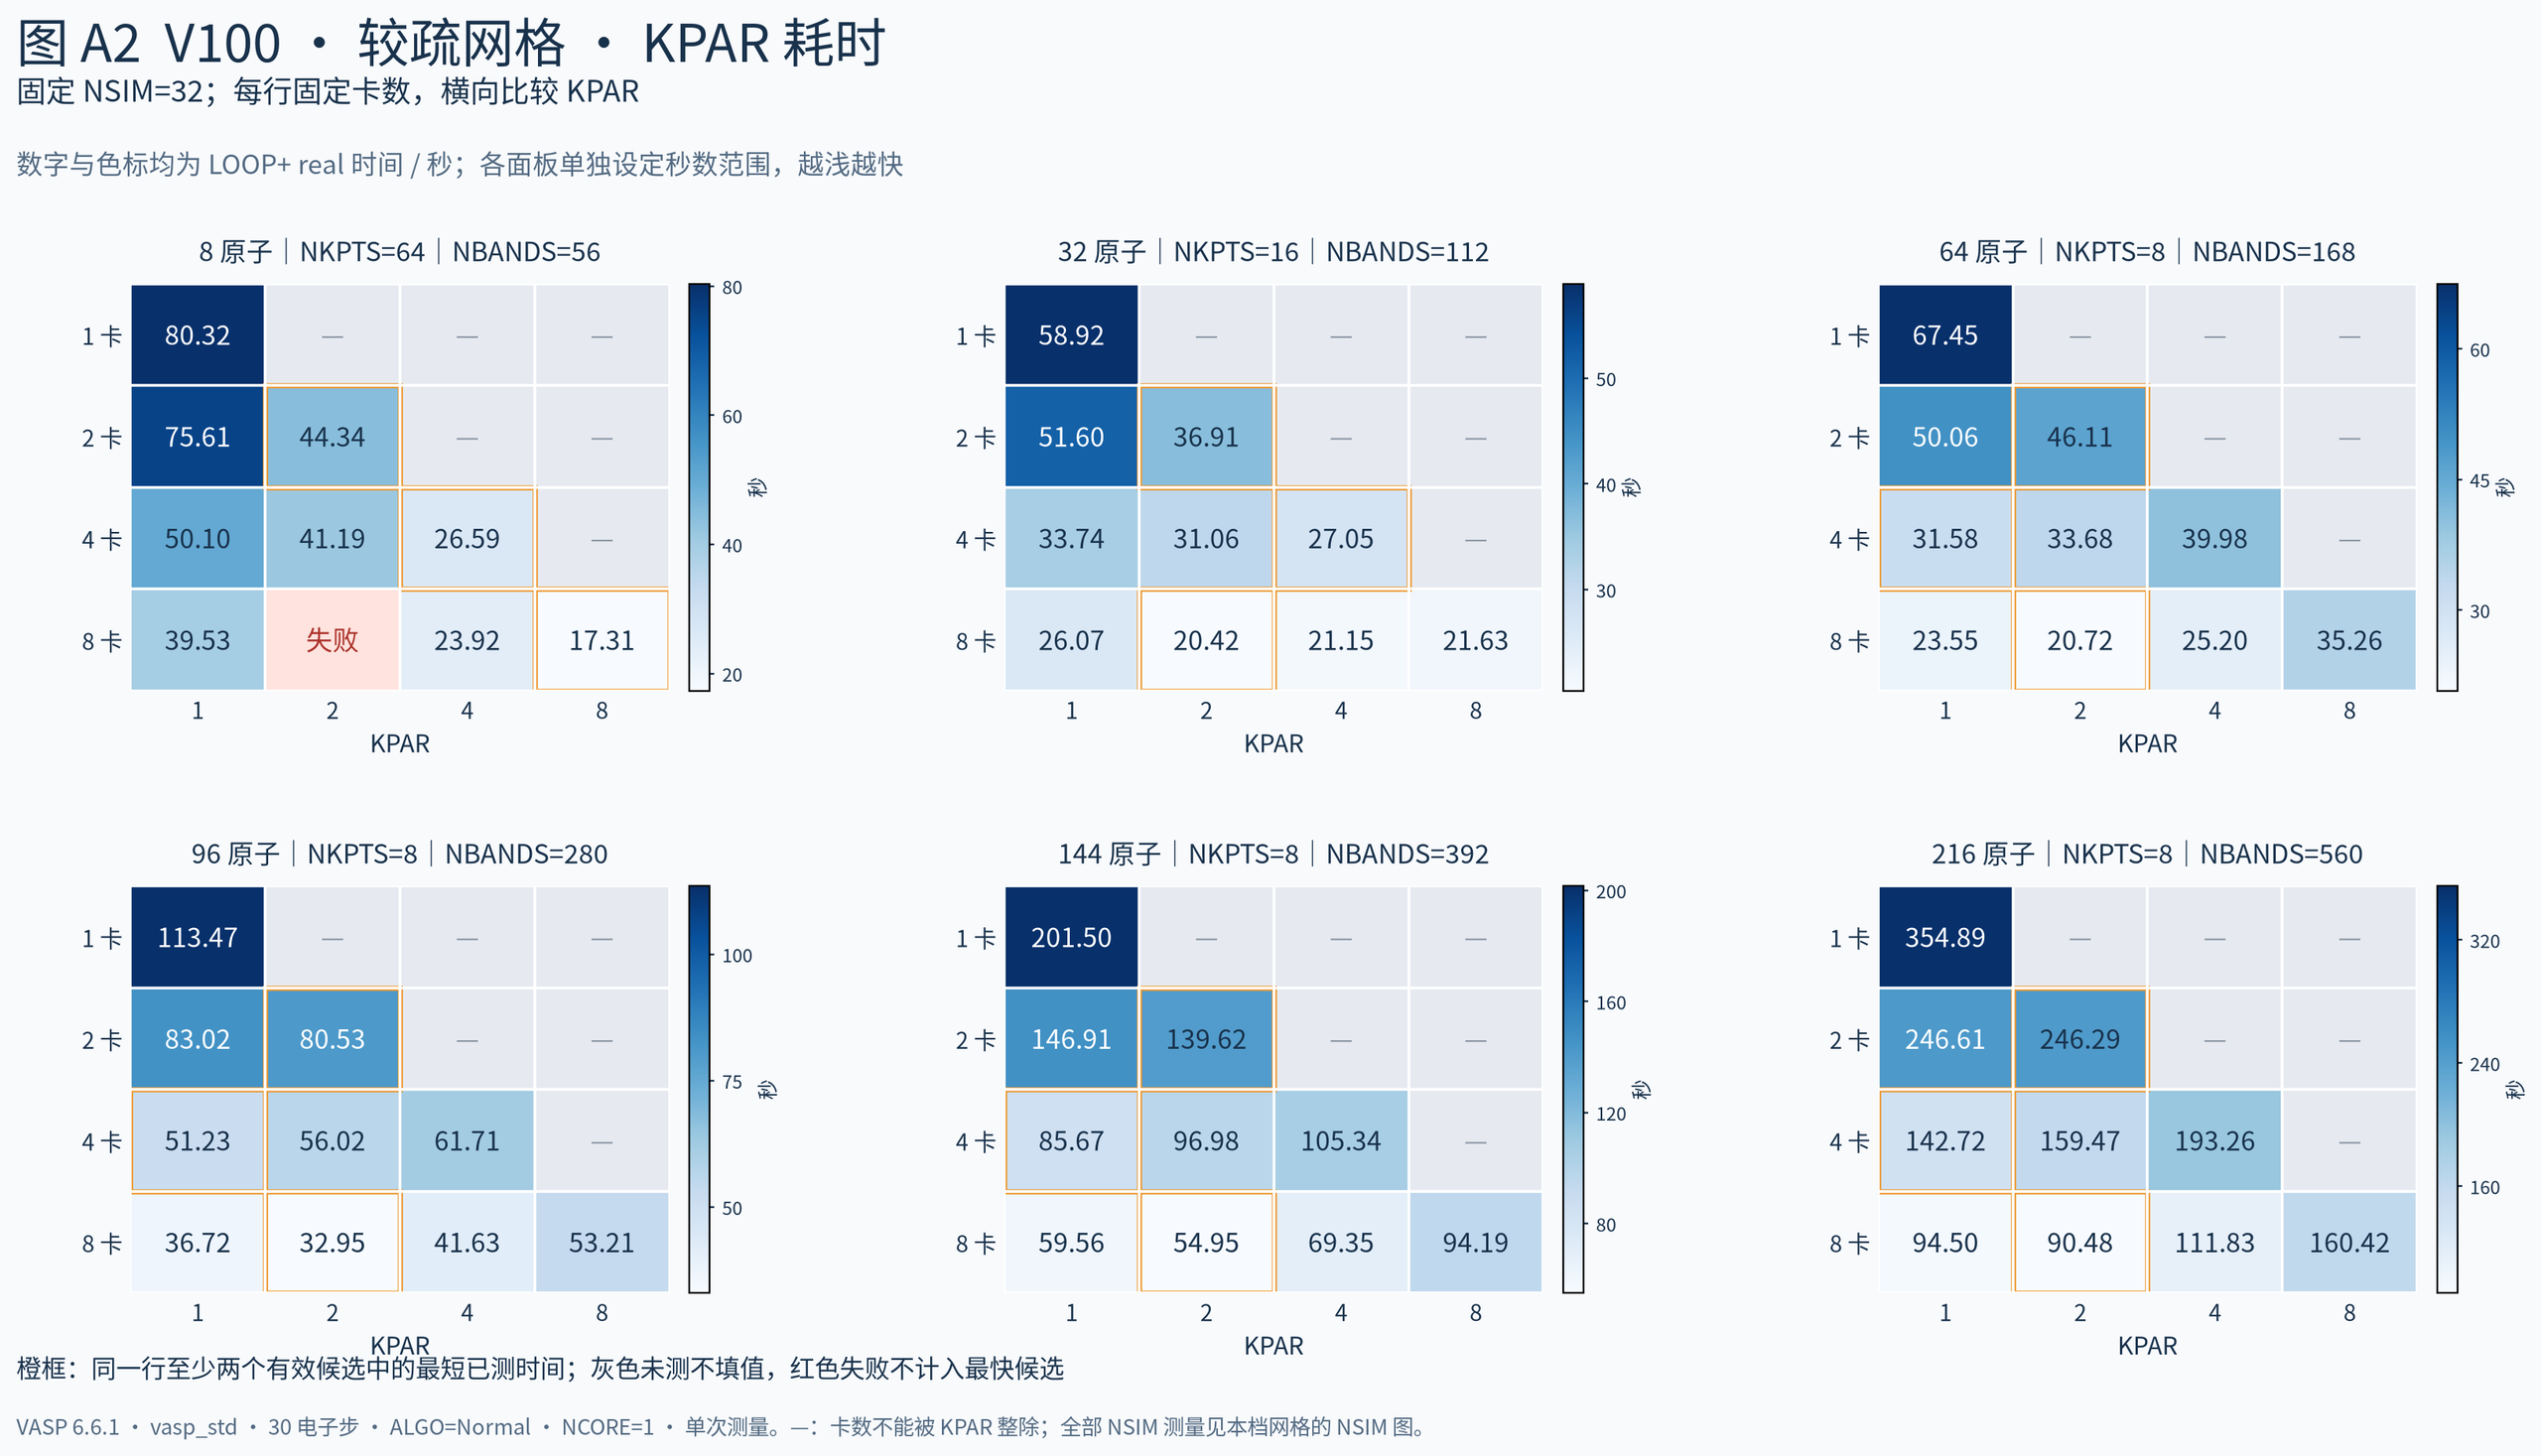
固定 NSIM=32,同一行比较不同 KPAR;数字与色标单位均为秒。
先看八卡、固定 NSIM=32 时,六种规模中时间最短的 KPAR:
| 原子数 | NKPTS | P100 八卡:KPAR;时间(秒) | V100 八卡:KPAR;时间(秒) |
|---|---|---|---|
| 8 | 64 | 8;19.25 | 8;17.31 |
| 32 | 16 | 4;26.25 | 2;20.42 |
| 64 | 8 | 2;28.96 | 2;20.72 |
| 96 | 8 | 2;48.36 | 2;32.95 |
| 144 | 8 | 2;83.96 | 2;54.95 |
| 216 | 8 | 2;140.32 | 2;90.48 |
8 原子:k 点多,较大的 KPAR 很有效。 NKPTS=64,P100 和 V100 在双/四/八卡上,固定 NSIM=32 的较优 KPAR 分别是 2/4/8。以八卡为例,P100 从 KPAR=1 的 56.02 秒降到 KPAR=8 的 19.25 秒;V100 对应为 39.53 秒和 17.31 秒。这里每组能够分到多个 k 点,分组收益很清楚。
32 原子:八卡时已经不需要一律选 KPAR=8。 NKPTS=16,双/四卡固定 NSIM=32 时,两种 GPU 都以 KPAR=2/4 较优;八卡则变为 P100 的 KPAR=4、V100 的 KPAR=2。继续增大 KPAR 并没有保持前面小晶胞的优势。对这类中间负载,应把 2 和 4 都纳入八卡候选。
64、96、144 原子:较小的 KPAR 成为主要候选。 这三个体系均为 NKPTS=8。固定 NSIM=32 时,P100 四卡以 KPAR=2 较优,V100 四卡以 KPAR=1 较优;两种 GPU 的八卡都以 KPAR=2 较优。原子规模增大以后,为每个 k 点保留更多组内进程,比把每个 k 点拆到单卡上更合适。
216 原子:八卡上仍以 KPAR=2 更快。 八卡、NSIM=32 下,P100 的 KPAR=1/2/4/8 分别用时 167.30/140.32/166.33/189.93 秒;V100 分别为 94.50/90.48/111.83/160.42 秒。两种平台都应优先比较 KPAR=1、2,而不是因为“八卡、八个 k 点”就直接采用 8。
这些结果说明,KPAR 的选择不能只看 NKPTS 能否被卡数整除,还要看单个 k 点的计算量。 从分组方式看,KPAR=2 在八卡上保留了每组四个进程,KPAR=8 则每组只有一个进程。实测趋势与这种计算分配差异一致;这些计时本身并未进一步分解通信、FFT 和矩阵计算各占多少时间。
4.2 NSIM 的结果:16/32 常见,较小批量也有适用场景#
图 A3:P100 较疏网格 NSIM 实测耗时#
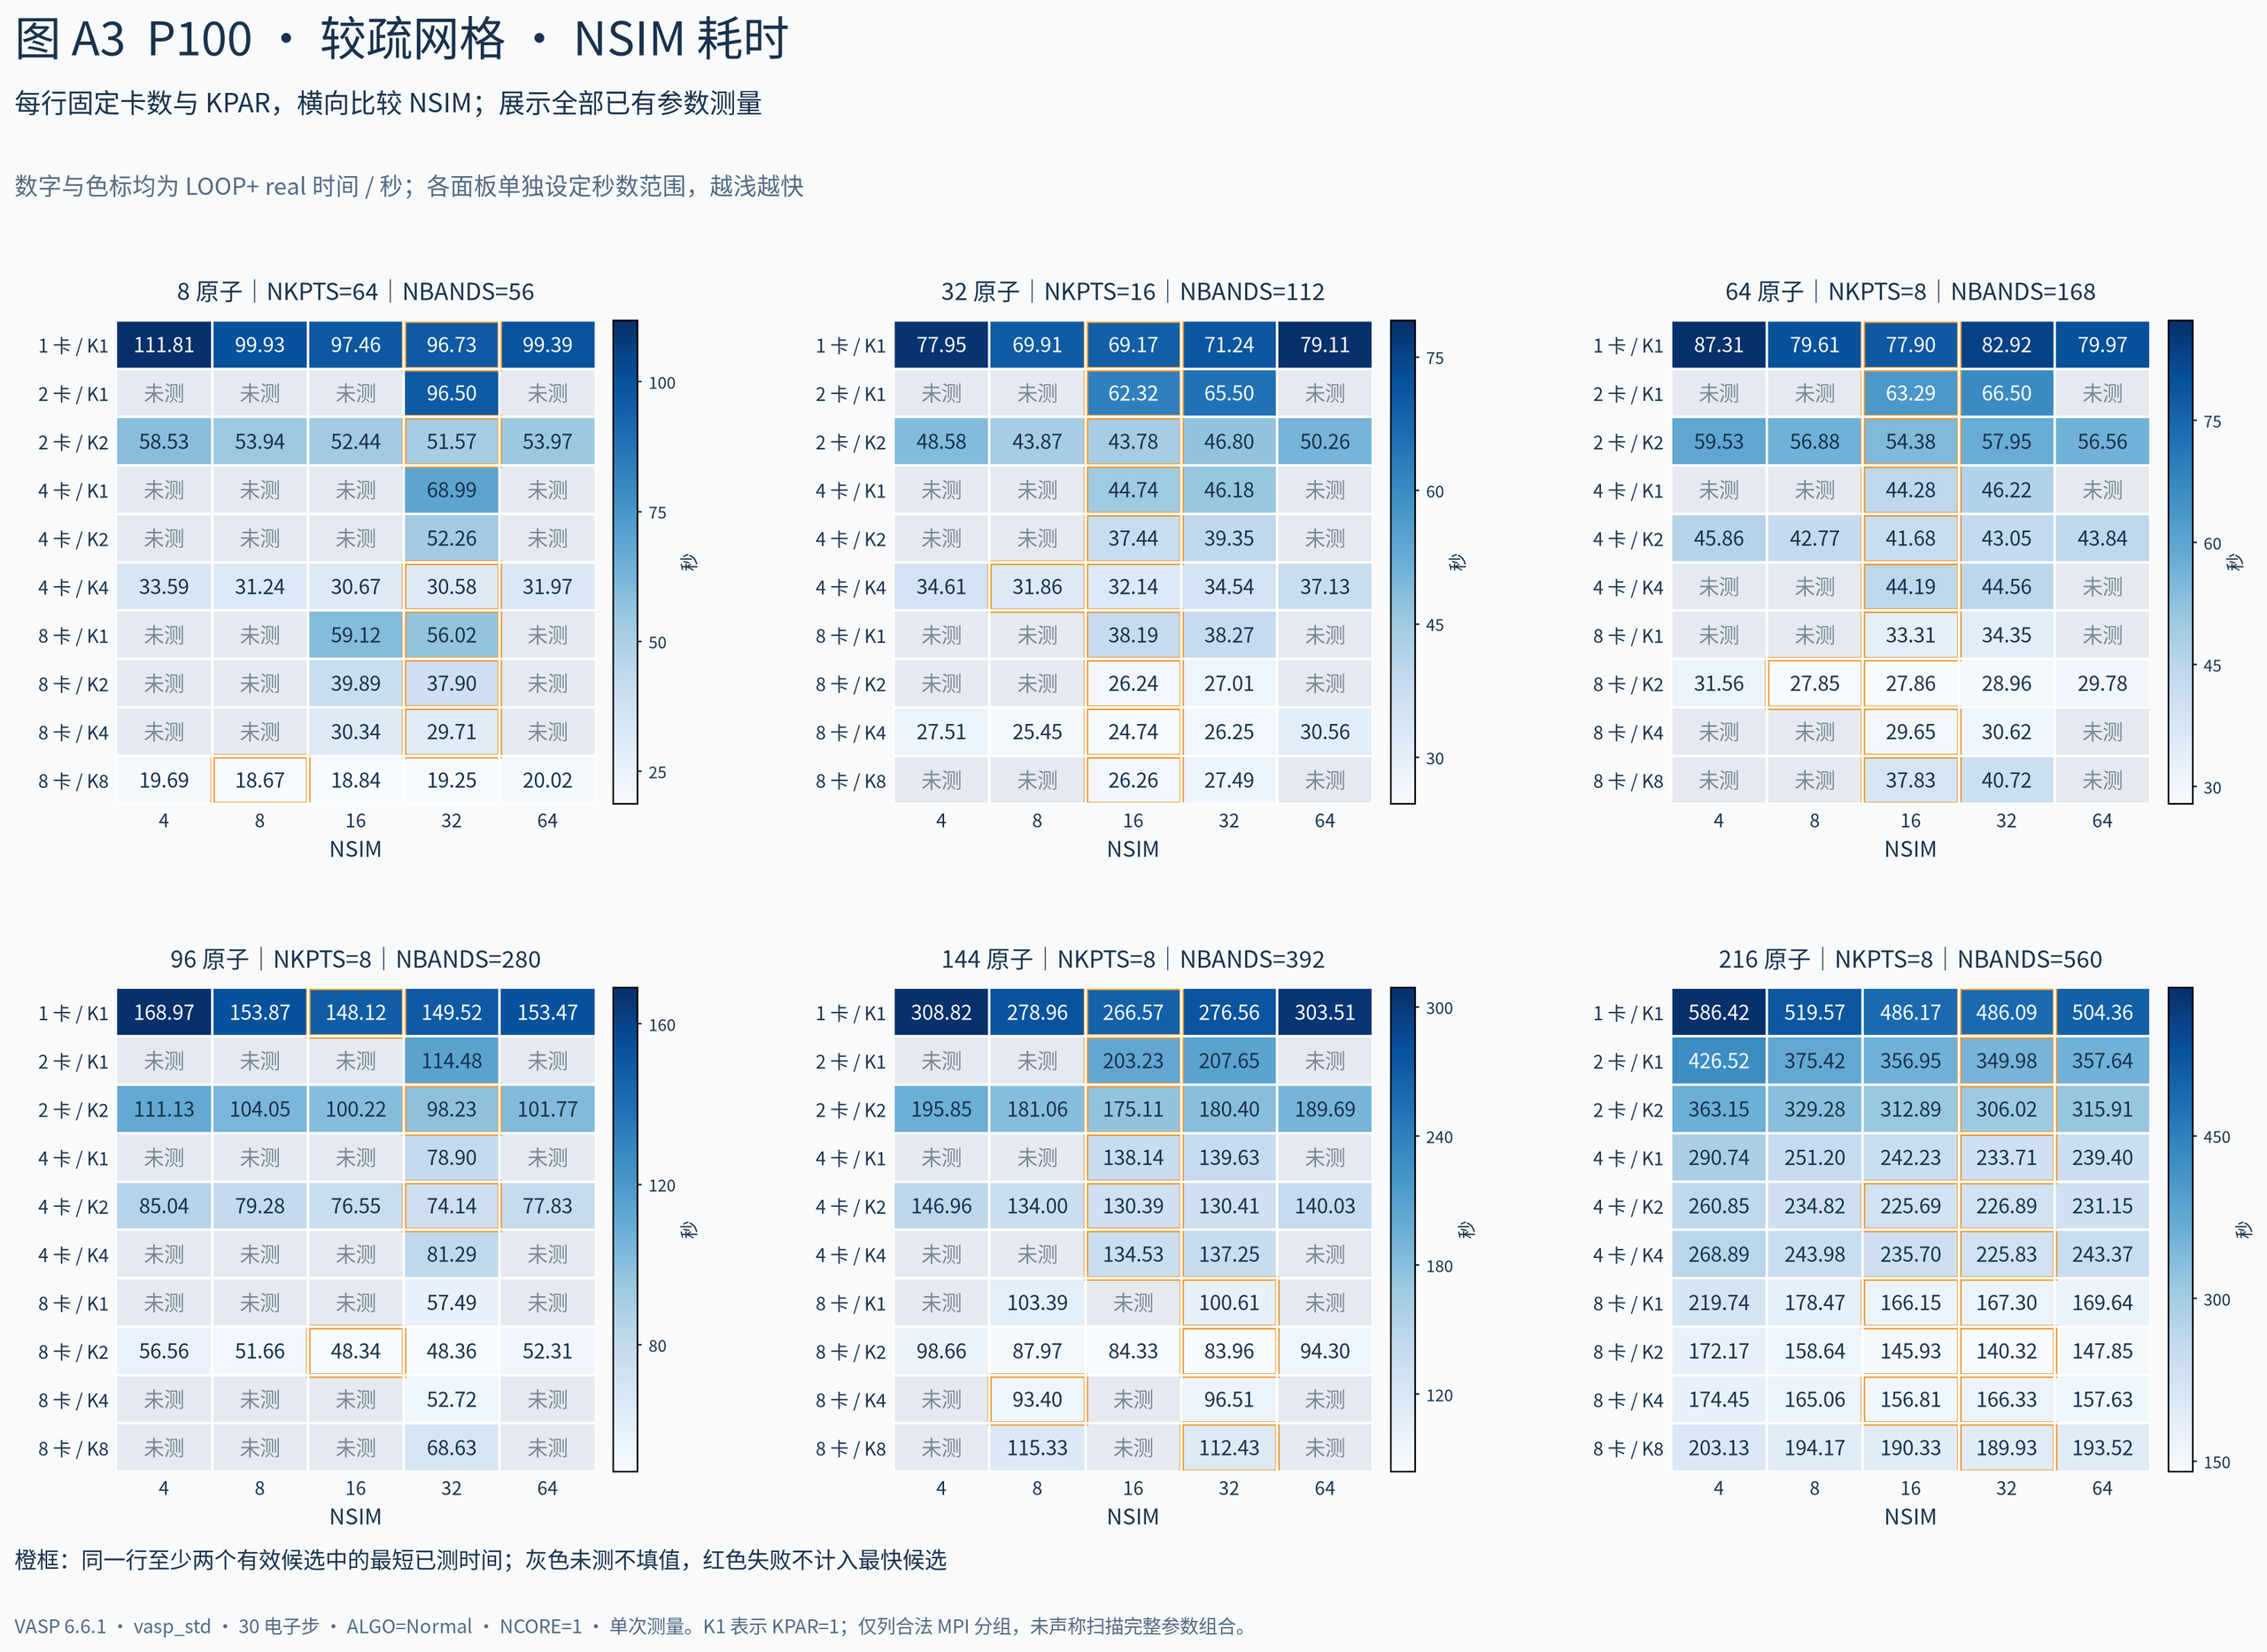
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
图 A4:V100 较疏网格 NSIM 实测耗时#
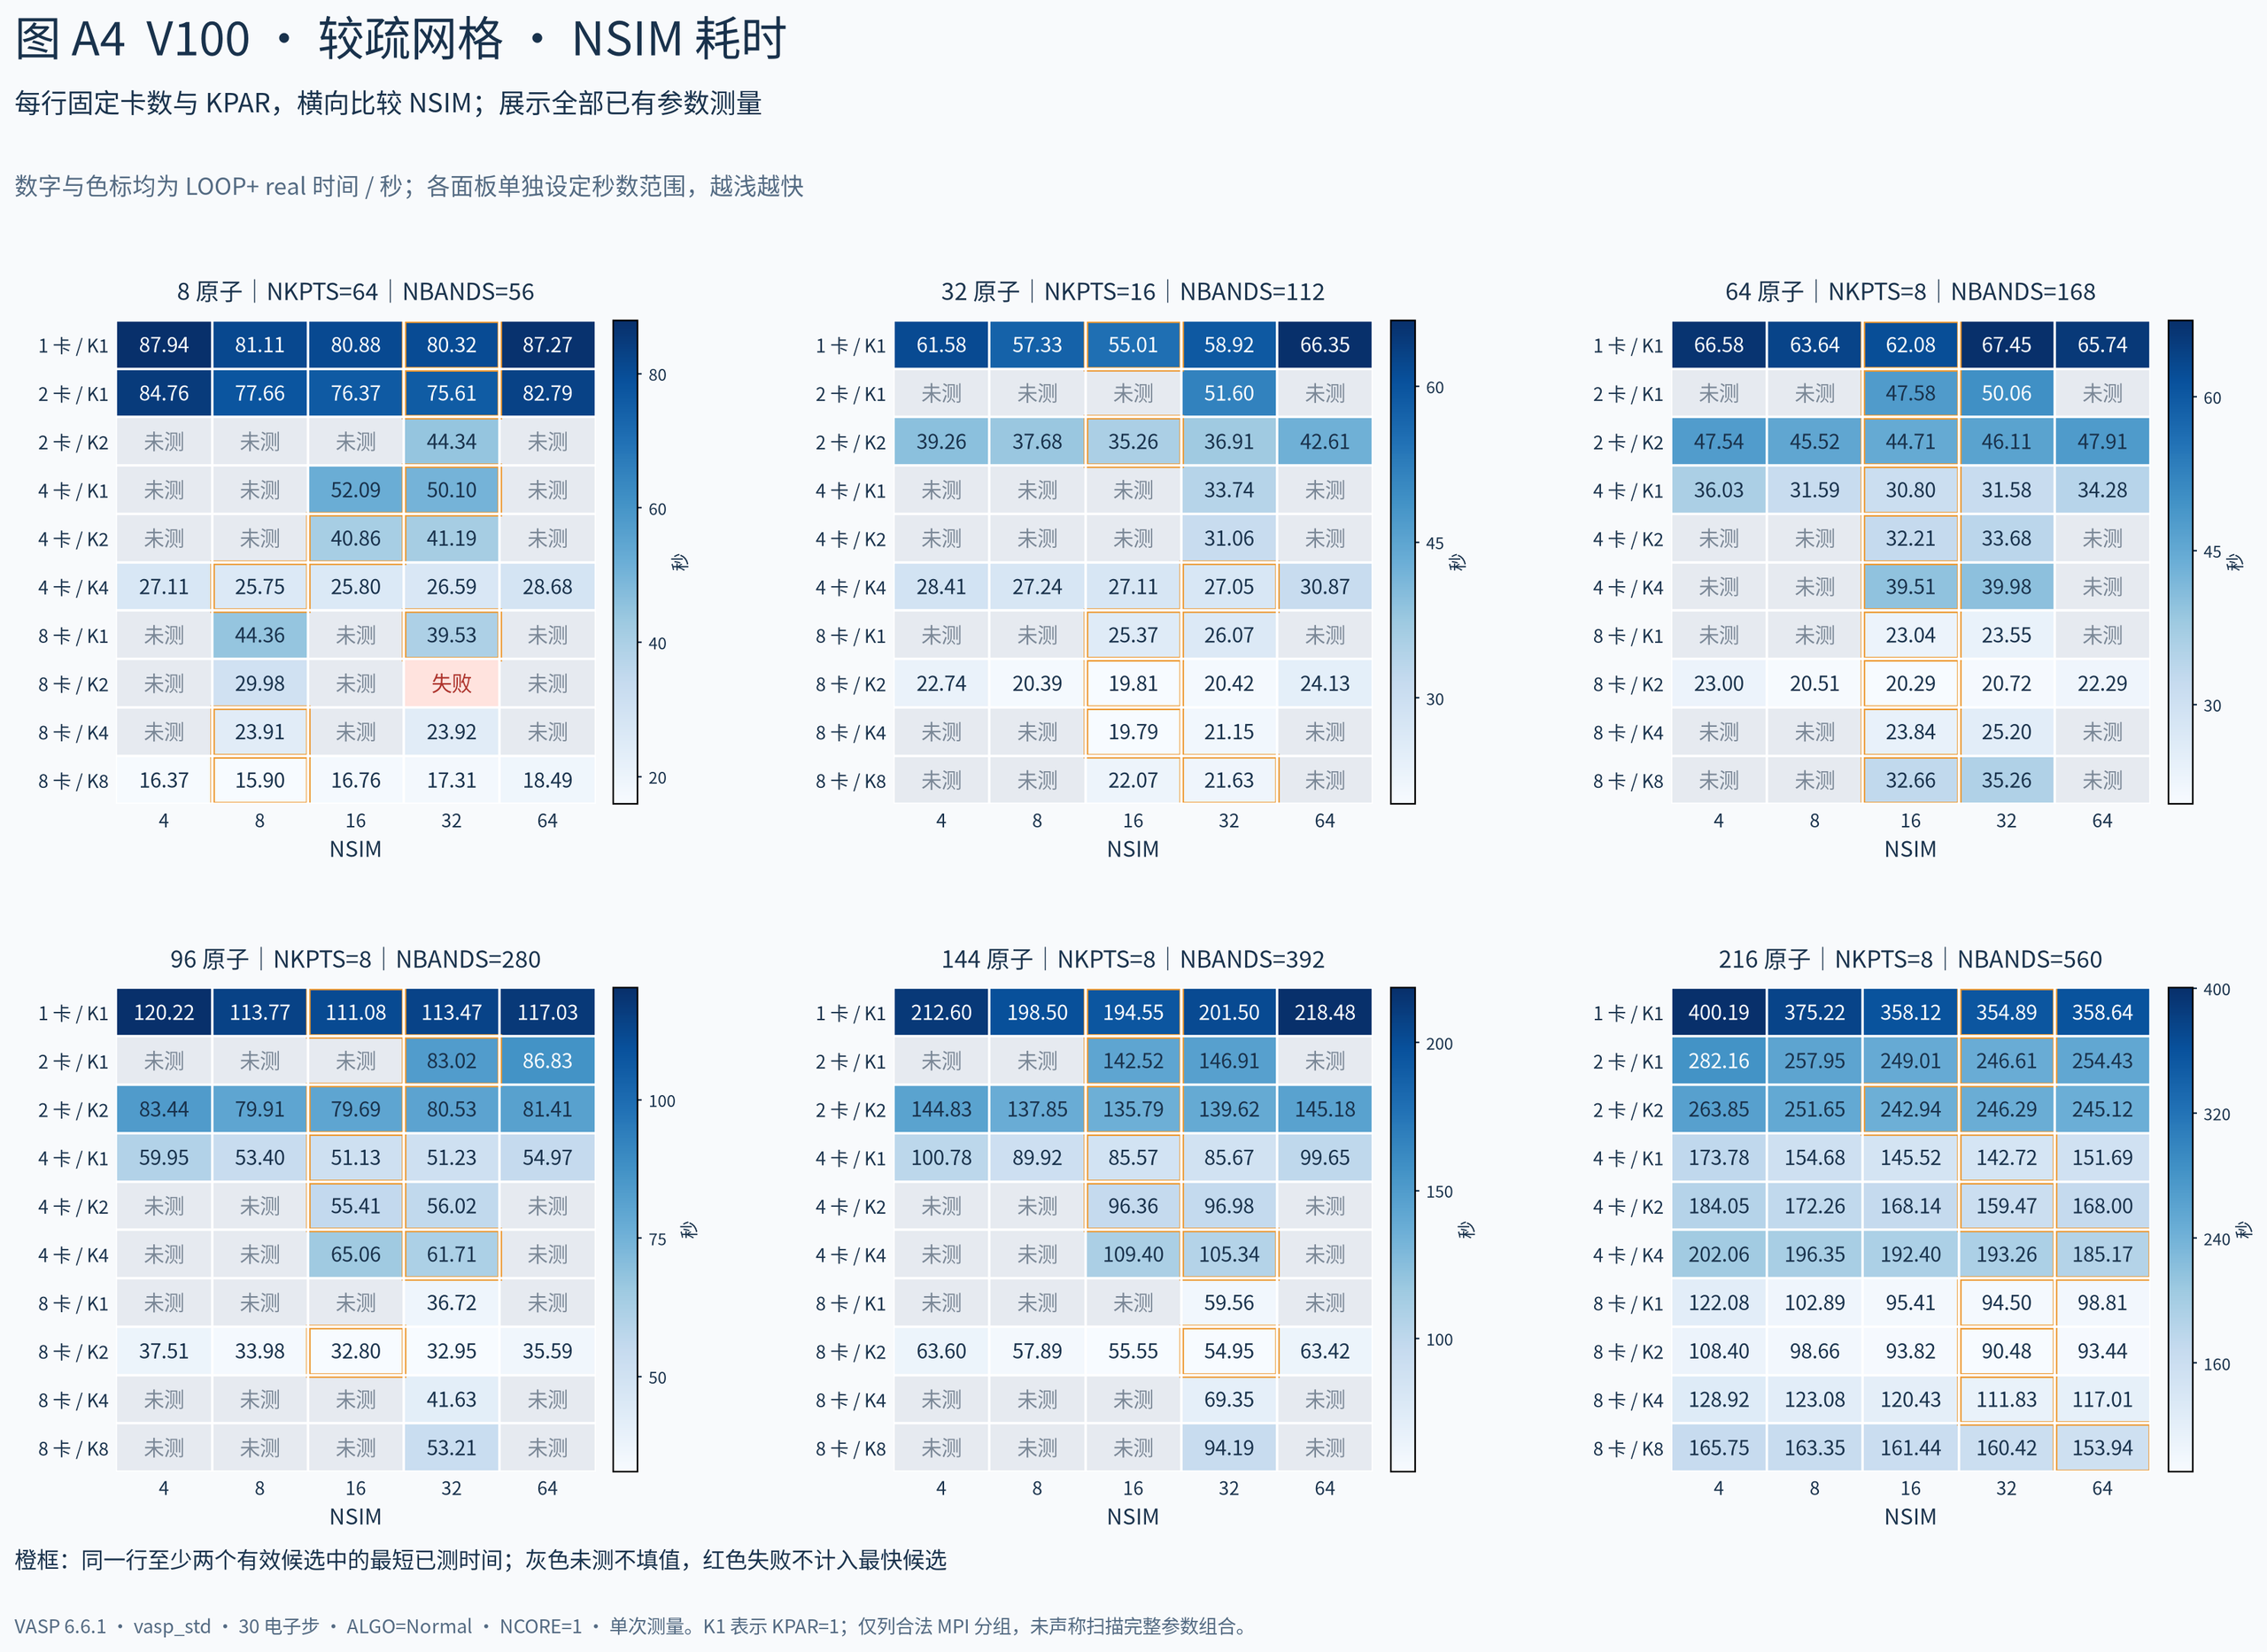
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
小体系多卡时,NSIM=8 值得试。 8 原子、八卡、KPAR=8 下,按 NSIM=4/8/16/32/64 的顺序,P100 用时 19.69/18.67/18.84/19.25/20.02 秒,V100 用时 16.37/15.90/16.76/17.31/18.49 秒。两种 GPU 都以 8 最短,直接从 32 增大到 64 反而更慢。这说明“GPU 一定要大 NSIM”需要结合当前工作量理解。
32、64 原子以中等批量为主,但不必固定一个值。 32 原子 P100 四卡最快已测配置是 KPAR=4、NSIM=8,31.86 秒;64 原子 P100 四卡则是 KPAR=2、NSIM=16,41.68 秒。V100 32 原子四卡的最快已测候选仍是 NSIM=32,64 原子四卡则是 NSIM=16。卡数相同并不意味着 NSIM 相同。
96、144 原子通常先比较 16 和 32。 96 原子 V100 八卡、KPAR=2 下,五个 NSIM 的时间为 37.51/33.98/32.80/32.95/35.59 秒,16 与 32 很接近,4 和 64 都没有优势。144 原子单/双卡的最快已测候选在两种平台上均为 NSIM=16,八卡则均为 32。选择时应按同一行的时间比较,而不是只沿原子数递增地调大 NSIM。
216 原子单卡中,NSIM=32 已经接近这一档的较优批量。 P100 单卡五个候选分别为 586.42/519.57/486.17/486.09/504.36 秒,V100 为 400.19/375.22/358.12/354.89/358.64 秒。4 明显偏慢,继续增大到 64 也没有超过 32。对这种工作量,可以先以 16/32 为中心,再向两侧试。
4.3 为什么调好 NSIM 后,还要回头检查 KPAR#
KPAR 图固定的是 NSIM=32,而最终参数表是在全部有效候选中选择,两者回答不同的问题。例如 32 原子 V100 八卡,固定 NSIM=32 时 KPAR=2 用时 20.42 秒;联合比较后,KPAR=4、NSIM=16 的 19.79 秒更短。因此,先选 KPAR、再选 NSIM 后,还应使用选出的 NSIM 复核相邻 KPAR。
216 原子 P100 四卡也说明了这种相互影响:NSIM=16 时,KPAR=2/4 为 225.69/235.70 秒;NSIM=32 时则为 226.89/225.83 秒。两组的排序会变化。最终 KPAR=2、NSIM=16 与 KPAR=4、NSIM=32 的差异只有约 0.14 秒,应把它们视为近优候选,避免把一次测量中的小差异当成稳定优势。
用于自己的较疏网格计算时: 小晶胞且 k 点多,可以从较大的合法 KPAR 开始;NKPTS 较少、能带较多的四/八卡任务,优先比较 KPAR=1、2、4,再围绕 NSIM=16、32 调整。P100 和 V100 应分别试算,不要只复制另一种卡的最佳组合。
5. Γ 单点:KPAR 固定为 1,卡数与 NSIM 决定剩余空间#
Γ 单点只有一个实际 k 点,无法通过增加 k 点组来获得并行收益。因此本节始终使用 KPAR=1,比较同一组内的多卡协作和 NSIM。图 A5、A6 只展示固定 NSIM=32 的卡数变化,不是多个 KPAR 的扫描。
5.1 卡数的结果:很小体系会较早达到收益上限#
图 A5:P100 Γ 单点 KPAR 实测耗时#
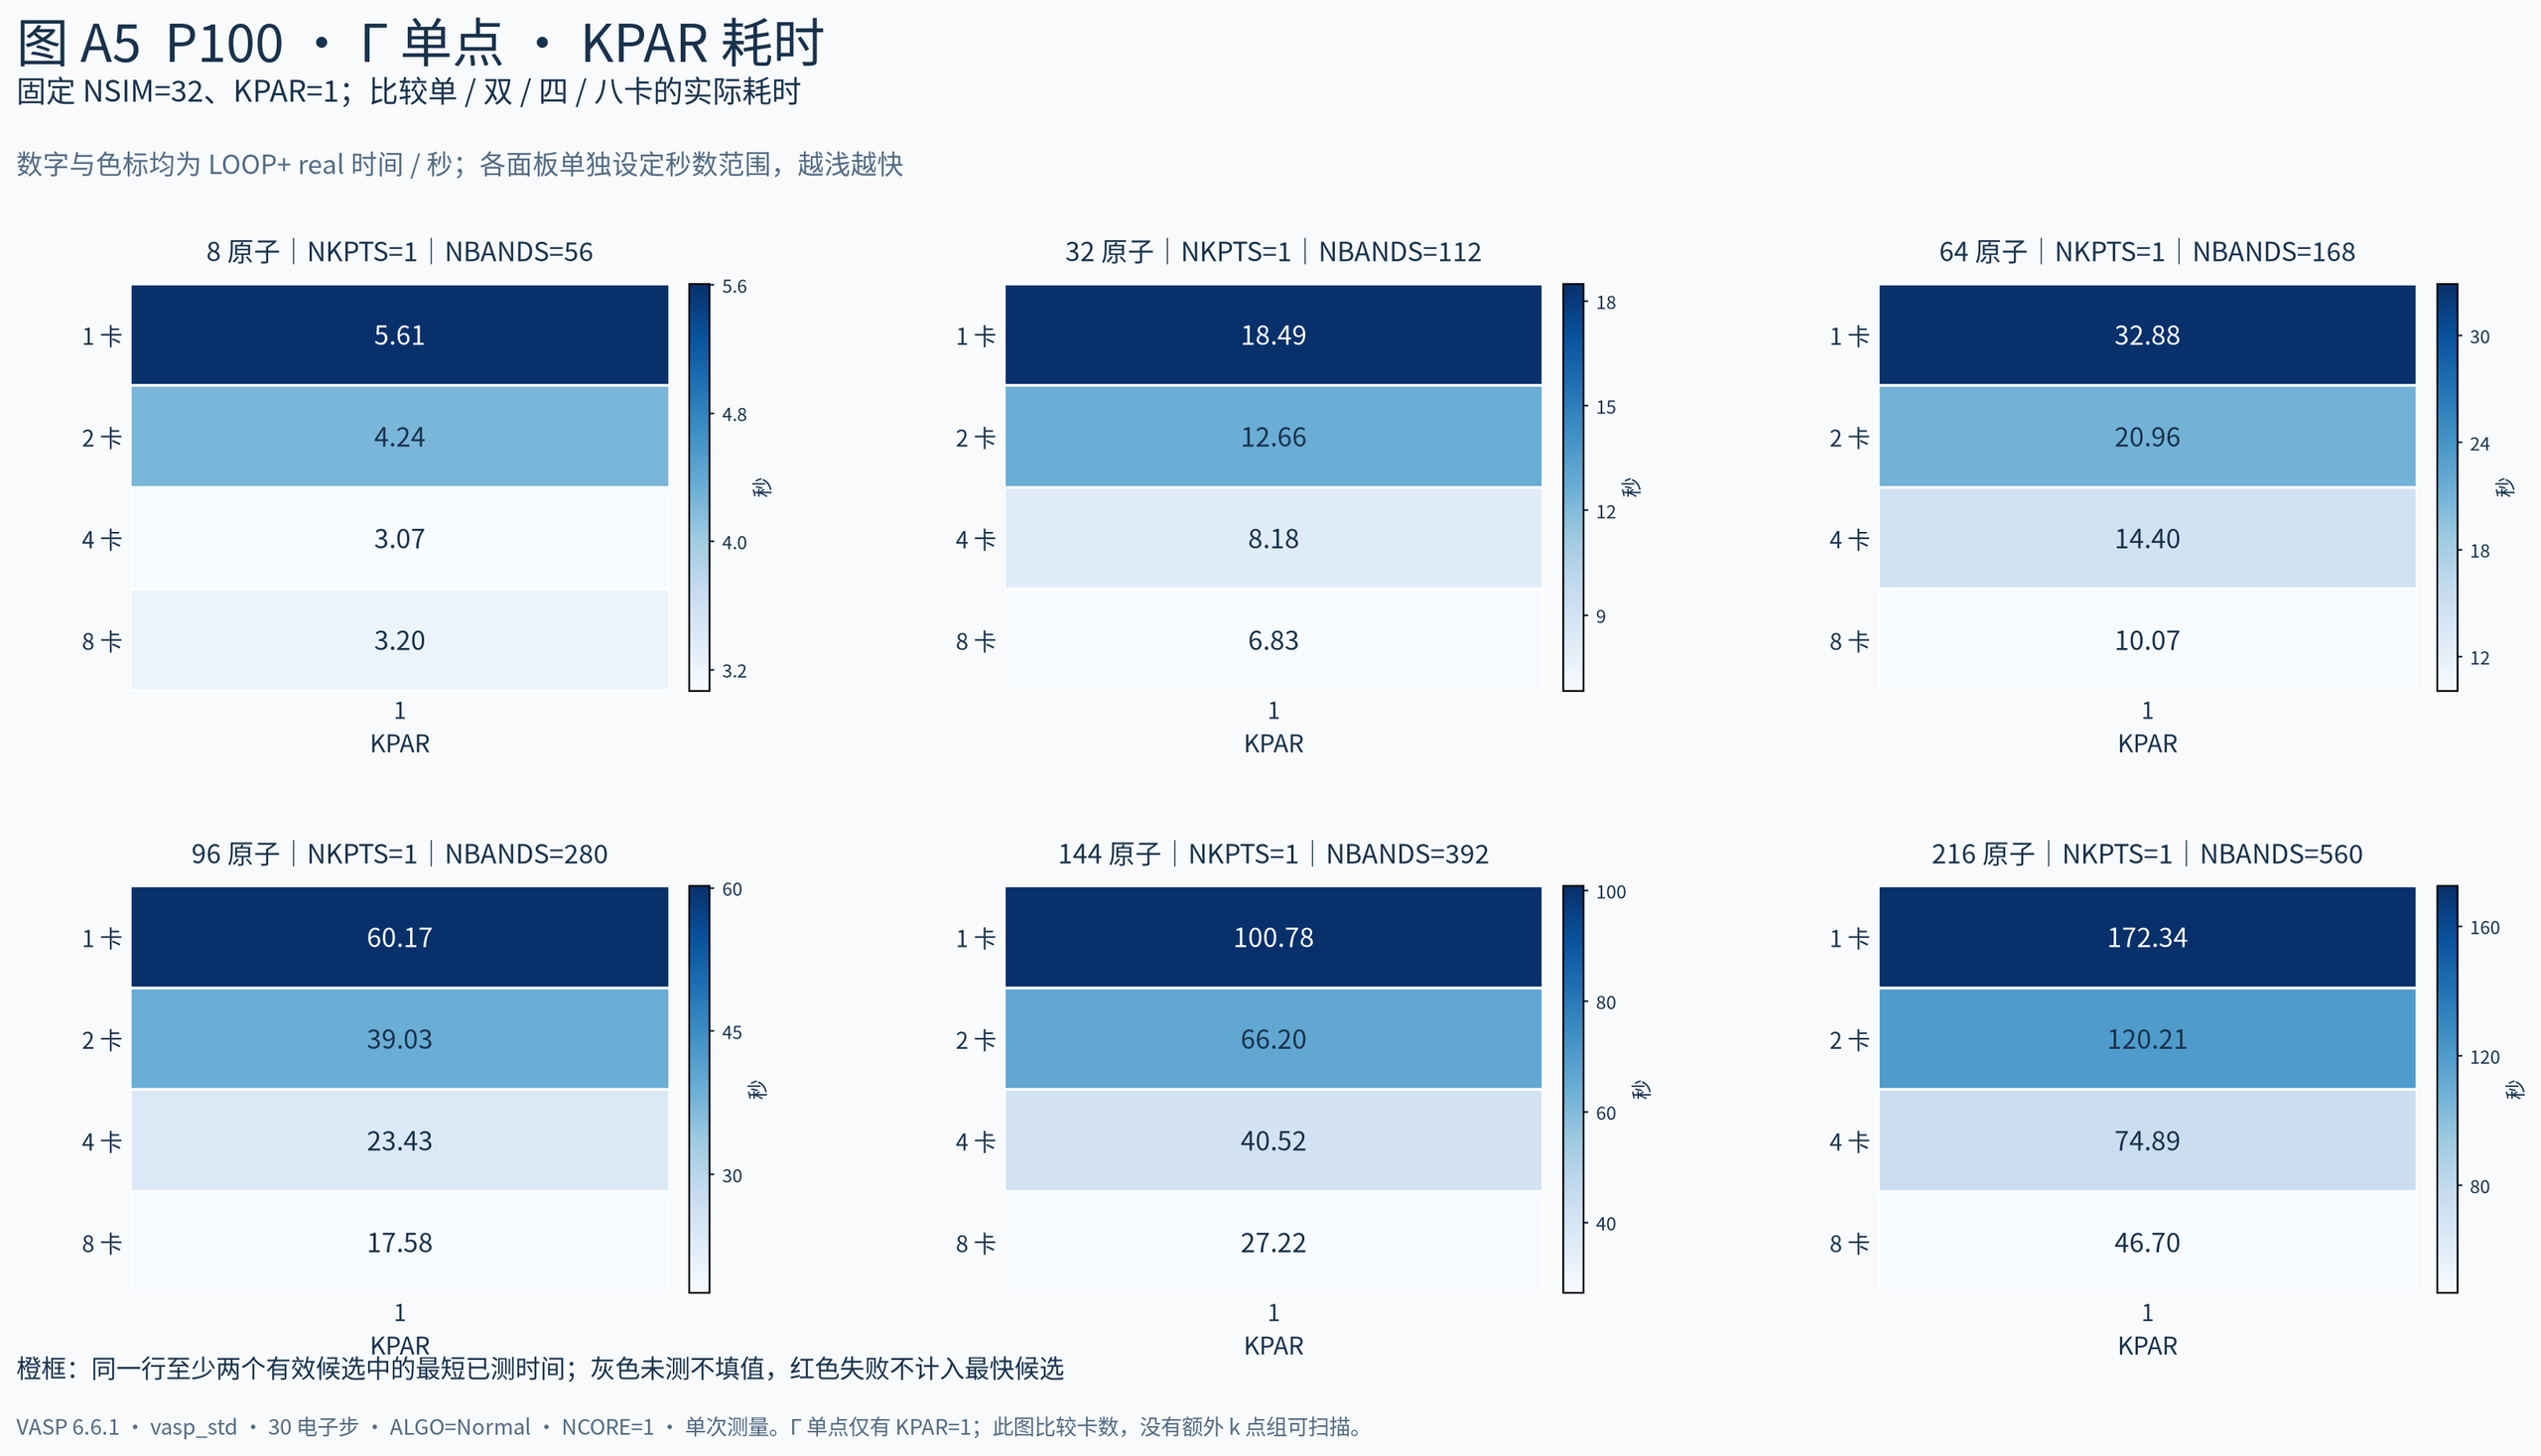
KPAR=1、NSIM=32,比较单/双/四/八卡;横轴只保留 KPAR=1。
图 A6:V100 Γ 单点 KPAR 实测耗时#
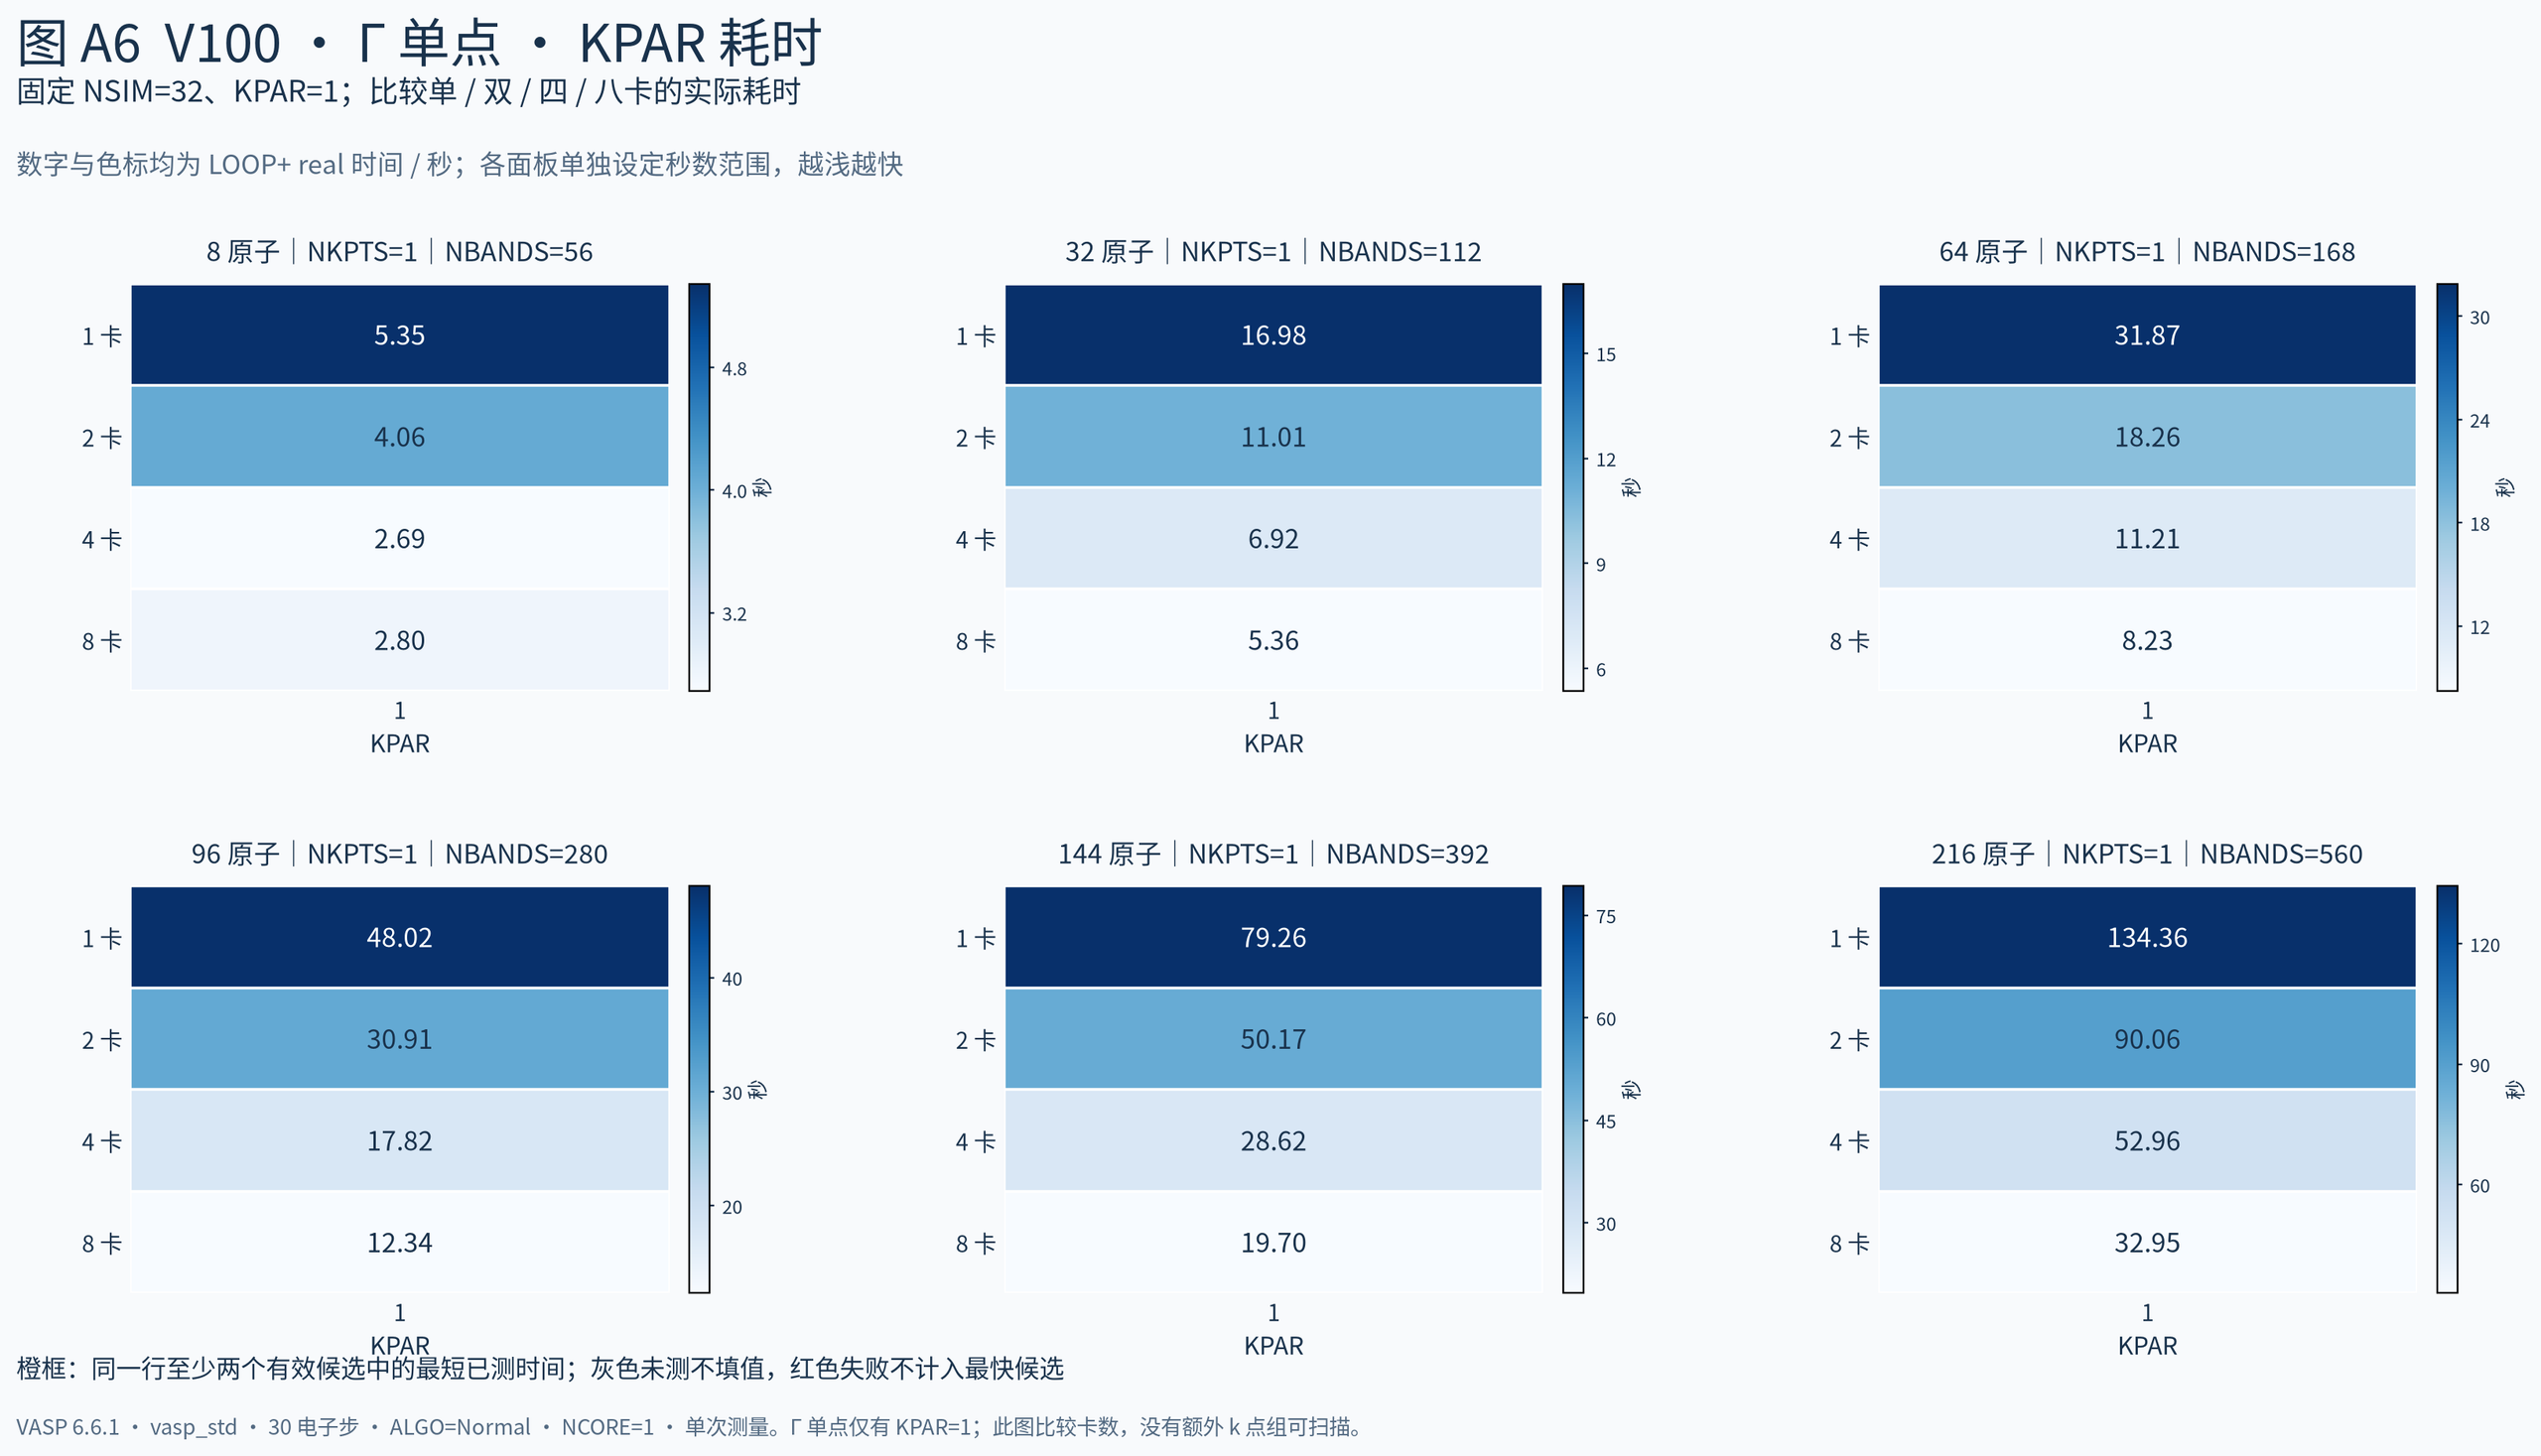
KPAR=1、NSIM=32,比较单/双/四/八卡;横轴只保留 KPAR=1。
8 原子:四卡到八卡没有继续缩短时间。 经过已测 NSIM 的选择,P100 单/双/四/八卡最快已测时间分别为 5.59/3.83/2.89/3.17 秒,V100 为 5.05/3.62/2.45/2.62 秒。这与小工作量下多卡协作开销难以被计算收益抵消的情况一致;从实际节省的时间看,不适合仅为这类任务申请八卡。
32、64 原子:八卡仍更快,但最后增加的卡数节省的时间有限。 32 原子 P100 四卡与八卡为 7.59/6.32 秒,V100 为 6.34/4.99 秒;64 原子 P100 为 13.69/9.77 秒,V100 为 10.77/7.83 秒。应结合剩余计算量和资源可用情况决定是否继续加卡。大量相互独立的小任务,也可以考虑把 GPU 分配给不同作业。
96、144、216 原子:同一 k 点仍有足够工作量受益于多卡。 216 原子 P100 单/双/四/八卡最快已测时间为 162.25/106.83/68.71/46.30 秒,V100 为 126.52/85.28/52.39/32.74 秒。Γ 单点不能利用 k 点组并行,但并不意味着大体系只能使用单卡。
5.2 NSIM 的结果:单卡大体系与多卡不宜沿用同一批量#
图 A7:P100 Γ 单点 NSIM 实测耗时#
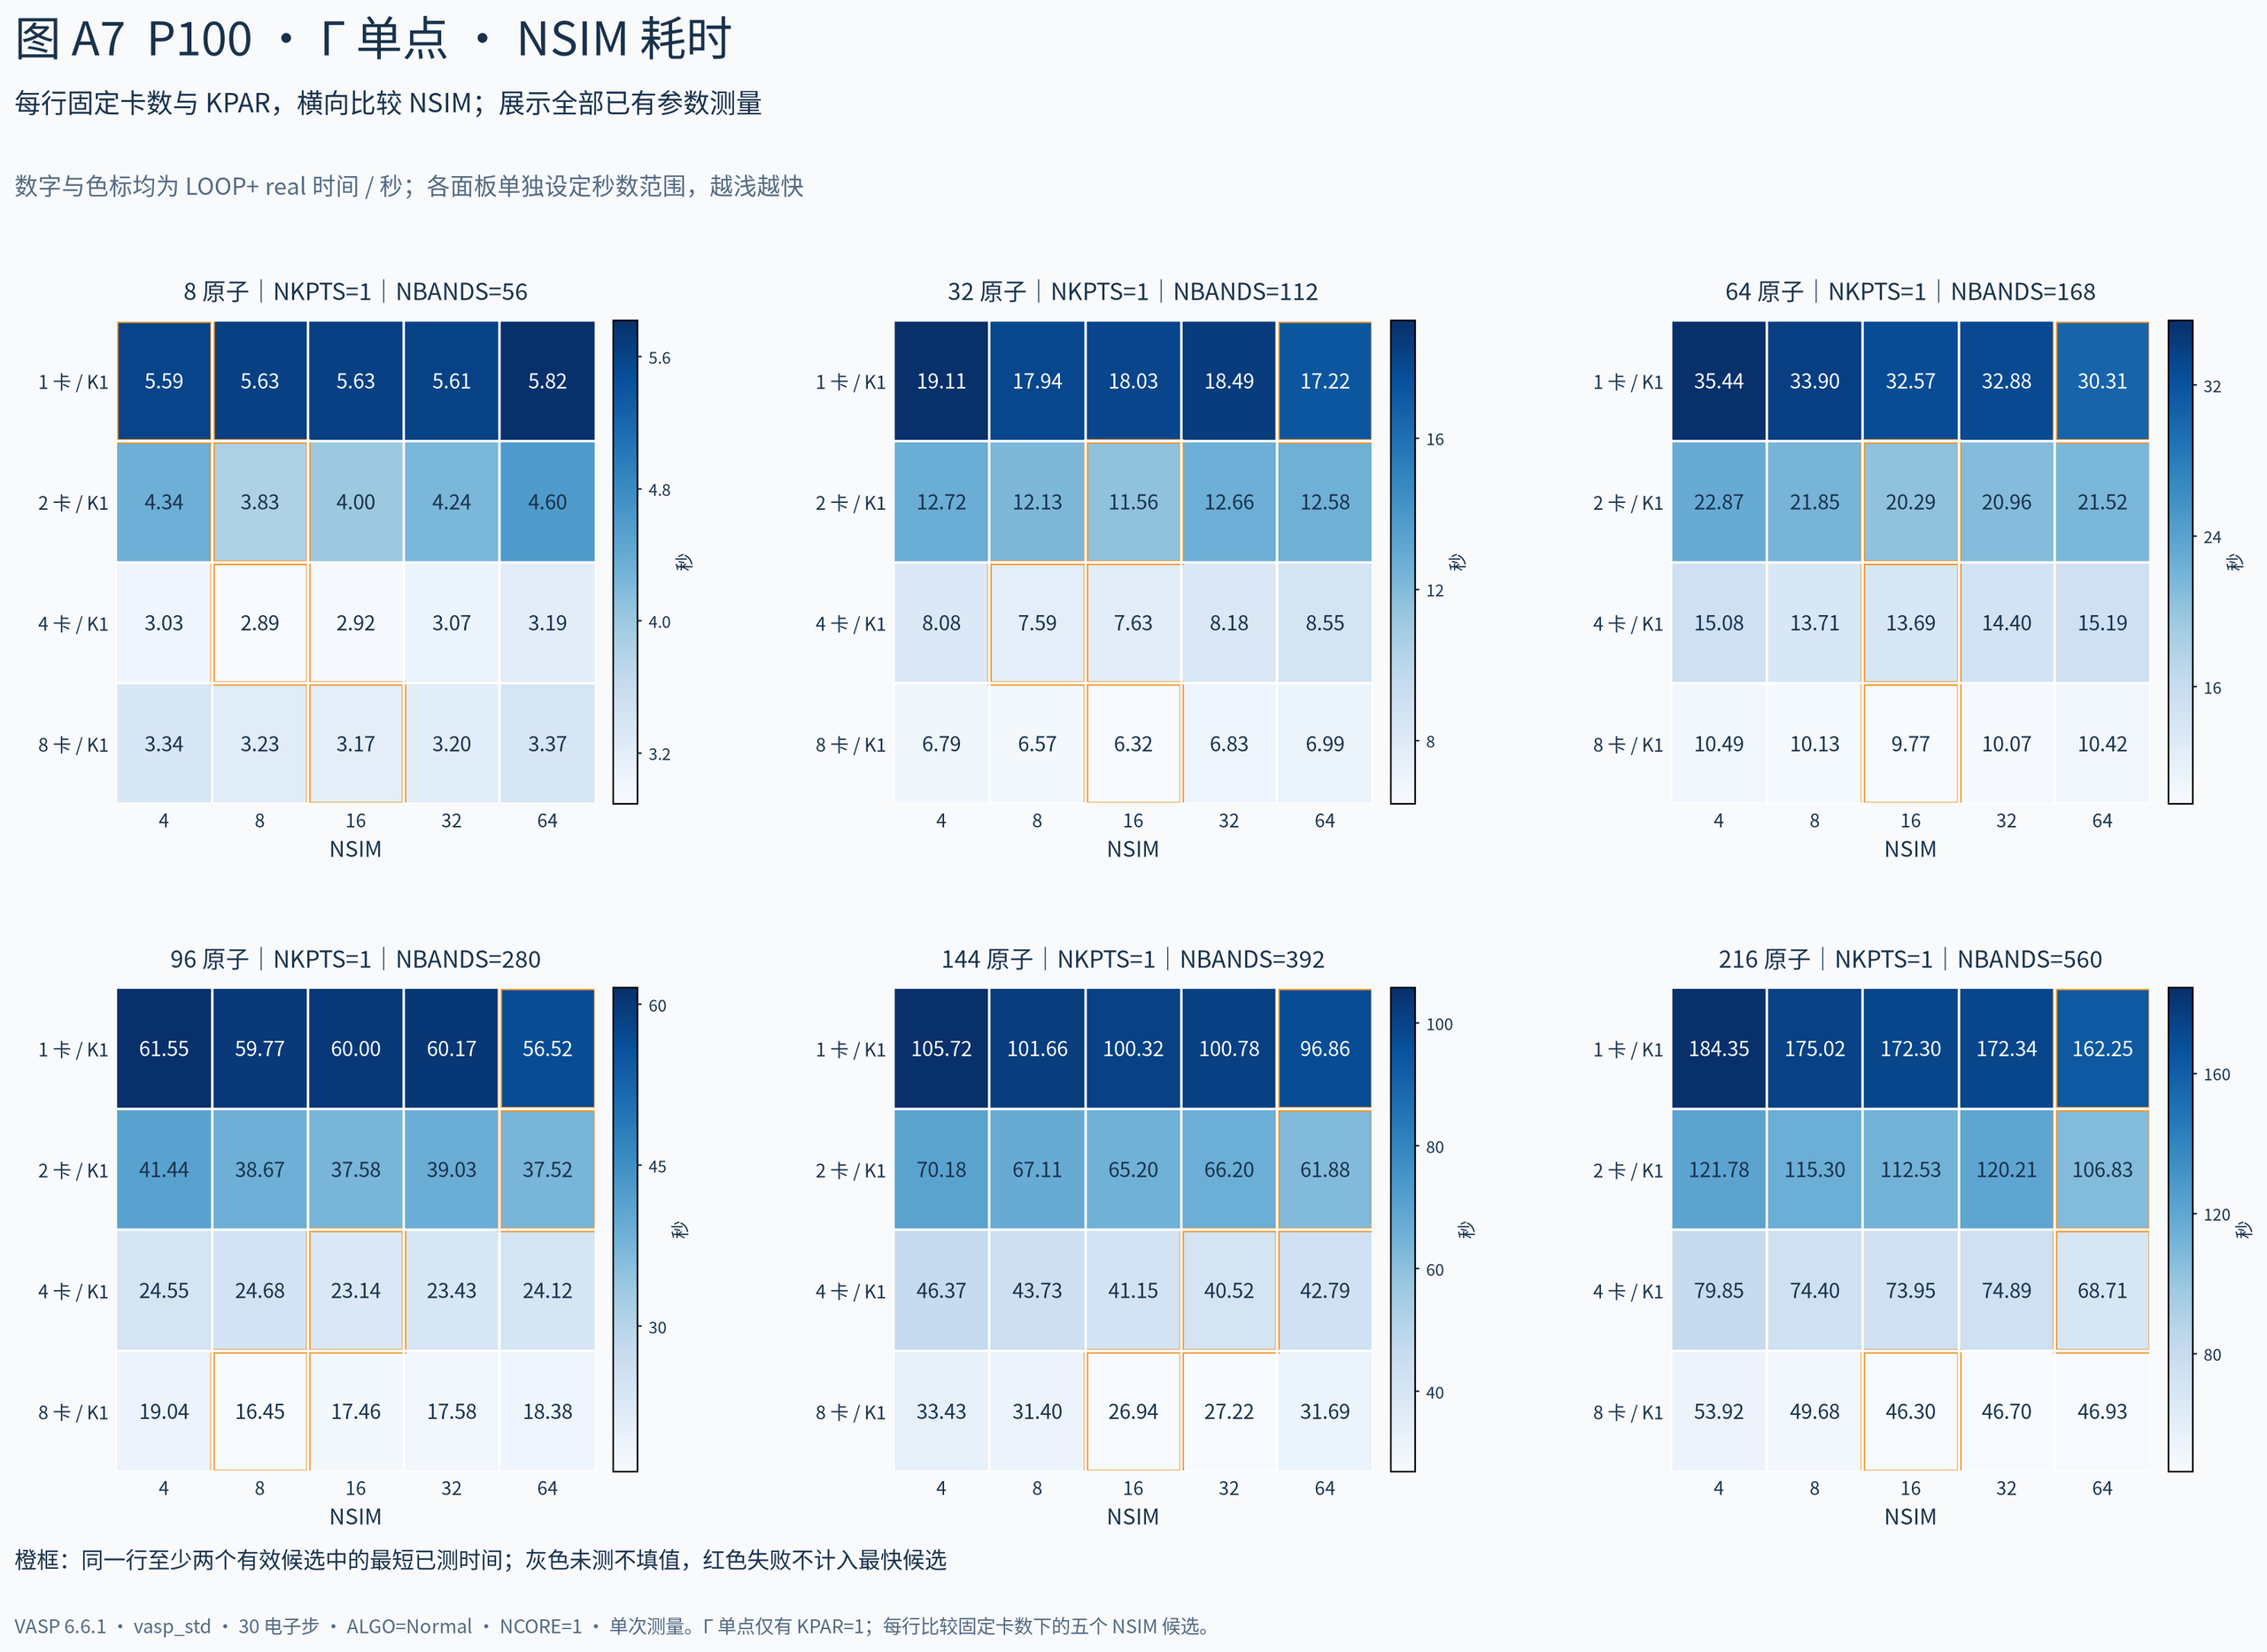
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
图 A8:V100 Γ 单点 NSIM 实测耗时#
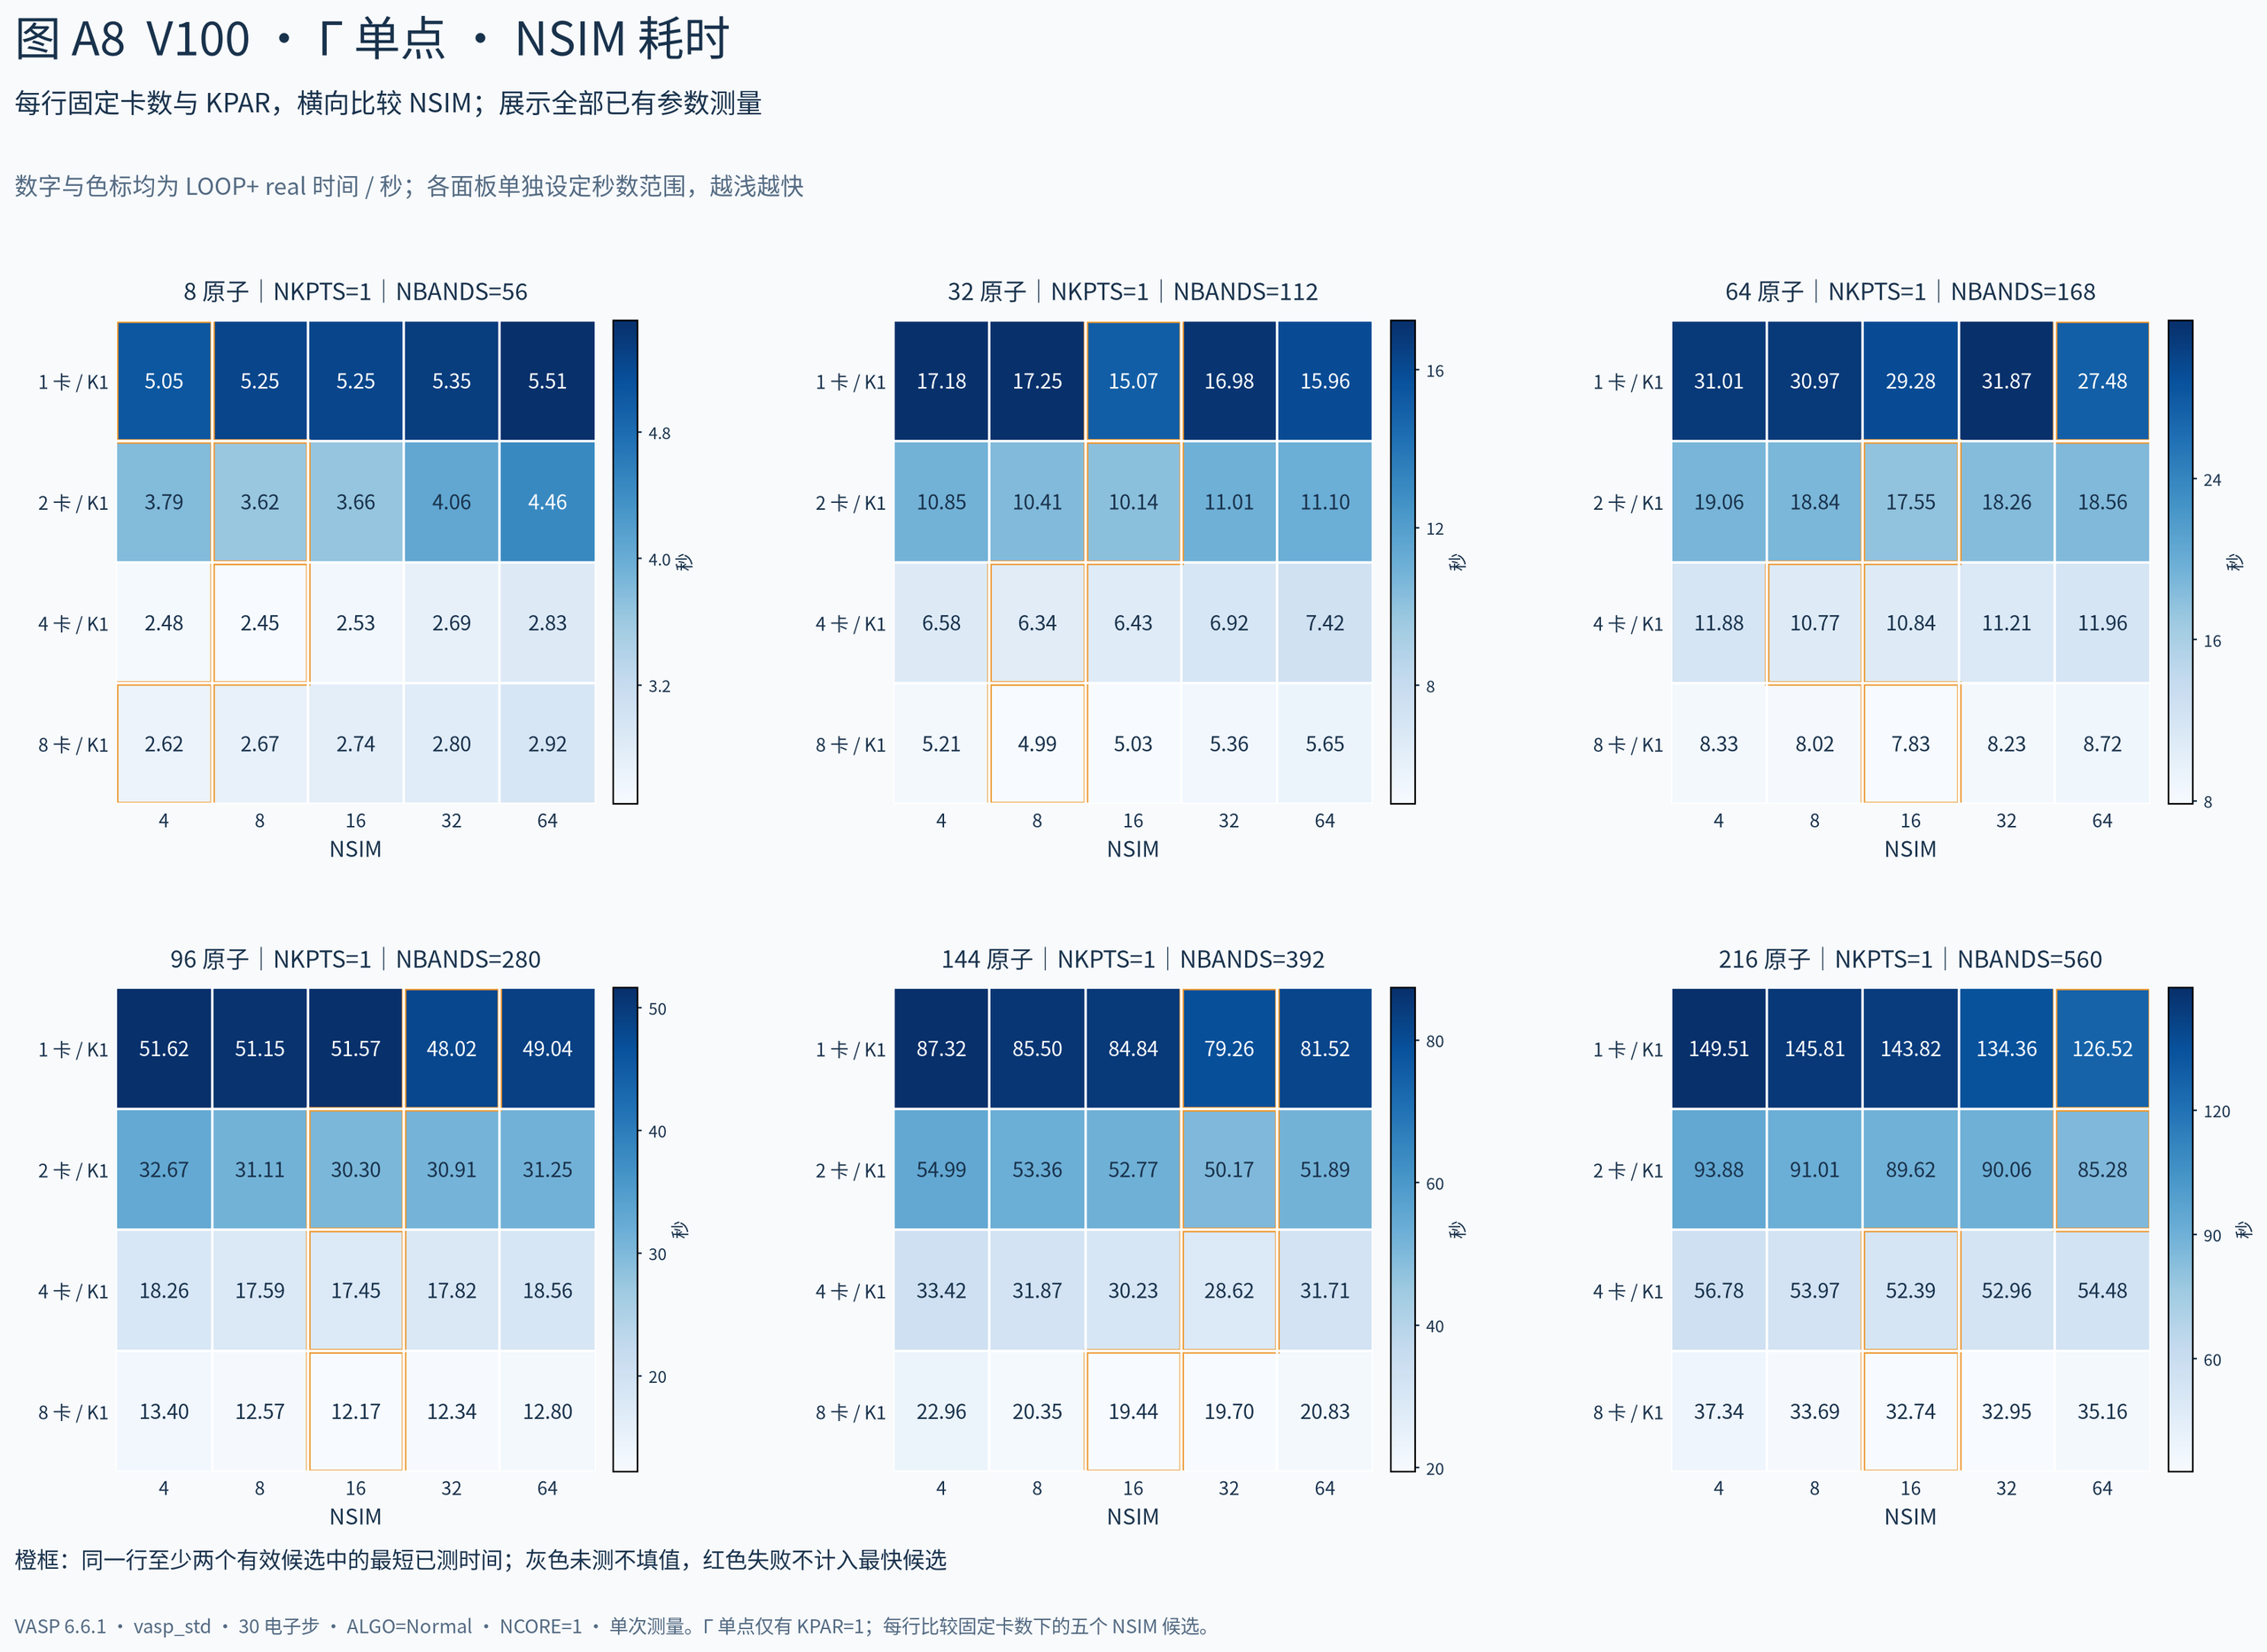
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
8 原子以较小 NSIM 为主。 两种 GPU 单卡均以 NSIM=4 最快,四卡均以 8 最快。例如 V100 四卡五个 NSIM 用时为 2.48/2.45/2.53/2.69/2.83 秒,增大到 32、64 没有加速。这个结果只说明当前极小 Γ 负载的较优候选,不意味着其他 GPU 算例都应使用 4。
32、64 原子需要区分单卡与多卡。 P100 单卡在这两种规模上均以 NSIM=64 最快;V100 32 原子单卡以 16 最快,64 原子单卡则以 64 最快。四卡的较优 NSIM 主要是 8 或 16。相同 NBANDS 放到更多 GPU 上以后,每卡实际参与的工作改变,单卡较优值不必继续适合四/八卡。
96、144 原子中,16/32/64 都有各自适用配置。 96 原子 P100 单/双卡以 64 最快,四卡以 16、八卡以 8 最快;V100 对应为 32/16/16/16。144 原子 P100 单/双卡以 64 最快,四/八卡为 32/16;V100 单/双/四卡为 32,八卡为 16。平台和卡数的差异,比“原子更多就把 NSIM 加大”的规则更值得关注。
216 原子的完整曲线最直观。 单卡按 NSIM=4/8/16/32/64,P100 为 184.35/175.02/172.30/172.34/162.25 秒,V100 为 149.51/145.81/143.82/134.36/126.52 秒;两者都以 64 最短。八卡 P100 则为 53.92/49.68/46.30/46.70/46.93 秒,V100 为 37.34/33.69/32.74/32.95/35.16 秒;两者都变为 16 最短。
用于自己的 Γ 单点计算时: KPAR 保持 1。先在合理卡数上比较 NSIM=16、32;很小体系补测 4、8,大体系单卡或双卡可补测 64。不要因为单卡 NSIM=64 较快,就把它直接带到八卡配置中。最终是否采用专用 vasp_gam,应另按该程序进行测试,不能直接用本文 vasp_std 的秒数替代。
6. 较密网格:k 点增加后,较优分组可能发生变化#
这一档六种规模的实际 NKPTS 为 125、45、27、18、12、8。相比较疏网格,前五种规模增加了实际 k 点工作量。即便结构与 NBANDS 不变,也应重新选择 KPAR 和 NSIM。
6.1 KPAR 的结果:较多 k 点使较大分组更有机会#
图 A9:P100 较密网格 KPAR 实测耗时#
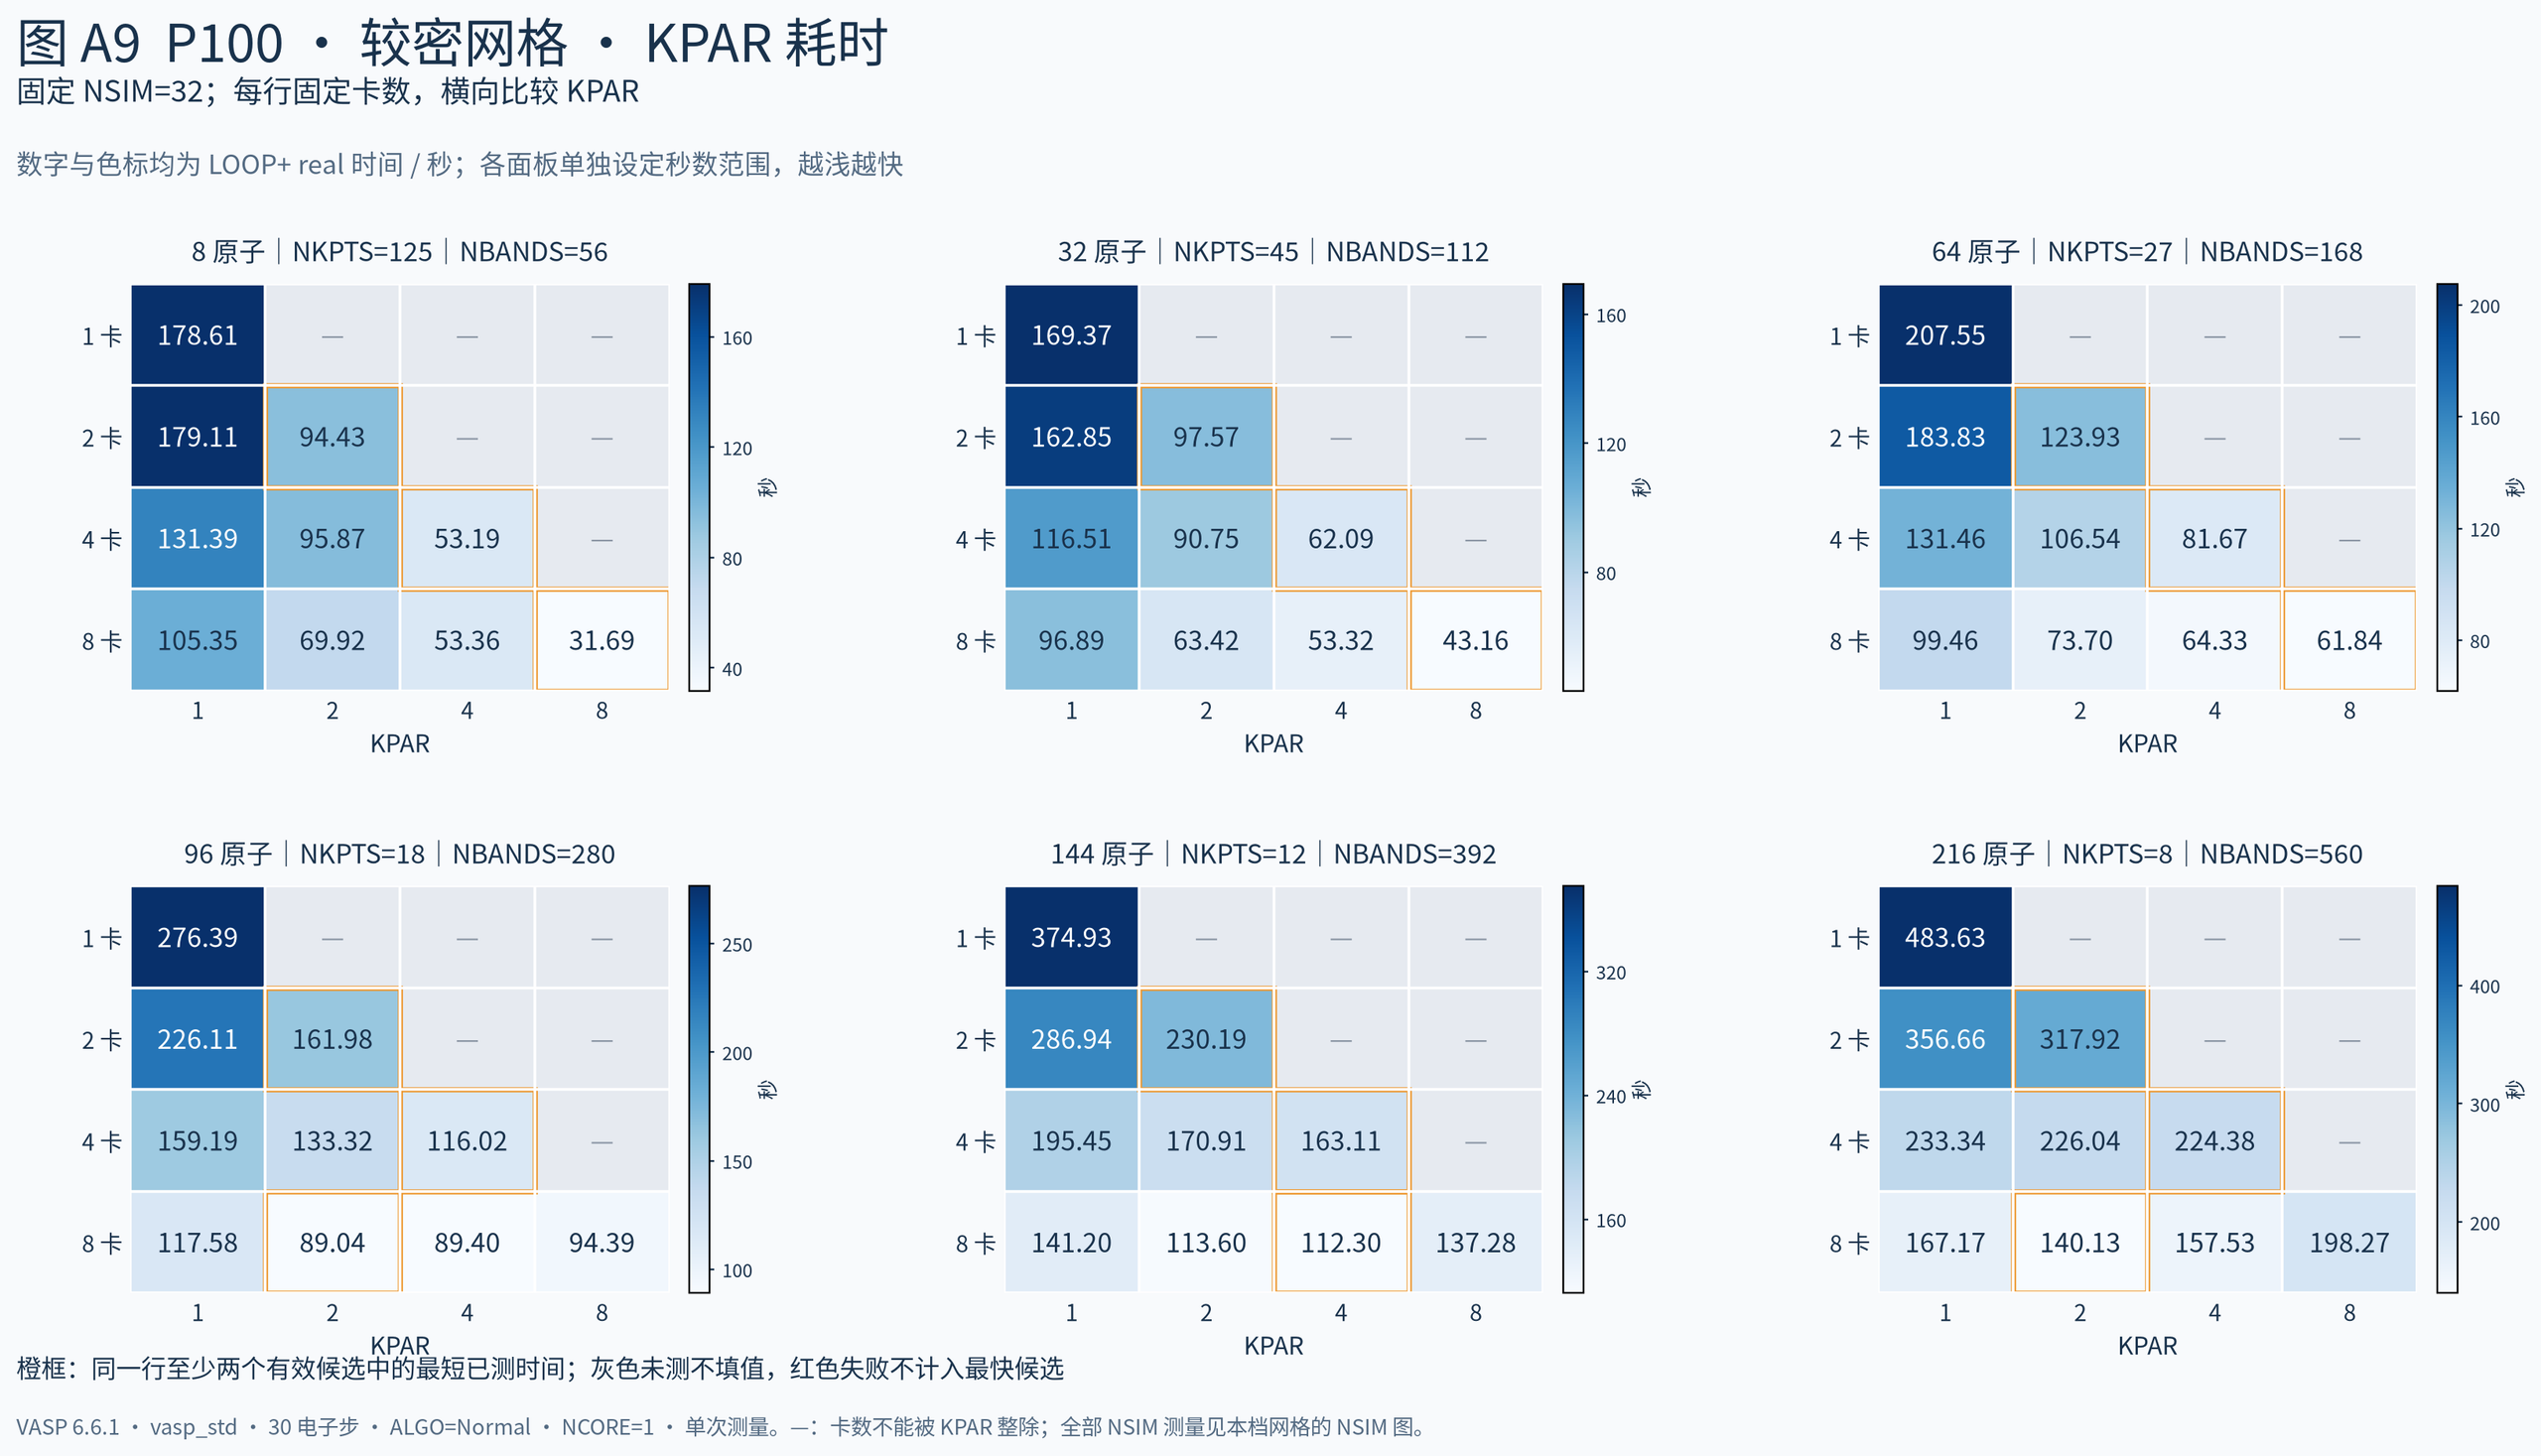
固定 NSIM=32,同一行比较不同 KPAR;数字与色标单位均为秒。
图 A10:V100 较密网格 KPAR 实测耗时#
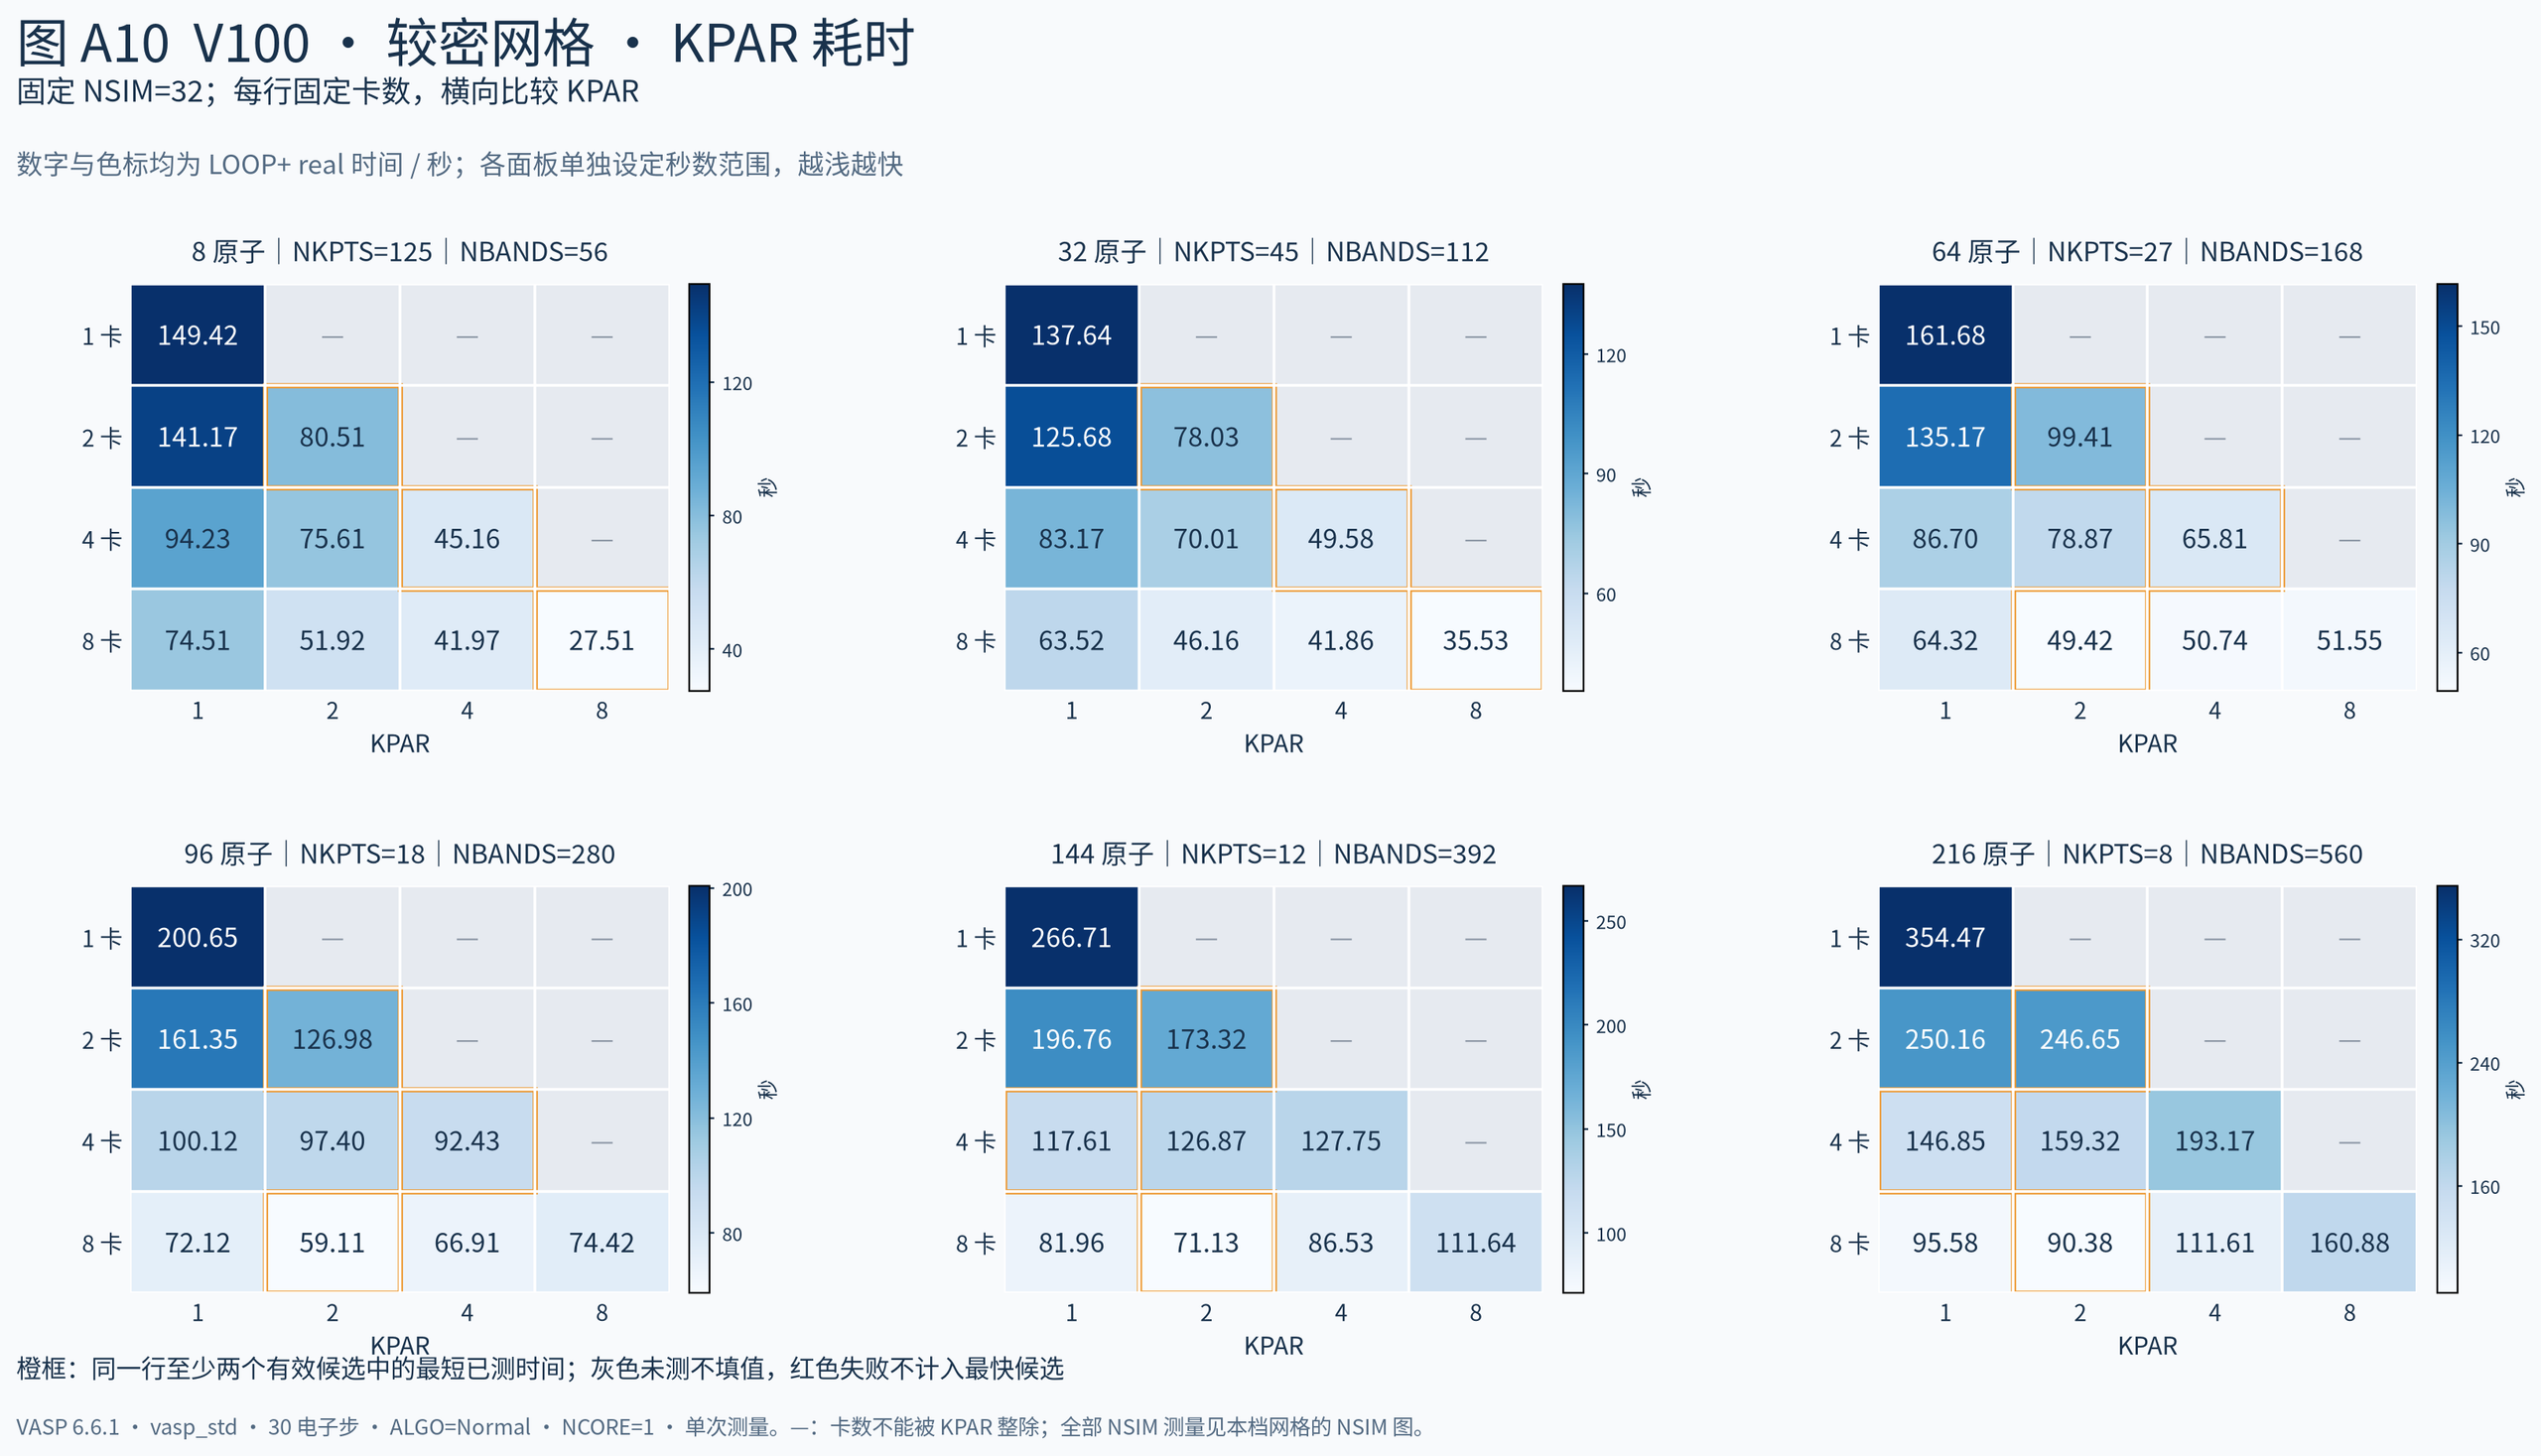
固定 NSIM=32,同一行比较不同 KPAR;数字与色标单位均为秒。
先看八卡、固定 NSIM=32 时,各体系最短已测候选:
| 原子数 | NKPTS | P100 八卡:KPAR;时间(秒) | V100 八卡:KPAR;时间(秒) |
|---|---|---|---|
| 8 | 125 | 8;31.69 | 8;27.51 |
| 32 | 45 | 8;43.16 | 8;35.53 |
| 64 | 27 | 8;61.84 | 2;49.42 |
| 96 | 18 | 2;89.04 | 2;59.11 |
| 144 | 12 | 4;112.30 | 2;71.13 |
| 216 | 8 | 2;140.13 | 2;90.38 |
8、32 原子:两种平台都适合优先试大 KPAR。 这两种规模有 125 和 45 个实际 k 点。固定 NSIM=32 时,两种 GPU 的双/四/八卡均以 KPAR=2/4/8 较优。联合选择 NSIM 后,8 原子八卡 P100 为 31.69 秒,V100 为 27.05 秒;32 原子八卡分别为 41.83 秒和 33.92 秒。原子少并不代表多卡无效,较多 k 点本身就能提供可并行的工作。
64 原子:P100 与 V100 的较优 KPAR 开始分开。 NKPTS=27,P100 八卡、NSIM=32 下以 KPAR=8 较优,V100 则以 KPAR=2 较优。NSIM 扫描后,P100 最快已测配置为 KPAR=8、NSIM=16,58.02 秒;V100 为 KPAR=4、NSIM=16,46.34 秒。V100 在 NSIM=32、KPAR=2 时为 49.42 秒,因此只看固定 NSIM 的 KPAR 图还不够。
96 原子:八卡继续优先比较较小 KPAR。 NKPTS=18,两种 GPU 的四卡、NSIM=32 以 KPAR=4 较优,八卡却都转为 KPAR=2。联合候选中,八卡 P100 为 KPAR=2、NSIM=32,89.04 秒;V100 为 KPAR=2、NSIM=16,58.11 秒。把卡数翻倍时,没有必要同时把 KPAR 翻倍。
144 原子:十二个实际 k 点下,平台差异仍然存在。 固定 NSIM=32,P100 四/八卡较优 KPAR 为 4/4,V100 为 1/2。联合选择后,八卡 P100 为 KPAR=4、NSIM=32,112.30 秒,V100 为 KPAR=2、NSIM=32,71.13 秒。这类负载可以从 2、4 开始比较,再补充 1 或 8。
216 原子:仍应优先试 KPAR=2。 该规模密网格实际 NKPTS 仍为 8。八卡、NSIM=32 下,P100 的 KPAR=1/2/4/8 分别为 167.17/140.13/157.53/198.27 秒;V100 为 95.58/90.38/111.61/160.88 秒。与较疏网格一样,大 KPAR 没有成为最短候选。
6.2 NKPTS 不能整除 KPAR,是否一定不划算#
不一定。例如密网格 8 原子 NKPTS=125、32 原子 NKPTS=45,都不能被 8 整除,但本批八卡最快已测候选仍采用 KPAR=8。k 点数量较多时,各组相差一个 k 点的相对负载差可能较小;与较小 KPAR 相比,增加独立组数的收益仍可能更大。
反过来,216 原子 NKPTS=8 可以被 KPAR=8 整除,但实测 KPAR=2 更快。均分是值得考虑的条件,不能单独用它决定最佳参数。 应先满足进程分组要求,再结合每个 k 点的计算量比较时间。
6.3 NSIM 的结果:多数先试 16/32,再检查分组相互影响#
图 A11:P100 较密网格 NSIM 实测耗时#
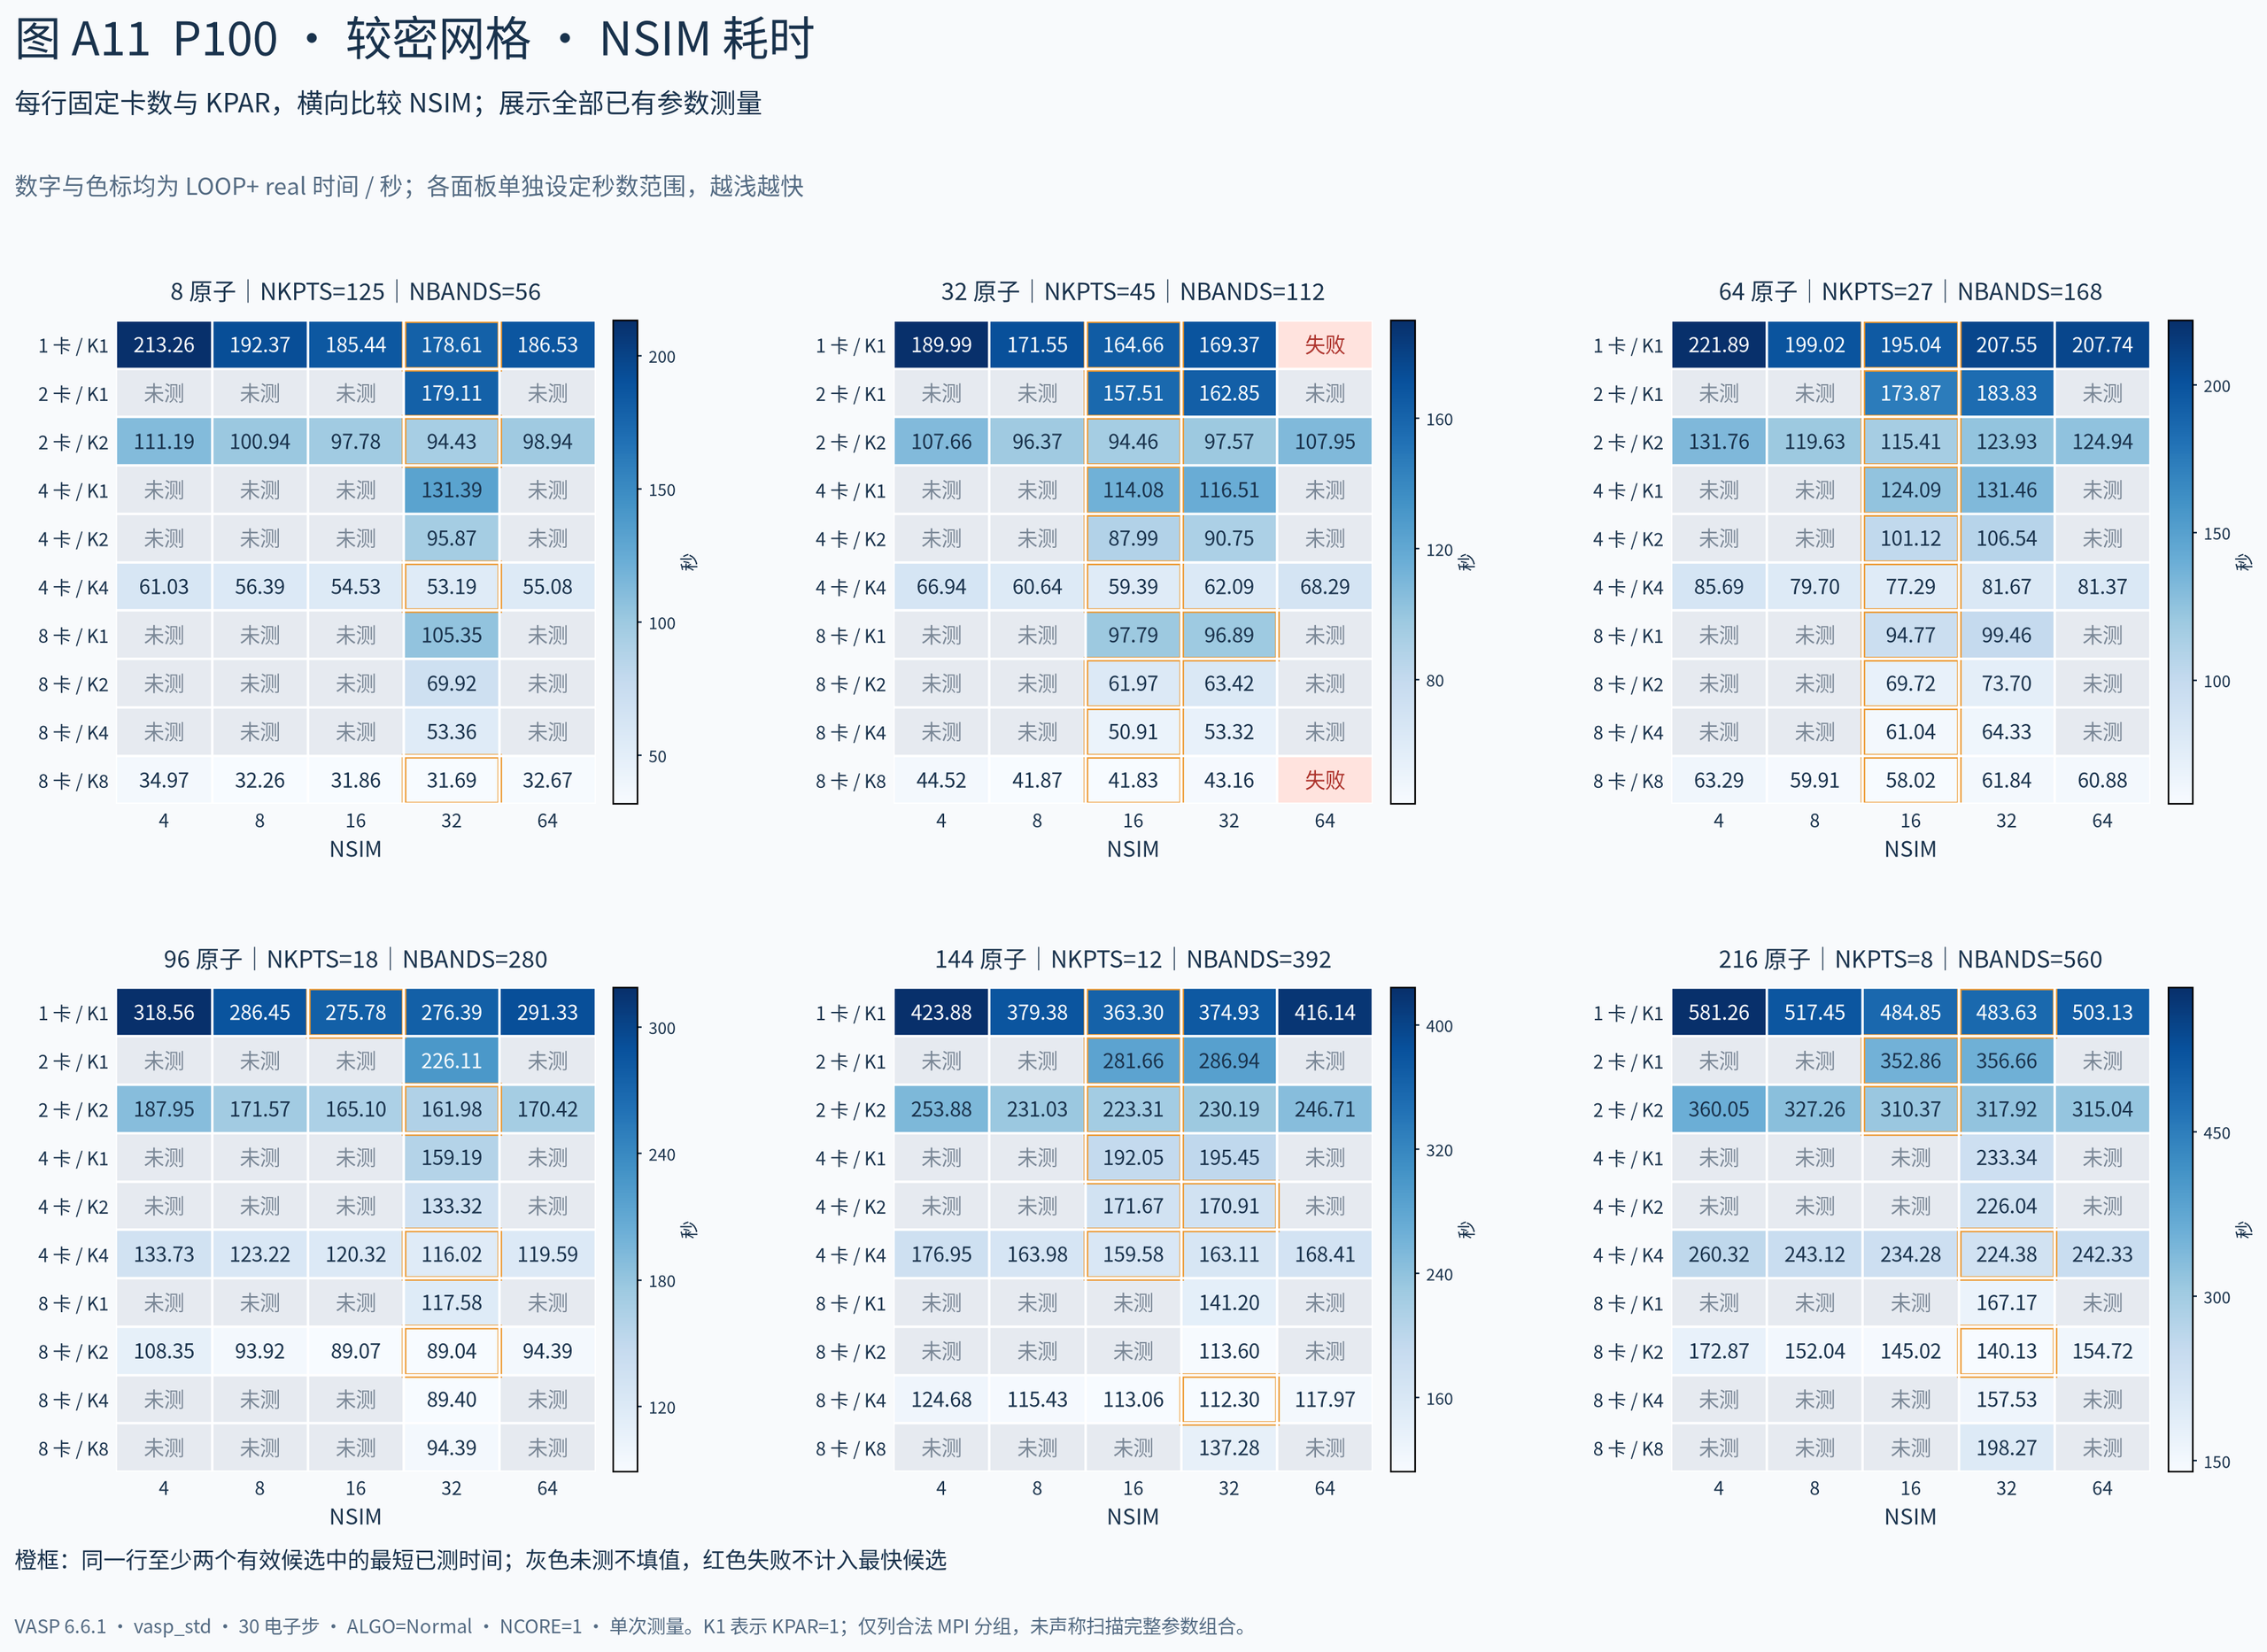
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
图 A12:V100 较密网格 NSIM 实测耗时#
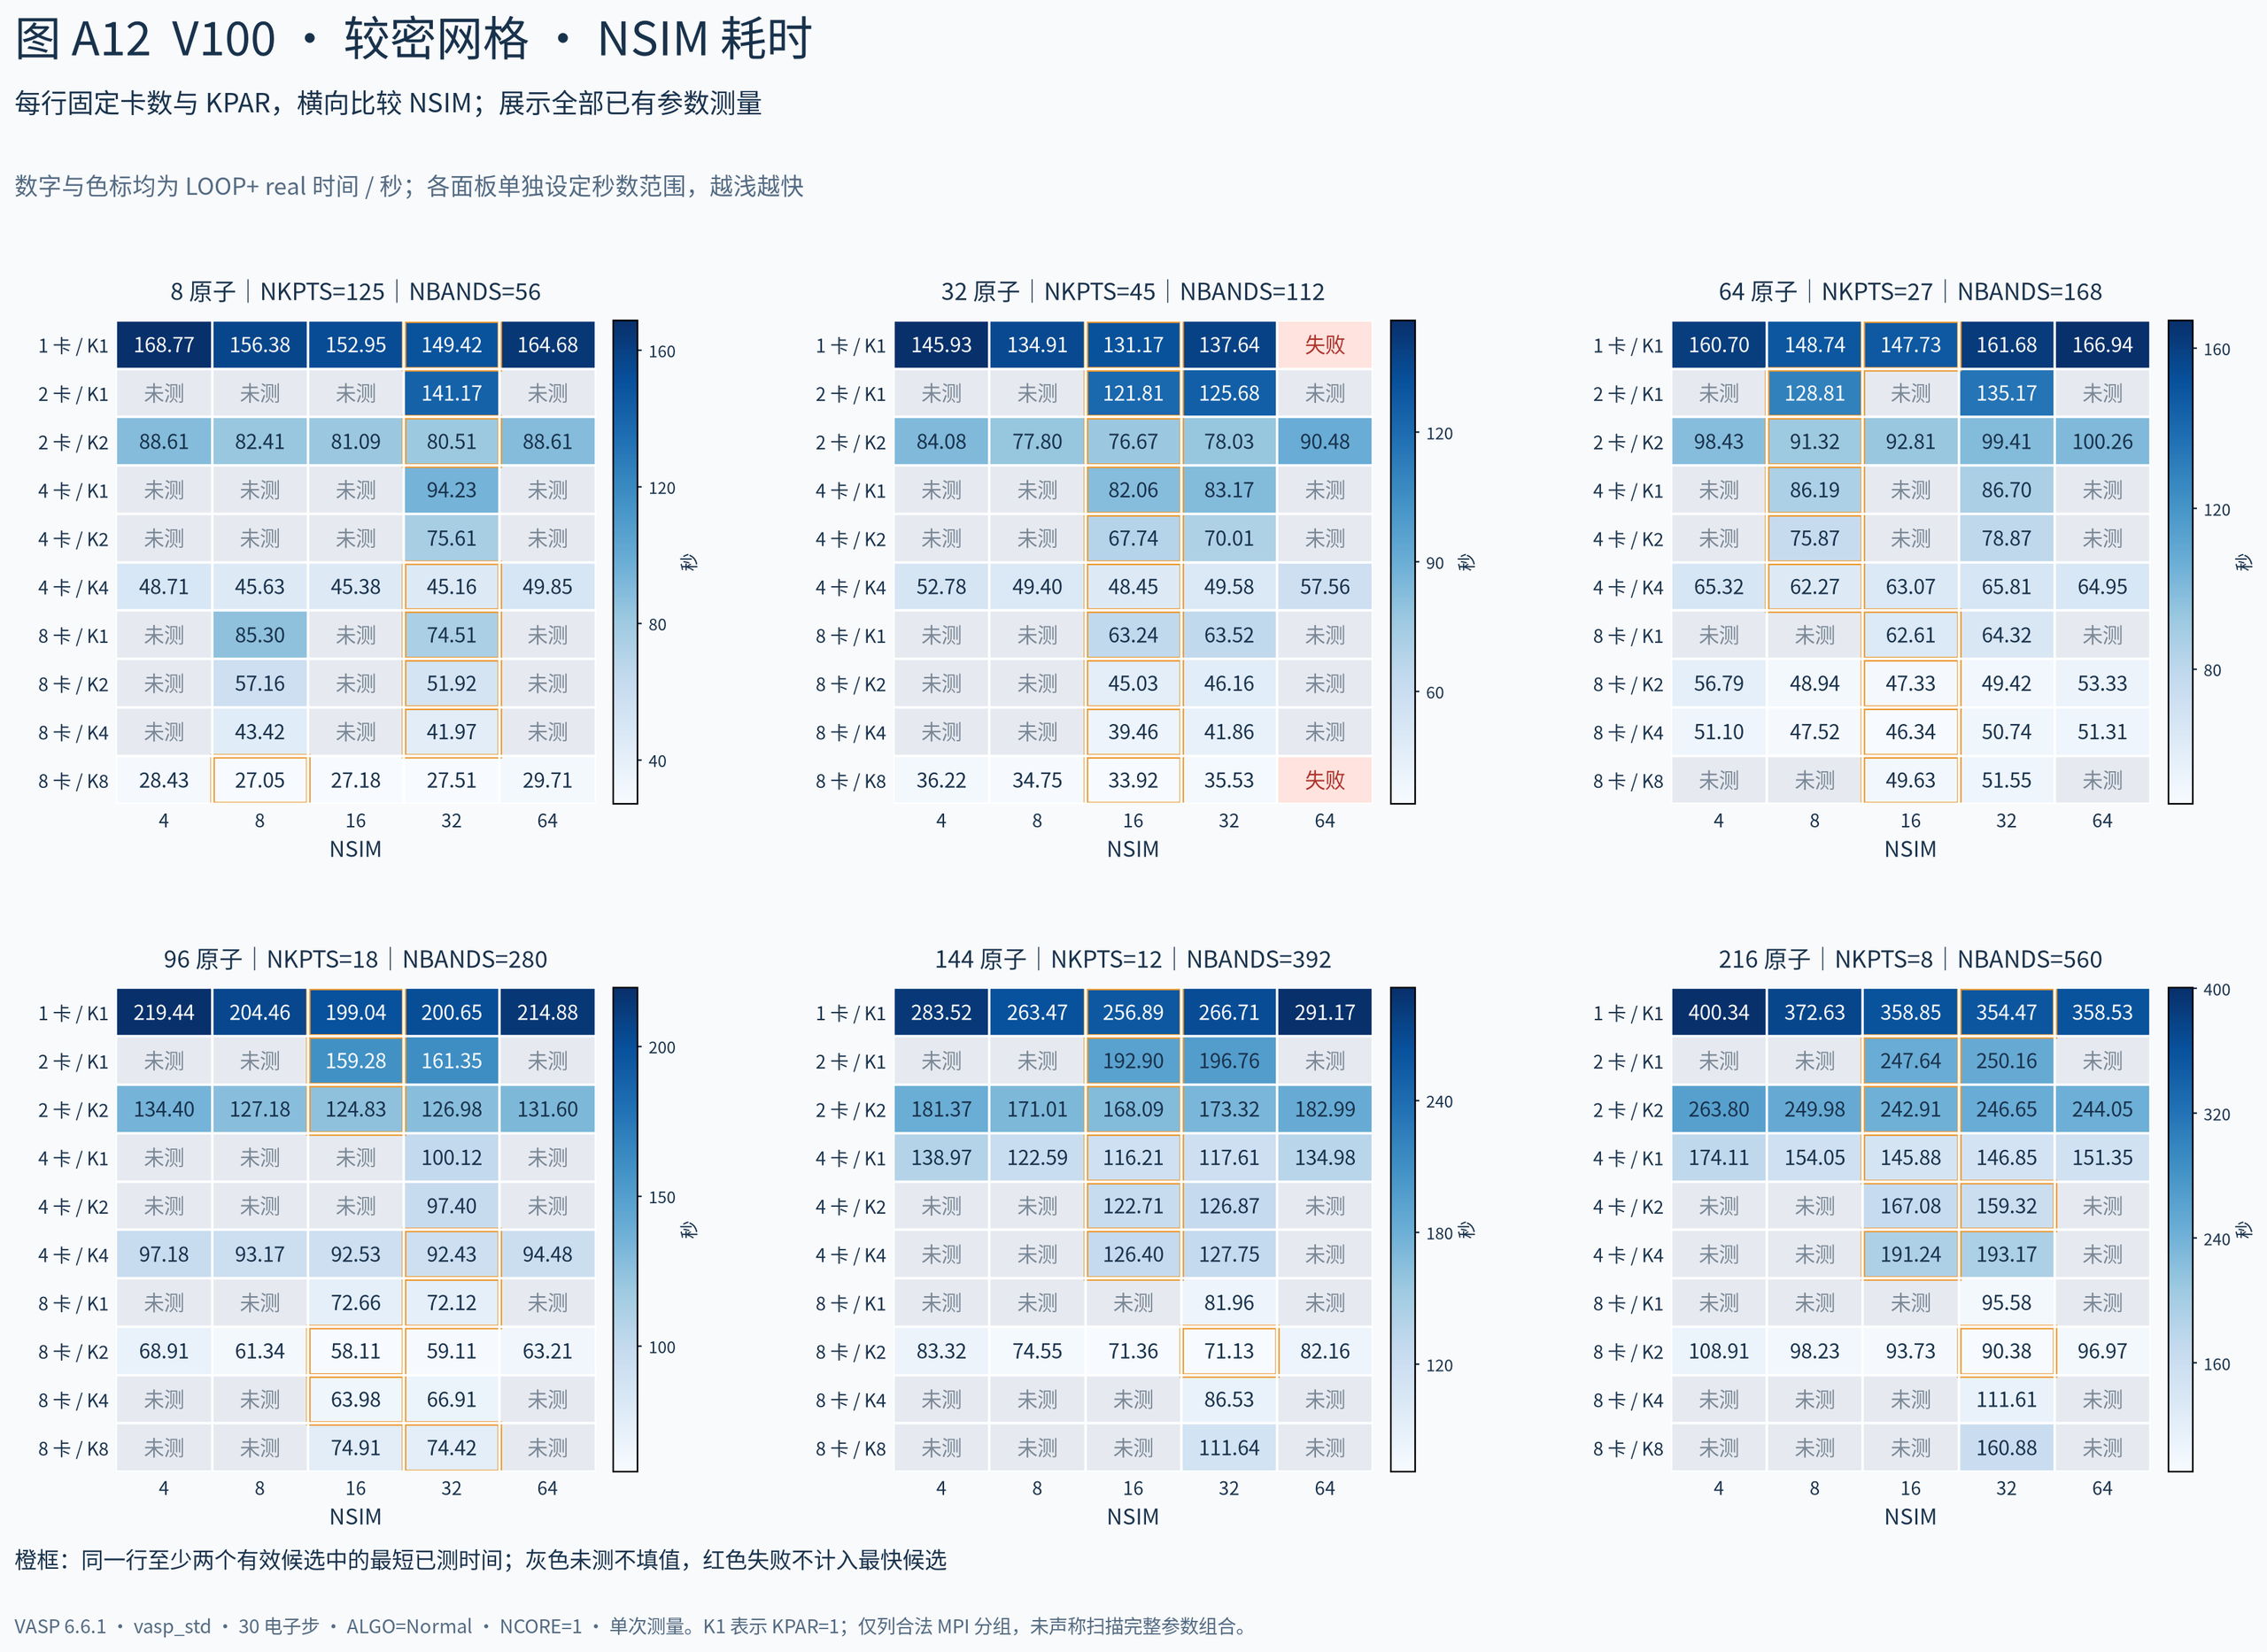
同一行的卡数和 KPAR 固定,比较 NSIM=4/8/16/32/64;数字与色标单位均为秒。
32~144 原子中,16 与 32 是主要候选。 32 原子在两种 GPU 的单/双/四/八卡中,最快已测候选均使用 NSIM=16。64 原子 P100 也全部以 16 最快;V100 双/四卡则以 8 最快。96、144 原子八卡中,P100 以 32 较优,V100 的 96 原子以 16、144 原子以 32 较优。需要按平台和资源分别选择。
64 原子八卡的 NSIM 对比说明,增大到 64 没有继续收益。 P100、KPAR=8 的五个时间为 63.29/59.91/58.02/61.84/60.88 秒;V100、KPAR=4 为 51.10/47.52/46.34/50.74/51.31 秒。两者均以 16 最短。96 原子 V100 八卡、KPAR=2 的时间为 68.91/61.34/58.11/59.11/63.21 秒,同样以 16 较优。
216 原子不要机械沿用 Γ 单点单卡的 NSIM=64。 本档单卡两种平台都以 NSIM=32 最快,八卡也都是 KPAR=2、NSIM=32。同一规模的 Γ 单点单卡却以 64 较优,说明网格变化后,NSIM 的候选顺序应重新确认。
图中的 32 原子部分 NSIM=64 组合未完成规定的完整 30 步,已标成失败。它们不参与最短时间比较,也不能把已运行的较少步数时间当成“更快”。这并不代表 NSIM=64 在所有体系都不可用:第 5 节的大体系 Γ 单点已有有效且较快的 64 结果。
6.4 怎样把疏网格参数迁移到密网格#
64 原子 P100 八卡,较疏网格最快已测配置为 KPAR=2、NSIM=8,27.85 秒;较密网格变成 KPAR=8、NSIM=16,58.02 秒。这里两次计算的 k 点工作量不同,不能把时间增加归因于换了 KPAR,但参数变化明确说明应重新调优。
216 原子两个网格的实际 NKPTS 和 NBANDS 相同,八卡的较优参数也相同,时间很接近。耗时接近并不表示两个网格具有相同采样精度。 网格位置、权重与采样密度仍是科学精度问题,应单独检查收敛。
用于自己的较密网格时,可以先保留原较优配置作为基准,再加入更大的合法 KPAR。尤其是 k 点明显增加的小/中晶胞,应重新比较 4、8;每选出新的 KPAR,再比较 NSIM=16、32,并用较优 NSIM 回头检查其他分组。
7. 从结果中决定:该用几张卡,是否需要换平台#
7.1 原子数不能单独决定卡数#
同为 8 原子,Γ 单点 P100 四卡已约 2.89 秒,八卡没有继续缩短;密网格 P100 却从单卡的 178.61 秒缩短到八卡的 31.69 秒。差别来自工作量,尤其是实际 k 点数量,而不是原子数标签。
对于 96~216 原子的本批 Si 计算,三档网格中四卡到八卡都继续缩短了最快已测时间。以 216 原子疏网格为例,P100 四/八卡为 225.69/140.32 秒,V100 为 142.72/90.48 秒。这类较大工作量更值得比较八卡;小负载则应重点看增加卡数后实际节省了多少秒。
选择资源时可以分别考虑“单个任务尽快完成”和“同时完成更多独立任务”。八卡计算更快,并不自动说明把八张卡都放在一个小任务上最合适。大量独立的秒级小任务,应同时考虑作业启动时间、排队情况和任务分配方式。
7.2 P100 和 V100 的参数需要分别比较#
本批三档网格、六种规模、四种卡数形成 72 组对应资源对照。在每组各自选择最快已测参数后,V100 的时间均短于 P100。例如密网格 144 原子八卡,P100 为 112.30 秒,V100 为 71.13 秒;Γ 单点 216 原子八卡分别为 46.30 秒和 32.74 秒。
这个比较代表本集群这两台节点及其软件环境的整体表现。GPU 型号、节点 CPU 和多卡互联都不同,不能仅凭这些总时间把全部差异归到某一个硬件因素。对用户更直接的启示是:换到另一种 GPU 后,保留科学输入,重新检查 KPAR 和 NSIM。
7.3 哪些经验可以直接用,哪些需要自己验证#
可直接用于本文标准配置的操作规则是:每卡一个 MPI 进程;KPAR 整除进程数;Γ 单点保持 KPAR=1;GPU 程序使用 NCORE=1。VASP 官方 GPU 文档也要求每个 GPU 一个 MPI 进程,并指出 KPAR、NSIM 的较优值随体系和负载变化。
本文时间和参数来自 Si、PBE、ALGO=Normal、非磁性普通版 vasp_std。更换材料、ENCUT、NBANDS、真空层、算法,或使用磁性、SOC、杂化泛函及扩展功能后,应以自己的短试算决定最终组合。参数表可以缩小候选范围,但不能保证其他计算达到同一秒数或同一最优值。显存是否足够也要在实际配置中确认,不能从最短时间反推。
8. 参数速查:六种规模、三档网格与四种卡数#
每格格式为“时间(秒);KPAR/NSIM”。例如“140.318;2/32”表示该资源组最快已测时间为 140.318 秒,配置为 KPAR=2、NSIM=32。
下表联合考虑 KPAR 与 NSIM,因此可能与固定 NSIM=32 的 KPAR 图选出不同分组。表中三位小数用于准确对应数据,不表示近似时间差具有相同的统计确定性。
较疏网格 · P100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 64 | 96.730;1/32 | 51.574;2/32 | 30.579;4/32 | 18.675;8/8 |
| 32 | 16 | 69.169;1/16 | 43.784;2/16 | 31.865;4/8 | 24.744;4/16 |
| 64 | 8 | 77.902;1/16 | 54.375;2/16 | 41.681;2/16 | 27.852;2/8 |
| 96 | 8 | 148.122;1/16 | 98.233;2/32 | 74.141;2/32 | 48.338;2/16 |
| 144 | 8 | 266.572;1/16 | 175.106;2/16 | 130.392;2/16 | 83.955;2/32 |
| 216 | 8 | 486.089;1/32 | 306.015;2/32 | 225.690;2/16 | 140.318;2/32 |
较疏网格 · V100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 64 | 80.320;1/32 | 44.337;2/32 | 25.745;4/8 | 15.898;8/8 |
| 32 | 16 | 55.014;1/16 | 35.259;2/16 | 27.054;4/32 | 19.790;4/16 |
| 64 | 8 | 62.082;1/16 | 44.707;2/16 | 30.798;1/16 | 20.289;2/16 |
| 96 | 8 | 111.083;1/16 | 79.688;2/16 | 51.128;1/16 | 32.803;2/16 |
| 144 | 8 | 194.552;1/16 | 135.786;2/16 | 85.569;1/16 | 54.952;2/32 |
| 216 | 8 | 354.889;1/32 | 242.937;2/16 | 142.718;1/32 | 90.478;2/32 |
Γ 单点 · P100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 1 | 5.585;1/4 | 3.832;1/8 | 2.890;1/8 | 3.173;1/16 |
| 32 | 1 | 17.216;1/64 | 11.562;1/16 | 7.593;1/8 | 6.315;1/16 |
| 64 | 1 | 30.313;1/64 | 20.289;1/16 | 13.693;1/16 | 9.773;1/16 |
| 96 | 1 | 56.521;1/64 | 37.520;1/64 | 23.138;1/16 | 16.453;1/8 |
| 144 | 1 | 96.861;1/64 | 61.879;1/64 | 40.515;1/32 | 26.941;1/16 |
| 216 | 1 | 162.252;1/64 | 106.825;1/64 | 68.712;1/64 | 46.297;1/16 |
Γ 单点 · V100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 1 | 5.052;1/4 | 3.622;1/8 | 2.446;1/8 | 2.623;1/4 |
| 32 | 1 | 15.069;1/16 | 10.143;1/16 | 6.336;1/8 | 4.990;1/8 |
| 64 | 1 | 27.478;1/64 | 17.554;1/16 | 10.773;1/8 | 7.833;1/16 |
| 96 | 1 | 48.020;1/32 | 30.296;1/16 | 17.450;1/16 | 12.171;1/16 |
| 144 | 1 | 79.256;1/32 | 50.169;1/32 | 28.624;1/32 | 19.440;1/16 |
| 216 | 1 | 126.523;1/64 | 85.281;1/64 | 52.393;1/16 | 32.744;1/16 |
较密网格 · P100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 125 | 178.613;1/32 | 94.429;2/32 | 53.188;4/32 | 31.692;8/32 |
| 32 | 45 | 164.662;1/16 | 94.457;2/16 | 59.390;4/16 | 41.826;8/16 |
| 64 | 27 | 195.037;1/16 | 115.412;2/16 | 77.288;4/16 | 58.021;8/16 |
| 96 | 18 | 275.779;1/16 | 161.978;2/32 | 116.018;4/32 | 89.044;2/32 |
| 144 | 12 | 363.304;1/16 | 223.309;2/16 | 159.575;4/16 | 112.299;4/32 |
| 216 | 8 | 483.630;1/32 | 310.368;2/16 | 224.380;4/32 | 140.130;2/32 |
较密网格 · V100#
| 原子数 | NKPTS | 1卡:秒;KPAR/NSIM | 2卡:秒;KPAR/NSIM | 4卡:秒;KPAR/NSIM | 8卡:秒;KPAR/NSIM |
|---|---|---|---|---|---|
| 8 | 125 | 149.415;1/32 | 80.508;2/32 | 45.157;4/32 | 27.054;8/8 |
| 32 | 45 | 131.169;1/16 | 76.666;2/16 | 48.452;4/16 | 33.916;8/16 |
| 64 | 27 | 147.735;1/16 | 91.316;2/8 | 62.266;4/8 | 46.338;4/16 |
| 96 | 18 | 199.038;1/16 | 124.826;2/16 | 92.428;4/32 | 58.109;2/16 |
| 144 | 12 | 256.890;1/16 | 168.089;2/16 | 116.209;1/16 | 71.127;2/32 |
| 216 | 8 | 354.467;1/32 | 242.911;2/16 | 145.880;1/16 | 90.384;2/32 |
9. 实际操作:修改资源、短试算、确认结果#
9.1 先获取与账户、GPU 和版本匹配的模板#
在集群运行 yskit,进入“复制 Slurm 脚本”,选择 VASP、程序版本及节点类型。使用对应账户的队列模板,可以避免 GPU 类型、队列名称与程序模块不匹配。
本集群标准模板加载相应 VASP module,由模块准备编译器、MPI 和库环境。不要在同一脚本中再随意加载另一套 MPI 或编译器。GPU 版不沿用 CPU 的 NCORE=7、14 等分组;本文配置显式使用 NCORE=1,INCAR 中无需额外手工设置 NPAR。
9.2 增加卡数时,同步修改 MPI 进程数#
以下是核时账户、P100 双卡、普通 VASP 6.6.1的示例。其他账户或 GPU 应使用自己的对应模板。
#!/bin/bash
#SBATCH --job-name=vasp_gpu
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --cpus-per-task=1
#SBATCH --ntasks=2
#SBATCH --gres=gpu:p100-16g:2
#SBATCH --output=%j.out

module load vasp/6.6.1-p100 || exit $?
export NO_STOP_MESSAGE=1
VASP_BIN="${VASP_ROOT}/vasp_std"
export OMP_NUM_THREADS="${SLURM_CPUS_PER_TASK}"

mpirun --bind-to none -np "${SLURM_NTASKS}" "${VASP_BIN}"
改为四卡时,把 --ntasks=2 和 --gres=gpu:p100-16g:2 中的数量都改成 4;改为八卡则都改成 8。--cpus-per-task=1 继续保持每个 MPI 进程一个 CPU 核心,与本文测试条件一致。
V100-16GB 核时模板使用 gpu-8v100-16g-hs 队列、gpu:v100-16g:N 资源和 vasp/6.6.1-v100 模块;套餐账户应从 yskit 获取对应套餐队列模板。实际卡数由 Slurm 分配,INCAR 的 KPAR 决定这些进程怎样分组。
双卡的一个起始并行配置为:
KPAR = 2
NCORE = 1
NSIM = 32
这三行需要与其他科学参数合并使用。Γ 单点应把 KPAR 改为 1;四/八卡需要按 NKPTS 和负载重新比较合法候选,不能只照抄双卡设置。
9.3 用少量候选完成自己的调参#
- 准备可比较的输入。 保持 POSCAR、POTCAR、KPOINTS、ENCUT、算法和收敛要求一致;各候选采用同样的启动方式,避免一组从已有 WAVECAR 开始、另一组从头开始。
- 确认实际工作量。 查看 NKPTS、实际 NBANDS 和完成的电子步数。并行配置可能影响自动补齐的 NBANDS,若实际能带数不同,就不能把全部时间差解释为参数加速。
- 固定 NSIM 比 KPAR。 多 k 点计算可先固定 NSIM=32,按第 1、2 节选两三个分组;Γ 单点跳过这一轮,保持 KPAR=1。
- 固定较优 KPAR 比 NSIM。 先测 16、32;按结果增加 8、64,极小负载可增加 4。比较同一工作量的时间,同时观察显存余量。
- 交叉确认。 用选出的 NSIM 复核其他有竞争力的 KPAR;时间很接近时再测一次。最后检查正常退出、收敛状态、能量与力是否满足计算要求,再用于正式任务。
试算可以使用固定的少量电子步,但各组应完成相同工作量。若只为计时调整了 NELM/NELMIN,应在正式计算时恢复自己的收敛设置。VASP 官方也建议使用接近真实任务的短计算比较候选,并在目标硬件上选择参数。
9.4 用哪个时间比较#
查看 OUTCAR 的 LOOP+ 行:
grep 'LOOP+:' OUTCAR
比较 real time 后面的秒数。本文固定结构算例只有一条 LOOP+,对应完整 30 步自洽及相关后处理阶段。多离子步的结构优化会有多条 LOOP+;可以比较总和,也可以比较电子步数相近的稳定离子步,但需要在所有候选中采用同一口径。
OUTCAR 尾部的 Elapsed time 包含更完整的程序墙钟时间,适合衡量从启动到退出的成本。若关心的是作业总耗时,也可以看它;但不要把它与本文图中的 LOOP+ 混合比较。最快参数也必须通过计算完整性和数值检查,提前停止的输出不能作为成功的性能结果。
合集
《VASP GPU 加速专题一:发展历程、GPU选型》
《VASP GPU 加速专题二:VASP 多版本与扩展功能支持》
《VASP GPU 加速专题三:性能实测》
《VASP GPU 加速专题四:计算准确性》
《VASP GPU 加速专题五:加速参数选择》
《VASP GPU 加速专题六:显存容量规划》