
VASP GPU 加速专题三:性能实测
比较CPU与P100、V100完成时间及参考核时。
阅读本篇目录
1. 先看结论:哪些资源更快,哪些更省#
对这套 Si 测试,有三条适合用来确定候选资源的观察:
- 小体系优先考虑 CPU。 很小的 Γ 单点任务中,CPU56 核同时具有速度与核时优势;即使使用八张 GPU,也未必缩短完整程序时间。
- 较大体系值得考虑 GPU 多卡。 在较疏、较密网格的较大体系中,V100 四/八卡明显缩短计算时间;大体系 Γ 单点也能受益于多卡协作。
- 预算优先与时间优先要分开选择。 本批每个体系/网格中,最少核时消耗的配置都是 CPU56 核或单卡 GPU;四/八卡主要用于缩短单个任务的时间。
这些是当前 Si 输入、软件与节点条件下的实测趋势。原子数只是工作量的一部分,实际 k 点数、能带数、泛函和算法同样会改变结果。
图 P1:速度总览:计算阶段与完整程序#
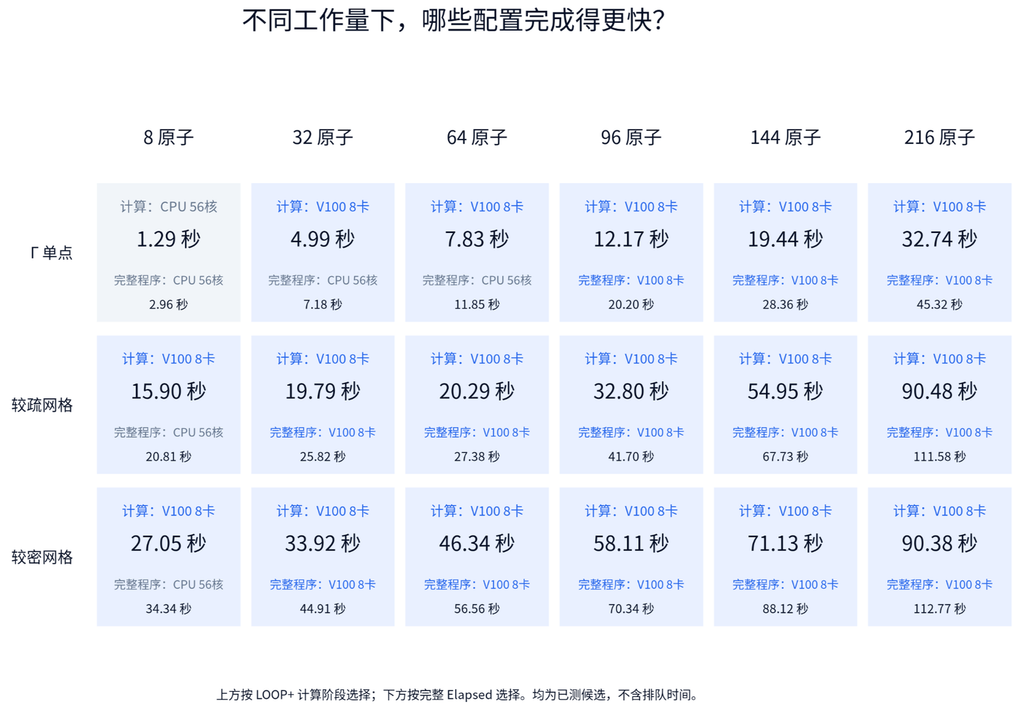
每格上方是在九种选定资源配置中,LOOP+ 计算阶段最短的候选;下方是完整程序 Elapsed 最短的候选。秒数越小越快。两种计时可能选出不同资源;图中均未计入排队时间。
为什么同时列两种时间? 例如 32 原子 Γ 单点,CPU 计算阶段为 5.25 秒,V100 八卡为 4.99 秒,二者接近;完整程序却分别为 7.18 秒和 12.39 秒。小任务中,初始化与结束阶段足以改变结果。客户关心从程序启动到退出要等多久时,应看完整程序时间。
如果只希望判断核时,直接看第 4 节总览;需要比较不同卡数,查看第 5 节的六面板柱状图。第 6 节用一个 216 原子算例解释怎样在等待时间与预算之间取舍。
2. 测试工作量与图中的时间#
2.1 测试节点及资源#
| 平台 | 测试节点 | 资源配置 | 编译与运行环境 |
|---|---|---|---|
| CPU 8173m | ccn001-8173m | 单节点 56 个 MPI 进程,每进程 1 个 CPU 核心 | VASP 6.6.1;oneAPI 2024.2、Intel MPI、MKL |
| P100 | gcn001-8p100 | PCIe 16GB;1/2/4/8 卡,每卡 1 个 MPI 进程、1 个 CPU 核心 | VASP 6.6.1 OpenACC;NVHPC 25.3、CUDA 12.8、配套 MPI、MKL 2023.2 |
| V100 | gcn001-8v100-16g | SXM2 16GB;1/2/4/8 卡,每卡 1 个 MPI 进程、1 个 CPU 核心 | VASP 6.6.1 OpenACC;NVHPC 25.3、CUDA 12.8、配套 MPI、MKL 2023.2 |
GPU 使用默认通信设置,默认功耗上限为 P100 250W、V100 300W。本文 V100 的实测设备为 16GB 节点。V100 32GB 套餐资源具有更大显存,但本组数据不是32GB资源的独立性能测试,不能直接保证两者实际完成时间相同。
2.2 六种原子规模、三档 k 网格#
测试结构由金刚石 Si 的常规 8 原子晶胞扩胞得到,参考晶格常数 5.43Å,三个方向施加 0.99/1/1.01 的固定缩放。每档网格内,CPU 与 GPU 使用相同结构、赝势、k 点输入和实际 NBANDS。
| 原子数 | 实际 NBANDS | Γ 网格/NKPTS | 疏网格/NKPTS | 密网格/NKPTS |
|---|---|---|---|---|
| 8 | 56 | 1×1×1/1 | 6×6×6/64 | 8×8×8/125 |
| 32 | 112 | 1×1×1/1 | 6×3×3/16 | 8×4×4/45 |
| 64 | 168 | 1×1×1/1 | 3×3×3/8 | 4×4×4/27 |
| 96 | 280 | 1×1×1/1 | 3×3×2/8 | 4×4×3/18 |
| 144 | 392 | 1×1×1/1 | 3×2×2/8 | 4×3×3/12 |
| 216 | 560 | 1×1×1/1 | 2×2×2/8 | 3×3×3/8 |
NKPTS 是 VASP 实际计算的不可约 k 点数,不能直接用网格乘积代替。较疏网格各方向 k×a 约 32.25~32.91Å,作为结构优化用途的性能参考;较密网格约 43.01~49.36Å,作为电子结构用途的性能参考。网格精度仍需根据材料做收敛测试,不能只根据时间选择。
| 科学设置 | 本测试采用的值 |
|---|---|
| 程序 | 普通版 vasp_std;Γ 数据同样使用 std |
| 赝势与截断能 | PAW_PBE 标准 Si 05Jan2001;ENCUT=350eV |
| 电子算法 | ALGO=Normal;ISMEAR=0;SIGMA=0.1 |
| 其他设置 | LREAL=Auto;ISYM=2;非磁性、无 SOC |
| 工作量 | 固定结构静态计算;NELM=NELMIN=30,完成 30 个电子步;从相同初始方式开始 |
| 并行参数 | 各资源配置采用已经测过且通过完整性与数值检查的较优候选;CPU 调整 KPAR/NCORE,GPU 调整 KPAR/NSIM |
固定 30 步是用于公平计时的工作量,不是生产计算的收敛建议。这里也未执行完整的结构优化、DOS 或能带工作流。小体系的 NBANDS 包含为比较并行配置而保留的额外空带,不能把秒数直接套到另一份默认能带输入上。
2.3 读图时区分两种时间#
| 指标 | 包含什么 | 主要用途 |
|---|---|---|
| LOOP+ real time | 这一静态计算的电子自洽及力等后处理阶段 | 比较计算阶段性能,与参数选择图保持同一口径 |
| Elapsed time | 从 VASP 程序启动到正常退出的完整墙钟时间 | 比较完整程序耗时,并折算本文参考核时 |
| 实际 Slurm 运行时间 | 整个作业脚本执行时间,可能包含 VASP 之外的处理 | 真实作业计费;本文没有实际扣费记录 |
图 P2~P4 用深色短条表示 LOOP+,浅色长条表示完整 Elapsed,每行数字按“计算阶段/完整程序”排列,单位均为秒。图 P6~P8 则使用完整 Elapsed 计算参考核时。所有柱状图横轴从 0 开始,六个面板各自设置范围,跨原子规模请读数字。
全文共比较 162 组选定资源配置:3 档网格 × 6 种规模 × 9 种资源。每个候选只有一次有效测量;近似时间差不代表已经确认的稳定排名。选定参数按最快有效 LOOP+ 筛选,没有另做“最少费用参数”的全组合搜索。
3. 性能实测:CPU 与单/双/四/八卡怎样比较#
3.1 Γ 单点:小体系适合 CPU,大体系仍有多卡空间#
图 P2:Γ 单点:计算阶段与完整程序耗时#
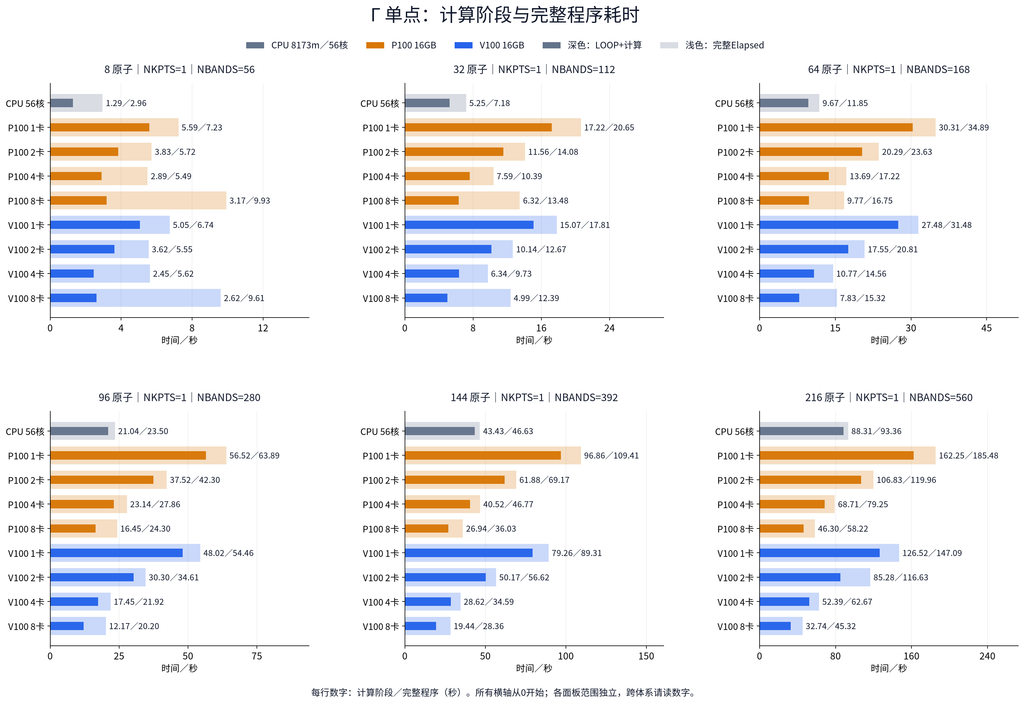
六个面板分别对应六种原子规模。深色是计算阶段、浅色是完整程序;每行数字是两者的秒数。Γ 单点 NKPTS=1,各 GPU 配置使用 KPAR=1。
8 原子:CPU 优势明显,八卡没有带来收益。 CPU 计算阶段仅 1.29 秒,P100 四卡为 2.89 秒,V100 四卡为 2.45 秒。两种 GPU 从四卡增加到八卡后,时间分别变为 3.17 和 2.62 秒,未继续缩短。完整程序的 CPU 也最短。这种秒级小负载不宜只为单个任务申请大量 GPU。
32、64 原子:计算阶段已接近,但启动开销不能忽略。 32 原子 CPU/V100 八卡的 LOOP+ 为 5.25/4.99 秒;64 原子为 9.67/7.83 秒。V100 八卡的计算阶段更短,完整程序却仍由 CPU 更快。对这种短任务,应该把完整时间与核时一起考虑,不只看 GPU 核心计算阶段。
96 原子:八卡开始缩短完整程序时间。 CPU 的计算阶段/完整时间为 21.04/23.50 秒,V100 八卡为 12.17/20.20 秒。优势比小体系更清楚,但八卡的核时也明显增加,是否采用要看时间目标。
144、216 原子:多卡协作更有价值。 216 原子 CPU 计算阶段为 88.31 秒,P100 四/八卡为 68.71/46.30 秒,V100 四/八卡为 52.39/32.74 秒。Γ 单点没有 k 点组间并行,但较大的能带工作量仍可让同组多卡受益。
对自己的 Γ 单点任务,先保持 KPAR=1,再比较卡数与 NSIM。本文使用 vasp_std,没有把专用 vasp_gam 的性能混入这些结果。
3.2 较疏网格:GPU 优势随单个 k 点的工作量增加而更明显#
图 P3:较疏网格:计算阶段与完整程序耗时#
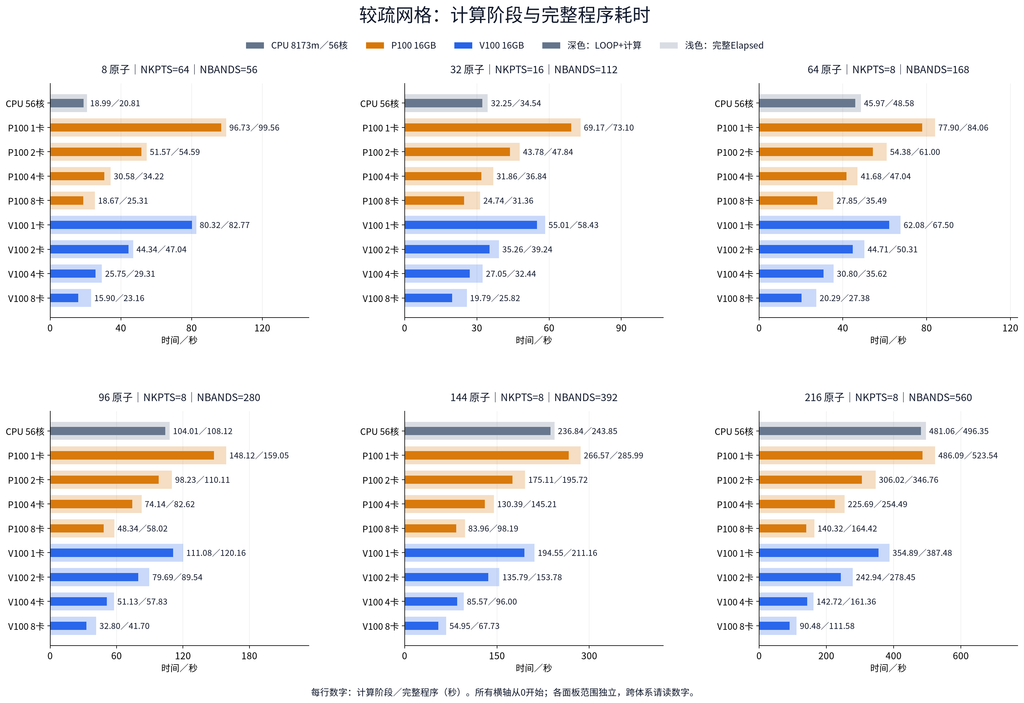
这一档对应较疏网格。每个规模的实际 NKPTS、NBANDS 在面板标题中给出;CPU 与各卡数均使用本批已测较优参数。数字为计算阶段/完整程序秒数。
8 原子、64 个 k 点:CPU 仍有很强竞争力。 CPU LOOP+ 为 18.99 秒,P100 八卡为 18.67 秒,两者接近;V100 八卡为 15.90 秒。但完整程序 CPU 为 20.81 秒,仍短于 V100 八卡的 23.16 秒。这里不能把 GPU 的计算阶段优势直接解释为完整任务更快。
32、64 原子:四卡或八卡更值得比较,单卡未必快。 32 原子 CPU/P100 单卡/V100 单卡的 LOOP+ 为 32.25/69.17/55.01 秒,单卡均较慢;V100 四/八卡缩短到 27.05/19.79 秒。64 原子 V100 双卡与 CPU 的计算阶段接近,四/八卡则更快。短试算时应比较实际完整时间,再决定是否加卡。
96 原子:V100 双卡以上已经具有较明显收益。 CPU 计算阶段为 104.01 秒,V100 双/四/八卡分别为 79.69/51.13/32.80 秒。P100 双卡的 LOOP+ 略短于 CPU,但完整程序为 110.11 秒,比 CPU 的 108.12 秒略长。这再次说明应按客户关心的时间口径比较。
144、216 原子:V100 单卡开始同时提供速度收益,多卡继续缩短时间。 216 原子 CPU 计算阶段为 481.06 秒,P100 单卡为 486.09 秒,二者接近;V100 单卡为 354.89 秒。使用 V100 四/八卡后降为 142.72/90.48 秒。工作量增加以后,GPU 计算的收益更容易覆盖运行与通信开销。
这批结果支持把较大体系的四/八卡作为时间优先候选,但不支持把“单卡 GPU 一定比 CPU56 核快”作为默认规则。KPAR 和 NSIM 的选择也会改变多卡结果,具体方法见GPU 参数选择帮助。
3.3 较密网格:k 点增加,也改变了较优资源配置#
图 P4:较密网格:计算阶段与完整程序耗时#
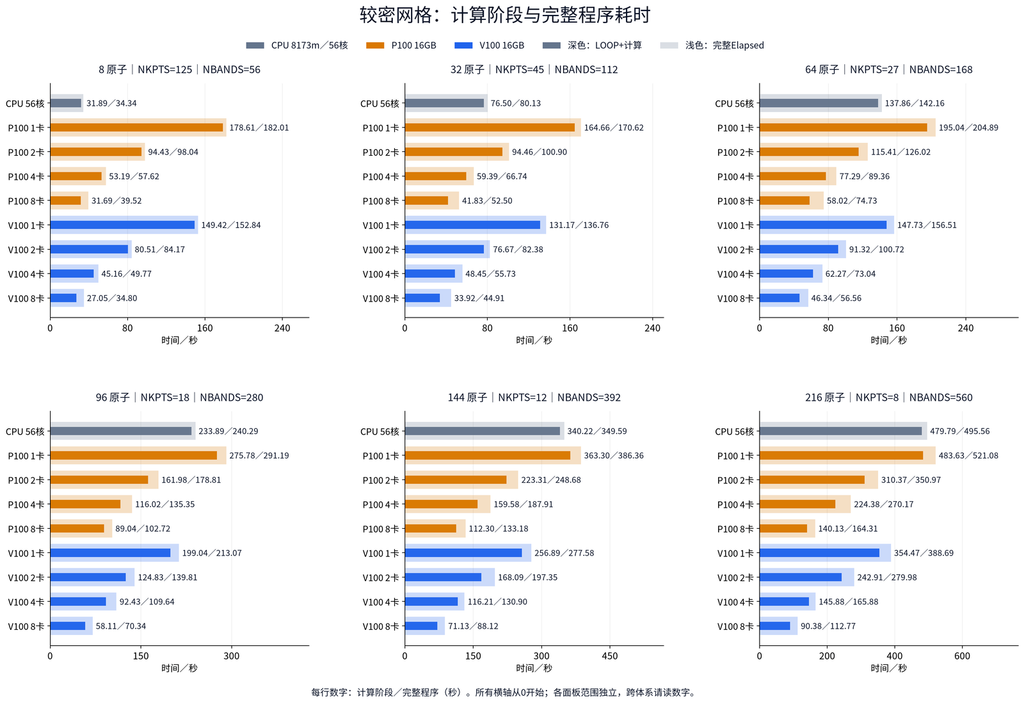
较密网格的 NKPTS 依次为 125、45、27、18、12、8。时间只与同一面板中的 CPU/GPU 配置比较;不把减少 k 点当作加速方案。
8 原子:较多 k 点有利于 GPU 分组,但完整任务仍需看 CPU。 CPU/V100 八卡的计算阶段为 31.89/27.05 秒,完整时间为 34.34/34.80 秒。完整时间非常接近,不能根据一次计时认定稳定胜负;CPU 的参考核时则明显更少。
32、64 原子:GPU 多卡的计算优势更清楚。 32 原子 CPU 为 76.50 秒,V100 四/八卡为 48.45/33.92 秒;64 原子 CPU 为 137.86 秒,V100 双/四/八卡为 91.32/62.27/46.34 秒。相同原子数下,增加实际 k 点工作量后,多卡配置值得重新调参。
96、144、216 原子:V100 单卡和多卡都有可比较的收益。 96 原子 CPU/V100 单卡为 233.89/199.04 秒;144 原子为 340.22/256.89 秒。216 原子 CPU 为 479.79 秒,V100 四/八卡为 145.88/90.38 秒。
216 原子疏、密网格虽然不同,实际 NKPTS 都是 8,NBANDS 都是 560,所以时间接近。它们的采样坐标和权重仍不同,不能由耗时接近推断采样精度相同。三档网格都应先满足科学精度,再选择计算资源。
3.4 为什么这些趋势会出现#
GPU 需要足够的工作量来发挥计算能力。很小的体系或很少的能带,计算收益可能难以覆盖运行与多卡协作开销;k 点较多时,可以将工作分配到不同 k 点组,较大的能带工作量也更容易受益于 GPU 运算。这些解释与本批时间趋势一致,但计时结果本身没有分解各类通信、FFT 和矩阵运算所占的比例。
CPU 与 GPU 均使用各自较优的已测参数,因此这些图展示的是用户完成同一任务时可选择的配置,不是固定全部并行参数的严格扩展性实验。V100 节点整体比 P100 更快的结果,也包含节点 CPU、GPU 型号、多卡互联与工具链的共同影响。
4. 核时怎样计算:先看预算总览#
4.1 本集群的核时规则#
核时按作业运行时间逐秒累计,没有最低扣费。8173m 为独占整节点,按 56 核计费;GPU 采用每卡等效核数,配套 CPU 不再另外收费。
| 资源 | 计费等效核数 | 运行 T 秒的核时 |
|---|---|---|
| CPU 8173m 整节点 | 56 | 56 × T / 3600 |
| P100 16GB,G 张卡 | 24 × G | 24 × G × T / 3600 |
| V100 16GB,G 张卡 | 32 × G | 32 × G × T / 3600 |
核时不是 GPU 运行小时,也不是钱数。 核时费用等于消耗核时乘以账户适用的每核时单价。在同一单价下,核时越少,费用越低。
以下图表使用同一选定配置的完整 VASP Elapsed 折算,称为“参考核时”。真实扣费以 Slurm 整个作业的运行时间为准,脚本中的预处理、后处理等也应计入。表格与图中的小数位用于展示,不表示按这个位数取整收费。套餐固定月费和 V100 32GB 套餐资源应按实际服务规则考虑,不能从本批 16GB 核时图直接推算。
4.2 看一张图,确定省核时的起始方向#
图 P5:核时总览:最少参考核时的候选#
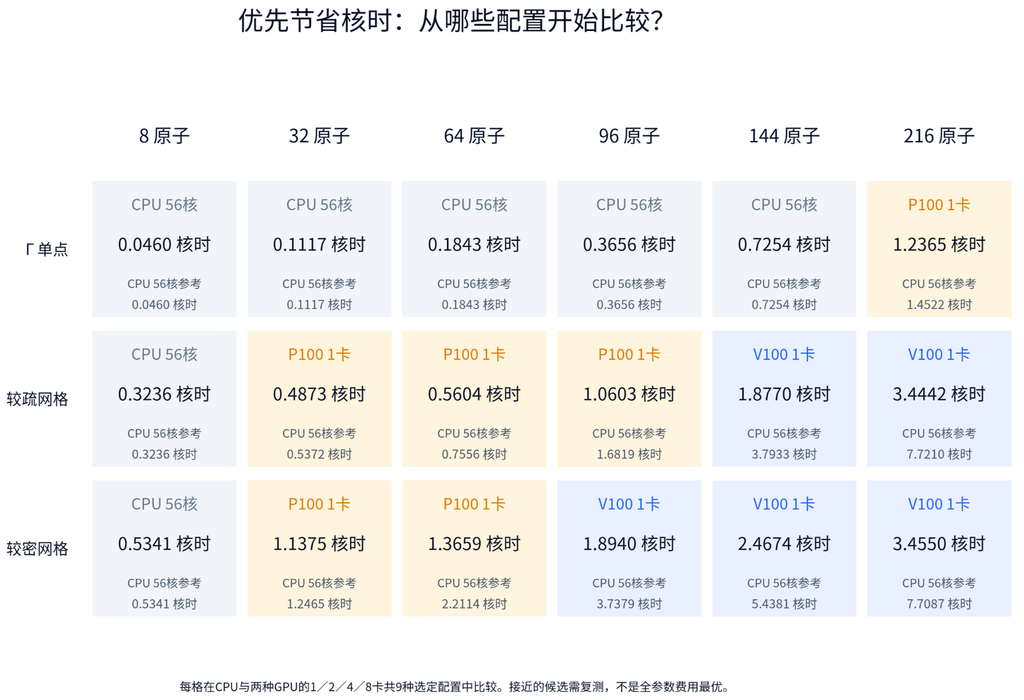
每格在 CPU56 核和两种 GPU 的单/双/四/八卡,共九种选定配置中比较。大字给出最少参考核时的候选,小字给出同一体系的 CPU 基准。颜色对应资源类型,不表示统计置信度。
Γ 单点:8~144 原子优先从 CPU 比较。 其中 144 原子 CPU 为 0.7254 核时,P100 单卡为 0.7294 核时,差异很小,应视为近似候选。216 原子 P100 单卡为 1.2365 核时,低于 CPU 的 1.4522 核时。
较疏、较密网格:8 原子 CPU 更省,32~216 原子单卡 GPU 更值得作为预算候选。 注意图中“最少”的资源不一定计算最快。例如 32 原子疏网格 P100 单卡计算阶段慢于 CPU,但因计费等效核数较少,参考核时仍较低。
P100 与 V100 接近时,不必过度解读排名。 比如 216 原子疏网格的 P100/V100 单卡为 3.4903/3.4442 核时;差异小于换成多卡带来的资源消耗变化。一次测试应把接近的配置保留为候选,再按自己的输入复测。
5. 各规模、各节点的核时消耗#
下面三张图将每个原子规模单独画成面板,每个面板都列 CPU56 核、P100 单/双/四/八卡、V100 单/双/四/八卡。柱越短、数字越小,参考核时越少。 可以先定位自己的原子规模,再在同一个面板比较资源,无需从大表中逐项寻找。
5.1 Γ 单点:多卡缩短计算时间,不代表少用核时#
图 P6:Γ 单点:不同配置的核时消耗#
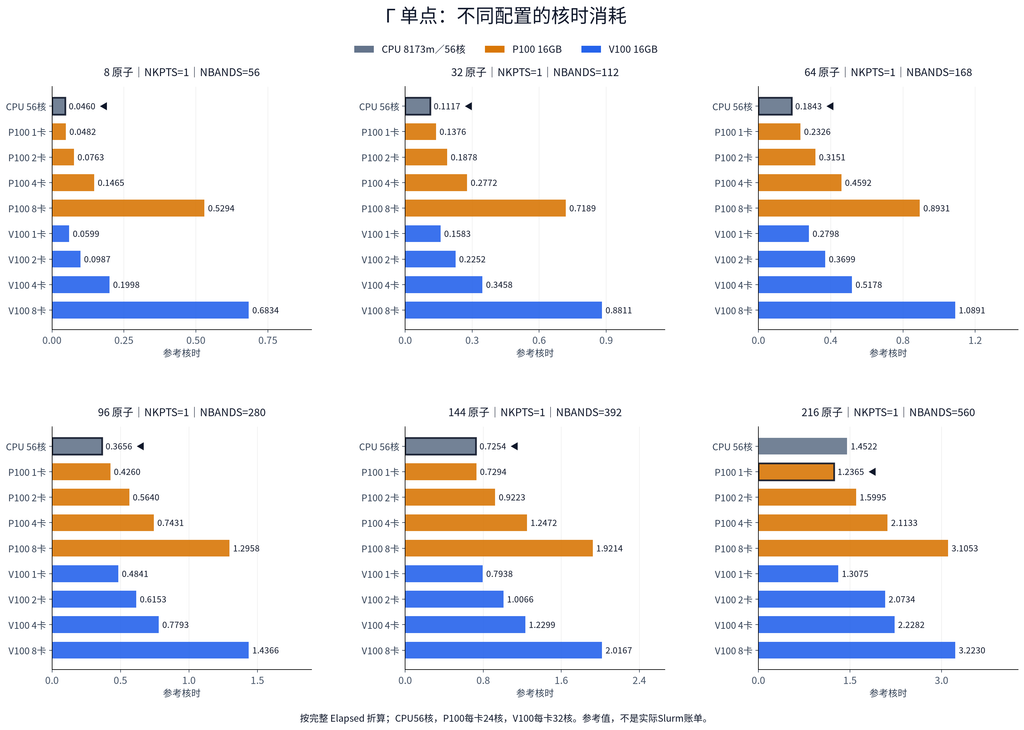
每个面板包含全部九种选定资源。深边框与三角标记表示最少参考核时的候选;各面板横轴范围独立,均从 0 开始。
8、32、64、96 原子均以 CPU 的参考核时较少。虽然 GPU 多卡可以缩短其中一些算例的计算阶段,但增加计费等效核数后,并没有成为更省核时的选择。
144 原子的 CPU 和 P100 单卡参考核时几乎相同;CPU 比 GPU 单卡更快,因此在本批短任务中 CPU 值得优先考虑。216 原子开始出现单卡 GPU 节省核时:CPU/P100 单卡/V100 单卡分别为 1.4522/1.2365/1.3075 核时。
但 216 原子 V100 四/八卡会增加到 2.2282/3.2230 核时。它们完成计算更快,适合有时间要求的任务;若只追求这一批工作量的核时最低,单卡更值得比较。
5.2 较疏网格:单卡预算优势与多卡时间收益可以同时存在#
图 P7:较疏网格:不同配置的核时消耗#
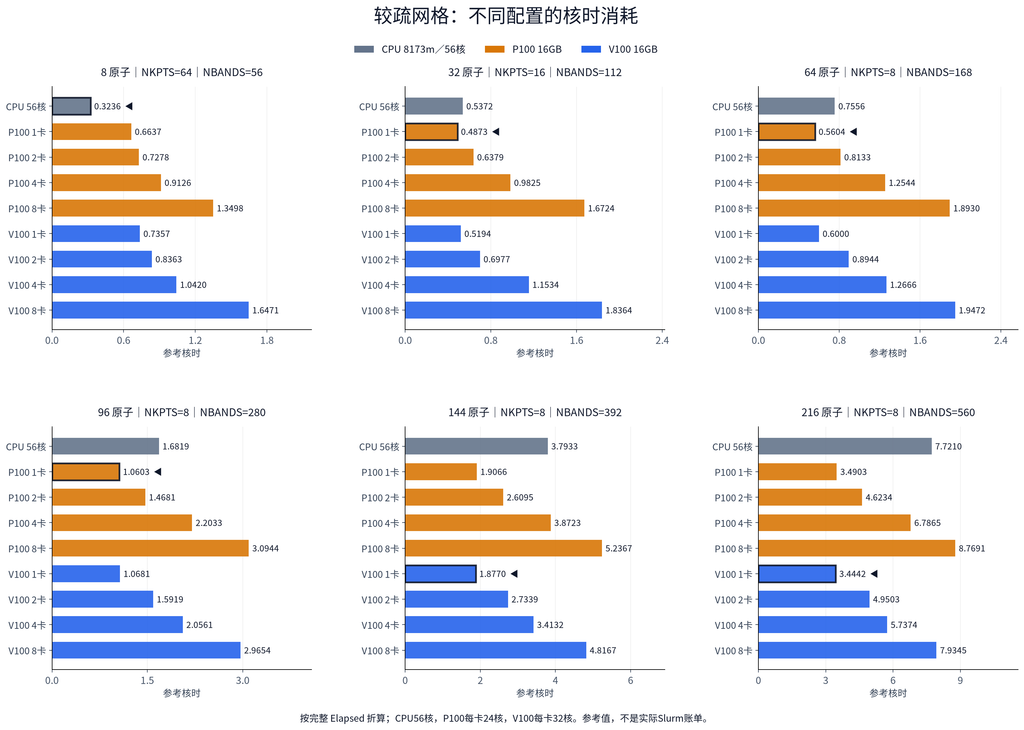
较疏网格六种规模的完整程序参考核时。所有核算使用同一科学工作量、各资源的选定参数,GPU 的配套 CPU 不另收费。
8 原子:CPU 更省。 CPU 为 0.3236 核时,P100/V100 单卡为 0.6637/0.7357 核时;多卡又继续增加资源消耗。这个算例不要仅因 GPU 计算阶段更短就忽略 CPU。
32、64、96 原子:P100 单卡是预算比较的起点。 96 原子 CPU/P100 单卡/V100 单卡分别为 1.6819/1.0603/1.0681 核时,两种 GPU 单卡非常接近。更快的 V100 在每卡 32 核的计费规则下,未必比按 24 核计费的 P100 更省。
144、216 原子:单卡 GPU 相对 CPU 的预算优势更加清楚。 216 原子 CPU 为 7.7210 核时,P100/V100 单卡为 3.4903/3.4442 核时。四卡仍可以在少于 CPU 核时的同时缩短时间;八卡则需要重新判断是否值得为更短时间增加核时,第 6 节给出具体对照。
5.3 较密网格:单卡 GPU 可作为较大体系的预算候选#
图 P8:较密网格:不同配置的核时消耗#
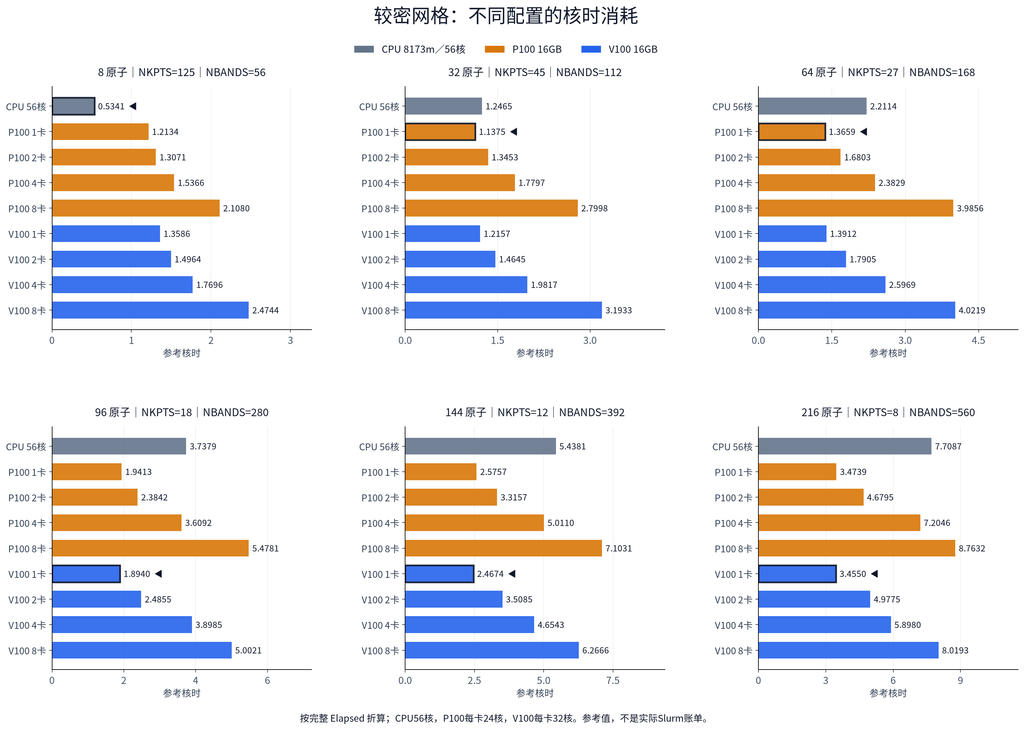
较密网格六种规模的参考核时。P100 与 V100 采用不同每卡等效核数,所以不能只比较运行秒数来判断核时。
8 原子仍由 CPU 最少用核时。32、64 原子的选定配置中,P100 单卡参考核时最少;64 原子 P100/V100 单卡为 1.3659/1.3912 核时,仍属于接近的候选。
96、144、216 原子的选定配置中,V100 单卡参考核时最少。例如 144 原子 CPU/P100 单卡/V100 单卡为 5.4381/2.5757/2.4674 核时;216 原子为 7.7087/3.4739/3.4550 核时。
多卡在速度图中很有吸引力,但每卡等效核数也随卡数一起增加。因此应在同一面板确认对应核时,再决定是否为时间收益付出更多资源。这里的候选分界不是所有材料都适用的固定原子数阈值。
6. 一个清楚的例子:216 原子怎样在时间与预算间选择#
图 P9:216原子:完整时间与核时的选择#
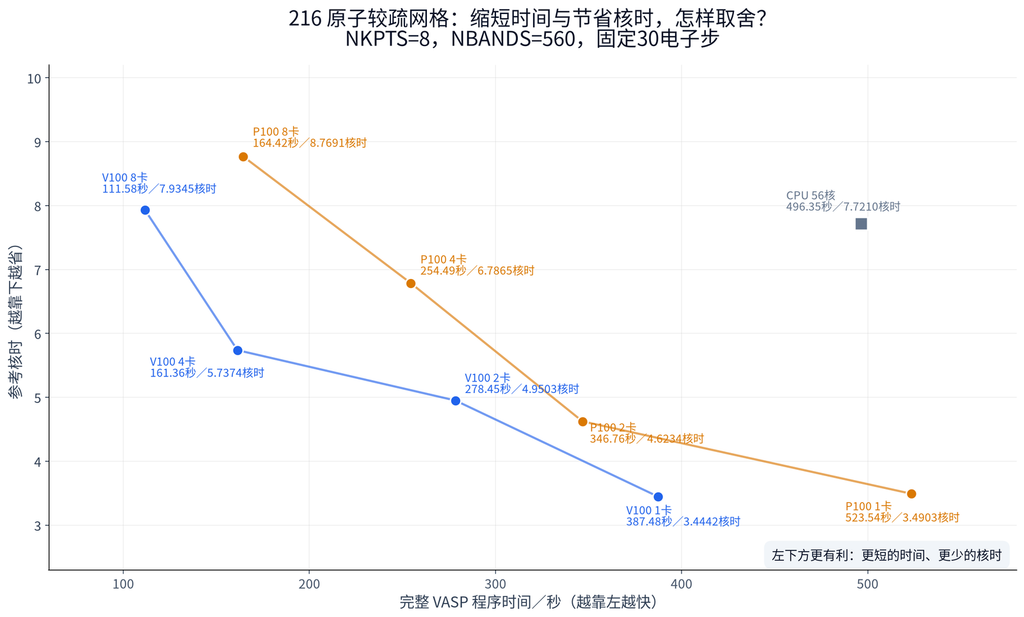
横轴是完整程序秒数,越靠左越快;纵轴是参考核时,越靠下越省。每个点为同一 216 原子疏网格算例的一种选定资源,连线依次连接同平台的单/双/四/八卡。
从这张图可以直接看到三种选择:
- 预算优先: 单卡 GPU 位于图的下方,参考核时少,但完成时间较长。
- 兼顾时间与预算: 四卡 V100 比 CPU 更靠左也更靠下,在本批算例中同时缩短完整时间、减少参考核时。
- 时间优先: 八卡 V100 最靠左,完成最快,但位置更高,核时多于四卡,也略多于 CPU。
用少量关键数字对照:
| 资源 | 完整程序时间/秒 | 参考核时 |
|---|---|---|
| CPU 56核 | 496.35 | 7.7210 |
| P100 1卡 | 523.54 | 3.4903 |
| V100 1卡 | 387.48 | 3.4442 |
| V100 4卡 | 161.36 | 5.7374 |
| V100 8卡 | 111.58 | 7.9345 |
V100 从单卡改为四卡,完整时间由 387.48 秒缩短到 161.36 秒,参考核时由 3.4442 增至 5.7374。改为八卡后,时间继续缩短到 111.58 秒,参考核时增至 7.9345。客户可以据此判断,节省的等待时间是否值得增加资源。
6.1 为什么更快的 V100 不一定更省核时#
同样卡数下,P100 按每卡 24 核、V100 按每卡 32 核折算。V100 的完整运行时间需要低于 P100 的 75%,才会在相同核时单价下用更少核时。这个判断来自计费公式,与显卡型号的理论峰值无关。
216 原子疏网格单卡中,V100 足够快,使其核时略少于 P100;96 原子疏网格中,两者核时几乎相同。因此选择资源时应该比较“时间 × 计费等效核数”,不能只看更短的秒数。
6.2 为什么不能只用 LOOP+ 判断预算#
216 原子疏网格 V100 八卡的 LOOP+ 为 90.48 秒,完整程序为 111.58 秒。初始化和结束阶段同样占用已申请资源,核时应按完整作业时间累计。对短任务,忽略这些阶段可能改变预算结论。
本测试只包含固定 30 步,完整程序的额外阶段占比可能高于长时间生产作业。因此这些核时可以用于选择短试算方向,但不能简单乘一个系数就当作完整结构优化或长时间计算的实际费用。
7. 将结果用于自己的计算#
7.1 怎样确定试算资源#
先依据科学精度选定 k 网格,再读取 VASP 实际 NKPTS 和 NBANDS。在性能图中找接近自己工作量的面板,并按目标选择少量候选:
| 目标 | 可以从哪些候选开始 |
|---|---|
| 小体系/很短的 Γ 单点任务 | CPU56 核;必要时比较单卡 GPU 的完整时间 |
| 尽量减少核时 | CPU56 核、P100 单卡、V100 单卡,按第 4、5 节比较 |
| 较大任务尽快完成 | V100 四/八卡,同时核对显存与参考核时 |
| 时间与预算兼顾 | 比较双/四卡与 CPU、单卡,不只选择两端的配置 |
| 大量独立算例 | 同时考虑分配给不同作业;本文没有测量多作业并发吞吐量 |
材料、原子种类、空带数、真空层、ENCUT、泛函或算法改变后,需要使用自己的输入复测。原子数相同不代表工作量相同,本文 Si 的边界不能直接套到所有体系。
7.2 怎样提交和核对#
在 yskit 的“复制 Slurm 脚本”中选择账户类别、VASP 版本和 CPU/GPU 节点,使用对应模板。CPU8173m 保持整节点 56 核;GPU 模板的 MPI 进程数与 GPU 数量同步修改,每卡 1 个进程、1 个 CPU 核心。科学输入保持自己的收敛要求,不照抄固定 30 步设置。
并行参数选择见《VASP GPU 加速专题五:加速参数选择》。同一种资源内部,先调优再比较,避免因不合适的 KPAR、NSIM 或 NCORE 得到误导性的速度结论。
正常完成试算后,分别查看计算阶段与完整程序时间:
grep 'LOOP+:' OUTCAR
grep 'Elapsed time (sec)' OUTCAR
真实作业预算还需要以 Slurm 的实际运行时间为准。只在确认正常退出、完成相同工作量以及能量、力等数值满足要求之后比较时间。候选很接近时再复测,不根据一次小差异决定长期使用方案。
8. 完整数据:按需查阅#
下面保留所有 162 组选定配置的三类数值,供查数和复核。正文图 P2~P4 已显示全部 LOOP+ 和 Elapsed,图 P6~P8 已显示全部参考核时;阅读结果讨论不需要先读完这些表。
8.1 计算阶段:LOOP+ 时间,单位秒#
Γ 单点#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 1 | 1.290 | 5.585 | 3.832 | 2.890 | 3.173 | 5.052 | 3.622 | 2.446 | 2.623 |
| 32 | 1 | 5.248 | 17.216 | 11.562 | 7.593 | 6.315 | 15.069 | 10.143 | 6.336 | 4.990 |
| 64 | 1 | 9.674 | 30.313 | 20.289 | 13.693 | 9.773 | 27.478 | 17.554 | 10.773 | 7.833 |
| 96 | 1 | 21.039 | 56.521 | 37.520 | 23.138 | 16.453 | 48.020 | 30.296 | 17.450 | 12.171 |
| 144 | 1 | 43.432 | 96.861 | 61.879 | 40.515 | 26.941 | 79.256 | 50.169 | 28.624 | 19.440 |
| 216 | 1 | 88.311 | 162.252 | 106.825 | 68.712 | 46.297 | 126.523 | 85.281 | 52.393 | 32.744 |
较疏网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 64 | 18.992 | 96.730 | 51.574 | 30.579 | 18.675 | 80.320 | 44.337 | 25.745 | 15.898 |
| 32 | 16 | 32.248 | 69.169 | 43.784 | 31.865 | 24.744 | 55.014 | 35.259 | 27.054 | 19.790 |
| 64 | 8 | 45.969 | 77.902 | 54.375 | 41.681 | 27.852 | 62.082 | 44.707 | 30.798 | 20.289 |
| 96 | 8 | 104.007 | 148.122 | 98.233 | 74.141 | 48.338 | 111.083 | 79.688 | 51.128 | 32.803 |
| 144 | 8 | 236.844 | 266.572 | 175.106 | 130.392 | 83.955 | 194.552 | 135.786 | 85.569 | 54.952 |
| 216 | 8 | 481.058 | 486.089 | 306.015 | 225.690 | 140.318 | 354.889 | 242.937 | 142.718 | 90.478 |
较密网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 125 | 31.890 | 178.613 | 94.429 | 53.188 | 31.692 | 149.415 | 80.508 | 45.157 | 27.054 |
| 32 | 45 | 76.500 | 164.662 | 94.457 | 59.390 | 41.826 | 131.169 | 76.666 | 48.452 | 33.916 |
| 64 | 27 | 137.855 | 195.037 | 115.412 | 77.288 | 58.021 | 147.735 | 91.316 | 62.266 | 46.338 |
| 96 | 18 | 233.891 | 275.779 | 161.978 | 116.018 | 89.044 | 199.038 | 124.826 | 92.428 | 58.109 |
| 144 | 12 | 340.217 | 363.304 | 223.309 | 159.575 | 112.299 | 256.890 | 168.089 | 116.209 | 71.127 |
| 216 | 8 | 479.787 | 483.630 | 310.368 | 224.380 | 140.130 | 354.467 | 242.911 | 145.880 | 90.384 |
8.2 完整 VASP 程序:Elapsed 时间,单位秒#
Γ 单点#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 1 | 2.958 | 7.231 | 5.719 | 5.492 | 9.927 | 6.740 | 5.551 | 5.619 | 9.610 |
| 32 | 1 | 7.181 | 20.647 | 14.083 | 10.394 | 13.479 | 17.807 | 12.670 | 9.726 | 12.390 |
| 64 | 1 | 11.846 | 34.891 | 23.634 | 17.221 | 16.745 | 31.481 | 20.809 | 14.564 | 15.316 |
| 96 | 1 | 23.500 | 63.894 | 42.297 | 27.865 | 24.297 | 54.462 | 34.609 | 21.918 | 20.202 |
| 144 | 1 | 46.634 | 109.410 | 69.172 | 46.769 | 36.026 | 89.305 | 56.624 | 34.591 | 28.360 |
| 216 | 1 | 93.355 | 185.478 | 119.961 | 79.248 | 58.224 | 147.092 | 116.630 | 62.669 | 45.323 |
较疏网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 64 | 20.806 | 99.555 | 54.587 | 34.222 | 25.308 | 82.766 | 47.040 | 29.306 | 23.162 |
| 32 | 16 | 34.537 | 73.096 | 47.841 | 36.843 | 31.358 | 58.430 | 39.244 | 32.440 | 25.825 |
| 64 | 8 | 48.576 | 84.061 | 61.000 | 47.040 | 35.494 | 67.498 | 50.308 | 35.623 | 27.382 |
| 96 | 8 | 108.123 | 159.048 | 110.111 | 82.625 | 58.020 | 120.156 | 89.543 | 57.829 | 41.701 |
| 144 | 8 | 243.852 | 285.987 | 195.716 | 145.213 | 98.189 | 211.165 | 153.781 | 95.997 | 67.735 |
| 216 | 8 | 496.351 | 523.541 | 346.757 | 254.494 | 164.420 | 387.477 | 278.453 | 161.363 | 111.579 |
较密网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 125 | 34.335 | 182.010 | 98.036 | 57.621 | 39.525 | 152.845 | 84.173 | 49.771 | 34.796 |
| 32 | 45 | 80.134 | 170.624 | 100.896 | 66.738 | 52.496 | 136.763 | 82.379 | 55.735 | 44.906 |
| 64 | 27 | 142.164 | 204.887 | 126.023 | 89.359 | 74.730 | 156.512 | 100.716 | 73.038 | 56.558 |
| 96 | 18 | 240.291 | 291.195 | 178.812 | 135.346 | 102.715 | 213.070 | 139.812 | 109.645 | 70.342 |
| 144 | 12 | 349.593 | 386.358 | 248.680 | 187.911 | 133.184 | 277.579 | 197.355 | 130.902 | 88.124 |
| 216 | 8 | 495.562 | 521.078 | 350.966 | 270.174 | 164.310 | 388.693 | 279.983 | 165.880 | 112.771 |
8.3 参考核时:按完整程序时间折算#
Γ 单点#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 1 | 0.0460 | 0.0482 | 0.0763 | 0.1465 | 0.5294 | 0.0599 | 0.0987 | 0.1998 | 0.6834 |
| 32 | 1 | 0.1117 | 0.1376 | 0.1878 | 0.2772 | 0.7189 | 0.1583 | 0.2252 | 0.3458 | 0.8811 |
| 64 | 1 | 0.1843 | 0.2326 | 0.3151 | 0.4592 | 0.8931 | 0.2798 | 0.3699 | 0.5178 | 1.0891 |
| 96 | 1 | 0.3656 | 0.4260 | 0.5640 | 0.7431 | 1.2958 | 0.4841 | 0.6153 | 0.7793 | 1.4366 |
| 144 | 1 | 0.7254 | 0.7294 | 0.9223 | 1.2472 | 1.9214 | 0.7938 | 1.0066 | 1.2299 | 2.0167 |
| 216 | 1 | 1.4522 | 1.2365 | 1.5995 | 2.1133 | 3.1053 | 1.3075 | 2.0734 | 2.2282 | 3.2230 |
较疏网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 64 | 0.3236 | 0.6637 | 0.7278 | 0.9126 | 1.3498 | 0.7357 | 0.8363 | 1.0420 | 1.6471 |
| 32 | 16 | 0.5372 | 0.4873 | 0.6379 | 0.9825 | 1.6724 | 0.5194 | 0.6977 | 1.1534 | 1.8364 |
| 64 | 8 | 0.7556 | 0.5604 | 0.8133 | 1.2544 | 1.8930 | 0.6000 | 0.8944 | 1.2666 | 1.9472 |
| 96 | 8 | 1.6819 | 1.0603 | 1.4681 | 2.2033 | 3.0944 | 1.0681 | 1.5919 | 2.0561 | 2.9654 |
| 144 | 8 | 3.7933 | 1.9066 | 2.6095 | 3.8723 | 5.2367 | 1.8770 | 2.7339 | 3.4132 | 4.8167 |
| 216 | 8 | 7.7210 | 3.4903 | 4.6234 | 6.7865 | 8.7691 | 3.4442 | 4.9503 | 5.7374 | 7.9345 |
较密网格#
| 原子数 | NKPTS | CPU56核 | P1001卡 | P1002卡 | P1004卡 | P1008卡 | V1001卡 | V1002卡 | V1004卡 | V1008卡 |
|---|---|---|---|---|---|---|---|---|---|---|
| 8 | 125 | 0.5341 | 1.2134 | 1.3071 | 1.5366 | 2.1080 | 1.3586 | 1.4964 | 1.7696 | 2.4744 |
| 32 | 45 | 1.2465 | 1.1375 | 1.3453 | 1.7797 | 2.7998 | 1.2157 | 1.4645 | 1.9817 | 3.1933 |
| 64 | 27 | 2.2114 | 1.3659 | 1.6803 | 2.3829 | 3.9856 | 1.3912 | 1.7905 | 2.5969 | 4.0219 |
| 96 | 18 | 3.7379 | 1.9413 | 2.3842 | 3.6092 | 5.4781 | 1.8940 | 2.4855 | 3.8985 | 5.0021 |
| 144 | 12 | 5.4381 | 2.5757 | 3.3157 | 5.0110 | 7.1031 | 2.4674 | 3.5085 | 4.6543 | 6.2666 |
| 216 | 8 | 7.7087 | 3.4739 | 4.6795 | 7.2046 | 8.7632 | 3.4550 | 4.9775 | 5.8980 | 8.0193 |
合集
《VASP GPU 加速专题一:发展历程、GPU选型》
《VASP GPU 加速专题二:VASP 多版本与扩展功能支持》
《VASP GPU 加速专题三:性能实测》
《VASP GPU 加速专题四:计算准确性》
《VASP GPU 加速专题五:加速参数选择》
《VASP GPU 加速专题六:显存容量规划》