
VASP GPU 加速专题四:计算准确性
比较能量、原子力、电子结构和吸附分析。
阅读本篇目录
把计算从 CPU 转到 GPU,最值得关心的是:最终物理结果是否保持一致,能否用于自己的科研问题。本指南采用相同结构、赝势、泛函与收敛设置,对比鸢算科技 HPC 集群上 VASP 6.6.1 的 CPU、P100 和 V100 结果。
**在这里验证的 Si、水分子和 CO/Pt(111) 模型中,CPU 与 GPU 的收敛能量、原子力和目标低能电子结构具有很高的一致性;表面吸附能、Bader 电荷与差分电荷也进行了独立对照。**所有数值均取自按电子收敛条件结束的计算。下文依次说明如何比较、实测差异有多大,以及这些结果对实际使用意味着什么。
1. 怎样理解“计算准确性”#
科研计算中的准确性包含三个层次,彼此不能替代。
| 层次 | 具体问题 | 需要怎样验证 |
|---|---|---|
| CPU/GPU 的数值一致性 | 同一个问题交给不同计算平台,结果是否相近? | 固定物理输入,比较最终收敛的能量、力和目标性质 |
| 数值参数的收敛 | 截断能、k 点、空带数或网格是否足够? | 在同一模型上逐项增加参数,观察目标性质是否稳定 |
| 物理模型的适用性 | 泛函、结构、自旋态和环境是否能描述研究对象? | 根据物理问题选择方法,并与可靠理论或实验对照 |
例如,CPU 和 GPU 算出相同的 PBE 带隙,说明两种实现的结果一致;PBE 对该材料是否存在带隙偏差,仍是物理模型层面的问题。CPU 在这里是对照实现,并不是自动给出精确真值的标准答案。
VASP 的 GPU 端口面向科学数值计算,官方明确强调 GPU 的双精度浮点性能,并将 P100、V100 列入测试硬件。
浮点数只能保存有限位数,求和顺序、矩阵分块、MPI 归约和数值库实现都可能改变末位数字。这些微小变化还会影响自洽求解经过的迭代路径。因此,更合理的要求是差异足够小、不影响所研究的性质,而不是所有文件逐字节相同。
2. 测试模型与比较方法#
2.1 验证了哪些问题#
| 模型 | 规模与采样 | 用途 |
|---|---|---|
| 应变 Si | 8 原子,6×6×6 网格,64 个不可约 k 点 | 能量、目标能级、态密度和空带收敛 |
| 轻微扰动的 Si | 32 原子,6×3×3 网格,28 个不可约 k 点 | 非零原子力、多卡一致性、电子结构 |
| 固定结构的 H₂O | 3 原子,Γ 点,vasp_gam |
Γ 点专用程序的能量和非零力 |
| CO/Pt(111) | 12 个 Pt+CO,2×2 表面单胞、三层 Pt,3×3×1 网格 | 吸附能、Bader 电荷、差分价电子密度 |
Si 的电子收敛阈值为 EDIFF=1E-9,水分子为 1E-10。Si 使用 ENCUT=350 eV、PREC=Accurate、LREAL=.FALSE.;水分子使用 ENCUT=300 eV。这些严格设置用于识别实现之间的微小差异,并不是要求所有生产任务一律照搬。
CPU 采用 8173m 节点的 56 个 MPI 进程,每进程 1 线程;GPU 每张卡对应 1 个 MPI 进程和 1 个 CPU 核。Si 覆盖 P100、V100 的单卡、双卡、四卡和八卡,表面吸附与电荷分析采用两种 GPU 的单卡结果。
程序版本均为 VASP 6.6.1 普通版。CPU 构建采用 oneAPI 2024.2、Intel MPI 和 MKL;GPU 构建采用 NVHPC 25.3、CUDA 12.8、配套 HPC-X/OpenMPI 与 MKL 2023.2。保持同一套 PAW-PBE 赝势和同一物理模型,电子数由原子组成与赝势确定。
2.2 公平比较需要满足什么条件#
每组 CPU/GPU 对照均核对相同的 POSCAR、POTCAR、KPOINTS,以及实际采用的能带数和 FFT 网格。允许根据平台选择合适的并行分组,但不能把不同结构、不同磁态或不同科学参数下的结果当作硬件差异。
所有静态测试使用 NELMIN=2,NELM=150 仅作为允许的最大迭代次数,以达到 EDIFF 为停止条件。Si、水分子及空带控制计算实际用了 16—33 个电子步;还检查了正常退出标记和最终数值输出。程序正常退出本身不等于所有目标性质已经收敛。
VASP 的 EDIFF 同时考察相邻电子步的总自由能变化和能带能量变化。它不能直接承诺某个力分量、某条高能空带或某种响应函数的误差上限。
3. 总能量与原子力:收敛以后相差多少#
3.1 能量要采用相同口径#
free energy TOTEN、energy without entropy 和 energy(sigma→0) 是不同的输出量。比较时应固定展宽设置,并使用相同的能量定义。本节逐项比较总自由能与 sigma→0 能量,二者在 Si 对照中得到相同量级的最大差异。
每原子能量差定义为:
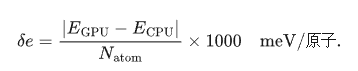
下表取每种 GPU 全部已测配置中的最大差异,不是挑选最接近 CPU 的一次结果。
| 算例 | 平台 | 已测配置数 | 最大能量差 / (meV/原子) | 最大力分量差 / (eV/Å) |
|---|---|---|---|---|
| Si8 | P100 | 5 | 1.25e-06 | 0 |
| Si8 | V100 | 5 | 1.25e-06 | 0 |
| Si32(非零力) | P100 | 5 | 9.37e-07 | 2.67e-06 |
| Si32(非零力) | V100 | 5 | 9.37e-07 | 2.67e-06 |
| H₂O(Γ专用) | P100 | 1 | 0 | 6.43e-06 |
| H₂O(Γ专用) | V100 | 1 | 0 | 6.43e-06 |
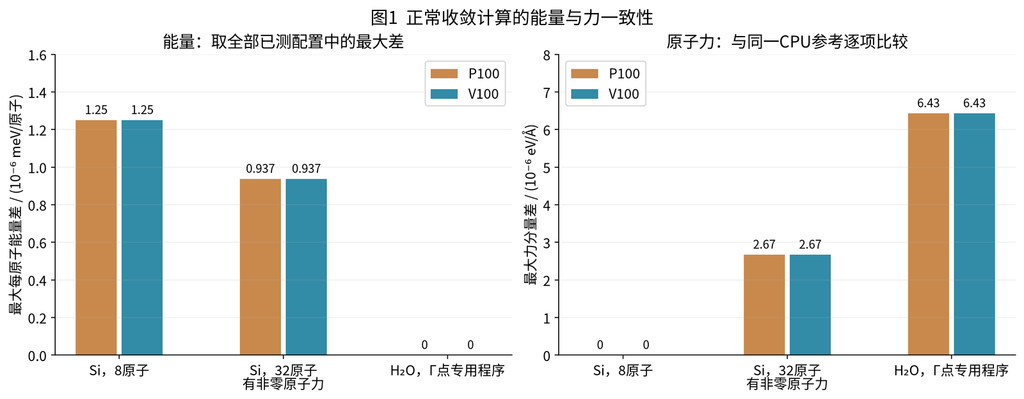
图1:能量比较采用相同能量定义;力比较采用同一结构下的逐分量差值。Si8 的原子力受对称性约束,在输出精度内为零,因此主要用于能量和电子结构检查。
Si 的最大每原子能量差为 1.25×10⁻⁶ meV/原子。这个很小的数值来自保存文件之间的差,而文件本身只有有限有效位数。它支持两种实现的能量一致性,但不能用来宣称实际材料能量已具有如此高的绝对物理精度。表中的零差也只表示在输出精度内一致。
3.2 力的验证应包含真实的非零力#
Si32 对每个原子施加确定性的小位移,并去掉整体平移。CPU 参考中最大的原子力约为 0.6009 eV/Å,避免了只比较两个零力数组的问题。
两种 GPU 相对 CPU 的最大力分量差均为 2.67×10⁻⁶ eV/Å,最大逐原子力矢量差为 2.88×10⁻⁶ eV/Å。这里逐项读取了 vasprun.xml 的力,不仅比较 OUTCAR 中较少的小数位。
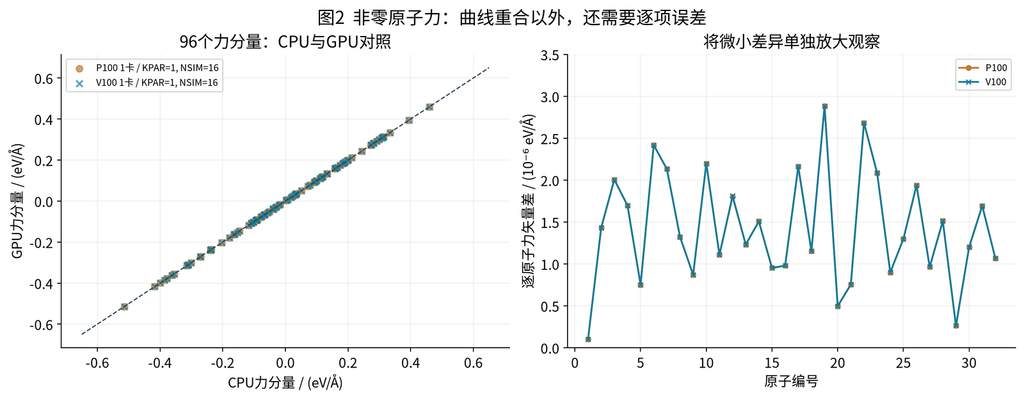
图2:左图对照 96 个力分量,右图放大逐原子的力矢量差。每个平台选择最大力分量差最大的已测配置。曲线看起来重合只是直观表现,误差判断依据右图和数值统计。
水分子的 Γ 点专用程序对照给出最大力分量差 6.43×10⁻⁶ eV/Å。这些差异明显小于常见结构优化中采用的力阈值,支持所测固定结构上的力一致性。声子、微小位移响应等问题仍应根据目标量检查截断能、投影精度和电子迭代收敛。
PREC=Accurate 和 LREAL=.FALSE. 有助于减少相应数值近似,但不能替代完整的参数收敛测试。
3.3 多卡会降低精度吗#
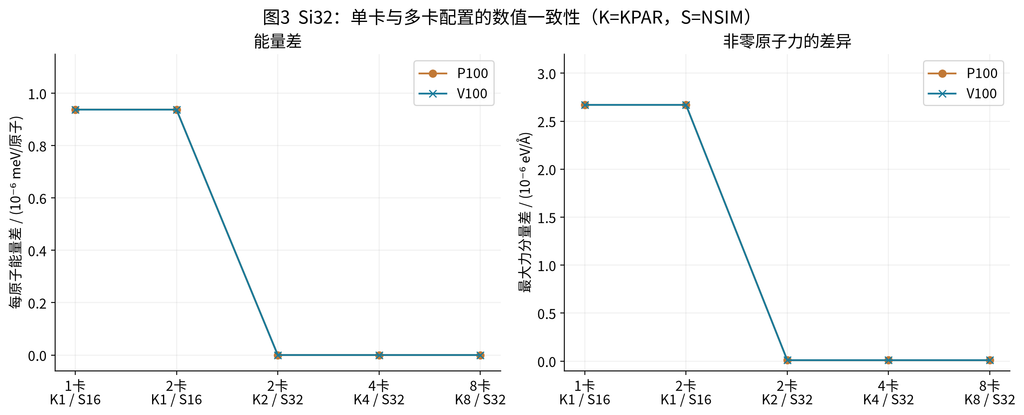
图3:K 表示 KPAR,S 表示 NSIM。所有点均与同一 CPU 参考比较。两个双卡配置同时改变了 KPAR 和 NSIM,检查的是整套配置的结果一致性,不用于分别确定两个参数各自的影响。
这组正常收敛测试中,没有观察到增加 GPU 卡数后能量或原子力误差持续增大的趋势。KPAR 分配 k 点任务,NSIM 调整同时优化的能带批量;它们影响工作组织和求解过程,不是物理精度等级。
更换并行设置后,仍应核对 OUTCAR 中的实际 NBANDS。程序可能根据并行分组调整能带数,届时工作量和高空态求解范围也会随之改变。
4. 电子结构:能级、带隙与态密度分别检查#
4.1 价带与低能导带的一致性#
对于非磁性 Si,逐项比较相同 k 点和带序的本征值,目标窗口为全部占据态以及 CPU 价带顶上方 5 eV 内的空态。统计使用原始本征值,没有通过任意能量平移消除差异。
| 算例 | 平台 | 最大目标能级差 / meV | 最大带隙差 / meV | CPU网格采样带隙 / eV |
|---|---|---|---|---|
| Si8 | P100 | 0.001 | 0 | 0.413634 |
| Si8 | V100 | 0.001 | 0 | 0.413634 |
| Si32(非零力) | P100 | 0.002 | 0 | 0.384861 |
| Si32(非零力) | V100 | 0.002 | 0 | 0.384861 |
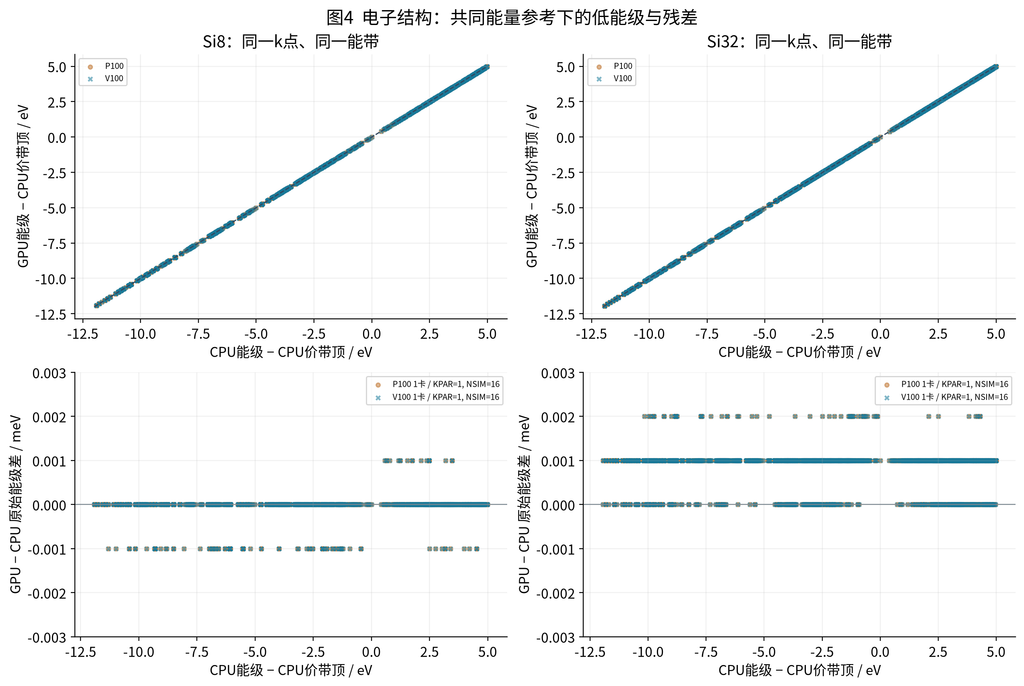
图4:上图以同一个 CPU 价带顶作共同零点,展示同一 k 点、同一能带的对照;下图直接绘制 GPU−CPU 的原始本征值差。这里只是均匀网格上的能级比较,不是高对称路径能带图。
目标低能区的最大差为 0.002 meV。两种 Si 模型的网格采样带隙在保存精度内一致。这里的带隙由所采样 k 点确定,没有进行整个布里渊区的带边极值搜索,因此不应把它直接当作已收敛的基本带隙或实验带隙。
4.2 DOS 与投影 DOS 是否重合#
Si 的 DOS 和投影 DOS 使用相同的能量范围、展宽、LORBIT=11 与 NEDOS=2001。在 CPU 价带顶下方 12 eV 至上方 5 eV 的窗口内,20 组对照的总 DOS 最大逐点差为 CPU 峰值的 0.0270%;逐原子、逐轨道 PDOS 最大逐点差为 CPU 对应集合峰值的 0.0230%。
这里以窗口内峰值作归一化,不用每个点的 DOS 作分母,避免在禁带中因 DOS 接近零而得到没有意义的巨大百分比。
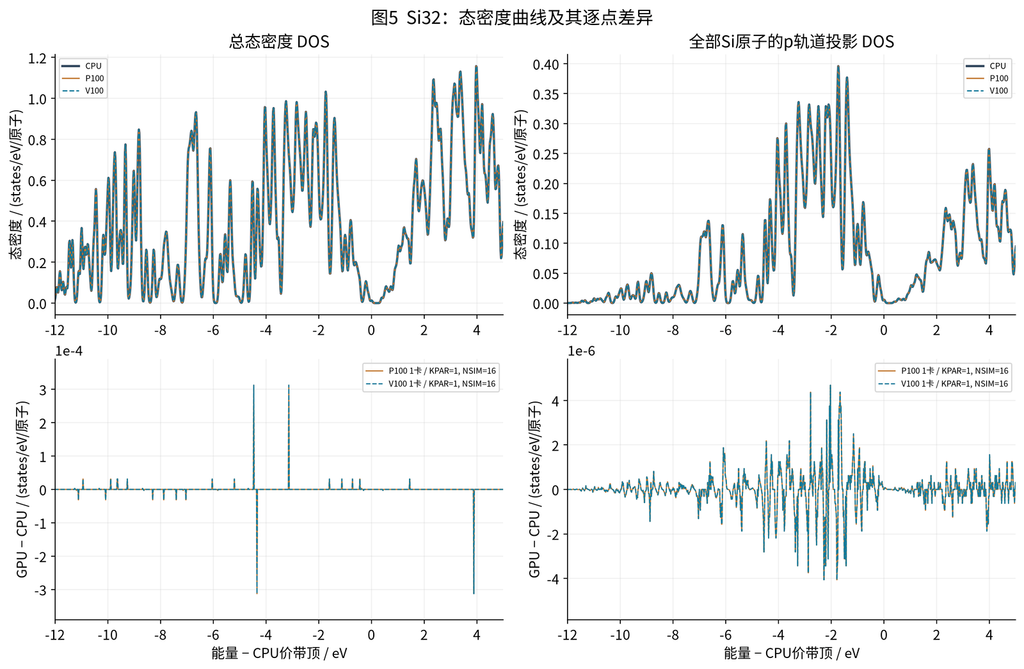
图5:上排展示曲线,下排单独展示差值。绘图以 CPU 价带顶为共同参考。右列显示所有 Si 原子的 p 轨道投影之和;0.0230% 的统计则逐项检查各原子和轨道,不只检查求和曲线。
DOSCAR 的逐行能量输出位数有限。本组数据依据文件头声明的相同均匀能量网格,比较同一行的原始 DOS 数值,没有插值或平滑。增加 NEDOS 只能提高能量取样分辨率,不能代替 k 网格、展宽和空带数的收敛。
4.3 为什么高能空态要单独检查#
在已经达到 EDIFF=1E-9 的 Si8 计算中,全部 56 条能带的最大 CPU/GPU 差仍可达到 21.787 meV,主要出现在求解能带区间的顶部;价带与目标低能导带的结果则非常接近。原因是总能量对完全未占据态不敏感,而迭代求解中接近能带上限的态通常收敛更慢。
为检查求解余量的影响,保持结构、k 网格、EDIFF、算法及各平台并行设置不变,仅将 NBANDS 从 56 增至 112,仍比较原来前 56 条目标带。
| 平台 | 求解56条带:前56条最大差 / meV | 求解112条带:前56条最大差 / meV |
|---|---|---|
| P100 | 21.787 | 0.001 |
| V100 | 21.787 | 0.001 |
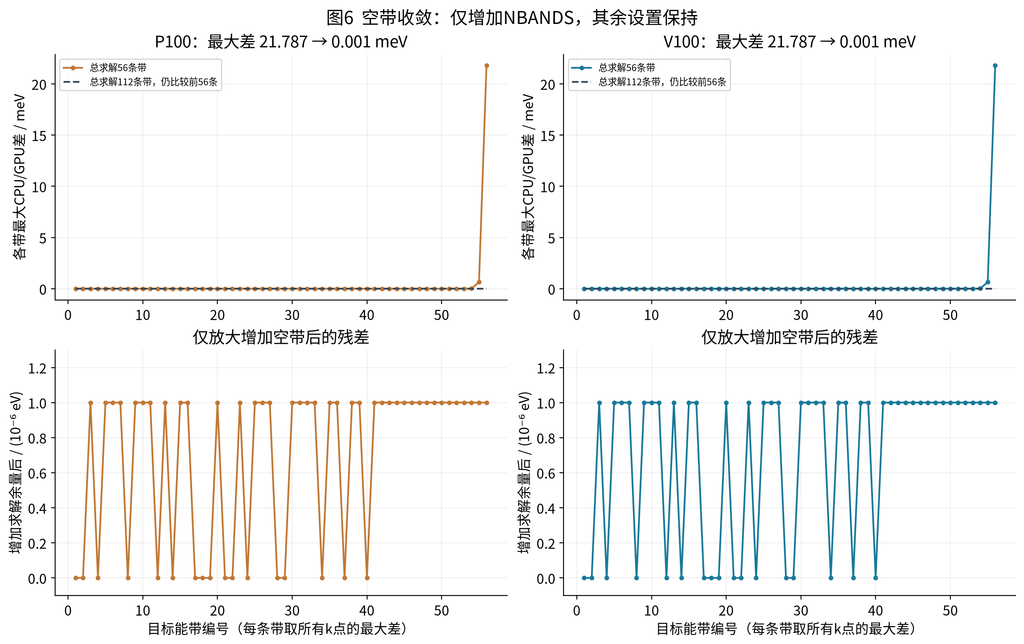
图6:每条带取所有 k 点上的最大 CPU/GPU 差。上排比较相同的前 56 条目标带,下排放大增加空带后的残差;新增的第 57—112 条带不混入这一目标指标。
两种 GPU 的目标带最大差均降至 0.001 meV。这支持“为目标空态保留求解余量”的处理方法,而不是把此前的差异简单解释成 GPU 固有的精度损失。
同时也应看到:新增计算的全部 112 条带仍包含尚未充分优化的最高空态,最大差约为 71.332 meV。验证结论只适用于明确检查过的目标区间。研究高能跃迁、光学响应或更多未占据态时,应继续增加余量,检查目标本征值及最终响应量;必要时从收敛电荷密度出发采用适合的对角化方法。
5. 实际应用:CO 在 Pt(111) 表面的吸附能#
5.1 从同一几何比较吸附能#
表面吸附能涉及三个总能量之差,比单独比较一个总能量更接近常见科研任务。采用:
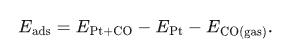
按这个符号约定,负值表示该模型中的电子吸附过程放能。三项均采用相同泛函、赝势和截断能,并统一使用 energy(sigma→0);不能把不同能量定义混合相减。
这里建立 2×2、三层、12 个 Pt 原子的 Pt(111) 模型,晶格常数为 3.98 Å,晶胞垂直长度 30 Å,一个 CO 位于顶位。固定 Pt 原子,优化 CO 的位置与键长;游离 CO 在独立 15 Å 晶胞中优化。随后固定统一几何,在 CPU、P100、V100 上各做相同输入的静态计算。
表面计算使用 PAW-PBE、ENCUT=450 eV、3×3×1 Γ 中心网格、EDIFF=1E-8、高精度 FFT 设置和表面法向偶极修正。几何准备阶段使用 EDIFF=1E-7,CO 活动自由度满足 0.03 eV/Å 的力判据;CPU/GPU 比较阶段不再分别优化结构。
这是冻结 Pt 层的吸附模型,检验的是同一模型、同一几何下的硬件一致性。 给定覆盖度、层数、晶格常数和 k 网格尚不能视为完成了表面物理参数收敛,也没有比较所有可能的吸附位点。因此,下面的吸附能用于展示计算方法与平台对照,不作为该材料的最终实验预测。
| 计算平台 | 吸附能 / eV | 相对CPU的差 / meV |
|---|---|---|
| CPU 56核 | -1.82166718 | 参考 |
| P100 单卡 | -1.82166719 | -1e-05 |
| V100 单卡 | -1.82166716 | 2e-05 |
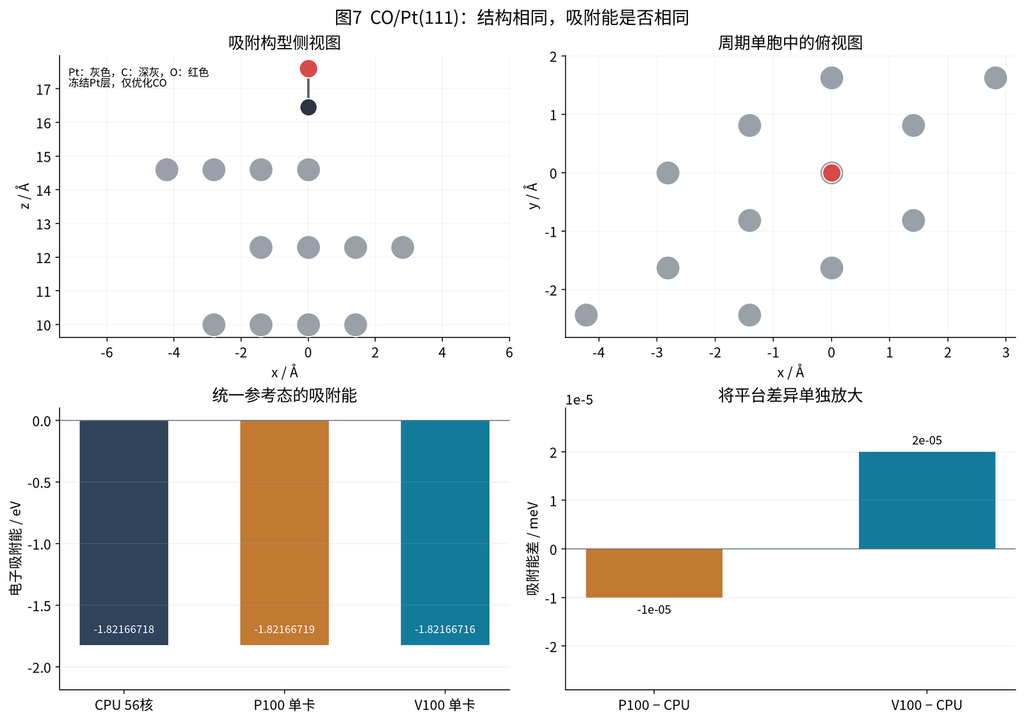
图7:统一模型的侧视图与俯视图,以及三种平台的吸附能;差值面板将 GPU 相对 CPU 的微小差异单独显示。图中的结构不因计算平台改变。
CPU得到的电子吸附能为 -1.82166718 eV。P100、V100相对CPU的最大吸附能差为 2e-05 meV;相同静态结构下,全部参考态的最大力分量差为 2.19e-06 eV/Å。三种平台对该模型中吸附放能的判断一致。这里比较的是收敛后的电子能,未加入零点振动能、温度熵或溶剂修正,因而不将它标为有限温度吸附自由能。
对于比较两个位点或两个反应中间体的研究,关键是 CPU/GPU 引入的差异是否远小于需要区分的能量差。还应分别检查泛函、覆盖度、表面层数、k 点与气相参考态。硬件一致性良好,并不意味着这些物理和数值误差已经自动消失。
6. Bader 电荷:电子转移的判断是否一致#
Bader 分析根据电荷密度的拓扑划分原子空间。本例以 AECCAR0+AECCAR2 的重构全电子密度确定分区,并对 CHGCAR 的价电子密度积分;三种平台均使用相同的 Bader 1.05 和 96×96×384 网格。
Bader 后处理本身在 CPU 上执行。下表的 P100/V100 指由相应 GPU 版 VASP 生成密度后,再用同一个 Bader 程序分析,因而比较的是 VASP 密度来源改变后,电荷分析结论是否保持一致。
本文的净电荷定义为:
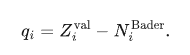
q>0 表示该原子区域相对中性价电子数失电子,q<0 表示得电子。Pt、C、O 的价电子数分别为 10、4、6。CO 的净电荷取 C 与 O 的净电荷之和,避免只看一个原子就判断整个分子的电子转移方向。
| 平台 | C净电荷 / e | O净电荷 / e | 整个CO净电荷 / e | CO净电荷相对CPU的差 / e |
|---|---|---|---|---|
| CPU | +0.248741 | -0.635285 | -0.386544 | 参考 |
| P100 | +0.248256 | -0.634799 | -0.386543 | 1e-06 |
| V100 | +0.248612 | -0.635128 | -0.386516 | 2.8e-05 |
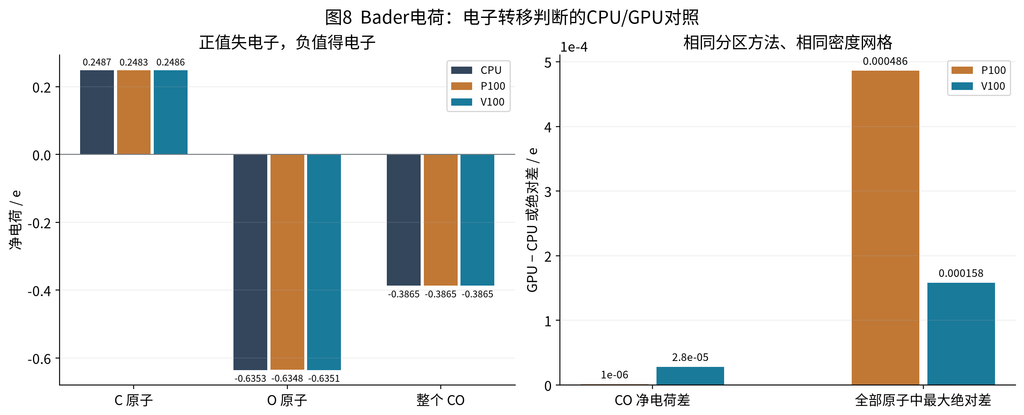
图8:C、O 与整个 CO 的净电荷,以及 GPU 相对 CPU 的分区电荷差。正负号遵循上式;同一分区方法和网格是公平比较的前提。
CPU参考中,CO的Bader净电荷为 -0.386544 e,按上述约定对应CO整体得到约 0.386544 个电子。三种平台的电子转移方向一致,CO净电荷最大差为 2.8e-05 e,全部原子净电荷的最大差为 0.000486 e。这支持同一密度网格和分区定义下的电子转移结论一致;它没有消除Bader电荷对网格与分区方法本身的依赖。
P100对照中,C与O的净电荷差分别为 −0.000485 e 和 +0.000486 e,相加后大部分抵消。价电子密度和分区参考密度的晶胞差异积分均约为10⁻⁹ e量级,但网格上的离散分区仍可能对这些微小扰动敏感。
为检查分区参考的作用,又保留各GPU生成的价电子密度,只将分区参考统一为同一份CPU参考密度;结果各原子的Bader输出均与CPU在保存精度内一致。
这组控制实验支持将上述差异主要归于参考密度所决定的分区边界,不能把它直接解释成同等大小的真实电子转移差异。统一参考只用于这里相同几何的控变量检查;不同结构应使用各自匹配的参考密度并检查网格收敛。
| 平台 | 各自参考密度:最大原子电荷差 / e | 共同CPU参考密度:最大原子电荷差 / e |
|---|---|---|
| P100 | 0.000486 | 0 |
| V100 | 0.000158 | 0 |
本例 ACF.dat 的原子电子数保留六位小数,电荷差据此解释,不将浮点相减产生的更小尾数当作额外测得的精度。
Bader 电荷是一种空间分区结果,不等同于形式氧化态,也不要求与其他电荷分析方法给出相同数值。生产研究中仍需检查密度网格对结果的影响,尤其当不同结构之间的电荷差本身很小时。
7. 差分电荷密度:成键区域的分布是否一致#
差分电荷密度定义为:
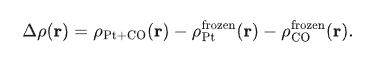
两个片段均保留吸附体系中的原子位置,使用相同晶胞、k 网格、FFT 网格和参数独立求解。这里减去的是保持吸附构型的 CO 片段,不是吸附能公式中另行优化的气相 CO;否则会混入分子变形与坐标错位造成的密度变化。
本节比较价电子密度,单位为 e/ų。Δρ>0 表示电子积累,Δρ<0 表示电子耗尽;中性片段的电子数相加等于完整体系,因此差分密度在整个晶胞上的积分应接近零。
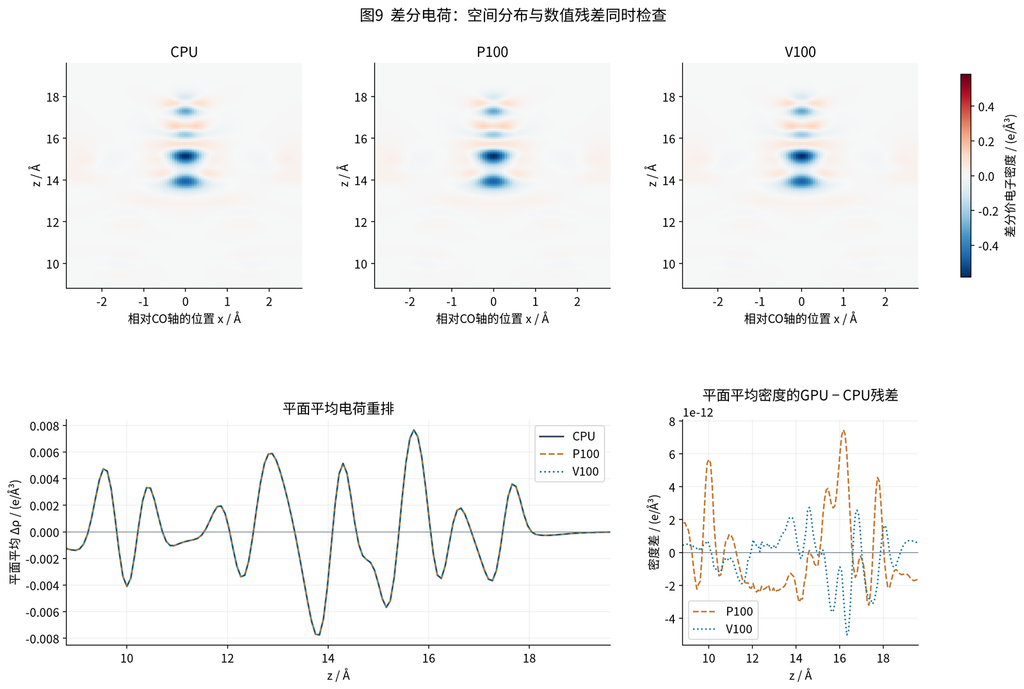
图9:上排展示穿过 CO 的密度截面,三种平台使用相同色标;下排展示平面平均密度与 GPU−CPU 残差。图像居中采用周期性平移,数值比较直接使用未平移的原始同一网格。
| 平台 | 差分密度的净积分 / e | 相对CPU的密度差异绝对值积分 / e | 相对CPU的逐网格RMS密度差 / (e/ų) |
|---|---|---|---|
| CPU | 5.45e-10 | 参考 | 参考 |
| P100 | 4.66e-10 | 1.93e-09 | 9.74e-12 |
| V100 | 4.58e-10 | 1.78e-09 | 1.03e-11 |
三个平台的差分密度净积分绝对值均不超过 5.45e-10 e,符合该中性片段构造的电子数守恒。GPU相对CPU的密度差异绝对值积分最大为 1.93e-09 e。该指标先取每个网格差异的绝对值再积分,避免正负误差相互抵消。同一色标下的图形对照与数值残差共同支持两种GPU保持了这一模型中的空间电荷重排。
评价差分电荷不能只依赖等值面“看起来一样”。本例同时检查逐网格差异和晶胞积分,以确认电子积累与耗尽的空间分布是否保持一致。图中的成键电荷重排与 CO 的 Bader 净电荷也不是同一个量:前者描述空间分布的变化,后者描述分区积分后的净结果。
合集
《VASP GPU 加速专题一:发展历程、GPU选型》
《VASP GPU 加速专题二:VASP 多版本与扩展功能支持》
《VASP GPU 加速专题三:性能实测》
《VASP GPU 加速专题四:计算准确性》
《VASP GPU 加速专题五:加速参数选择》
《VASP GPU 加速专题六:显存容量规划》