
GROMACS GPU性能与参数选择
GPU性能与参数选择,包含终端操作、输入文件、实际数据和适用范围。
阅读本篇目录
本文以鸢算科技集群 GROMACS 2026.4 实际结果为例。下载输入、参考轨迹、分析与绘图资料包,资料包约 529 MB,包含参考轨迹。解压后进入 gromacs-examples。参考输出在 cases;新计算由 new-case.py 建立独立目录。
先看单卡,再比较多卡#
以下是此前在本集群完成的 GROMACS 2026.4 GPU 短基准,和本专题新做的 100 ps 操作实例分开记录。水盒 2652 原子、RNase 24040 原子、ADH虚拟位点模型136224粒子;ADH粒子数包含虚拟位点。CPU节点离线,本页不报告CPU/GPU加速比。
每组预热后重复三次,下表选单卡、短程非键及PME均在GPU的结果。计时包含该次短运行边界,不能视作长生产任务的稳定性能排名。
| GPU | 体系 | 中位耗时 s | 采样峰值 MiB |
|---|---|---|---|
| p100 | adh-vsites | 8.739 | 337 |
| p100 | rnase | 3.425 | 285 |
| p100 | water | 2.473 | 275 |
| v100 | adh-vsites | 7.490 | 390 |
| v100 | rnase | 2.930 | 338 |
| v100 | water | 2.227 | 328 |
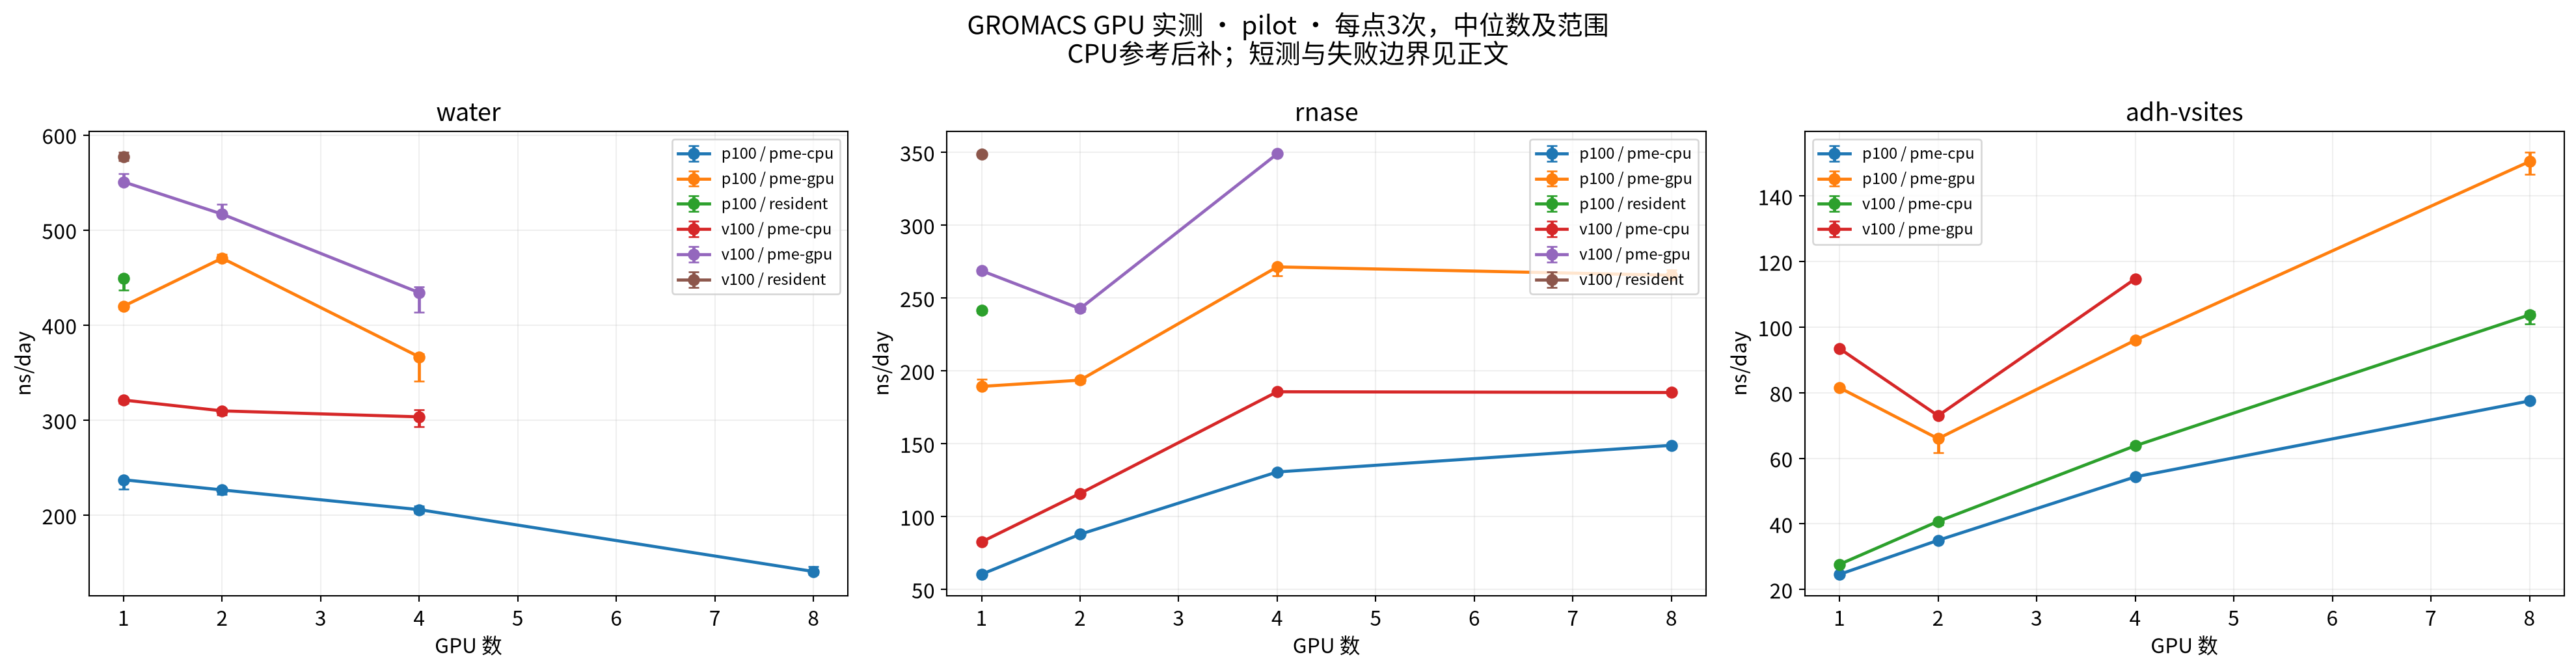
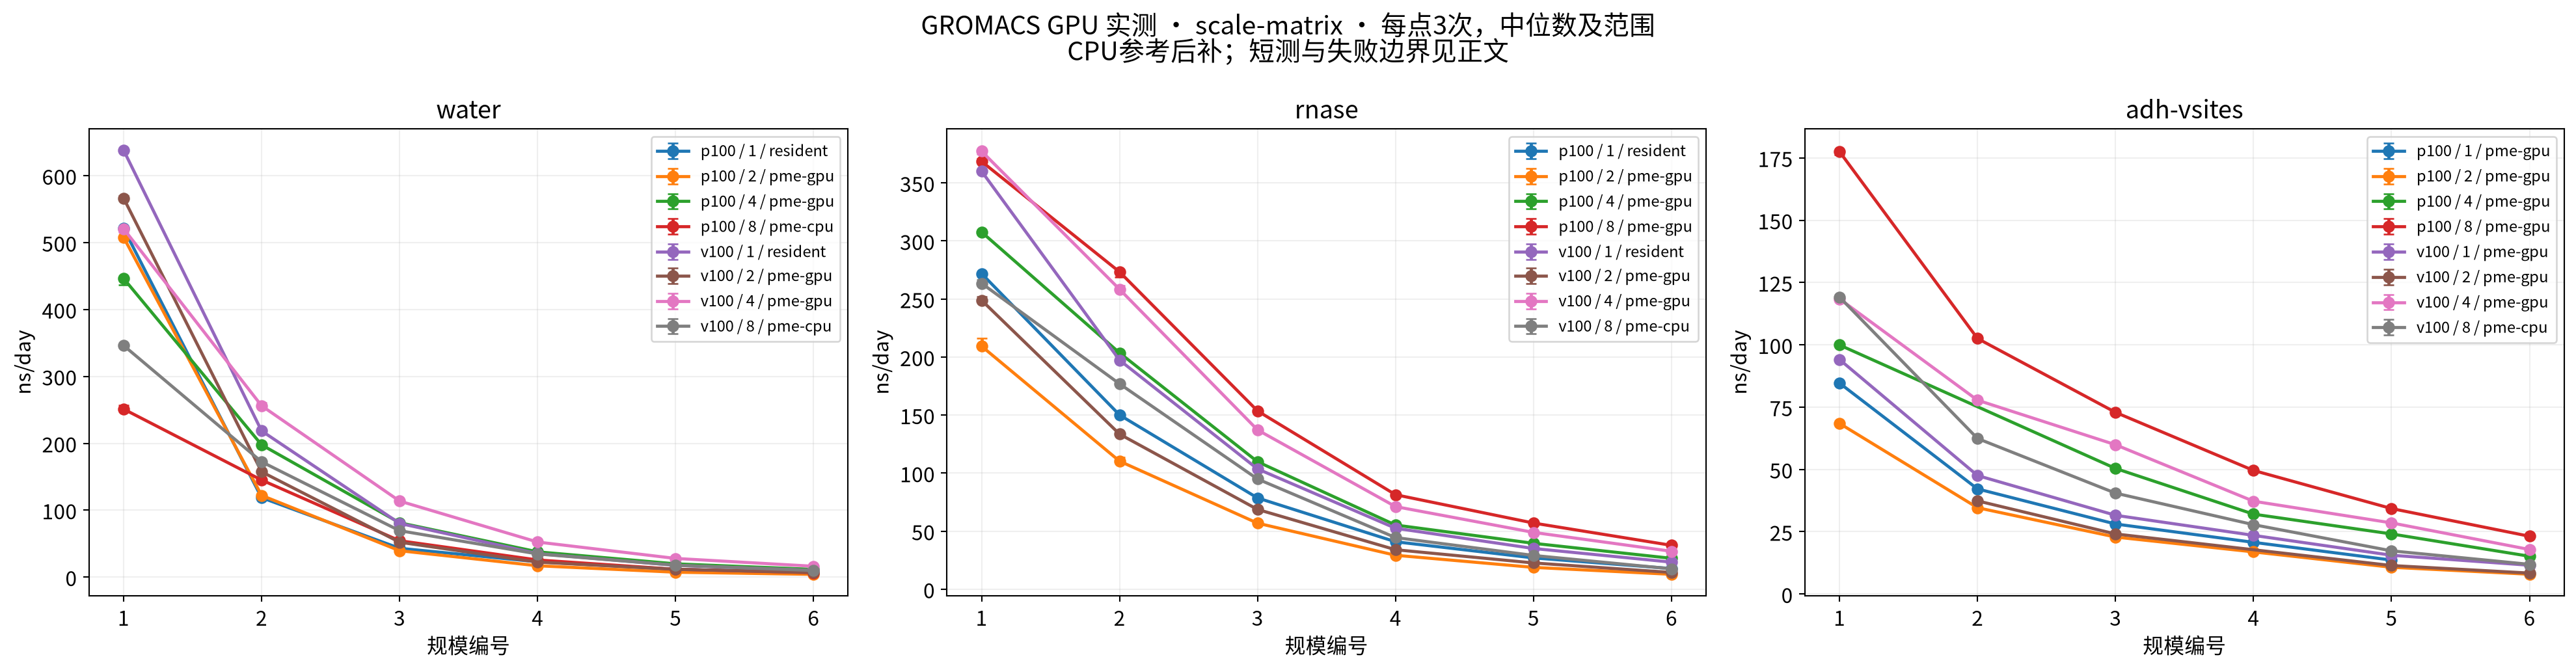
规模矩阵扩展了水盒、RNase和ADH整盒复制。复制体用于规模测试,不是新的更大蛋白;各体系的时间步和模型不同,不能跨模型直接比较 ns/day。原始汇总CSV在附件 gpu-benchmarks。
在自己的体系上测量#
先申请合法的单卡资源,在各自独立目录使用同一份TPR:
# 在已分配资源的计算目录运行,复制同一个 md.tpr
mkdir pme-cpu pme-gpu
cp md.tpr pme-cpu/
cp md.tpr pme-gpu/
cd pme-cpu
gmx mdrun -deffnm md -ntmpi 1 -ntomp 4 -nb gpu -pme cpu -update cpu
cd ../pme-gpu
gmx mdrun -deffnm md -ntmpi 1 -ntomp 4 -nb gpu -pme gpu -update cpu
保留相同物理参数,固定输出频率,先预热,再重复计时。多卡时同时调整Slurm申请、内部rank与线程数,核查日志中的GPU映射。更多卡不一定更快,小体系可能被通信和域分解限制。
历史ADH的5 fs虚拟位点性能基准在短NVE中总能变化较大;用相同5 ps时长改为1/2 fs后明显减小。不要仅按性能表把5 fs作为自己的默认生产步长。
参数查阅#
以本集群 gmx 命令名 -h 为准;GROMACS 2026.4 命令手册和MDP 参数手册可查完整选项。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。