
VASP GPU 加速专题六:显存容量规划
理解软件版本、科学参数和并行布局的显存影响。
阅读本篇目录
显存需求由体系、科学参数、并行布局和软件实现共同决定。本文先比较本集群五个VASP版本,再解释原子、赝势、真空、k点、ENCUT、KPAR和NSIM等因素,最后给出试算与排查方法。
表格中的显存均指运行期间最满单卡的采样最大已用量,不是瞬时分配的精确峰值,也不是多卡占用的总和。实验采用短电子步并覆盖力和正常退出,仅用于研究显存需求。
1. 显存容量决定能否装下算例,算力决定装下后有多快#
同样是216原子,稀疏和稠密的k点网格、空带数量、真空层厚度和杂化泛函等等都会影响显存需求。“16G显卡最多算多少原子”没有脱离这些设置的统一答案。先按自己的科学精度判断容量,再在可运行的候选中比较速度。
2. 更换VASP版本会怎样改变显存#
2.1 先区分版本、构建与实际计算路径#
VASP版本能够影响设备数组的组织、临时工作区、通信调用以及释放时机。升级版本后显存可能升高、降低或基本不变,方向还可能随体系与并行参数改变。
本节比较鸢算科技集群已经部署的普通GPU版本。固定每卡1个MPI进程、1个CPU核心;两类卡分别使用同一节点、同一批GPU。全部运行使用NVHPC25.3所带CUDA12.8库、NCCL2.25.1、HPC-X2.22.1/OpenMPI4.1.7rc1和MKL2023.2,节点驱动580.173.02。比较保留各版本原有构建,结果体现这套公共程序在统一运行环境中的整体差异。
| VASP版本 | 本集群GPU实现与构建记录 |
|---|---|
| 6.3.2 | NVIDIA OpenACC;旧式_OPENACC宏,包含USENCCL和USENCCLP2P |
| 6.4.2 | NVIDIA OpenACC;旧式_OPENACC宏,配置保留USENCCLP2P |
| 6.4.3 | NVIDIA OpenACC;_OPENACC与USENCCL |
| 6.5.1 | NVIDIA OpenACC;ACC_OFFLOAD、NVCUDA与USENCCL |
| 6.6.1 | NVIDIA OpenACC;ACC_OFFLOAD、NVCUDA与USENCCL |
本节只比较普通版的vasp_std与Γ点专用vasp_gam,不将CPU专属扩展、GPU溶剂、Wannier90或HDF5构建混成同一组。不同二进制即使版本号相同,也应先确认构建类型。
2.2 对照设计与读图方法#
每个平台、每个版本运行以下七个配置。原子坐标、POTCAR、INCAR和KPOINTS在版本间相同。这里的2×2×2网格经过实际输出核对为8个不可约k点。
| 配置 | Si原子数 | 程序 | GPU数 | 实际NKPTS | NBANDS | KPAR | NSIM |
|---|---|---|---|---|---|---|---|
| 单卡小批量 | 96 | std | 1 | 8 | 280 | 1 | 8 |
| 单卡大批量 | 96 | std | 1 | 8 | 280 | 1 | 64 |
| Γ点通用程序 | 216 | std | 1 | 1 | 560 | 1 | 32 |
| Γ点专用程序 | 216 | gam | 1 | 1 | 560 | 1 | 32 |
| 多卡、同一k点组 | 96 | std | 8 | 8 | 280 | 1 | 32 |
| 多卡、两个k点组 | 96 | std | 8 | 8 | 280 | 2 | 32 |
| 较大体系多卡 | 216 | std | 8 | 8 | 560 | 1 | 32 |
共同使用ENCUT=350 eV、PREC=Normal、ALGO=Normal、LREAL=Auto、ADDGRID、非自旋极化、静态计算。每次独立启动,固定10个电子步并运行到力和正常退出。
2.3 单卡:版本差异与NSIM的影响#
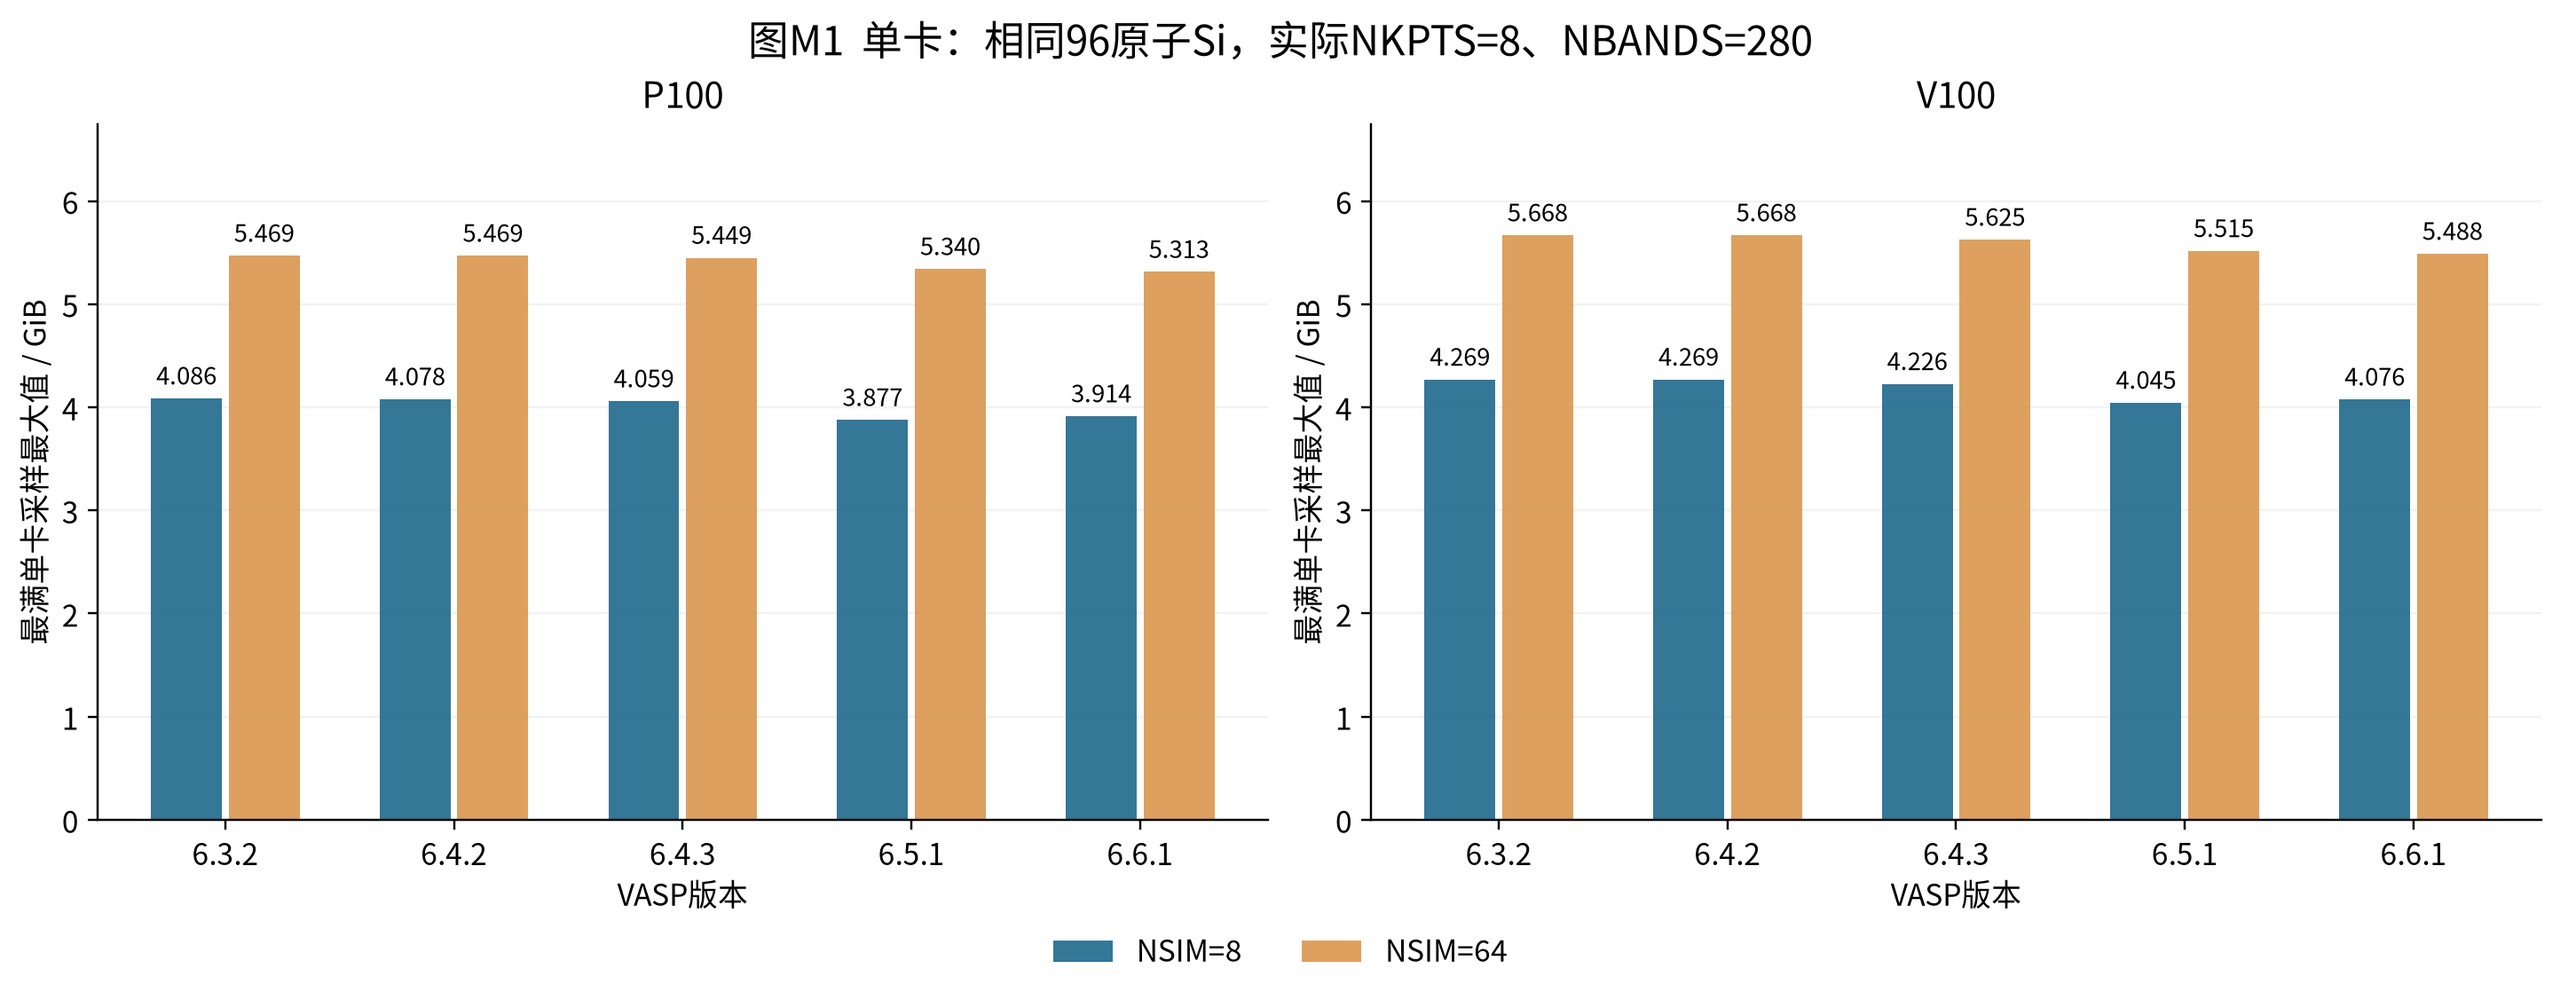
图M1:相同96原子、NKPTS=8、NBANDS=280,只在同一版本中改变NSIM。各柱是最满单卡采样最大值,纵轴从零开始。
P100的五个版本中,NSIM从8增至64,最满单卡占用增加33.8%~37.7%。固定NSIM64比较版本,记录范围为5.313~5.469 GiB,跨度0.156 GiB。
V100的五个版本中,NSIM从8增至64,最满单卡占用增加32.8%~36.4%。固定NSIM64比较版本,记录范围为5.488~5.668 GiB,跨度0.180 GiB。
NSIM是轨道处理批量,较大的NSIM可能改善GPU效率,也提高部分暂存需求。相同输入在P100和V100上的占用也不完全相同,这可能是由硬件相关的库工作区、上下文与通信实现的不同造成的。
2.4 Γ点:程序类型与版本应分别选择#
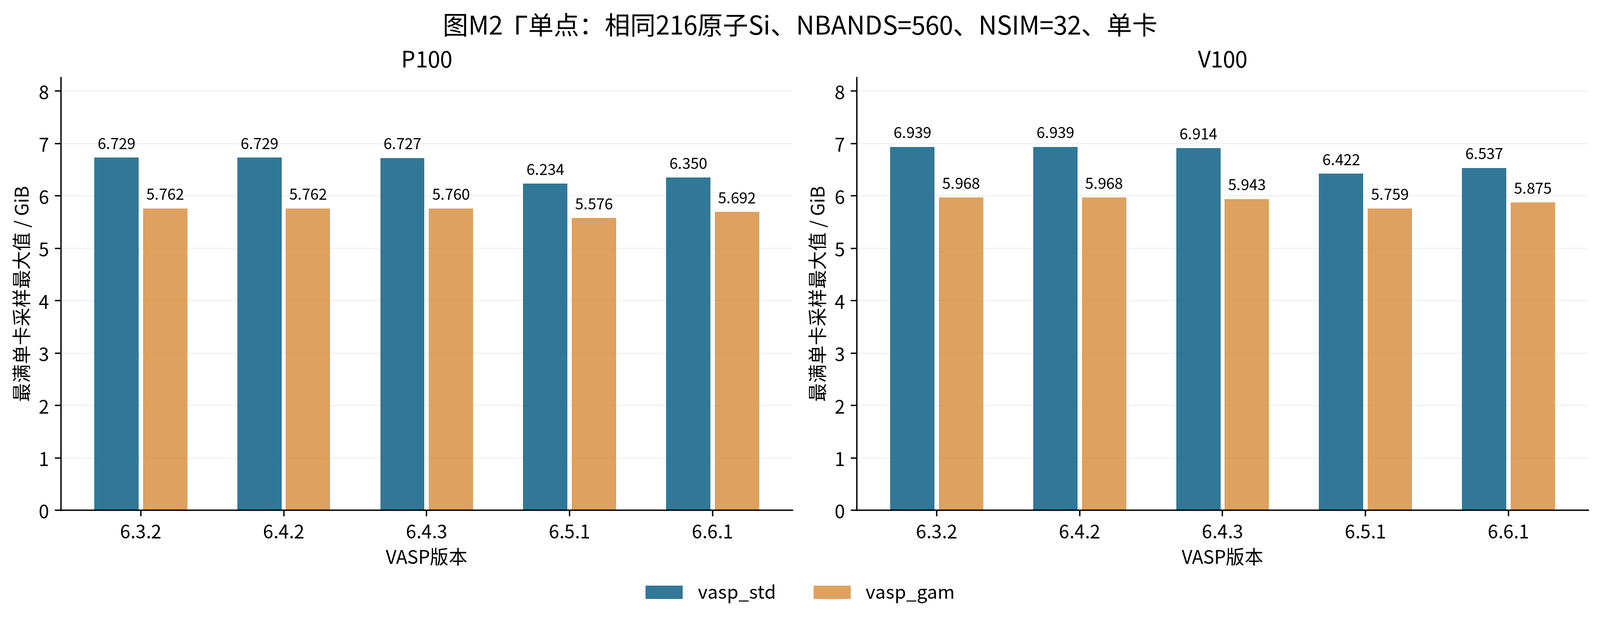
图M2:固定216原子、NBANDS=560、NSIM=32、KPAR=1、单GPU和相同Γ点输入。
P100在这五个版本中,gam相对std的整次占用减少10.4%~14.4%。gam本身的跨版本记录范围为5.576~5.762 GiB,跨度0.186 GiB。
V100在这五个版本中,gam相对std的整次占用减少10.1%~14.0%。gam本身的跨版本记录范围为5.759~5.968 GiB,跨度0.209 GiB。
本组除SYSTEM标题外的科学输入相同;实际带数与网格也一致,Γ点专用程序能够显著减少显存占用。
2.5 多卡:版本差异还包含通信行为#
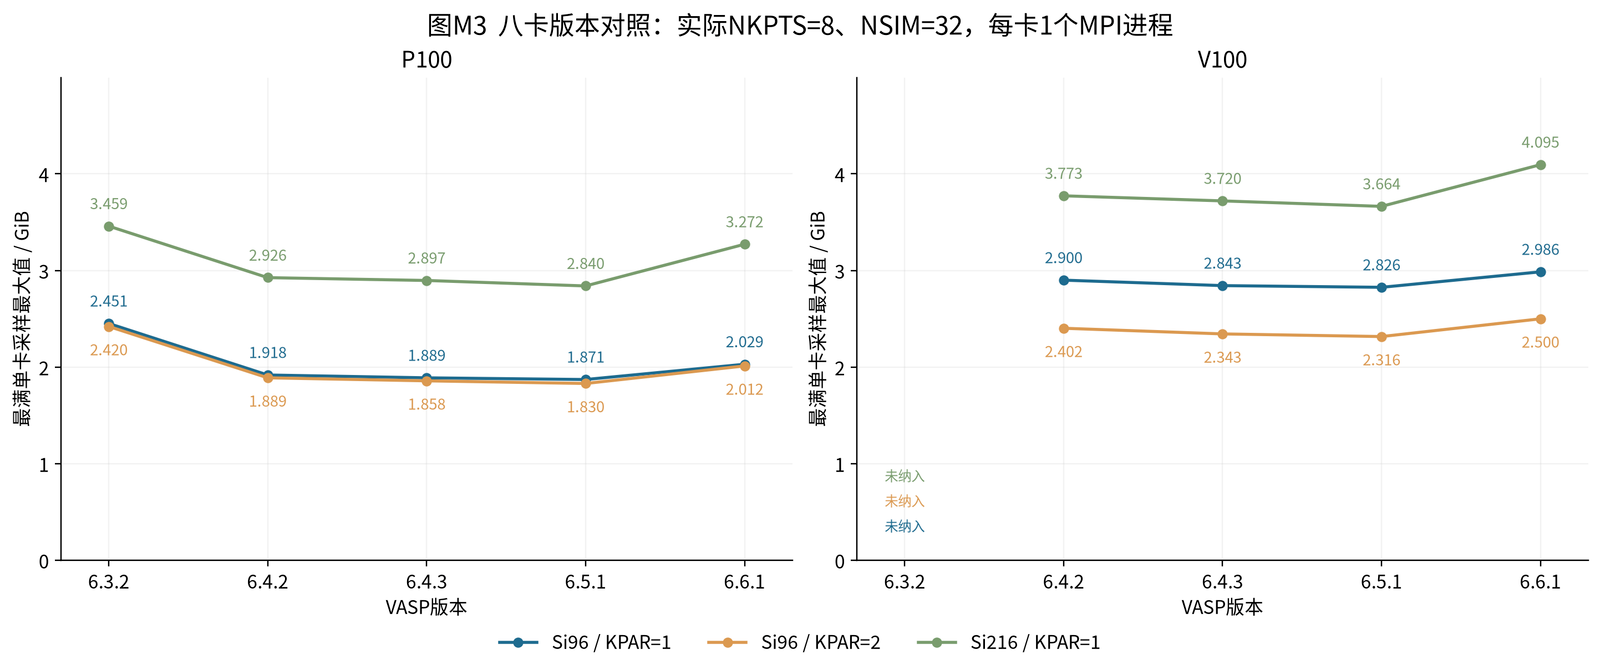
图M3:固定八卡与NSIM32;96原子KPAR1/2作为跨版本的通信诊断对照,216原子为较大体系对照。它们与第6节保留的216原子KPAR容量曲线分别讨论。
P100的216原子八卡KPAR1配置,有效版本记录范围为2.840~3.459 GiB,跨度0.619 GiB。
V100的216原子八卡KPAR1配置,有效版本记录范围为3.664~4.095 GiB,跨度0.432 GiB。
一个值得注意的反例是6.5.1→6.6.1:相同Si216八卡KPAR1,P100由2.840升至3.272 GiB(+15.2%);V100由3.664升至4.095 GiB(+11.8%)。两平台都增加442 MiB,而Si96单卡NSIM64在同一升级中略有下降。因此版本影响随工作负载和并行布局改变,不能统一套用“升级后更省”的规则。
完整主矩阵按平台列出,单位GiB;—表示被排除,没有以失败前占用代替完整容量。S表示NSIM,K表示KPAR;各列条件对应第2.2节。
P100:
| 版本 | Si96/1卡/S8 | Si96/1卡/S64 | Si216/Γ/std | Si216/Γ/gam | Si96/8卡/K1 | Si96/8卡/K2 | Si216/8卡/K1 |
|---|---|---|---|---|---|---|---|
| 6.3.2 | 4.086 | 5.469 | 6.729 | 5.762 | 2.451 | 2.420 | 3.459 |
| 6.4.2 | 4.078 | 5.469 | 6.729 | 5.762 | 1.918 | 1.889 | 2.926 |
| 6.4.3 | 4.059 | 5.449 | 6.727 | 5.760 | 1.889 | 1.858 | 2.897 |
| 6.5.1 | 3.877 | 5.340 | 6.234 | 5.576 | 1.871 | 1.830 | 2.840 |
| 6.6.1 | 3.914 | 5.313 | 6.350 | 5.692 | 2.029 | 2.012 | 3.272 |
V100:
| 版本 | Si96/1卡/S8 | Si96/1卡/S64 | Si216/Γ/std | Si216/Γ/gam | Si96/8卡/K1 | Si96/8卡/K2 | Si216/8卡/K1 |
|---|---|---|---|---|---|---|---|
| 6.3.2 | 4.269 | 5.668 | 6.939 | 5.968 | — | — | — |
| 6.4.2 | 4.269 | 5.668 | 6.939 | 5.968 | 2.900 | 2.402 | 3.773 |
| 6.4.3 | 4.226 | 5.625 | 6.914 | 5.943 | 2.843 | 2.343 | 3.720 |
| 6.5.1 | 4.045 | 5.515 | 6.422 | 5.759 | 2.826 | 2.316 | 3.664 |
| 6.6.1 | 4.076 | 5.488 | 6.537 | 5.875 | 2.986 | 2.500 | 4.095 |
3. 从电子数、平面波和FFT网格理解显存#
中性体系的默认电子数由每种原子的数量及所用POTCAR的ZVAL求和。这里的ZVAL是赝势显式处理的价电子数;含半芯态的赝势也会把相应电子纳入计算。当前Si赝势ZVAL=4,96原子对应384个电子。本文所有实验都使用这样的默认电子数。
电子数与能带数不是同一个量。非磁性计算每条占据态通常容纳两个电子,还需一定空带;实际NBANDS也可能被程序按并行布局向上取整。显存通常更直接受存储多少轨道影响,所以应同时记录实际NELECT与NBANDS。比较不同元素时,赝势投影等也变化,不能把显存差异全部归因于电子数。
波函数的代表性存储分量随k点、能带和平面波规模共同增长。平面波数由晶胞盒子与截断能决定;从截断关系可推导其量级近似正比于晶胞体积×ENCUT^(3/2)。这是趋势模型,实际分配还受FFT维度、填充、并行布局和临时数组影响,不能直接据此给出单卡GiB值。
同元素等密度扩胞、固定Γ或固定k网格时,体积和所需带数都增加,某些主要分量可接近原子数平方增长;保持k×a近似恒定时网格又会变疏,增长关系不同。单看原子数而忽略网格,可能得出相反结论。
真空中即使没有原子,平面波仍覆盖完整周期盒子,FFT也覆盖这段空间。因此增加真空能增加基函数与网格容量,而原子数和电子数保持不变。本文用相同64原子Si片层、相同面内晶胞和Γ采样改变空白z间隔,避免把真空效应与扩胞增加原子混在一起。
4. KPAR和NSIM需要同时考虑速度与显存#
KPAR改变k点组数,也改变每组内处理轨道的MPI进程数。k点计算可以分组,相关存储和工作区却不一定全部按k点组拆分;增大KPAR可能提高重复存储或每进程数组规模。另一方面,算法暂存及CUDA库工作区会使真实峰值偏离简单单调模型。应固定卡数、实际NBANDS和NSIM逐项比较,不能直接认为KPAR越大就越省显存。
NSIM控制一批处理多少条能带。较大的批量可能提高GPU效率,也会改变临时轨道、投影和子空间矩阵规模。本机VASP6.6.1源码中可以看到这些按NSIM分配的设备工作数组;它并不意味着全部显存随NSIM等比例变化。容量吃紧时,应在保持科学输入不变的条件下尝试较小NSIM,重新核对正常退出、数值和时间。
选择更多GPU也不保证每卡显存恰好除以卡数。不同数组有带并行、复制、当前k点暂存等布局,CUDA上下文和一些工作区还会在每卡出现。对单个算例,应联合选择“卡数、KPAR、NSIM”,保留容量余量,而不是分别按三个简单公式拼出配置。
5. 其他参数怎样影响显存#
估算时应先确定完整晶胞、实际能带数、实际 k 点数和并行布局,再考虑计算方法及后处理。以下机制由官方参数定义、数组规模和本集群记录解释;其中涉及设备驻留量的判断属于建模推断,只有已完成对照的项目才给出实测结论。不能给每个 INCAR 开关统一加上一个固定 GiB,也不能将主机内存变化直接换算成显存变化。
5.1 完整晶胞、截断能和网格#
| 因素 | 对容量的作用 | 估算时应记录什么 |
|---|---|---|
| 完整晶胞体积 | 平面波及 FFT 网格覆盖包括真空在内的整个周期晶胞;原子不变也能增加这部分存储 | 用晶格矩阵行列式的绝对值,不扣除真空,也不以原子所占几何体积替代 |
| 晶胞形状、倾斜及长宽比 | 相同体积不保证相同的离散 FFT 尺寸、数组填充或求解工作区 | 三条晶格矢量、夹角和实际粗/细网格;倾斜、细长晶胞需单独核验 |
| ENCUT | 改变平面波数量及默认网格;连续近似的平面波规模为体积乘 ENCUT 的 3/2 次方 | 350→700 eV 时这一规模约增至 2.83 倍,整个显存不一定乘 2.83 |
| PREC | Normal/Accurate 改变默认粗网格及投影精度;实际网格会离散取整 | 不能把 Accurate 当成平面波数量本身增加,也不能把 Single 理解成全程序改用浮点单精度 |
| NGX、NGY、NGZ | 手动指定波函数的粗 FFT 网格,覆盖对应默认维度 | 三个实际维度及其乘积;不能只看某一方向或只看 ENCUT |
| NGXF、NGYF、NGZF | 控制电荷密度、势等使用的细网格;一个网格数组的规模由三维点数共同决定 | 任一方向增大都会影响相关数组;三个方向都翻倍是该网格点数乘 8 |
| ADDGRID | 增加计算增广电荷的支撑网格,三个方向各为细网格的两倍 | 支撑网格有细网格 8 倍点数,不表示整次显存乘 8;部分额外工作也可能在主机侧完成 |
| ENAUG | 是否生效取决于 PREC;不是所有现代精度模式都会用它决定细网格 | 官方说明其仅在旧的 Low/Medium/High 设置下生效,Normal/Accurate 下不能给它额外的网格增量 |
5.2 能带、自旋、对称性和实际 k 点#
| 参数或特征 | 影响机制 | 容量判断中的注意点 |
|---|---|---|
| 原子种类、数量及 POTCAR | 默认 NELECT 来自各元素原子数乘 ZVAL 的求和;不同赝势还改变投影通道、推荐截断能等 | 原子数相同的不同材料不能共用一个每原子显存常数;含半芯态的势不能只按元素名称比较 |
| NBANDS | 更多轨道增加波函数存储;子空间矩阵还存在与能带数平方有关的分量 | 使用 OUTCAR 实际 NBANDS,包含 MPI 分组向上补齐;空带不能为了省显存随意删减 |
| ISPIN=2 | 两个自旋通道分别处理,默认带数也可能变化 | 额外自旋数组、带数和实际 k 点共同作用,不能给整次显存固定乘 2 |
| MAGMOM | 影响初始磁性、默认带数和所允许的对称操作 | 磁矩更大不等于直接按比例占用更多显存;磁性破坏对称后,NKPTS 可能增加 |
| LNONCOLLINEAR、LSORBIT | 使用旋量轨道;SOC 自动启用非共线,需 vasp_ncl;非共线默认 NBANDS 增大 | 同时核对旋量分量、实际 NBANDS 和 NKPTS;不能把普通 std 估算简单乘 2 或乘 4 |
| ISYM、SYMPREC 及结构对称性 | 决定自动网格约化;对称化本身也有工作区,ISYM=2 比 1 使用更节省内存的实现 | 关闭对称可能减少部分对称化工作区,却增加 k 点总量,整次峰值未必下降 |
| KPOINTS、KSPACING、KGAMMA 和网格偏移 | 改变网格及约化结果;不同居中或偏移不能只按网格乘积比较 | 优先采用实际 NKPTS;ISYM=0 仍可能约化 k 与 −k,不能一律当作完全无约化 |
| 零权重点、能带路径 | 权重为零不表示轨道无需计算或存储 | 显式 KPOINTS 中零权重点也应计入;SCF 网格的 NKPTS 不能代替全部路径点 |
| KPOINTS_OPT、KPOINTS_OPT_NKBATCH | 自洽完成后有独立的额外 k 点计算;批次越大,官方说明其内存需求越高 | 分开记录 SCF 网格与后处理网格和批量;不能用一个普通 SCF 的 NKPTS 覆盖两个阶段 |
本集群的固定 64 原子对照中,同一网格从 ISYM=2 改为 0、−1,实际 NKPTS 从 8 增至 14、27;P100 单卡采样最大值相应为 3.305、3.621、4.246 GiB。这证明对称性会通过实际 k 点改变容量,但不是独立的对称化数组增量测量。
5.3 算法、投影与交换相关方法#
| 参数或方法 | 影响机制 | 当前证据与使用边界 |
|---|---|---|
| ALGO、IALGO | Davidson、RMM 等使用不同轨道、子空间及暂存工作区;Exact 是更耗内存的完全对角化路径 | 已比较 Normal/Fast/VeryFast 的部分配置;必须观察真正进入目标算法,而不只是启动时的 DAV 阶段 |
| LREAL、ROPT | 实空间与倒空间使用不同的非局域投影表示;ROPT 改变实空间投影优化 | 已比较 Auto 与 .FALSE.;手动 ROPT 没有通用标定,不能套一个固定折扣 |
| POTCAR 投影通道 | PAW 非局域投影、一中心矩阵和角动量通道随势而变 | ZVAL 相同也不保证投影数据相同,拟合应保留赝势身份,不能仅保留 NELECT |
| LSCALAPACK、LSCALU 与实际库路径 | 改变正交化及子空间矩阵处理;部分矩阵分布在 MPI 进程之间 | 对大 NBANDS 很重要,但 GPU 端和 CPU 端工作区不同;开关变化不等于固定显存降幅 |
| LHFCALC、NBLOCK_FOCK | 杂化泛函需要精确交换,NBLOCK_FOCK 控制同时处理的轨道数 | 与 NSIM 是不同批量;官方明确它会影响性能和内存,应另作杂化方法的标定 |
| PRECFOCK | 独立控制精确交换 FFT 网格,与普通 DFT 网格不必相同 | 已有 HSE32 原子的 Normal/Accurate 定点对照,不能由普通 PBE 的 PREC 系数替代 |
| LFOCKACE | 使用自适应压缩交换算符,改变交换算符表示及工作过程 | 本批 HSE32 对照中开关没有提高整次峰值;不证明 ACE 的额外数组在所有输入下都免费 |
| NKRED、NKREDX/Y/Z | 对交换或响应方法的 q 网格降采样 | 主要改变工作量;不能把轨道存储或总显存直接除以 NKRED 的三次方,且降采样需要科学精度验证 |
| METAGGA、LASPH | 具体泛函可能需要动能密度、密度导数及 PAW 非球形项 | 只有 R2SCAN 少量定点参考;不同 meta-GGA 不能共用一个容量倍数 |
| LDAU、LDAUL、LMAXMIX | DFT+U 涉及局域占据矩阵;LMAXMIX 改变一中心密度混合与保存的角动量范围 | 由局域矩阵规模推断会改变部分存储,但缺少本集群设备增量标定;U 的数值增大不等于数组尺寸按比例变大 |
| IMIX、MAXMIX | 混合器保存历史向量,MAXMIX 设置保存数量,正值可跨离子步保留历史 | 官方明确更长历史会增加混合器内存;设备占用多少要实测,当前 10 步标定不能代表全部长历史峰值 |
这些变化应分别作用于轨道、网格、投影、子空间或暂存特征,而非对整次显存统一乘一个方法系数。
5.4 常用输出与后处理#
| 参数或功能 | 可能改变的阶段与数据 | 显存估算怎样处理 |
|---|---|---|
| LORBIT、RWIGS、EMIN/EMAX | 局域轨道投影、相位及相关后处理;不同投影方法使用不同数据 | 已测 0/1/10/11/12/14;未测模式不能直接外推;PROCAR 文件大小不代表设备驻留量 |
| NEDOS | DOS 的能量网格;用于 LOPTICS 时也是频率网格 | 已测投影 DOS 的 301/3001/10001;不能据此判断光学后处理同样没有峰值增量 |
| IDIPOL、LDIPOL、DIPOL | 能量修正与势/力修正不同;方向、中心及结构影响实际路径 | 已有单/多卡薄层及分子对照;真空导致的网格增加应与修正开关本身分开 |
| LOPTICS | 自洽后计算跃迁及频率相关介电矩阵,通常需要更多空带 | 实际 NBANDS、k 点及 NEDOS 都需记录;此阶段没有独立标定,不能只估基态 SCF |
| LEPSILON、LCALCEPS、IBRION=7/8 | 电场或声子响应需要额外计算路径和工作区 | 与 LOPTICS 的空带求和机制不同;LEPSILON 本身不要求为该方法增加空带,不使用统一响应方法倍数 |
| LAECHG | 在细 FFT 网格上重建全电子电荷密度,初始和自洽后都有输出 | 网格增加及重建工作区需要观察;AECCAR 的文件尺寸不能直接换算成显存 |
| LELF、LPARD 及势文件输出 | ELF、部分电荷或局域势需要相应计算、数组和写出阶段 | 主机/设备分配及 GPU 功能支持须按具体版本核验;不凭开关名字给出固定 GiB |
| LWAVE、LCHARG | 写出已有轨道/电荷,可能有暂存和传输 | 已测 96Si 开/关输出的整次峰值相同,关闭它们不等于释放运行所需的轨道和电荷数组 |
| LWANNIER90、LWANNIER90_RUN、LWRITE_UNK | 投影、邻接 k 点重叠矩阵、轨道写出或库内局域化;输入还来自 wannier90.win | 单独记录接口阶段,NBANDS、k 点、num_wann 及邻接信息;库在 CPU 执行的部分主要占主机 RAM,不能把它全部算作显存 |
| LSOL 及 GPU 溶剂补丁 | 启用溶剂后存在额外势、场和求解工作;GPU 移植会改变哪些数组驻留设备 | 普通版标定不能代表 sol 的全流程;编译进补丁和真正启用 LSOL 是不同条件 |
| GW、RPA、BSE | 空带、频率或响应矩阵带来不同规模和实现路径 | 必须使用对应方法、版本和 GPU 功能范围的验证;普通 DFT 拟合不适用 |
5.5 迭代过程、重启和软件运行环境#
| 因素 | 应怎样理解 |
|---|---|
| NELM、NELMIN、EDIFF | 主要控制迭代次数与收敛,不表示每多一步就永久多存一套波函数;但更长运行可能填满混合历史、触发其他阶段或改变内存池高水位 |
| NSW、IBRION、ISIF | 增加离子步数主要增加运行时间;原子移动、晶胞变化、预测和力/应力阶段可能改变暂存。单个静态结构不能代表整个优化/MD 的最高占用 |
| ISTART、ICHARG、已有 WAVECAR/CHGCAR | 冷启动、重启、固定电荷的路径不同;ISTART=2 还可能保留旧基组,因此仅由新 POSCAR 体积和 ENCUT 推算不够 |
| ISMEAR、SIGMA、AMIX/BMIX 等 | 主要影响占据与收敛,通常不像 NBANDS、网格那样直接决定最大数组维度;通过空带需求、迭代历史和算法路径仍可产生间接影响 |
| MPI 进程与 GPU 映射 | 本文按每 GPU 一个 MPI 进程;多个进程共用一张卡会叠加上下文、通信及重复数据,不能套用这个布局的估算 |
| NCCL、P2P、设备缓存、CUDA 库与工具链 | 通信缓冲、cuFFT/cuSOLVER 等工作区及内存池会改变设备分配高水位,可能产生非单调差异;本集群对照独立保留在 7 |
| GPU 上其他进程 | 影响本轮设备已用量和实际空闲量;需区分作业自身增量、GPU 背景占用及最满单卡 |
5.6 当前估算器的覆盖范围与后续改进重点#
| 因素 | 当前 yskit 的处理 |
|---|---|
| 体积、ENCUT、NBANDS、NKPTS、卡数/KPAR/NSIM | 已纳入普通非磁性 std 拟合;NBANDS 含并行补齐,k 点使用实际参考或非磁性对称预估 |
| PREC、ADDGRID、LREAL、Normal/Fast/VeryFast | 已有部分对照并纳入模型;不等于任意参数组合都已验证 |
| LORBIT/NEDOS、IDIPOL/LDIPOL/DIPOL | 已有新增单/多卡对照;超出已测模式、范围或中心位置时按外推处理 |
| 自旋、SOC、gam、HSE、R2SCAN | 只有少量相同输入的定点参考,不使用普通模型作通用预测 |
| 手动 FFT 网格、ROPT、响应方法 | 当前没有可靠通用估算;已识别的这些输入会返回证据不足 |
| MAXMIX、KPOINTS_OPT、LOPTICS、LAECHG、LELF、Wannier90 等新增因素 | 尚无独立拟合项;目前程序也未完整识别所有这些额外阶段,基础 DFT 数值不能被当作全流程峰值 |
| 非默认 NCCL/设备缓存 | 诊断数据与普通标定分开,检测到相应运行时变更时不套用普通估算 |
6. 本集群的显存实测#
本节基础扫描使用VASP6.6.1;其他版本没有逐一完成同样的全参数扫描。
下表为Γ单点、单GPU、普通std程序,单位GiB;ENCUT=350 eV、NSIM=32、KPAR=1、ALGO=Normal、PREC=Normal、LREAL=Auto、ADDGRID开启;实际NBANDS列于表中。原子数增长同时改变体积和默认电子数,应结合表中带数理解。
| 原子数 | 默认NELECT | 实际NBANDS | P100单卡采样最大值/GiB | V100单卡采样最大值/GiB |
|---|---|---|---|---|
| 8 | 32 | 56 | 2.215 | 2.388 |
| 32 | 128 | 112 | 2.617 | 2.793 |
| 64 | 256 | 168 | 2.943 | 3.119 |
| 96 | 384 | 280 | 3.637 | 3.812 |
| 144 | 576 | 392 | 4.637 | 4.812 |
| 216 | 864 | 560 | 6.350 | 6.537 |
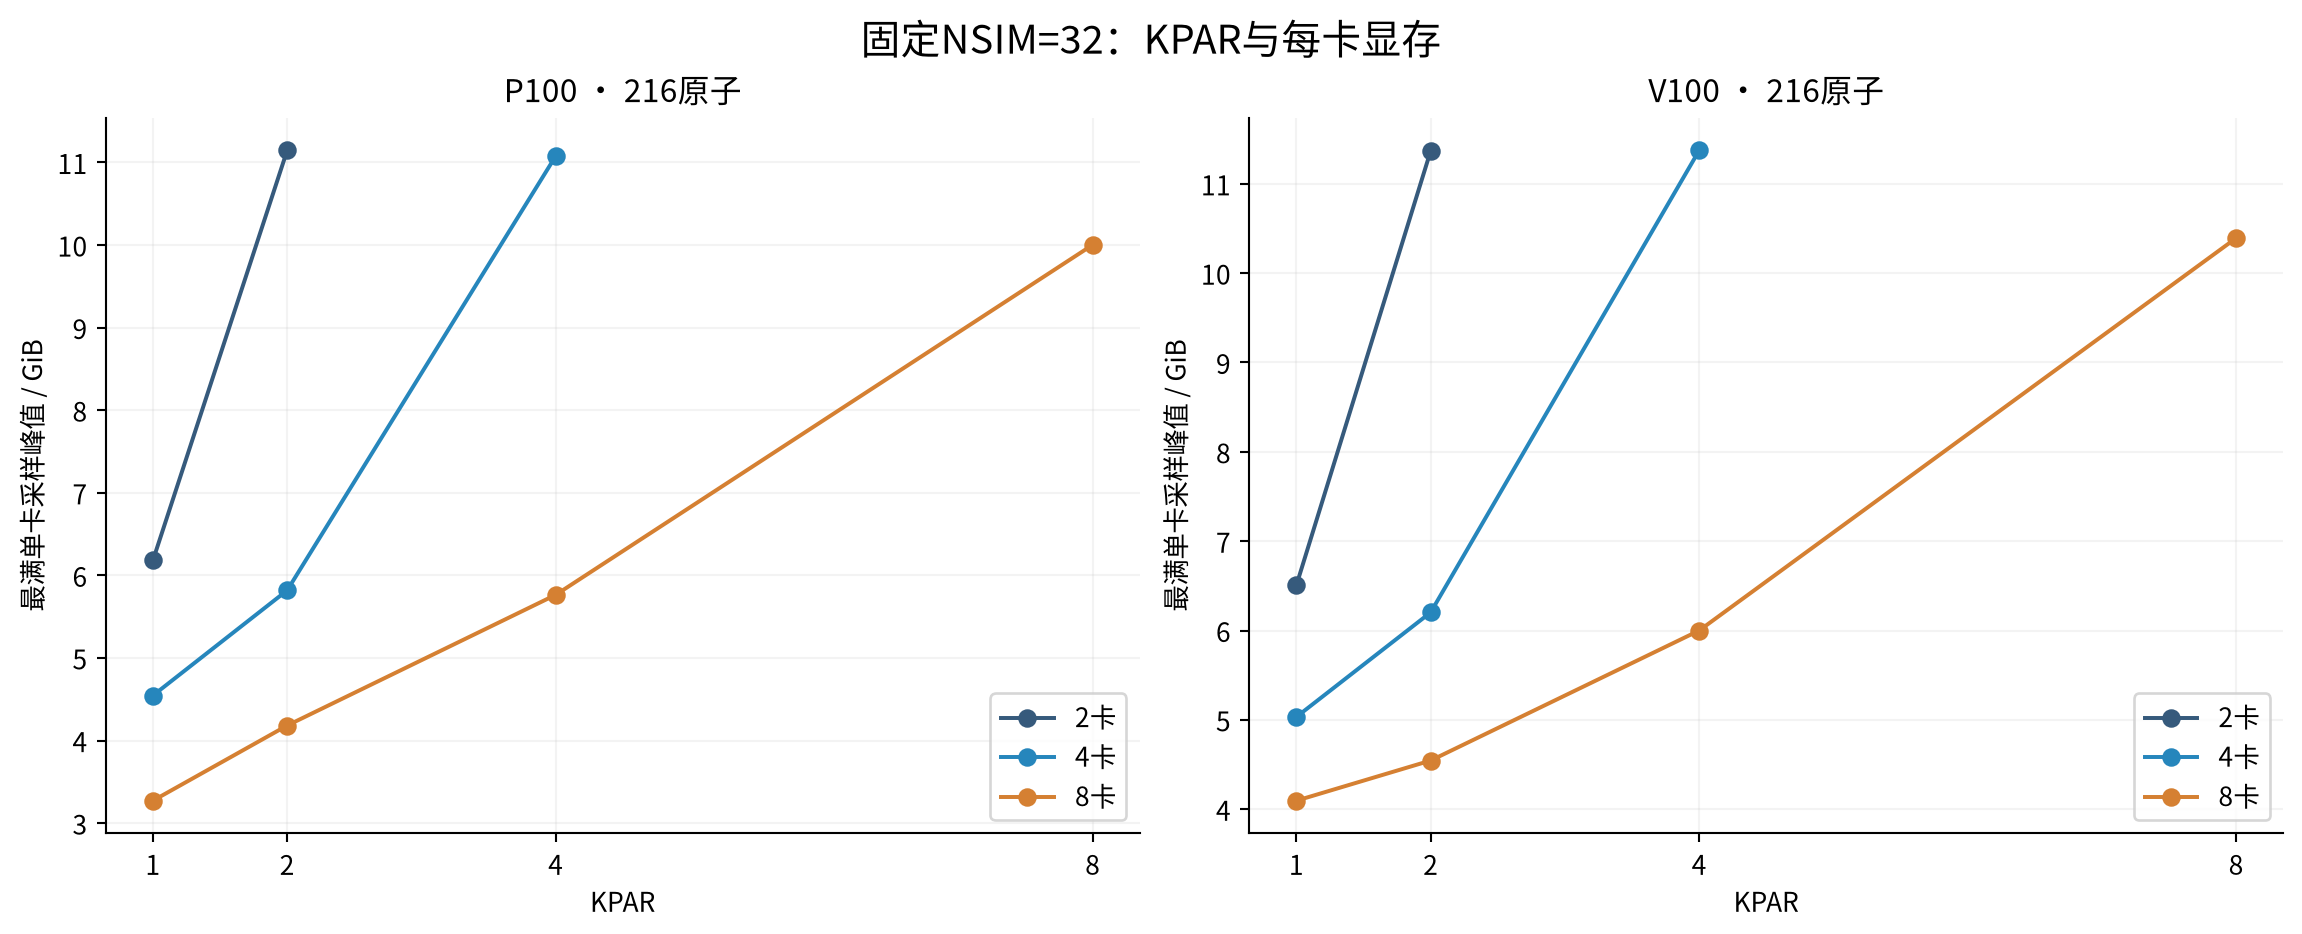
固定八卡、NSIM32、实际NKPTS=8的最满单卡采样最大值:
| 平台 | 原子数 | KPAR1/GiB | KPAR2/GiB | KPAR4/GiB | KPAR8/GiB |
|---|---|---|---|---|---|
| P100 | 216 | 3.272 | 4.182 | 5.764 | 10.002 |
| V100 | 216 | 4.095 | 4.545 | 6.000 | 10.392 |
图M4:固定NSIM=32的216原子Si,保留原2/4/8卡曲线;96原子的通信与缓存机制对照另列独立小节。
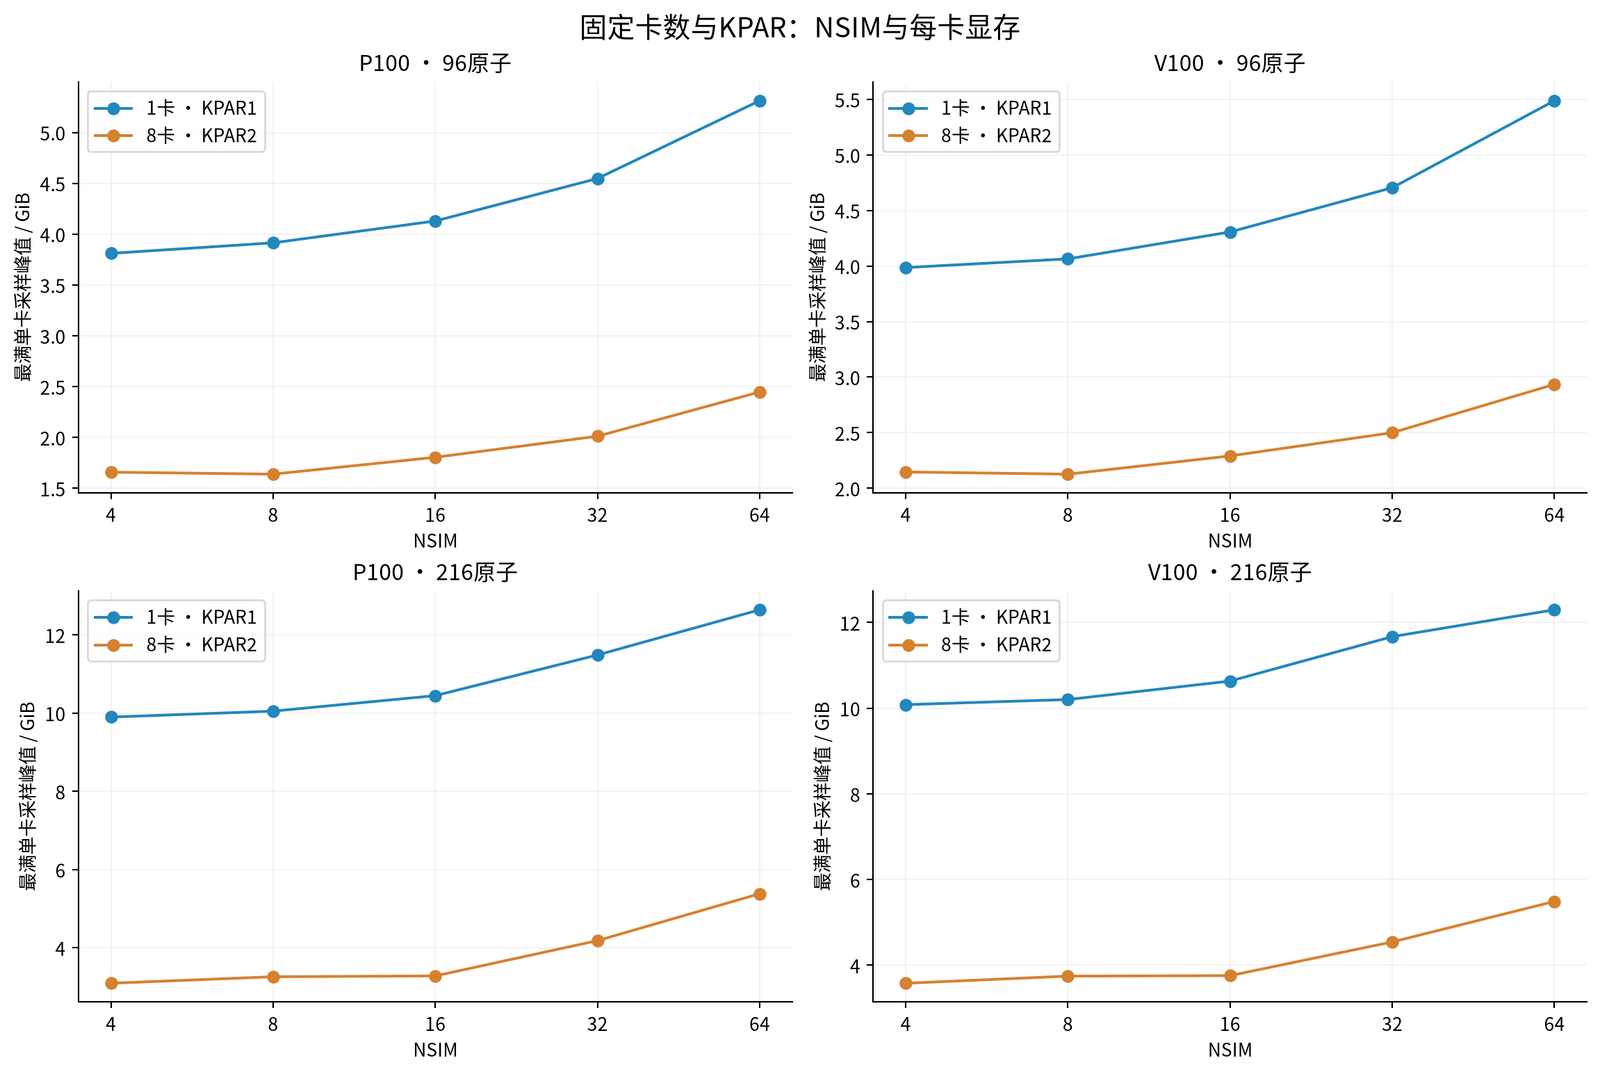
图M4固定NSIM比较KPAR,图M5固定卡数/KPAR比较NSIM。图M5使用实际NKPTS=8;单卡曲线为KPAR1,八卡曲线为KPAR2,每条曲线内部只改变NSIM。容量选择应基于最满单卡,不把同一组中的最快NSIM与另一组任意NSIM混合比较。
同一八卡输入,在已测合法KPAR/NSIM候选中比较容量和时间:
| 平台 | 原子数 | 选择依据 | KPAR | NSIM | 单卡采样最大值/GiB | 本次短步LOOP+/s |
|---|---|---|---|---|---|---|
| P100 | 96 | 最低显存 | 2 | 8 | 1.639 | 23.110 |
| P100 | 96 | 最短短步时间 | 2 | 16 | 1.805 | 22.214 |
| P100 | 216 | 最低显存 | 1 | 8 | 2.459 | 79.207 |
| P100 | 216 | 最短短步时间 | 2 | 32 | 4.182 | 61.761 |
| V100 | 96 | 最低显存 | 2 | 8 | 2.127 | 16.151 |
| V100 | 96 | 最短短步时间 | 2 | 16 | 2.291 | 15.684 |
| V100 | 216 | 最低显存 | 1 | 4 | 3.322 | 55.511 |
| V100 | 216 | 最短短步时间 | 2 | 32 | 4.545 | 41.556 |
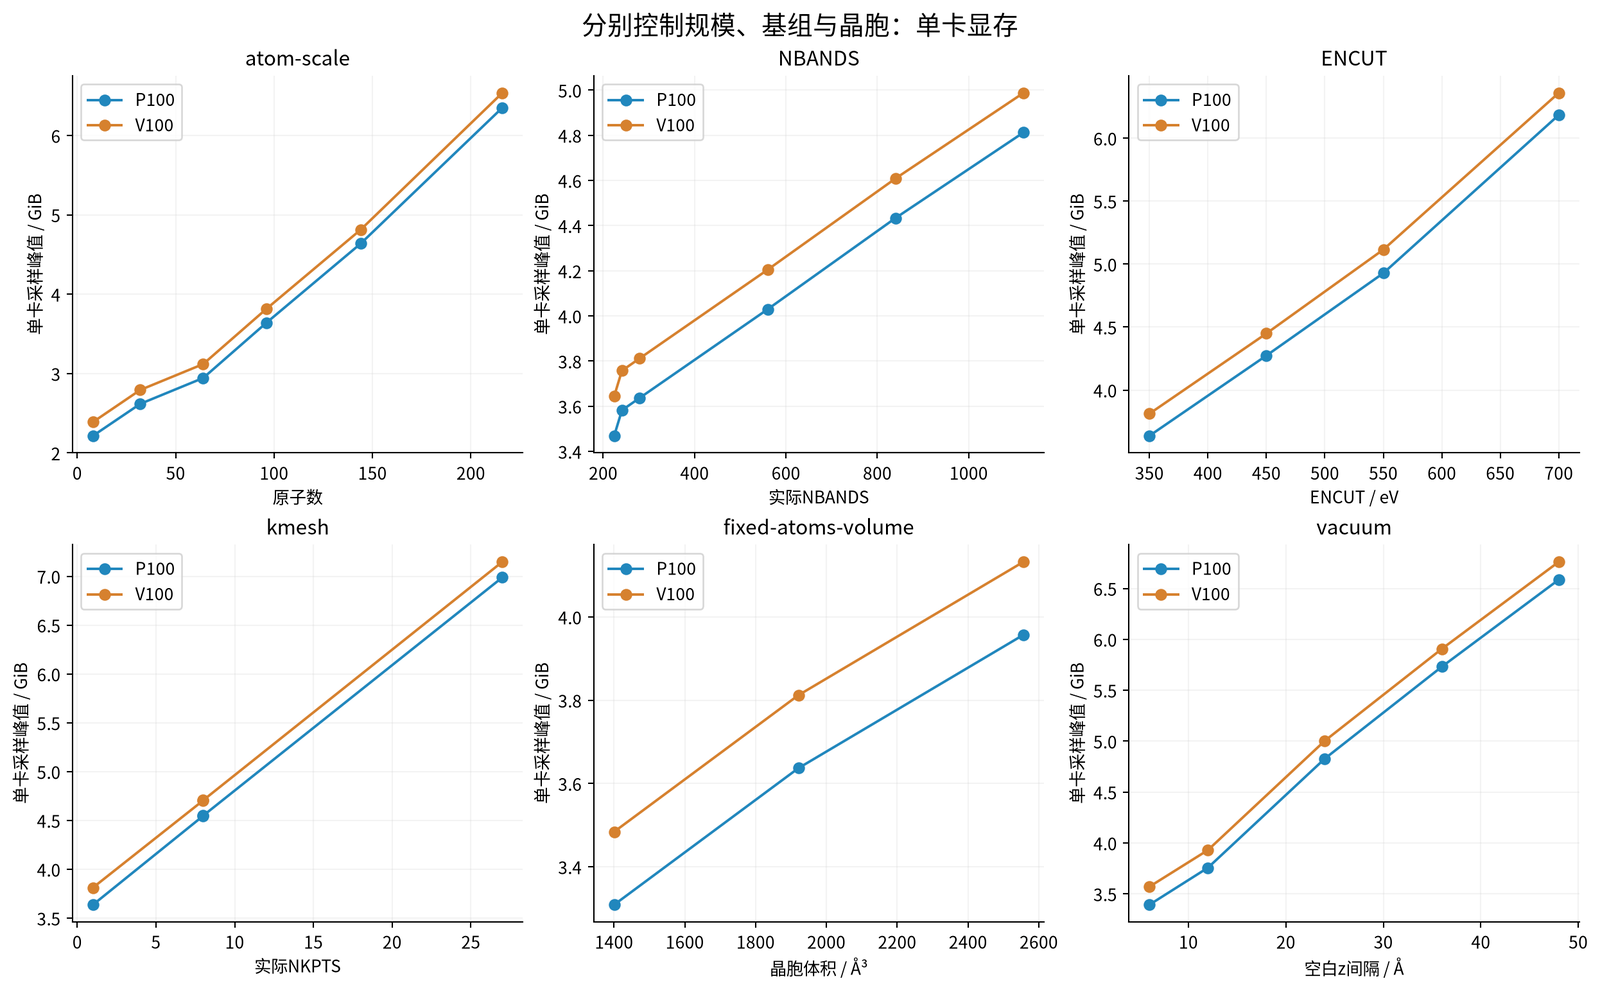
图M6的各面板分别改变一个主要规模因素:原子规模对照同步改变带数与晶胞;NBANDS对照则固定原子与基组,显示增加空带本身的代价。k点越密,需保存的轨道也增加。固定原子数只扩大周期盒子,同样会提高显存,说明“显存/原子”的单一比值不适合外推到表面或分子。
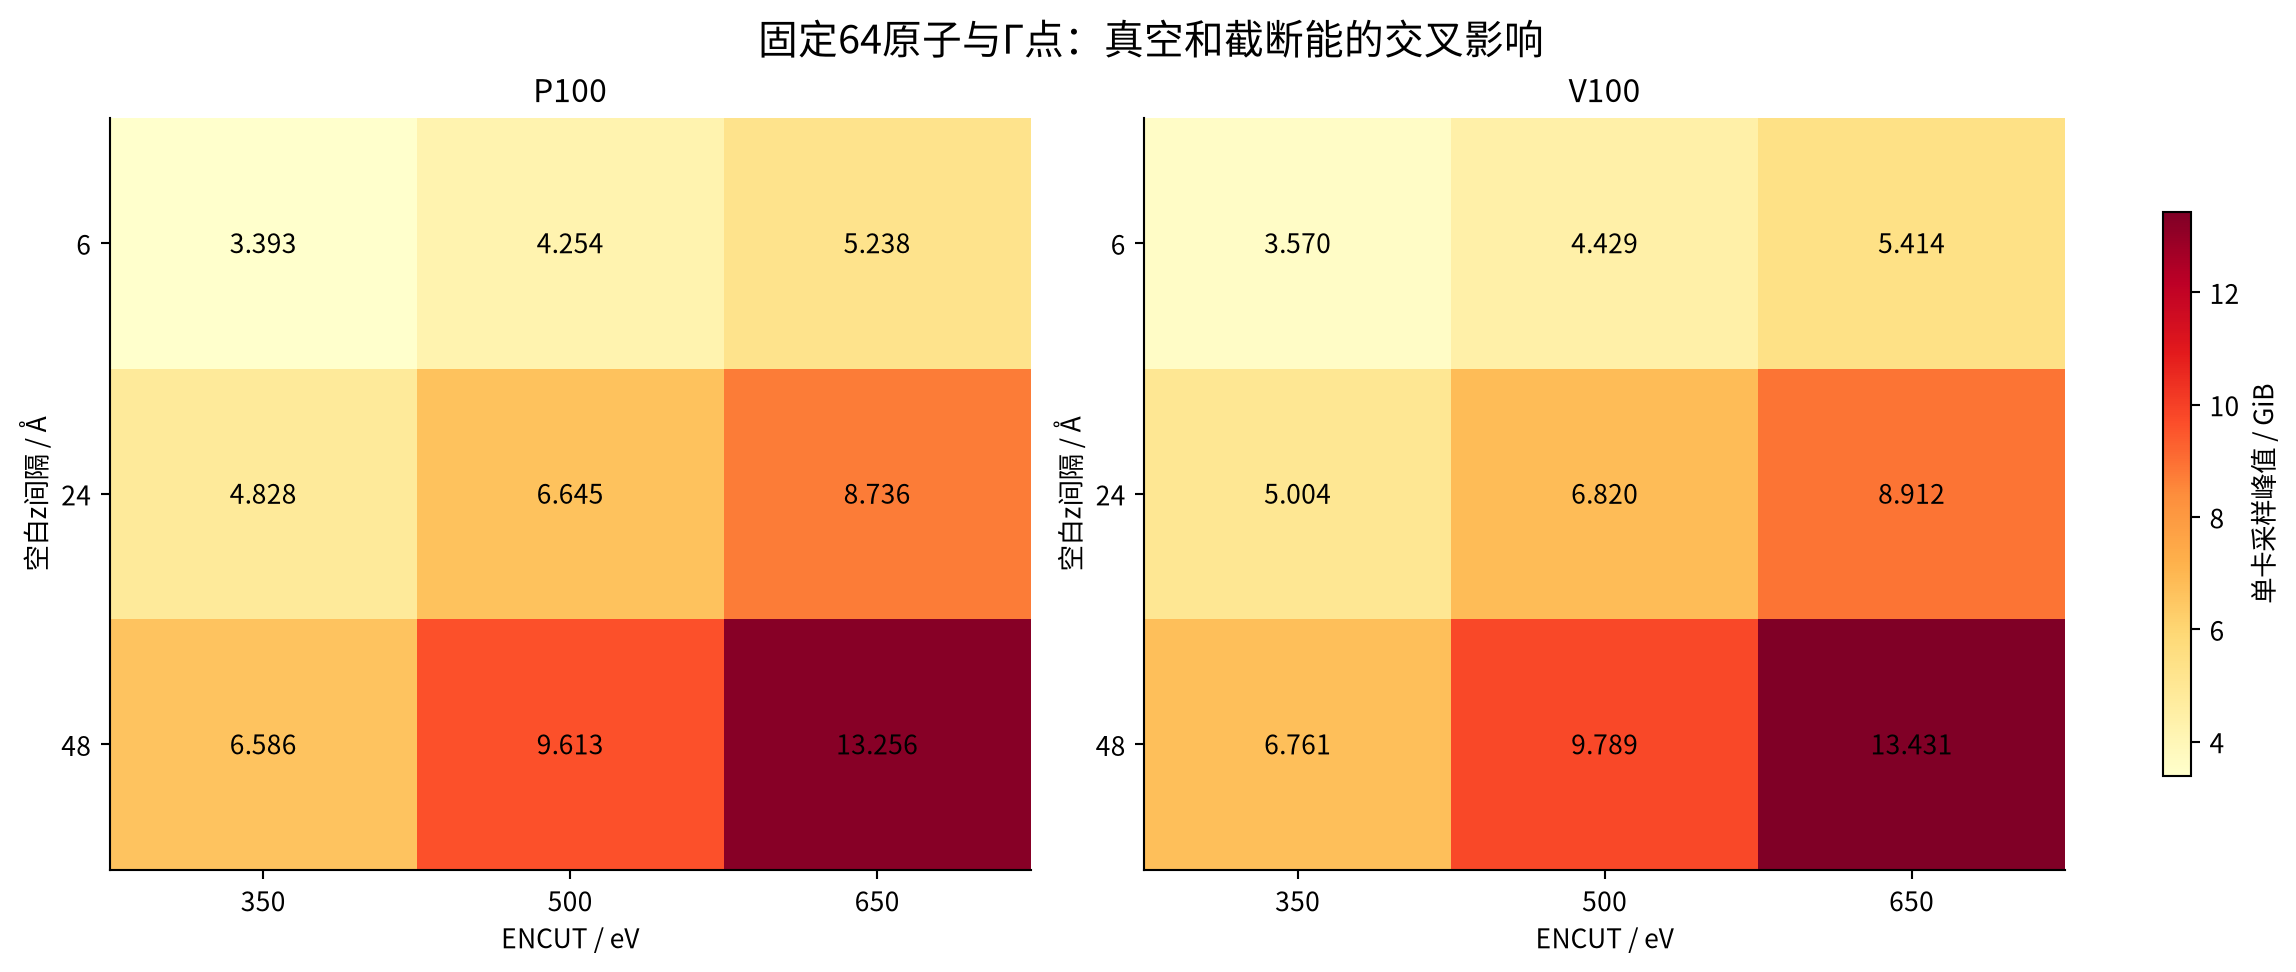
图M7给出更直接的容量例子:同样64原子,P100从6 Å空白间隔、350 eV的3.393 GiB,变为48 Å、650 eV的13.256 GiB;V100相应为3.570和13.431 GiB。原子数没有增加,完整盒子与截断能却同时放大了基组。因此不能用某个紧凑体相的“可算原子数”保证真空体系也装得下。
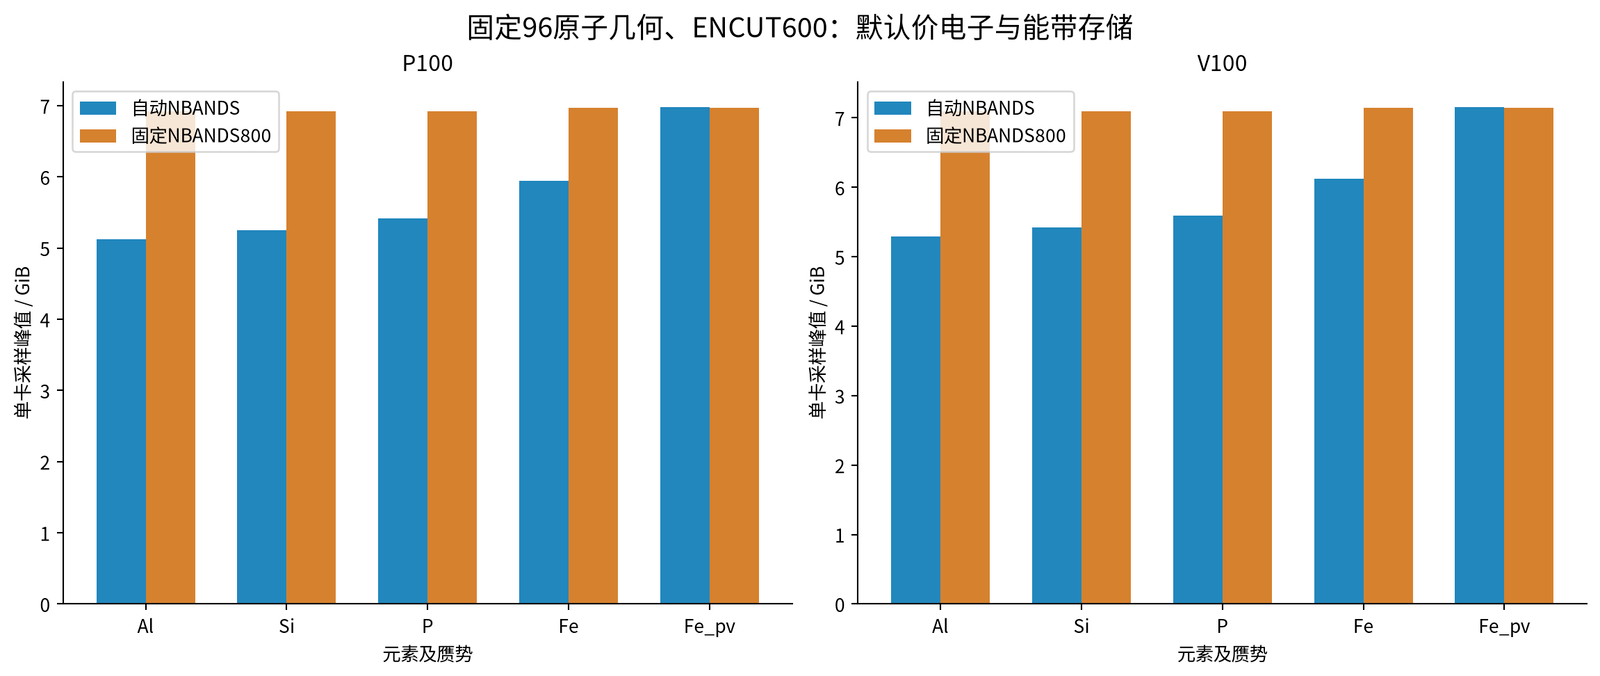
图M8将原子种类的影响拆开观察:采用自动带数时,不同赝势带来不同的默认电子数与NBANDS,显存差异较大;固定NBANDS=800后差异显著缩小,但投影与一中心数据仍有不同。它支持“电子数通过轨道数等途径影响容量”,并不表示不同元素仅由NELECT就能等价替换。没有显式修改NELECT。
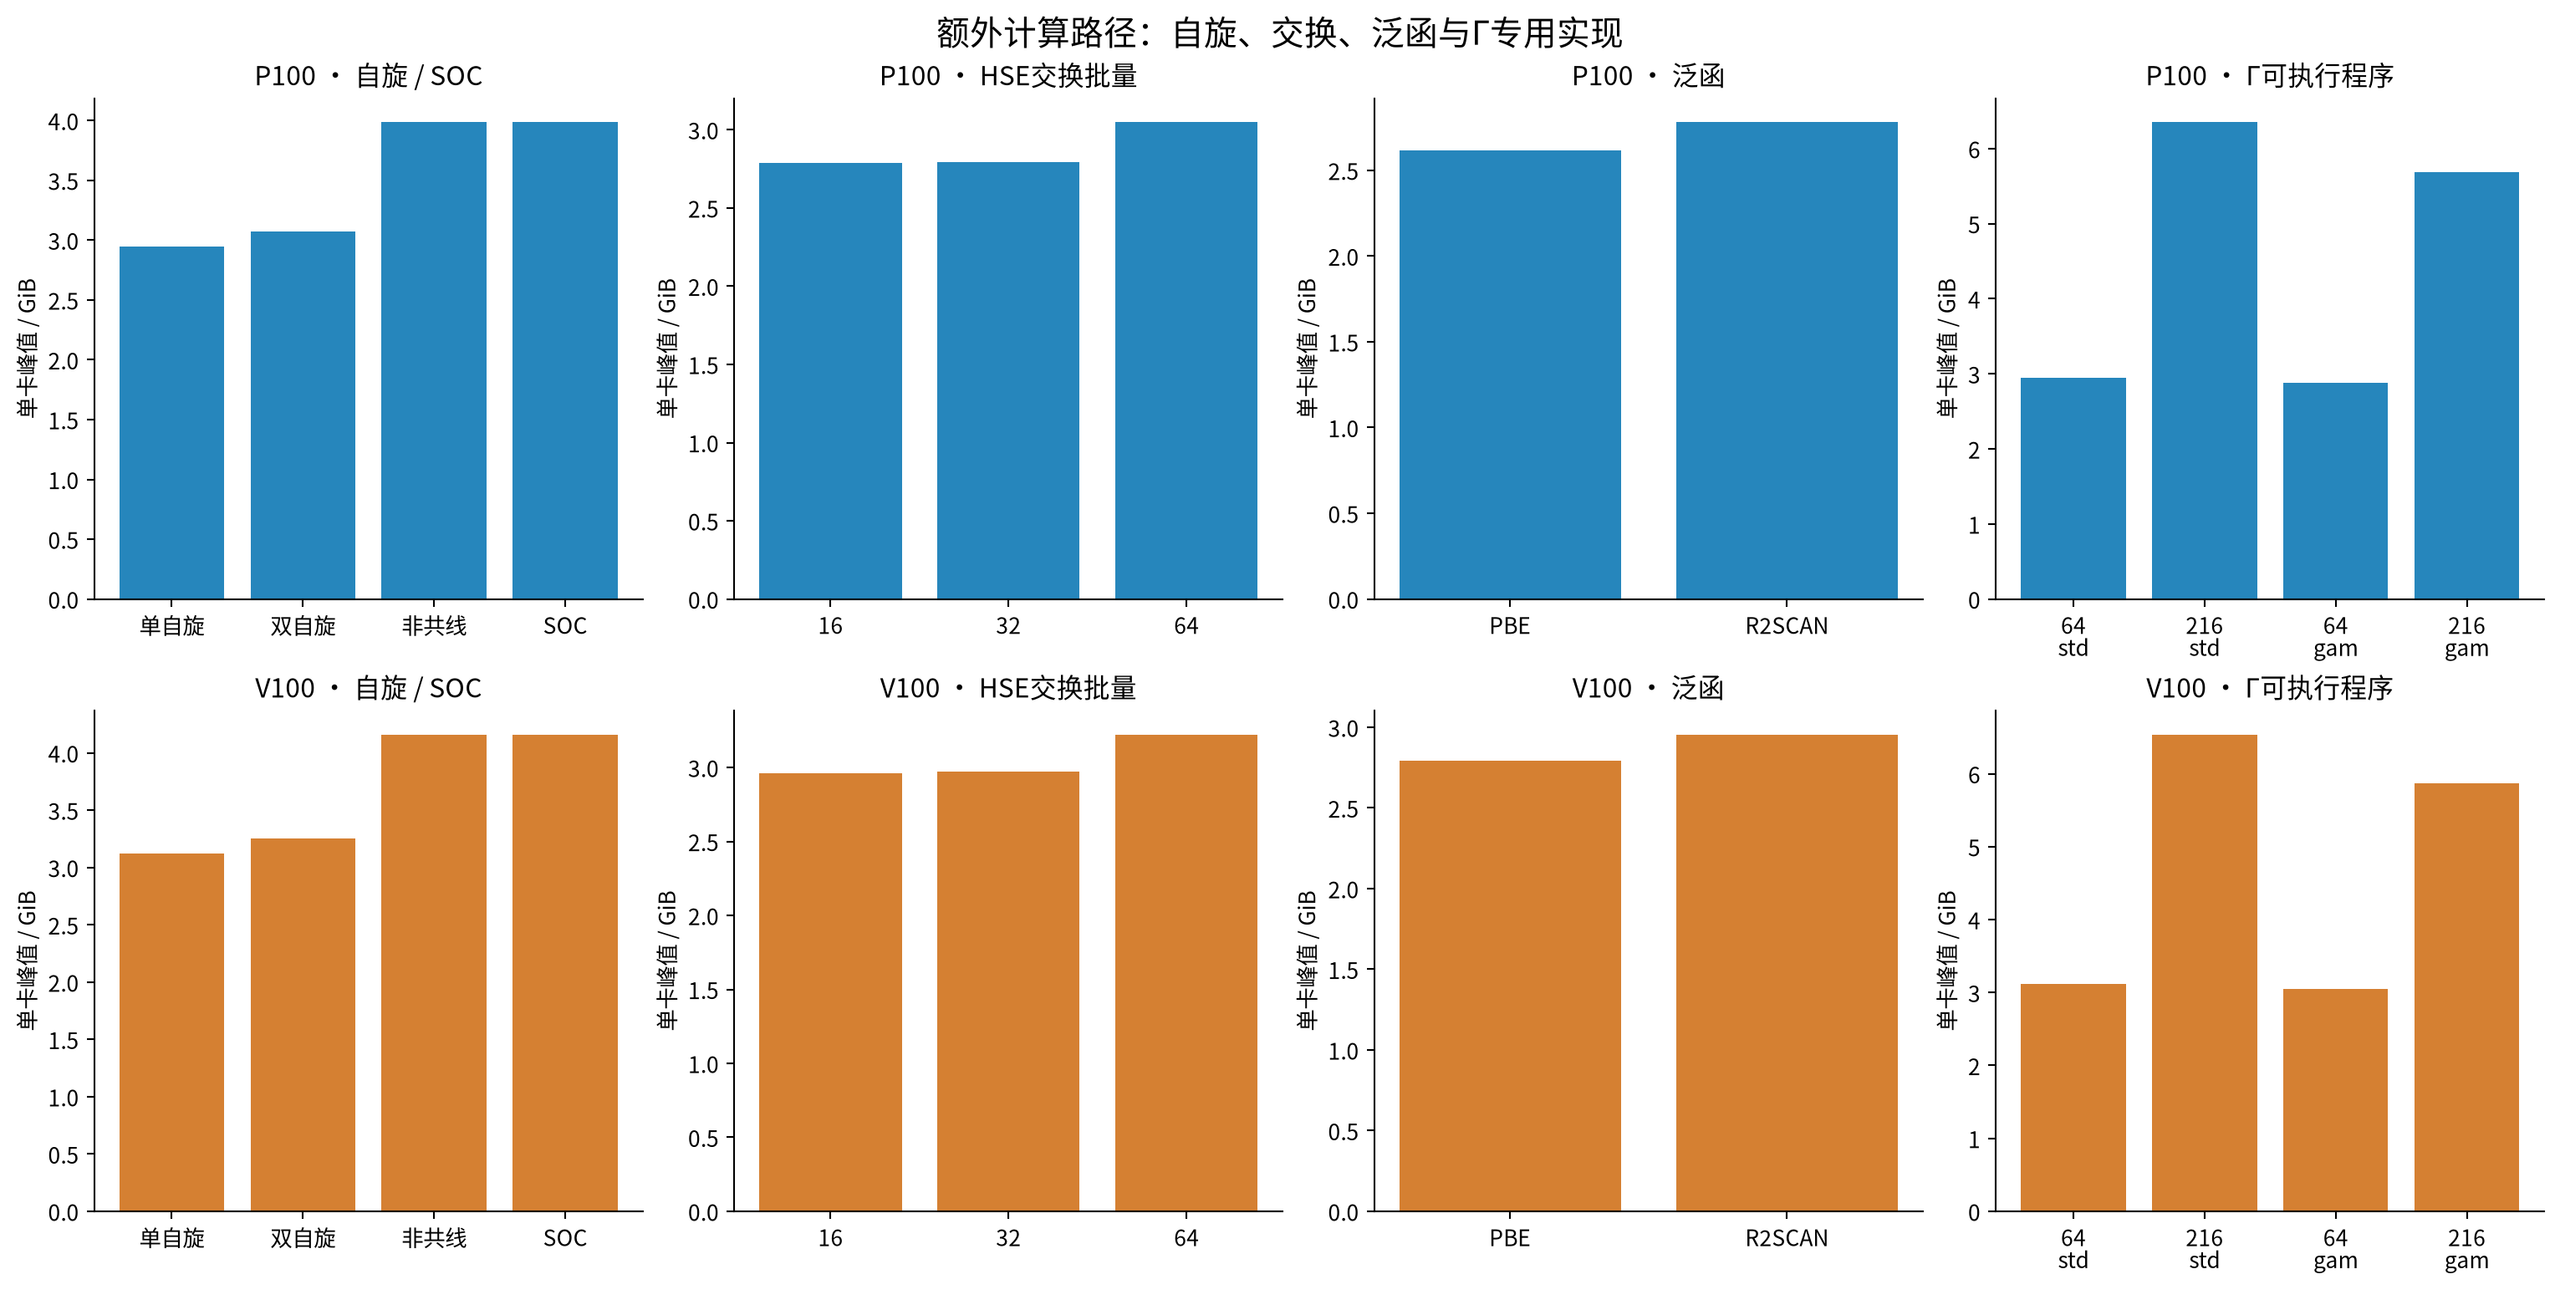
图M9包含方法与程序类型的定点对照。杂化泛函的交换工作区、磁性与旋量轨道,以及Γ点专用程序的表示方式,均须单独核对;某个小测试开关前后总峰值相同,不代表该功能不分配额外数组。
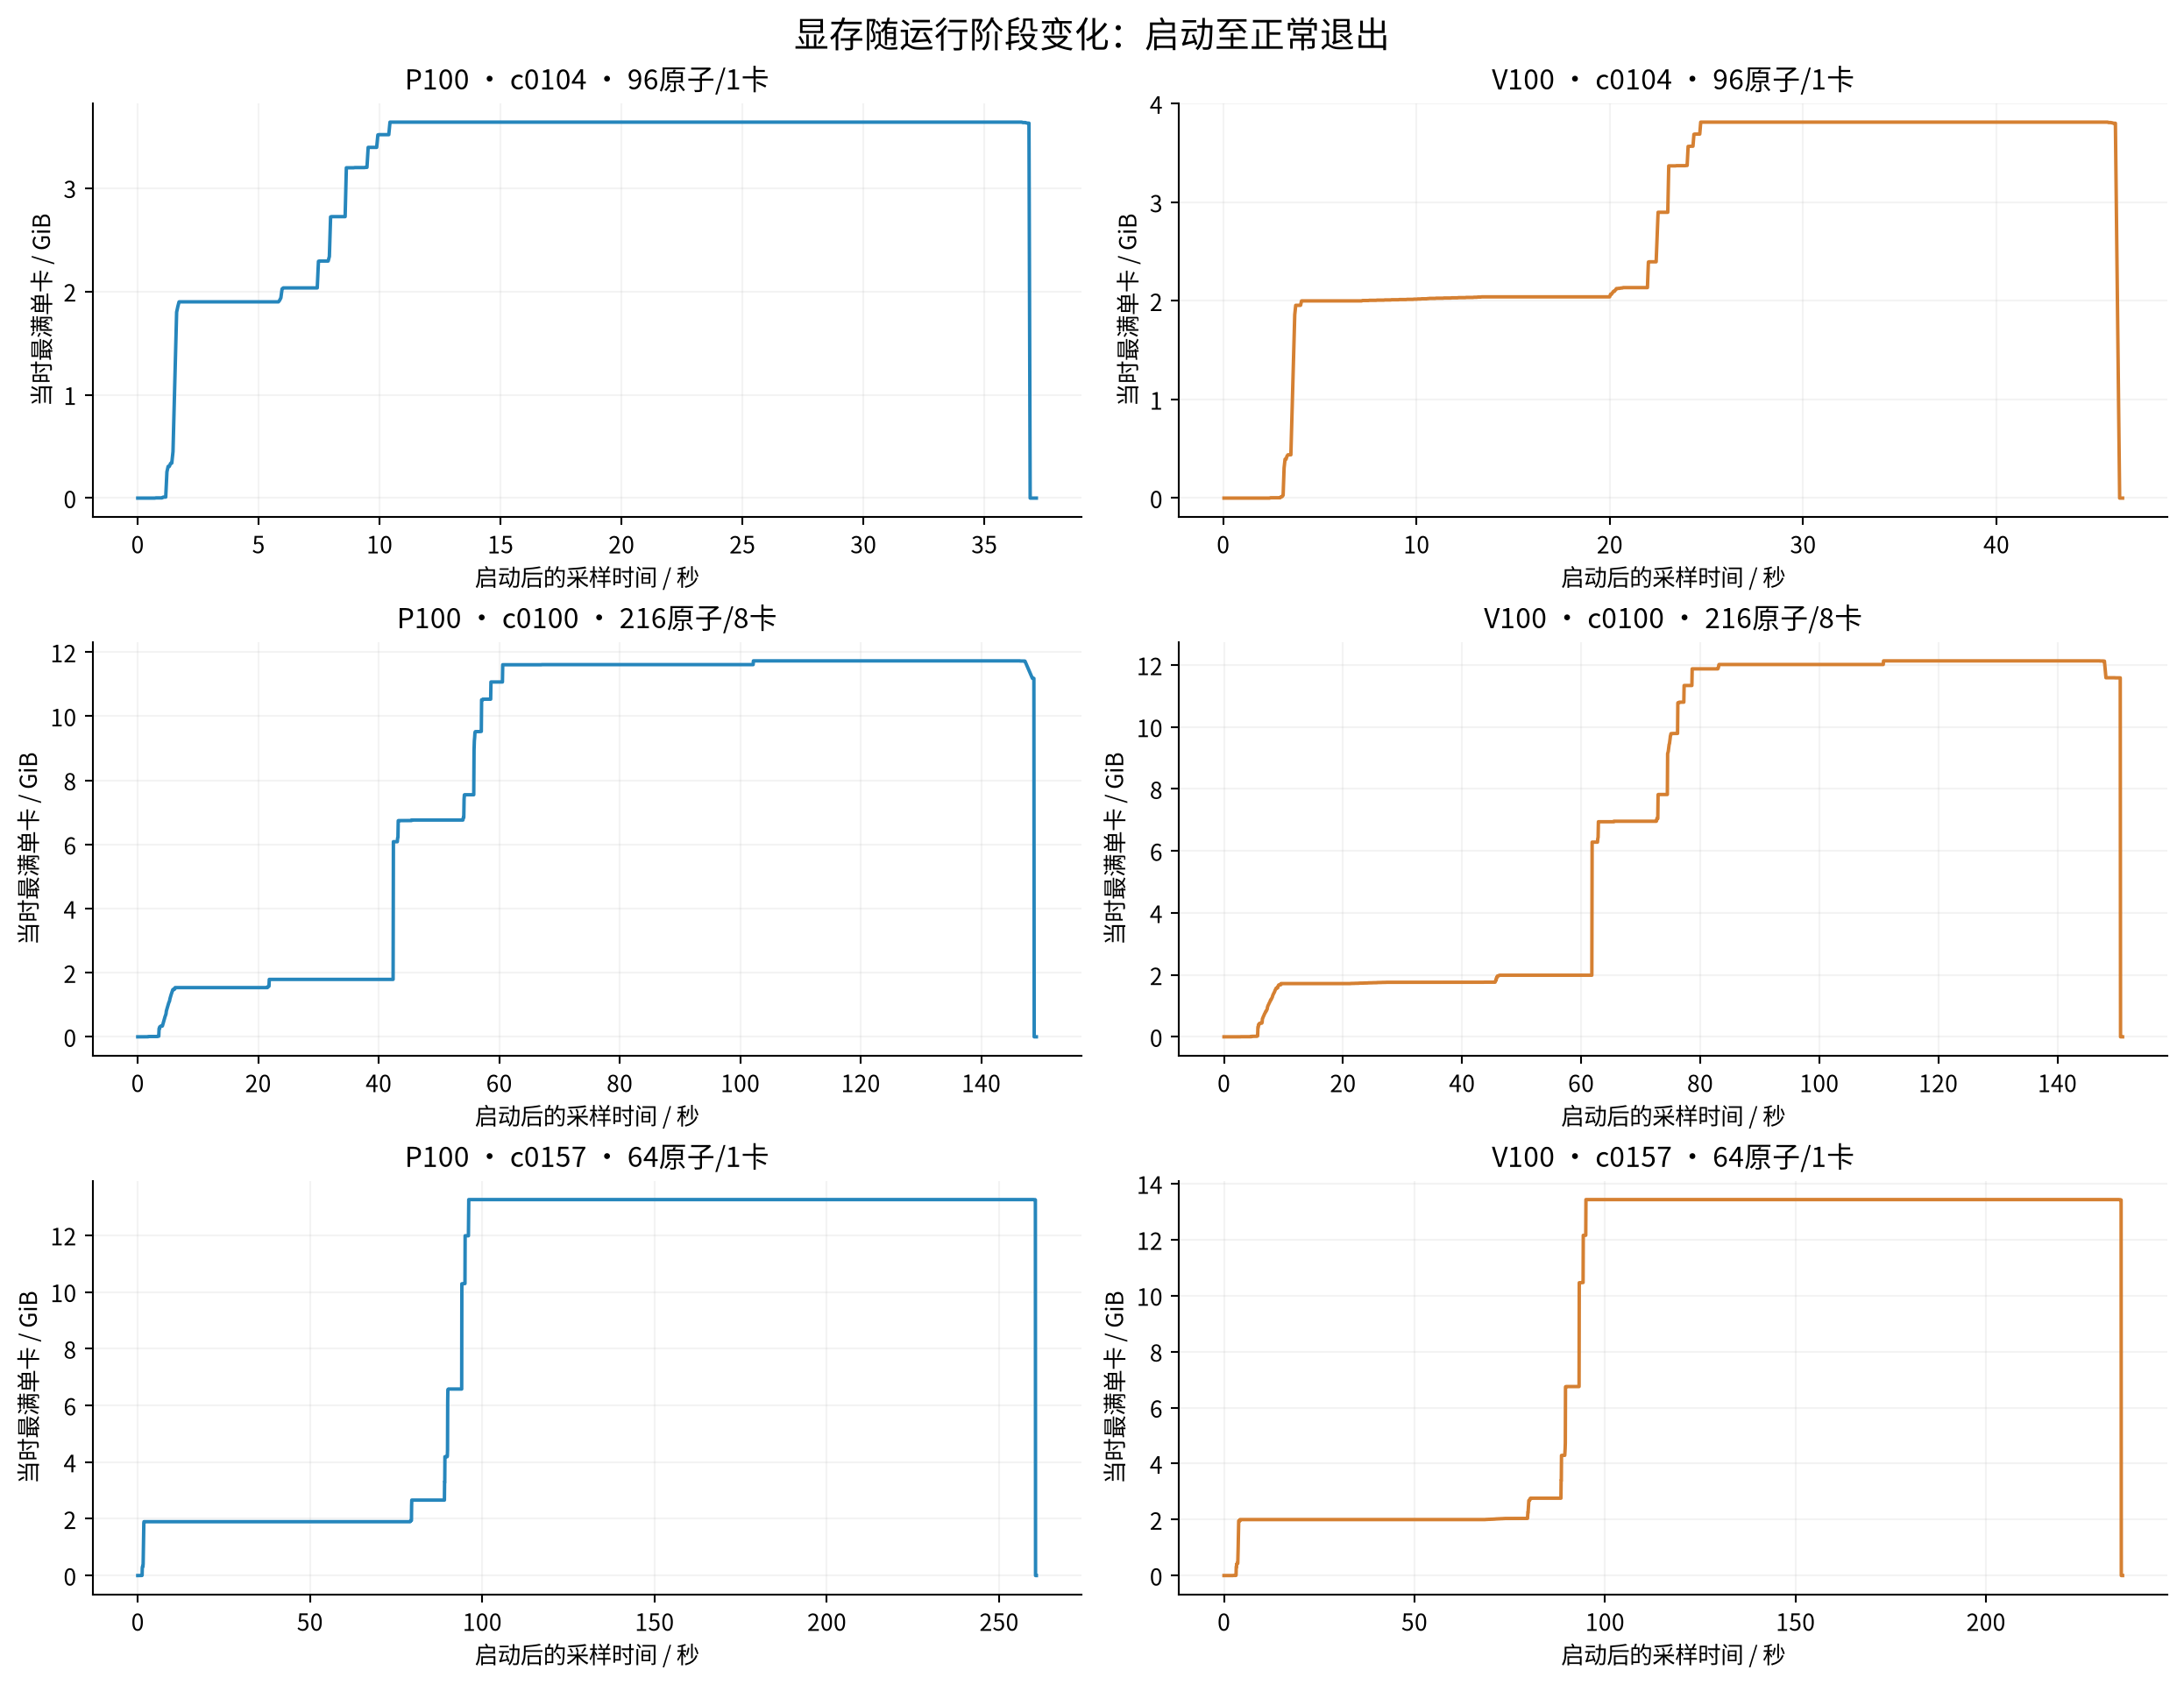
图M10展示启动、电子迭代以及最后一步/后处理的占用变化。只在某个电子步结束后查询一次,可能错过初始化工作区;容量测试应从进程启动前一直记录到退出。
中性原子种类对照保持96原子几何与ENCUT600不变。不同赝势被放入同一控制几何,未分别优化到各材料的稳定晶相;电子数之外,投影通道等也同时变化。因此这是容量控制实验,不是这些材料生产性能的排名。所有电子数来自原子数和POTCAR。
| 平台 | 赝势 | 原子数 | ZVAL | 默认NELECT | 带数设置 | 实际NBANDS | 单卡采样最大值/GiB |
|---|---|---|---|---|---|---|---|
| P100 | Al | 96 | 3.0 | 288 | 自动 | 193 | 5.121 |
| P100 | Si | 96 | 4.0 | 384 | 自动 | 241 | 5.246 |
| P100 | P | 96 | 5.0 | 480 | 自动 | 289 | 5.414 |
| P100 | Fe | 96 | 8.0 | 768 | 自动 | 460 | 5.943 |
| P100 | Fe_pv | 96 | 14.0 | 1344 | 自动 | 806 | 6.983 |
| P100 | Al | 96 | 3.0 | 288 | 800 | 800 | 6.922 |
| P100 | Si | 96 | 4.0 | 384 | 800 | 800 | 6.922 |
| P100 | P | 96 | 5.0 | 480 | 800 | 800 | 6.924 |
| P100 | Fe | 96 | 8.0 | 768 | 800 | 800 | 6.969 |
| P100 | Fe_pv | 96 | 14.0 | 1344 | 800 | 800 | 6.965 |
| V100 | Al | 96 | 3.0 | 288 | 自动 | 193 | 5.297 |
| V100 | Si | 96 | 4.0 | 384 | 自动 | 241 | 5.422 |
| V100 | P | 96 | 5.0 | 480 | 自动 | 289 | 5.589 |
| V100 | Fe | 96 | 8.0 | 768 | 自动 | 460 | 6.119 |
| V100 | Fe_pv | 96 | 14.0 | 1344 | 自动 | 806 | 7.158 |
| V100 | Al | 96 | 3.0 | 288 | 800 | 800 | 7.097 |
| V100 | Si | 96 | 4.0 | 384 | 800 | 800 | 7.097 |
| V100 | P | 96 | 5.0 | 480 | 800 | 800 | 7.099 |
| V100 | Fe | 96 | 8.0 | 768 | 800 | 800 | 7.144 |
| V100 | Fe_pv | 96 | 14.0 | 1344 | 800 | 800 | 7.140 |
单卡Γ算例的步数及采样间隔校验(96原子、KPAR1、NSIM32;不覆盖多卡KPAR比较):
| 平台 | 电子步数 | 目标采样间隔/s | 单卡采样最大值/GiB | 实际最大采样间隔/s |
|---|---|---|---|---|
| P100 | 10 | 0.05 | 3.637 | 0.1538 |
| P100 | 30 | 0.05 | 3.637 | 0.1610 |
| P100 | 10 | 0.01 | 3.637 | 0.1654 |
| V100 | 10 | 0.05 | 3.812 | 0.2206 |
| V100 | 30 | 0.05 | 3.812 | 0.2024 |
| V100 | 10 | 0.01 | 3.812 | 0.2120 |
另外还逐项测量了投影、算法、支撑网格、对称性、零权重点和写出等。完整分项表见显存测试报告;自动FFT维度、轨道和投影分配不是连续函数,不能将每一个因素都假定为单调、线性增长。
同输入P100/V100共形成184组短步能量/力对照,其中0组超过诊断阈值(0.01meV/原子、最大力分量0.001eV/Å)。该诊断保留未收敛迭代路径的差异,不等同于生产计算精度验收;有限输出和正常退出只确认本次容量工作负载完成。
这些测量覆盖正常退出和力/写出阶段,但仍可能漏掉采样之间的暂态。显存测试中的时间不加入原30步性能主表。最小可用容量不能只按表格峰值卡在边界上,还需为自己的输入和运行阶段留下余量。
LORBIT与偶极修正补测。 另完成154项VASP6.6.1普通GPU测试,覆盖LORBIT0/1/10/11/12/14、NEDOS301/3001/10001、64/96/216原子、非对称Si slab三个真空方向的IDIPOL/LDIPOL/DIPOL、水分子IDIPOL4,以及投影与偶极组合。单卡及多卡均从启动采样到正常退出,含最终投影后处理;10电子步,只用于容量研究。没有手动修改NELECT。
下表固定96原子Si、NBANDS280、NSIM32、ENCUT350eV;单卡为Γ,4/8卡实际NKPTS8。LORBIT<10带RWIGS,14带EMIN/EMAX。
| 平台 | GPU数 | KPAR | 未设置LORBIT/MiB | LORBIT各设置的最满单卡范围/MiB |
|---|---|---|---|---|
| P100 | 1 | 1 | 3724.125 | 3724.125~3724.125 |
| P100 | 4 | 1 | 2304.125 | 2304.125~2304.125 |
| P100 | 8 | 2 | 2060.125 | 2060.125~2060.125 |
| V100 | 1 | 1 | 3903.625 | 3903.625~3903.625 |
| V100 | 4 | 1 | 2823.625 | 2823.625~2823.625 |
| V100 | 8 | 2 | 2559.625 | 2559.625~2559.625 |
这些数字只比较整次运行最高采样值。峰值相同不说明投影或偶极步骤没有额外分配,也不说明其主机内存、耗时和I/O成本为零。偶极修正仍必须根据体系和收敛要求选择,不应以显存变化小为理由随意开启。
另一个直观例子是三原子水分子,默认NELECT=8,16Å立方真空盒、ENCUT500eV、ADDGRID开启、NBANDS8、NSIM32,使用std/Γ/KPAR1。这个小分子仍有较大的FFT网格与相关工作区,不能仅按原子少就预计极低显存。
| 平台 | GPU数 | 不启用偶极修正/GiB | IDIPOL4+LDIPOL+DIPOL=.5/GiB |
|---|---|---|---|
| P100 | 1 | 6.045 | 6.045 |
| P100 | 8 | 2.826 | 2.826 |
| V100 | 1 | 6.220 | 6.220 |
| V100 | 8 | 3.779 | 3.779 |
这组与Si体系的晶胞、元素和截断均不同,不把两者差值解释成某一个因素的独立贡献。
7. 通信库与设备缓存对显存的影响#
显卡上的占用除了轨道、FFT网格和算法数组,还包含通信缓冲、CUDA库工作区及运行时保留的分配。卡数或KPAR改变后,这些部分也会变化。本节用96原子Si单独研究这种影响,不将其混入上一节的KPAR容量曲线。
对照固定实际NKPTS=8、NBANDS=280、NSIM=32、ENCUT=350eV,以及相同结构、POTCAR和公共VASP6.6.1程序。默认NELECT=384,没有手动修改电子数。每张GPU一个MPI进程、一个CPU核心,P100/V100分别使用250W/300W默认功耗。临时改变三类运行时设置:
| 对照因素 | 此次诊断设置 | 用途 |
|---|---|---|
| NCCL通信库 | INCAR中LUSENCCL=.FALSE. |
比较使用与不使用NCCL的通信路径 |
| 设备缓存 | NVCOMPILER_ACC_MEM_MANAGE=0 |
关闭NVHPC设备内存管理器,观察分配保留的影响 |
| NCCL通道 | NCCL_MAX_CTAS=2 |
保持NCCL开启,限制通信通道;日志确认本次实际为2 |
| 平台 | 配置 | 默认最满单卡/MiB | 通信对照最满单卡/MiB | 通信对照设置 |
|---|---|---|---|---|
| V100 | 4卡、KPAR=1 | 2823.625 | 1863.625 | NCCL最多2条通道 |
| V100 | 8卡、KPAR=1 | 3057.625 | 1905.625 | NCCL最多2条通道 |
| V100 | 8卡、KPAR=2 | 2559.625 | 1971.625 | NCCL最多2条通道 |
| P100 | 8卡、KPAR=1 | 2078.125 | 1694.125 | 关闭NCCL |
| P100 | 8卡、KPAR=2 | 2060.125 | 2040.125 | 关闭NCCL |
V100四卡、八卡KPAR1默认分别采用8和12条主要集合通信通道。限制通道后,两者差距由234缩小到42MiB,说明通信策略贡献显著;剩余42MiB尚未逐项分配归因。八卡KPAR1/2的顺序也由“2较低”变成“2较高”。P100原本只差18MiB(约0.87%),关闭NCCL后同样反转;但P100两组默认主要通道数都是2,不能仅按通道条数解释其差异,还涉及组大小、连接和通信暂存。
只关闭设备缓存没有消除原顺序;限制通道且关闭缓存时,V100八卡KPAR1/2又为1761.625/1693.625MiB。控制之间存在交互,不能将不同运行的差值拆成固定的“NCCL字节”或“缓存字节”。OUTCAR主要数组估算仍表现为八卡KPAR1比四卡小、KPAR2比1大,实际GPU总占用则由更多部分共同决定。
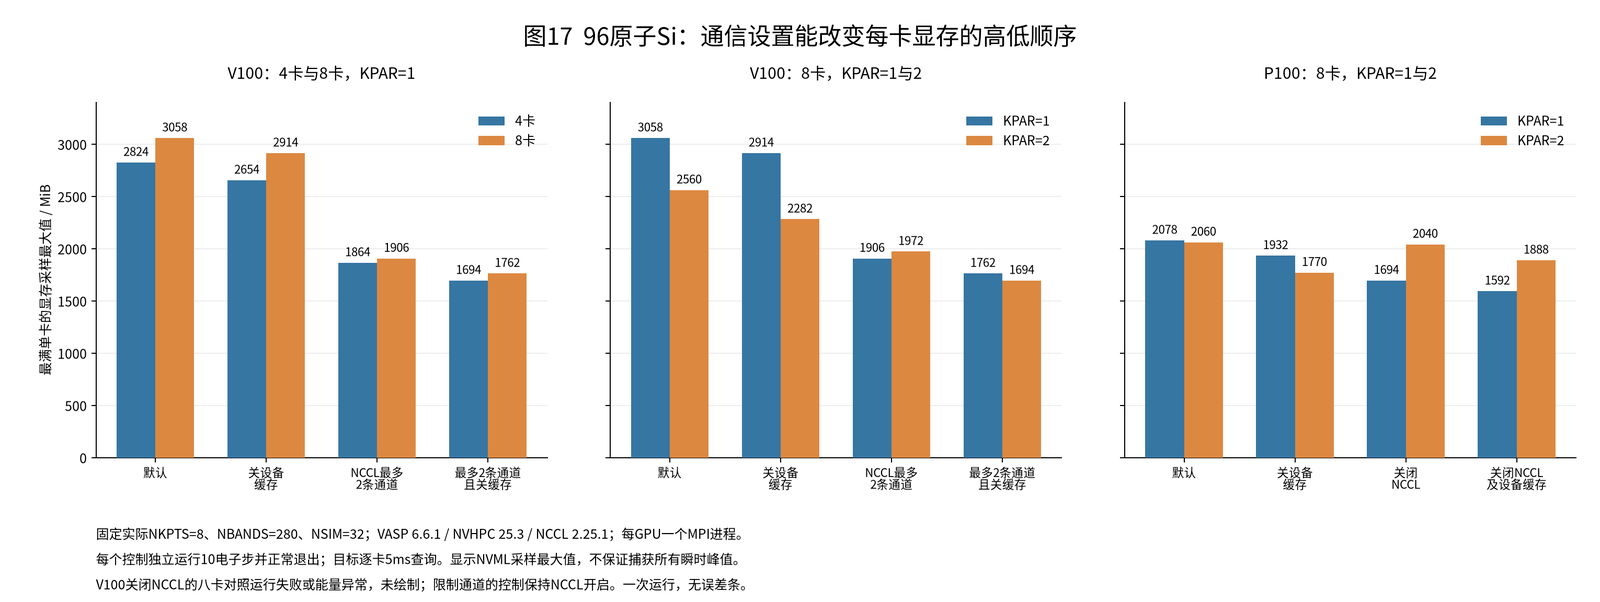
图M11:各柱取最满单卡的采样最大值。每项独立运行10电子步,图中控制均正常退出且能量、力通过同配置默认10步参考的诊断比较。
8. 用户怎样判断自己的算例是否装得下#
在本集群,可以先在自己的算例目录运行yskit,选择(3) VASP 显存估算;或直接执行:
yskit vasp-memory --gpu v100 --gpus 4
yskit vasp-memory --gpu p100 --gpus 8 --kpar 2 --nsim 32
工具只读INCAR/POSCAR/POTCAR/KPOINTS,不启动VASP、不修改输入;输出最满单卡估算、工程范围和建议每卡空闲量。它以本集群6.6.1普通非磁性DFT及默认通信/缓存设置为主;不同版本、材料和32G节点需要更宽范围,复杂方法或远超标定时可能不给数值。--kpar/--nsim仅用于估算对照,提交前仍需自行同步INCAR/Slurm。
确定物理精度后,先用小范围试算比较卡数、KPAR和NSIM,选择能正常完成且最满单卡仍有余量的候选。改变结构、元素/赝势、真空、空带、网格、截断、自旋或泛函后重新检查。容量不足时优先调整已验证的并行与批量设置,或选择容量更大的设备;NBANDS、ENCUT、真空和k网格仍由物理收敛要求决定。
合集
《VASP GPU 加速专题一:发展历程、GPU选型》
《VASP GPU 加速专题二:VASP 多版本与扩展功能支持》
《VASP GPU 加速专题三:性能实测》
《VASP GPU 加速专题四:计算准确性》
《VASP GPU 加速专题五:加速参数选择》
《VASP GPU 加速专题六:显存容量规划》