
LAMMPS GPU包与KOKKOS参数
MPI、OpenMP、邻居、Newton与PPPM的实测选择。
阅读本篇目录
选择资源时,先确认输入中的主要pair、fix和kspace是否有对应加速实现,再用同一输入做短试算。LAMMPS依靠空间分解、邻居表和MPI交换工作;VASP的KPAR、NCORE、NSIM不适用于这里。
CPU56核怎样搭配#
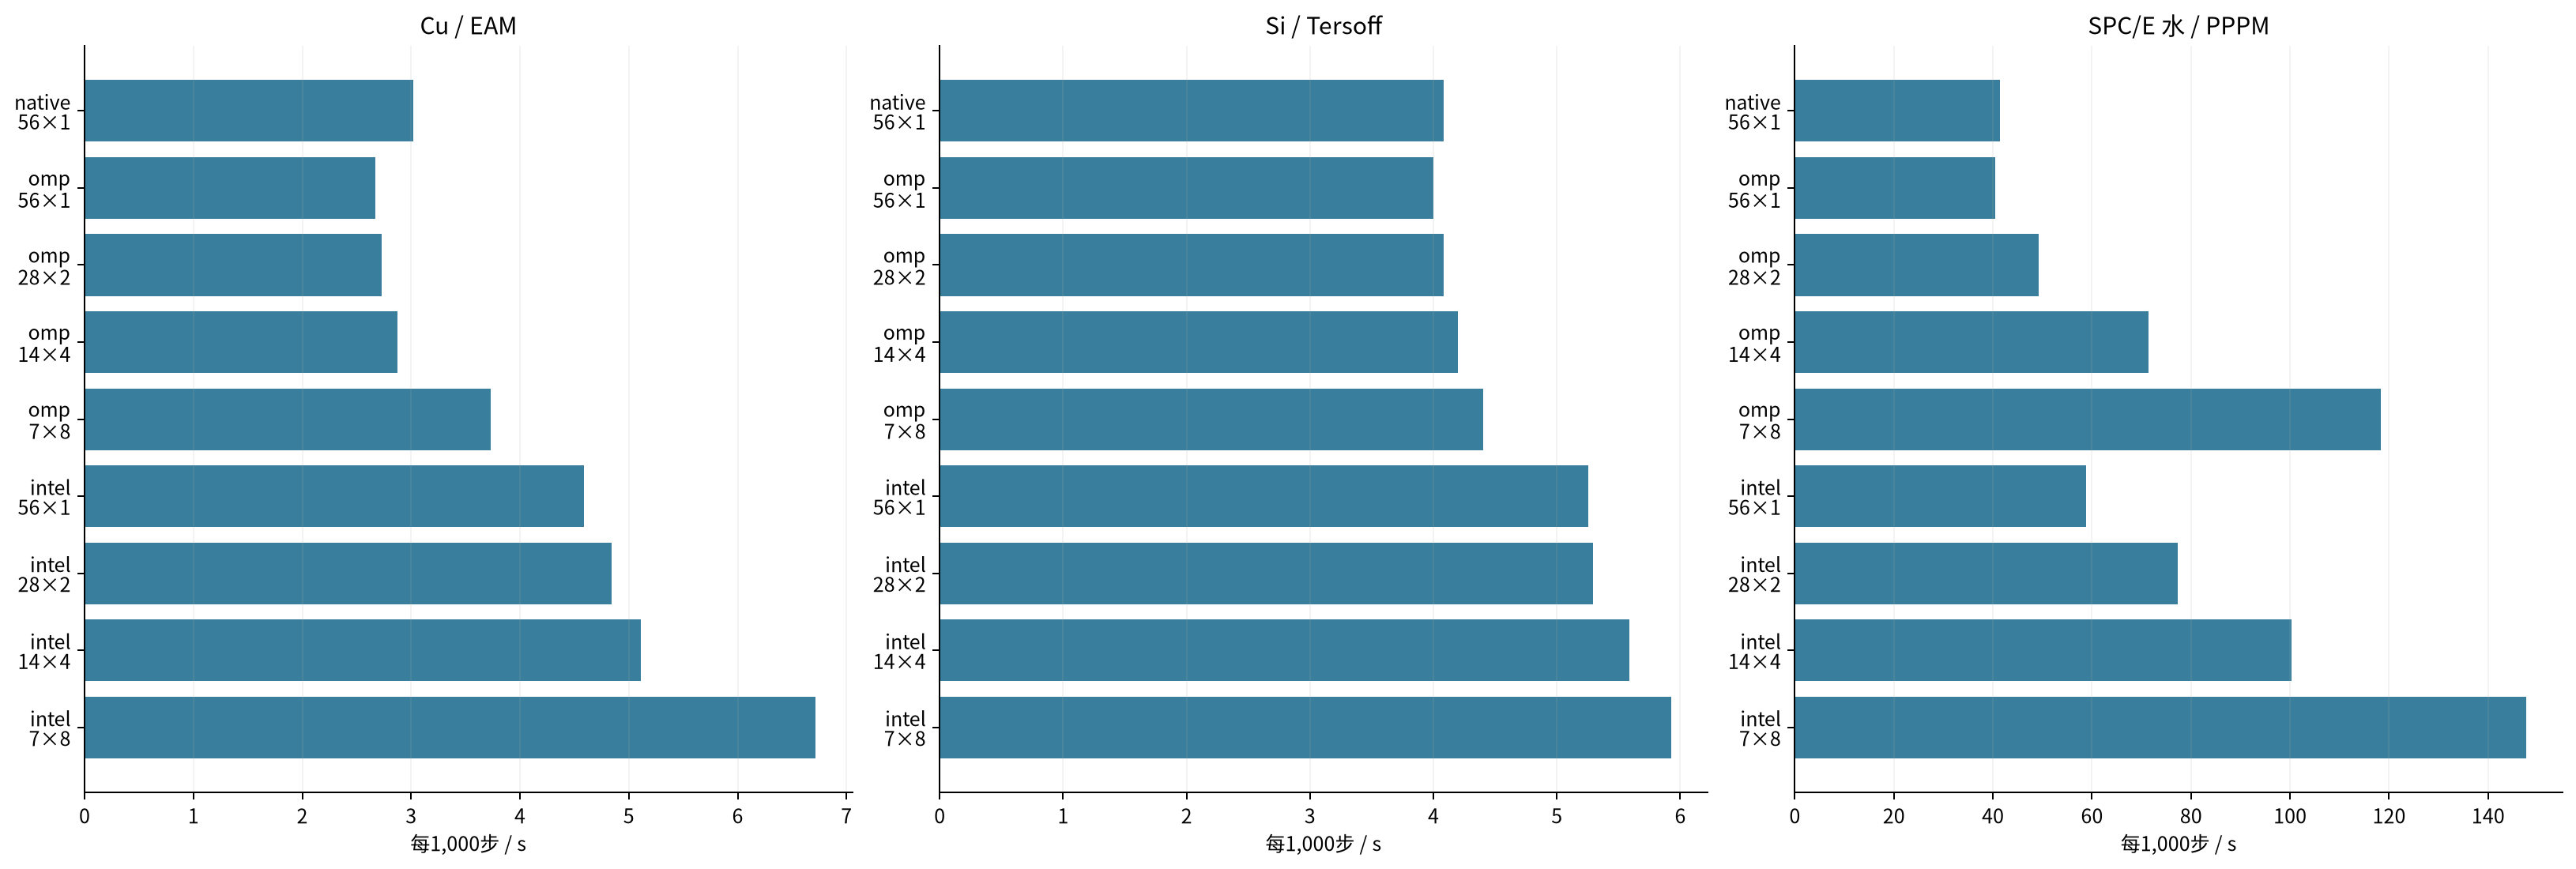
本集群8173m队列采用整节点计费,因此CPU配置始终满足MPI进程数×每进程OpenMP线程数=56。本次比较56×1、28×2、14×4、7×8,并试原生、OPENMP和INTEL实际支持的路径。INTEL明确指定mode double;改变线程数时也要启用相应加速style,不能只修改OMP_NUM_THREADS后就认定所有计算已经多线程。
CPU完整56核:MPI/OpenMP与实现路径
GPU包:每张卡可以共享多个MPI进程#
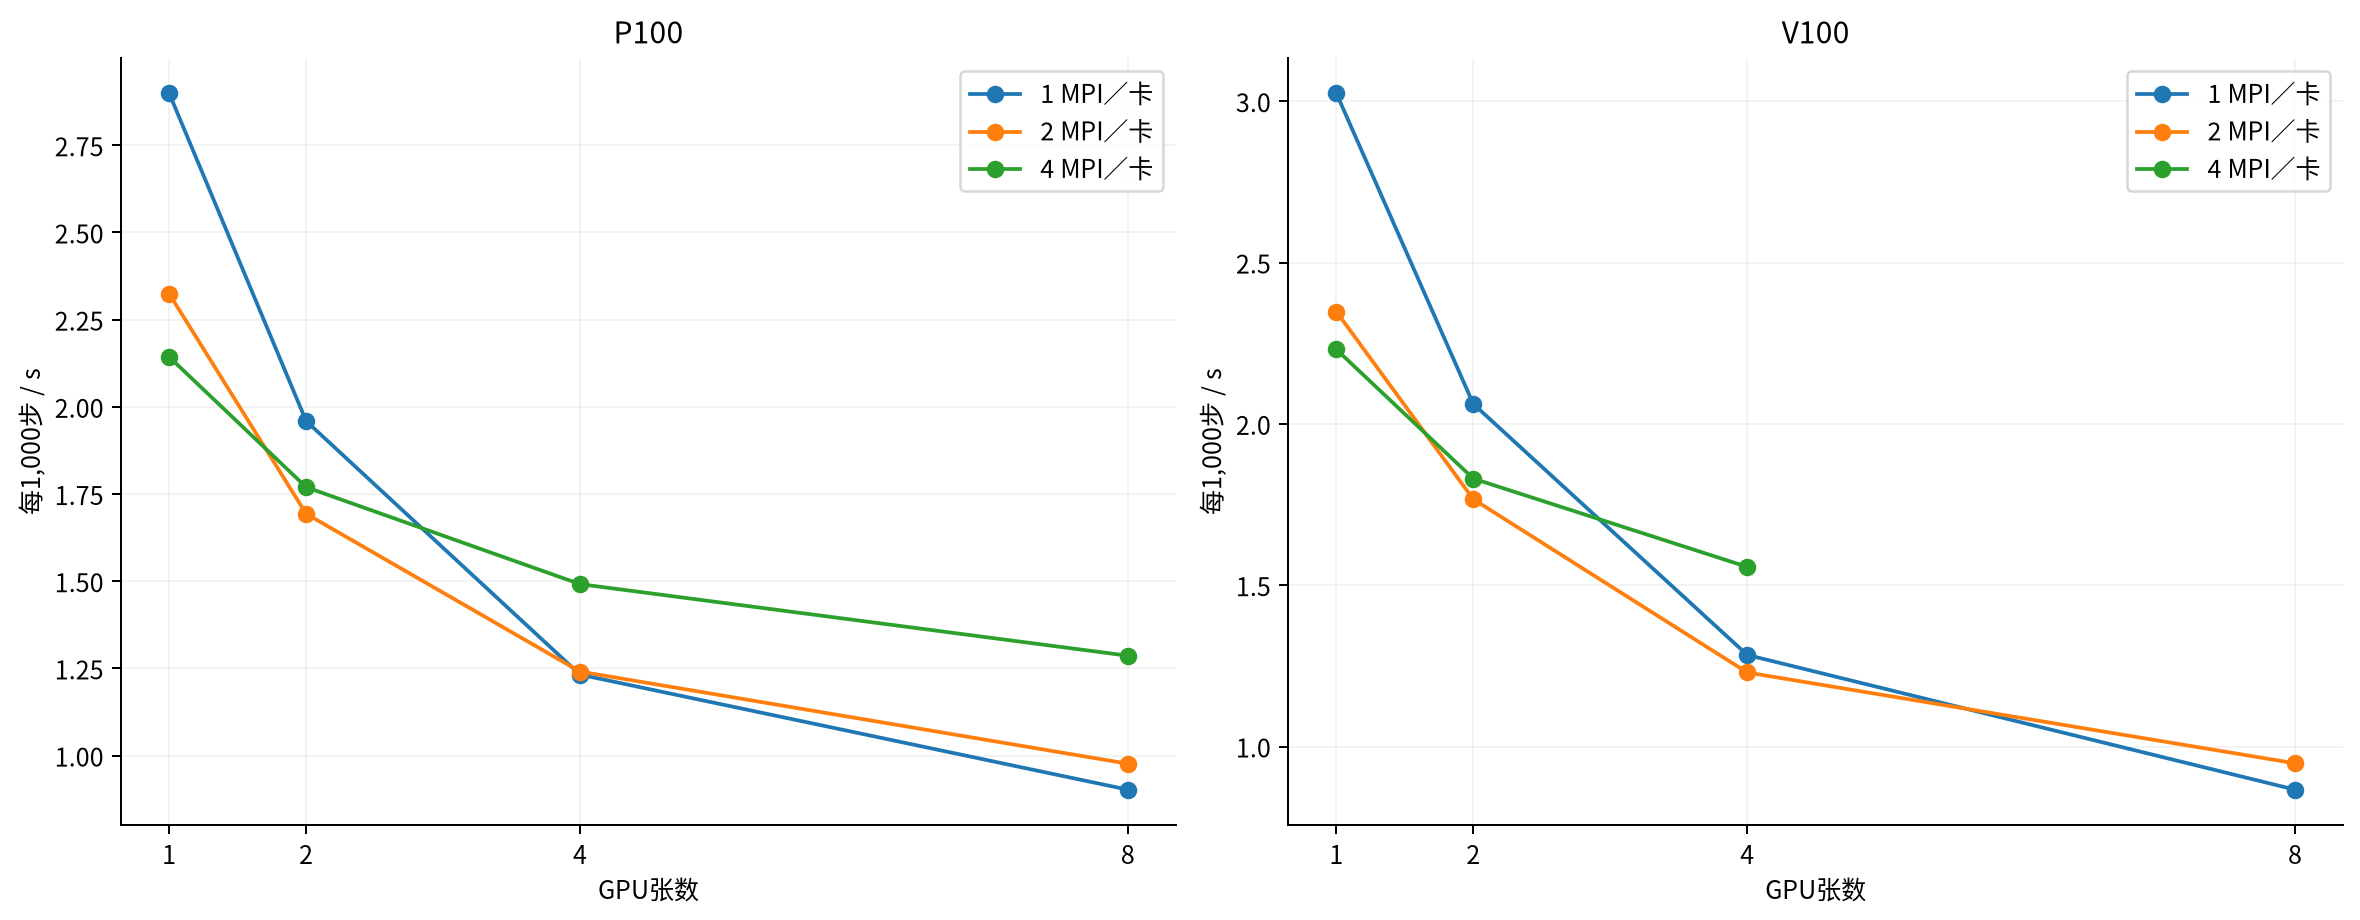
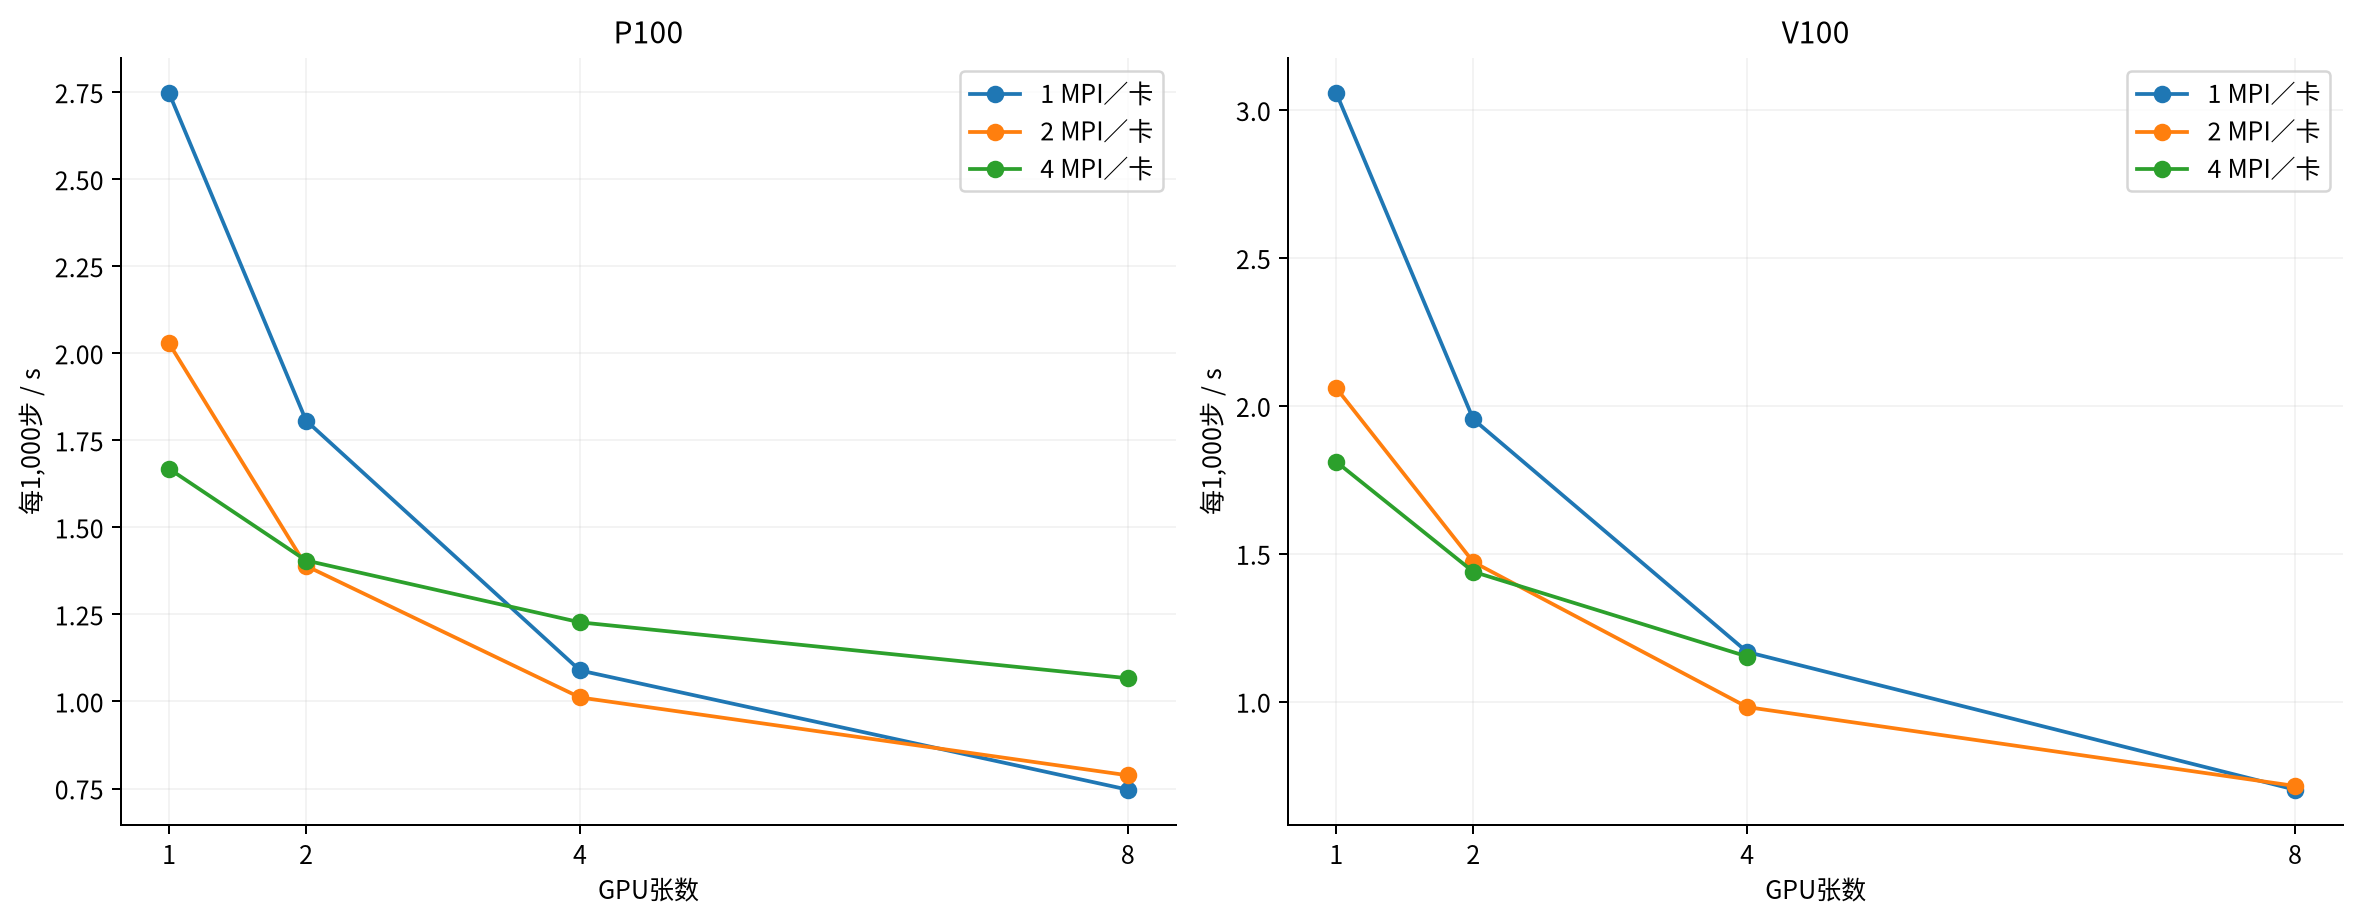
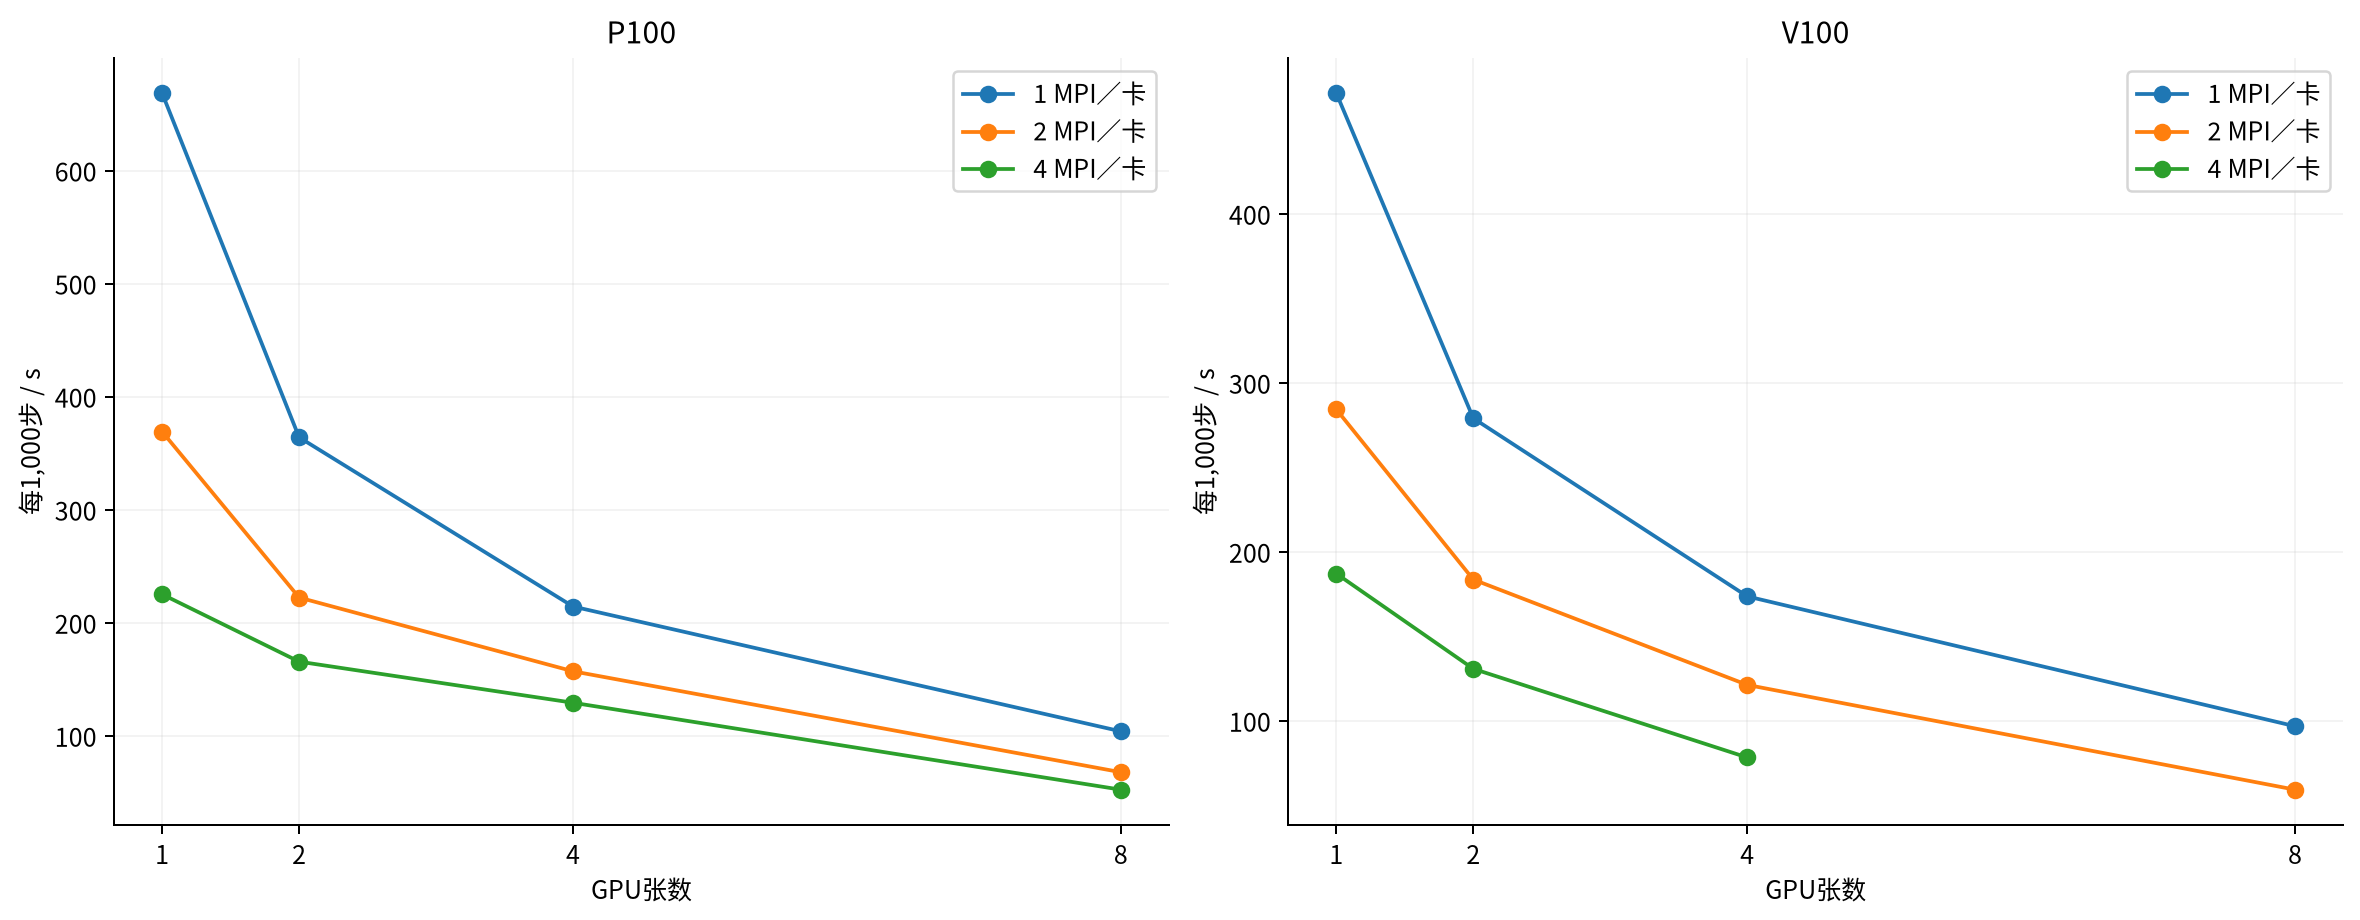
GPU包会把部分工作保留在CPU上,适合比较每卡1、2、4个MPI进程。更多进程可能改善CPU端计算和通信,也会增加GPU上下文、同步和显存开销。进程总数不得超过可用物理CPU核;本次V100八卡没有运行32个MPI进程挤占24核。
GPU包要求Newton pair关闭。CPU/GPU邻居表位置、GPU分工比例和长程静电布局都会影响速度;不同pair的实现范围不同。本次默认候选保留GPU承担pair力,水另测pair/only on,比较PPPM留在CPU上的分工。不能把所有计算都解释为GPU内核。
Cu / EAM:GPU包每卡MPI进程数比较
Si / Tersoff:GPU包每卡MPI进程数比较
SPC/E 水 / PPPM:GPU包每卡MPI进程数比较
KOKKOS:先采用一进程一卡#
本轮KOKKOS从每卡1个MPI进程开始,按style限制比较邻居表与Newton的合法组合。half/on是起点;full/off只在该style允许时使用。Tersoff在本次运行中明确要求Newton pair on,不把其他势的full/off直接套过来,失败候选保留并排除。输入包含没有KOKKOS版本的fix、compute或频繁输出时,可能增加CPU/GPU数据回传。
本集群通用GPU程序使用独立Open MPI5.0.10。编译支持CUDA与实际GPU-aware通信可用是两个层次,本轮用多卡算例验证,并保存运行环境。此路线不与VASP的NVHPC MPI或DeePMD的HPC-X环境混用。没有改动全局MPI、UCX或P2P设置。
本轮主矩阵采用的候选#
下面的候选从中等规模调参中选取,并用于跨规模对照。接近的单次时间不代表稳定胜负;生产任务建议在目标规模再比较邻近候选,尤其最小体系和最大体系。
| 模型 | 平台 | 实现 | 卡数 | MPI进程 | 每进程线程 | neighbor / Newton | PPPM分工 |
|---|---|---|---|---|---|---|---|
| Cu / EAM | CPU56核 | omp | 0 | 56 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | P100 | gpu | 1 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | P100 | gpu | 2 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | P100 | gpu | 4 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | P100 | gpu | 8 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | P100 | kokkos | 1 | 1 | 1 | full / off | 按实现默认 |
| Cu / EAM | P100 | kokkos | 2 | 2 | 1 | full / off | 按实现默认 |
| Cu / EAM | P100 | kokkos | 4 | 4 | 1 | full / off | 按实现默认 |
| Cu / EAM | P100 | kokkos | 8 | 8 | 1 | full / off | 按实现默认 |
| Cu / EAM | V100 | gpu | 1 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | V100 | gpu | 2 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | V100 | gpu | 4 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | V100 | gpu | 8 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Cu / EAM | V100 | kokkos | 1 | 1 | 1 | full / off | 按实现默认 |
| Cu / EAM | V100 | kokkos | 2 | 2 | 1 | full / off | 按实现默认 |
| Cu / EAM | V100 | kokkos | 4 | 4 | 1 | full / off | 按实现默认 |
| Cu / EAM | V100 | kokkos | 8 | 8 | 1 | full / off | 按实现默认 |
| Si / Tersoff | CPU56核 | omp | 0 | 56 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | P100 | gpu | 1 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | P100 | gpu | 2 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | P100 | gpu | 4 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | P100 | gpu | 8 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | P100 | kokkos | 1 | 1 | 1 | half / on | 按实现默认 |
| Si / Tersoff | P100 | kokkos | 2 | 2 | 1 | half / on | 按实现默认 |
| Si / Tersoff | P100 | kokkos | 4 | 4 | 1 | half / on | 按实现默认 |
| Si / Tersoff | P100 | kokkos | 8 | 8 | 1 | half / on | 按实现默认 |
| Si / Tersoff | V100 | gpu | 1 | 4 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | V100 | gpu | 2 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | V100 | gpu | 4 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | V100 | gpu | 8 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| Si / Tersoff | V100 | kokkos | 1 | 1 | 1 | half / on | 按实现默认 |
| Si / Tersoff | V100 | kokkos | 2 | 2 | 1 | half / on | 按实现默认 |
| Si / Tersoff | V100 | kokkos | 4 | 4 | 1 | half / on | 按实现默认 |
| Si / Tersoff | V100 | kokkos | 8 | 8 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | CPU56核 | omp | 0 | 56 | 1 | 默认 / 默认 | 按实现默认 |
| SPC/E 水 / PPPM | P100 | gpu | 1 | 4 | 1 | 默认 / 默认 | CPU |
| SPC/E 水 / PPPM | P100 | gpu | 2 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| SPC/E 水 / PPPM | P100 | gpu | 4 | 16 | 1 | 默认 / 默认 | CPU |
| SPC/E 水 / PPPM | P100 | gpu | 8 | 32 | 1 | 默认 / 默认 | 按实现默认 |
| SPC/E 水 / PPPM | P100 | kokkos | 1 | 1 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | P100 | kokkos | 2 | 2 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | P100 | kokkos | 4 | 4 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | P100 | kokkos | 8 | 8 | 1 | full / off | 按实现默认 |
| SPC/E 水 / PPPM | V100 | gpu | 1 | 4 | 1 | 默认 / 默认 | CPU |
| SPC/E 水 / PPPM | V100 | gpu | 2 | 8 | 1 | 默认 / 默认 | 按实现默认 |
| SPC/E 水 / PPPM | V100 | gpu | 4 | 16 | 1 | 默认 / 默认 | CPU |
| SPC/E 水 / PPPM | V100 | gpu | 8 | 16 | 1 | 默认 / 默认 | 按实现默认 |
| SPC/E 水 / PPPM | V100 | kokkos | 1 | 1 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | V100 | kokkos | 2 | 2 | 1 | half / on | 按实现默认 |
| SPC/E 水 / PPPM | V100 | kokkos | 4 | 4 | 1 | full / off | 按实现默认 |
| SPC/E 水 / PPPM | V100 | kokkos | 8 | 8 | 1 | full / off | 按实现默认 |
怎样理解本次调参差异#
- **Cu / EAM:**中等规模CPU最短有效候选为omp、56MPI×1线程,每1,000步2.671秒;此后跨规模沿用该布局。
- P100八卡GPU包:一进程一卡为0.902秒/1,000步,选定的8MPI×1线程为0.902秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
- V100八卡GPU包:一进程一卡为0.866秒/1,000步,选定的8MPI×1线程为0.866秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
- **Si / Tersoff:**中等规模CPU最短有效候选为omp、56MPI×1线程,每1,000步3.997秒;此后跨规模沿用该布局。
- P100八卡GPU包:一进程一卡为0.747秒/1,000步,选定的8MPI×1线程为0.747秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
- V100八卡GPU包:一进程一卡为0.703秒/1,000步,选定的8MPI×1线程为0.703秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
- **SPC/E 水 / PPPM:**中等规模CPU最短有效候选为omp、56MPI×1线程,每1,000步40.382秒;此后跨规模沿用该布局。
- P100八卡GPU包:一进程一卡为103.980秒/1,000步,选定的32MPI×1线程为52.386秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
- V100八卡GPU包:一进程一卡为96.760秒/1,000步,选定的16MPI×1线程为59.234秒。进程设置改变的是主机端并行度、分解与GPU共享开销,结果只适用于这次势和规模。
CPU标准56MPI与选定布局的同规模复核#
下面使用相同步数,列出额外的原生56MPI基准与主矩阵选定CPU布局。用于判断中等规模筛出的布局是否适合更小或更大体系;没有用较短的校准任务代替正式基准。
| 模型 | 原子数 | 原生56MPI / 秒每1,000步 | 选定布局 / 秒每1,000步 |
|---|---|---|---|
| Cu / EAM | 4,000 | 0.147 | 0.135 |
| Cu / EAM | 32,000 | 0.951 | 0.845 |
| Cu / EAM | 108,000 | 3.021 | 2.668 |
| Cu / EAM | 256,000 | 7.015 | 6.159 |
| Cu / EAM | 864,000 | 24.280 | 20.910 |
| Cu / EAM | 2,048,000 | 55.845 | 47.621 |
| Si / Tersoff | 4,096 | 0.190 | 0.187 |
| Si / Tersoff | 32,768 | 1.276 | 1.248 |
| Si / Tersoff | 110,592 | 4.156 | 4.010 |
| Si / Tersoff | 262,144 | 9.692 | 9.451 |
| Si / Tersoff | 884,736 | 35.291 | 38.234 |
| Si / Tersoff | 2,097,152 | 79.374 | 76.997 |
| SPC/E 水 / PPPM | 4,500 | 1.552 | 1.510 |
| SPC/E 水 / PPPM | 36,000 | 9.836 | 9.535 |
| SPC/E 水 / PPPM | 121,500 | 41.712 | 40.534 |
| SPC/E 水 / PPPM | 288,000 | 135.900 | 133.140 |
| SPC/E 水 / PPPM | 972,000 | 521.400 | 512.270 |
| SPC/E 水 / PPPM | 2,304,000 | 1303.070 | 1284.015 |
分配失败后的容量备选#
从已验证且预检占用较低的布局中重试一次,物理输入、精度和正式步数保持相同。原失败记录保留,结果以重试的实际检查为准。
| 模型/规模 | 平台/实现 | 卡数 | 重试MPI×线程 | neighbor / Newton | 状态 |
|---|---|---|---|---|---|
| SPC/E 水 / PPPM / 2,304,000 | P100 / gpu | 2 | 2×1 | 默认 / 默认 | 未通过 |
| SPC/E 水 / PPPM / 2,304,000 | V100 / gpu | 2 | 2×1 | 默认 / 默认 | 未通过 |
最大水盒的单卡邻居缓冲调整#
230.4万原子水盒的V100单卡KOKKOS预检在分配邻居表时失败。随后在两平台将skin由2Å改为0.5Å,保持势、9.8Å物理截断、PPPM精度、原子数和double精度,短容量检查通过后用于这两行正式任务。较小skin会增加邻居重建频率,因此性能和显存均应按实际设置阅读;不是降低势函数精度。20步预检的通过不替代正式运行的结果。
| 平台 | skin / Å | 容量短测采样最大值 / GiB | 正式对照结果 |
|---|---|---|---|
| P100 | 0.5 | 15.718 | 有效 |
| V100 | 0.5 | 15.919 | 有效 |
短测已接近16GiB容量上限,生产任务宜优先评估更多显卡或更大显存,并为后续邻居变化和额外分析保留余量。没有把V100的原失败推断为P100默认设置也已实测失败。
提交与短试算#
通过yskit复制匹配节点、版本、GPU包或KOKKOS的公共模板。先检查其module和启动参数,再选择MPI/线程。KOKKOS四卡常用4MPI;GPU包若改成每卡2MPI,则四卡需要8MPI。每进程线程数还需与--cpus-per-task匹配,任务总CPU不能超过节点物理核。Slurm负责分配可见GPU,不手动覆盖它给出的CUDA_VISIBLE_DEVICES。
现有通用GPU模板把GPU数量直接写成了SLURM_NTASKS,它适用于一进程一卡。改为多MPI共享GPU时,不能只改SBATCH资源行,还必须将启动命令中的GPU数量改为独立的SLURM_GPUS_ON_NODE。本文附带CPU56核、P100四卡八MPI、V100四卡四MPI三个独立示例,不会自动改动已有公共模板。四卡示例只演示资源对应关系,目标体系的最优参数仍需查表和短试算。
CPU若改为14MPI×4线程,SBATCH两项也要对应14和4,并设置OMP_NUM_THREADS=SLURM_CPUS_PER_TASK;使用OPENMP加速时增加-sf omp -pk omp 4,或按支持情况使用-sf intel -pk intel 0 mode double omp 4。仅修改线程环境变量不保证原生style实际使用所有线程。
当前公共KOKKOS模板原有gpu/aware off,本轮则单独验证了gpu/aware on。示例使用本轮已匹配的MPI与half/on起点,其他style或其他MPI需要重新核对,不能将该设置跨软件盲目套用。
GPU包启动形式:mpirun -np 8 lmp -sf gpu -pk gpu 4 -in in.lammps。KOKKOS形式:mpirun -np 4 lmp -k on g 4 -sf kk -in in.lammps。这是资源已经分配后的启动示例,具体neighbor/Newton设置以输入、style和实测为准;生产任务不要直接复制本次测试中的UUID或SSH节点管理操作。
比较参数时固定结构、力场、截断、长程误差、步长、系综及输出频率。预热后记录正式段Loop time,同时保存完整stdout和日志;GPU专用时间细分可能只出现在stdout。KOKKOS异步执行使普通分段计时不能直接当作精确GPU内核占比,性能主表未启用CUDA_LAUNCH_BLOCKING。
完整调参CSV · 性能与核时。原理参考:GPU包、KOKKOS、INTEL。命令按本次2025版本核对,在线手册后续新增功能不自动适用于旧程序。