
VASP GPU 加速专题一:发展历程、GPU选型
理解FP64、显存、多卡互联和算力选择。
阅读本篇目录
1. VASP 的 GPU 加速是怎样发展起来的#
VASP 的 GPU 加速经历了从关键计算移植到统一代码实现的过程。早期工作主要关注最耗时的矩阵运算、傅里叶变换和精确交换。2011 年提交、2012 年发表的研究已经把 GPU 用于 VASP 的精确交换计算,并以硼结构为例研究其性能。这代表了早期探索,不能将当时的加速倍数直接套用到今天的硬件和算例。
VASP 5.x 的 GPU 版本采用 CUDA-C 移植部分热点计算。它展示了 GPU 的潜力,同时也带来维护 Fortran 主程序和专门 GPU 代码的成本。2020 年,VASP 6.1 的 OpenACC 移植扩展了 GPU 覆盖,通过 Fortran 加速指令和 NVIDIA 数值库,让 CPU 与 GPU 实现更便于共同维护。
VASP 6.2 正式推荐 NVIDIA OpenACC 端口,6.3 移除了旧 CUDA-C 端口。到 6.6,NVIDIA 路线仍采用 OpenACC,同时出现面向 AMD、Intel 数据中心 GPU 的实验性 OpenMP offload 端口。本集群本次测试使用 VASP 6.6.1 的 NVIDIA OpenACC 构建。
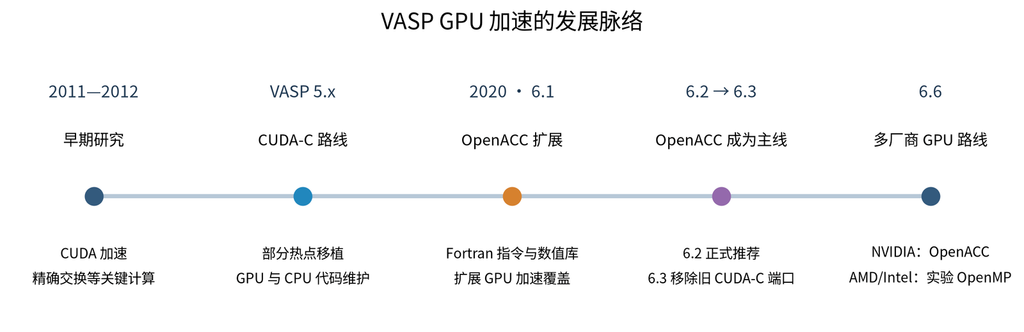
图1:路线演进示意,图中的版本节点表示实现变化。
2. 显卡参数、多卡互联与集群性价比#
选择 VASP 计算资源,需要了解的是这张卡的双精度能力是否足够,单卡显存能否装下任务,多张卡之间怎样连接,以及完成同一项计算需要多少时间和费用。
对鸢算科技 HPC 集群用户,实际可选的 GPU 包括 P100 PCIe 16GB、V100 SXM2 16GB、V100 SXM2 32GB。它们具备面向科学计算的双精度能力,配套的软件已经按平台分别构建。本文同时给出 A30、A100、H100、H200 等型号的参考参数,方便理解不同硬件的适用方向。
3. 先确定选型顺序#
建议按以下顺序选择资源:先满足计算方法和软件兼容性,再检查显存容量,然后比较双精度性能、显存带宽和多卡互联,最后用自己的算例比较完成时间与费用。
| 优先考虑的问题 | 需要确认的内容 | 对选择的影响 |
|---|---|---|
| 程序与功能是否匹配 | VASP 版本、GPU 端口、所需扩展、编译目标 | 程序和科学功能适用,才有后续性能比较的意义 |
| 单卡能否容纳任务 | 最满一张卡的显存、后续阶段峰值、必要余量 | 总显存相同的多卡与大显存单卡不能简单互换 |
| 双精度计算是否够强 | 普通 FP64、必要时核对 FP64 Tensor Core | GPU 核心数量和 AI TOPS 不能代替 FP64 指标 |
| 数据读写是否够快 | 显存带宽、实际频率 | 算力相同的卡也可能因带宽不同而表现不同 |
| 多卡通信是否合适 | PCIe、NVLink、NVSwitch、NUMA、网络 | 同样八张卡,实际通信条件可能差别很大 |
| 是否值得使用这些资源 | 同输入耗时、卡数、完整作业费用 | 最短时间与最低费用可能对应不同配置 |
VASP 官方将 P100、V100、A30、A100、H100,以及 Quadro GP100、GV100 列入 NVIDIA OpenACC 端口的已测试硬件,并强调较强的 FP64 能力。官方清单中的“已测试”也不等于其中所有卡在所有输入上都有统一性能排名。
4. 显卡参数应该怎样读#
| 参数 | 含义 | 对 VASP 的实际意义 |
|---|---|---|
| 普通 FP64,单位 TFLOPS | 双精度浮点运算的理论峰值 | 判断科学计算能力的重要起点;不是程序实测速度 |
| FP64 Tensor Core | 特定双精度矩阵运算路径的峰值 | 需要程序、数学库和矩阵形状适用;不能当作全部 VASP 的吞吐量 |
| FP32、TF32、FP16、FP8、FP4 | 其他精度或矩阵运算指标 | 适用于相应算法;不能用 AI 的低精度峰值换算标准 VASP 的速度 |
| 显存容量 | GPU 本地内存容量 | 决定能否容纳波函数、FFT 网格、工作数组、通信缓存等 |
| HBM / GDDR | 显存技术类型 | 结合实际带宽判断;名称本身不构成速度保证 |
| 显存带宽,单位 GB/s | GPU 对本地显存的数据访问能力 | 与 GPU 间通信带宽是不同指标 |
| NVLink 带宽 | GPU 间高速互联能力 | 必须看具体连接对象、链路数量及带宽口径 |
| PCIe 代数与通道数 | GPU 与主机及其他设备的连接条件 | Gen4 x8 与 Gen4 x16 不相同,也不同于 NVLink |
| ECC | 显存纠错能力 | 是长时间科学计算的一项可靠性配置,不等同于数值精度保证 |
| TDP / 功耗上限 | 板卡设计或运行功率限制 | 影响持续频率及性能;不等于实际耗电 |
| Compute Capability,CC | CUDA 指令与硬件能力版本 | 主要用于软件支持和编译目标匹配,不能按数字大小给 VASP 排名 |
例如,A100 的普通 FP64 为 9.7 TFLOPS,FP64 Tensor Core 为 19.5 TFLOPS;H100 SXM 分别为 34 和 67 TFLOPS。比较时需要使用同一列、同一种计量范围。
5. NVIDIA 主要计算卡的参数对照#
5.1 P100、V100、A30、A100、H100、H200#
下表均为单张 GPU 的厂商标称规格,不是 VASP 跑分。显存容量使用厂商 GB 标注;实际程序可使用的容量需要查询。NVLink 列为每张 GPU 全部相关链路的标称双向汇总带宽,不是任意两张卡之间都能达到的带宽。— 表示未提供该类 FP64 Tensor Core 指标;V100 本身有用于其他精度的 Tensor Core。
| 型号与形态 | 显存 | 普通 FP64 / TFLOPS | 显存带宽 / GB/s | NVLink 双向汇总 / GB/s | 标称功耗 / W |
|---|---|---|---|---|---|
| P100 PCIe 16GB | 16GB HBM2 | 4.7 | 732 | 无 | 250 |
| P100 SXM2 16GB | 16GB HBM2 | 5.3 | 732 | 160 | 300 |
| V100 PCIe 16GB | 16GB HBM2 | 7.0 | 900 | 无 | 250 |
| V100 PCIe 32GB | 32GB HBM2 | 7.0 | 900 | 无 | 250 |
| V100 SXM2 16GB | 16GB HBM2 | 7.8 | 900 | 300 | 300 |
| V100 SXM2 32GB | 32GB HBM2 | 7.8 | 900 | 300 | 300 |
| A30 PCIe 24GB | 24GB HBM2 | 5.2 | 933 | 200 | 165 |
| A100 PCIe 40GB | 40GB HBM2 | 9.7 | 1,555 | 600 | 250 |
| A100 PCIe 80GB | 80GB HBM2e | 9.7 | 1,935 | 600 | 300 |
| A100 SXM4 40GB | 40GB HBM2 | 9.7 | 1,555 | 600 | 400 |
| A100 SXM4 80GB | 80GB HBM2e | 9.7 | 2,039 | 600 | 400 |
| H100 SXM 80GB | 80GB HBM3 | 34 | 3,350 | 900 | 最高 700 |
| H100 NVL 94GB | 94GB HBM3 | 30 | 3,900 | 600 | 350–400 |
| H200 SXM 141GB | 141GB HBM3e | 34 | 4,800 | 900 | 最高 700 |
| H200 NVL 141GB | 141GB HBM3e | 30 | 4,800 | 900 | 最高 600 |
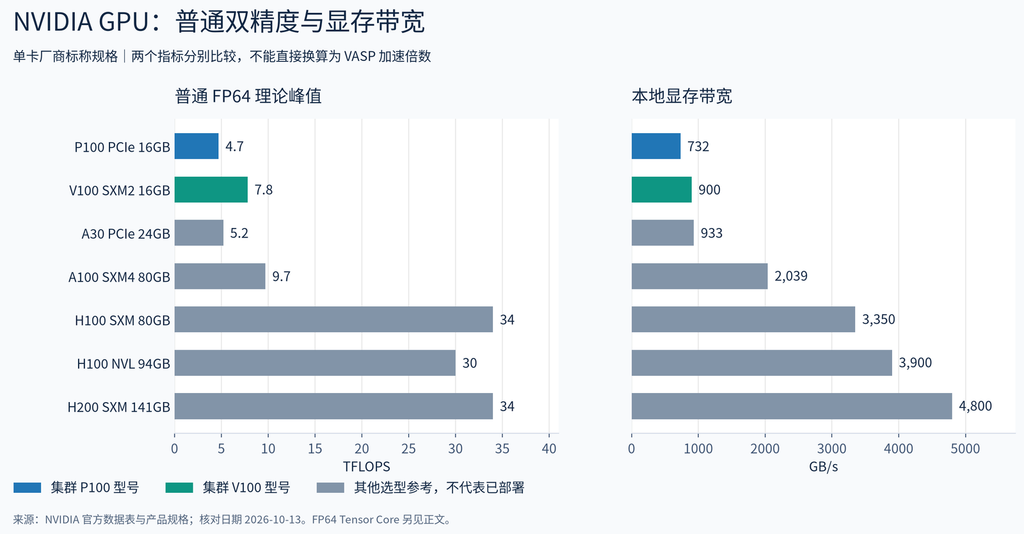
图1:单卡厂商规格,展示的是两个不同的硬件指标,不是 VASP 加速倍数;省略了同系列的部分配置。
同系列也需要分清形态。集群的 P100 是 PCIe 版本,不能把 SXM2 的 NVLink 参数套到它身上;集群的 V100 是 SXM2,不能按 V100 PCIe 的互联条件理解它。A100 PCIe 可通过桥连接两张 GPU,而 SXM4 平台的互联由服务器底板和相应平台提供。
5.2 RTX 和部分数据中心卡为什么不一定优先#
GeForce、RTX 工作站和部分面向推理/图形的数据中心卡适合各自的工作负载。用于 VASP 时,仍需回到 FP64 和实际运行结果。
| 代表型号 | 容量或定位特点 | VASP 选型时的判断 |
|---|---|---|
| GeForce RTX 3090 | 24GB;GA102 架构 | GA102 普通 FP64 吞吐率为 FP32 的 1/64,不能按其单精度能力判断 VASP |
| GeForce RTX 4090 | 24GB;AD102 架构 | AD102 普通 FP64 吞吐率为 FP32 的 1/64;优先用自己的任务验证 |
| GeForce RTX 5090 | 32GB GDDR7、较高显存带宽 | AI TOPS、游戏和渲染性能不能证明其适合双精度 VASP |
| NVIDIA L40S | 48GB ECC 显存,侧重 AI、图形与媒体 | 大显存与数据中心定位不等于强 FP64;官方规格不支持 NVLink |
| Quadro GP100 / GV100 | 官方 VASP 已测试的较早工作站计算卡 | 是需要按具体硬件判断的例子,不能把所有工作站卡归为同一类 |
如果手上已经有某张 RTX,可以在适配的软件环境中测试是否可运行、是否装得下,以及实际完成时间;本文不把“非优先选择”写成“任何任务都不能运行”。新采购或租用时,建议优先比较经过 VASP 验证的强 FP64 计算卡。
6. 显存容量怎样影响选型#
VASP 的内存需求涉及波函数和多种网格工作数组。官方内存说明给出波函数容量与 k 点、能带、平面波数组大小的关系;实际 GPU 占用还包含设备工作区、库和通信缓存,不能把单个公式当作完整显存预测。
| 任务特征或参数 | 可能改变的主要部分 | 选型时应怎样考虑 |
|---|---|---|
| 原子数、元素和 POTCAR | 默认电子数、能带和投影相关数组 | 相同原子数的 Si 与含半芯态赝势的过渡金属体系可能很不同 |
NBANDS |
波函数和带相关工作区 | 高空带数量任务需要单独评估,不能只看占据电子数 |
| 晶胞体积与形状、真空层 | 平面波及 FFT 网格 | 同原子数下,较大真空可能增加容量;以实际晶胞和网格为准 |
ENCUT、FFT 网格、PREC |
平面波和实空间工作数组 | 保持所需科学精度,再判断显存需求 |
| 实际 k 点、对称性 | k 点工作量及相应数据 | 不能用完整网格乘积代替实际 NKPTS |
| 自旋、SOC、非共线设置 | 自旋通道、旋量及相应数组 | 不直接套用非磁性标准版估算 |
| 杂化泛函及响应任务 | 交换、响应和相关暂存 | 先核对版本中哪些阶段实际使用 GPU,再测全流程峰值 |
KPAR |
分组和每组数据分布 | 改变每卡占用;更多 k 点组不保证更省显存 |
NSIM |
同时处理能带的工作批量 | 较大批量可能增加暂存,容量边界需要复测 |
| 投影、偶极及后处理输出 | 额外工作区或输出阶段 | 关注完整流程;不只采样最初几个电子步 |
这些影响因素已经结合本集群显存实验整理,详见《VASP GPU 加速专题六:显存容量规划》。用户可以先使用 yskit 的 VASP 显存估算功能筛选资源,再检查真实运行。当前估算模型的整组规模留出误差 p90 约为 18.8%,不能把预测值当成实际峰值上限。
两张 16GB 卡不等于一张 32GB 卡。 VASP 中部分数据分布到进程,部分数据仍会复制;不同阶段的分布也不同。NVLink 提高通信能力,不会自动把多张卡变成一个可任意使用的巨大显存池。决定能否运行时,应看最满单卡,而不是把容量简单相加。
7. 多卡连接方式:它们分别解决什么问题#
7.1 常见连接形态#
| 连接方式 | 通信路径与典型形态 | 适用价值 |
|---|---|---|
| PCIe,同一交换机附近 | GPU 经 PCIe 交换结构通信 | 普通 PCIe 服务器可提供多卡条件 |
| PCIe,跨 CPU / NUMA | 路径涉及多个根复合体或 CPU 互联 | 可连接同节点不同区域的 GPU |
| NVLink 桥 | 对应 GPU 之间的直连桥 | 改善特定两卡或多卡组合的通信 |
| SXM 平台的 NVLink 网络 | GPU 按底板规定的图互连 | 为同节点多卡提供较强连接 |
| NVLink + NVSwitch | 通过交换结构连接较多 GPU | 改善更大规模的互联一致性和通信能力 |
| 跨节点网络与 GPUDirect RDMA | GPU、网络适配器、网络、远端 GPU | 支持跨服务器的数据传输 |
NVLink 是 GPU 间的连接技术,NVSwitch 是构建更大互联网络的交换设备;两者不能用同一个词替代。当前新平台还有跨服务器的 NVLink 域,但不能把这种能力追认到早期单节点 V100。
同一台服务器里的 PCIe 路径也可能差别很大。对于 GPU–网卡的 GPUDirect RDMA,NVIDIA 文档明确区分仅经 PCIe 交换机、经 CPU/IOH、以及跨 CPU 互联的路径;实际效果与平台有关。
7.2 带宽的单位和计量范围#
| 标称信息 | 应怎样理解 |
|---|---|
| PCIe Gen3 x16 约 32GB/s 双向 | 每个方向约 16GB/s 的接口理论量级,不是可同时承诺的程序带宽 |
| PCIe Gen4 x16 约 64GB/s 双向 | 每个方向约 32GB/s;x8 的相应理论量级约减半 |
| PCIe Gen5 x16 约 128GB/s 双向 | 每个方向约 64GB/s,实际还受设备和路径影响 |
| V100 SXM2 NVLink 300GB/s | 每张 GPU 所有相关链路的双向汇总,并非任意一对 GPU 的带宽 |
| 200Gb/s 网络端口 | 除以 8 是约 25GB/s 的理论数据率,协议和通信开销尚未扣除 |
| 400Gb/s 网络端口 | 同理约 50GB/s;不能把 Gb/s 直接当作 GB/s |
7.3 P2P、CUDA-aware MPI、NCCL 与 RDMA 不相同#
| 名称 | 主要作用 |
|---|---|
| GPU P2P | GPU 之间访问或传输设备数据 |
| CUDA-aware MPI | MPI 能识别和处理 GPU 设备缓冲区 |
| NCCL | 针对 GPU 的集合通信库 |
| GPUDirect RDMA | 网络等设备直接与 GPU 显存进行适用的数据传输 |
多卡能力由硬件与软件共同决定。拓扑显示、设备缓冲通信检查、NCCL 的实际通道和 VASP 数值对照分别提供不同证据。
8. 鸢算科技 HPC 集群显卡的具体优势#
8.1 强 FP64、HBM 与两档 V100 容量、V100 NVLink连接#
| 集群 GPU | 代表节点 | 节点 GPU 数 | 每卡显存 | 普通 FP64 | 显存带宽 | 多卡连接 |
|---|---|---|---|---|---|---|
| P100 PCIe | gcn001-8p100 | 8 | 16GB | 4.7 TFLOPS | 732GB/s | PCIe |
| V100 SXM2 | gcn001-8v100-16g | 8 | 16GB | 7.8 TFLOPS | 900GB/s | NVLink |
| V100 SXM2 | gcn001-8v100-32g | 8 | 32GB | 7.8 TFLOPS | 900GB/s | NVLink |
P100 的优势是以较低的资源费用提供科学计算需要的双精度能力。V100 SXM2 在普通 FP64 和显存带宽上更强,NVLink 还为多卡工作流提供额外通信条件。V100 32GB 则在保留相同规格双精度能力的同时,提供更大的单卡容量,方便容量敏感的任务。
32GB 型号的价值首先是“装得下更多数据”,不应直接宣传为相同输入必然比 16GB 快两倍。本集群已有性能测试主要来自 16GB 节点,本文不把它们当成 32GB 节点的实测。
8.2 鸢算科技 HPC 集群的价格与费用优势#
核时价格换算为实际资源小时#
当前核时单价为 0.025–0.035 元/核时,具体单价以账户适用规则为准。P100 16GB 每张卡每小时折算 24 核时,V100 16GB 每张卡每小时折算 32 核时;GPU 配套 CPU 不额外收费。8173m 按整节点 56 核计费。运行时间按秒累计,没有最低扣费。
| 提供商 | 资源 | FP64算力 | 按当前单价换算的费用 |
|---|---|---|---|
| 鸢算科技HPC集群 | P100 16GB 单卡 | 4.7 | 0.600 元/卡时 |
| 鸢算科技HPC集群 | V100 16GB 单卡 | 7.8 | 0.800 元/卡时 |
| 鸢算科技HPC集群 | 8173m CPU 整节点 | - | 1.400 元/节点时 |
| 鸢算科技HPC集群 | V100 32GB 包月单卡 | 7.8 | 650 元/张/月,折合0.90 元/卡时 |
| A****l | V100-PCIE-32GB | 7.0 | 2.08 元/卡时 |
| A****l | A100-PCIE-40GB | 9.7 | 3.45 元/卡时 |
| 并*云 | V100-PCIE-32GB | 7.0 | 5 元/卡时 |
| S*I | V100-PCIE-16GB | 7.0 | 1.4元/卡时 |
对用户而言,鸢算科技HPC集群的费用优势体现在四个方面:远低于其他竞品价格;核时单价清晰,GPU 配套 CPU 不额外收费;短任务按秒累计,便于小规模试算和参数优化;持续使用者可以选择 650 元/月的 V100 32GB 包月方案。配合已经验证的软件环境,用户可以把预算集中用于实际计算,并用同输入的完成时间和核时决定资源配置。
8.3 资源、程序与辅助工具一起降低使用成本#
鸢算科技 HPC 集群已经提供五个 VASP 6.x GPU 发布版本:6.3.2、6.4.2、6.4.3、6.5.1、6.6.1。普通版、VTST、optcell、Wannier90、VASPsol、HDF5 六类构建分别覆盖 P100/V100,共 60 套 GPU 构建、180 个 std/gam/ncl 程序。
公共模块为用户准备匹配的运行环境;yskit 可复制提交脚本、估算 VASP 显存并辅助生成适用的 DP-GEN 配置。网页门户帮助查看资源、作业和账户信息,AI智能体 Codex 可辅助检查输入、脚本及整理结果。这些工具减少重复配置工作,与显卡算力一起构成集群的使用价值。
| 用户需求 | 本集群内可优先比较的资源 | 决策依据 |
|---|---|---|
| 预算优先,16GB 容量够用 | P100 单卡与 V100 16GB 单卡 | 比较完整任务时间与实际核时 |
| 希望缩短中大规模任务时间 | V100 16GB 双卡、四卡,再评估八卡 | 同时看 KPAR/NSIM、拓扑与并行效率 |
| 单卡容量接近 16GB 边界 | V100 32GB | 先解决容量问题,不假设增加小显存卡必然解决 |
| 持续运行且需要 32GB | V100 32GB 包月 | 结合每月实际使用小时评估 650 元月费 |
| 小体系或 GPU 不占优势 | 8173m CPU 整节点 | 用相同输入比较;CPU 仍可更合适 |
| 自行采购 NVIDIA 卡 | A100/H100/H200 等强 FP64 候选 | 在预算内比较容量、形态、互联、软件和实际任务 |
9. GPU 加速能为用户带来什么#
用户关心的不只是“程序能不能使用显卡”,还包括某个算例能缩短多少时间、需要几张显卡,以及这些显卡是否用得有效。已有测试表明,这些问题不能只根据原子数回答;不可约 k 点、能带数、并行划分和参数都会影响结果。
在本次 Si 测试中,8 原子体系使用 CPU56 核只需 18.992 秒。单卡 P100 和 V100 分别需要 96.730、80.320 秒;增加至八卡后分别为 18.675、15.898 秒。对于这样的小工作量,即使使用多卡,GPU 相对 CPU 的优势也很有限,接近的单次结果还应考虑波动。
216 原子体系的情况不同:CPU56 核为 481.058 秒,八卡 P100 为 140.318 秒,八卡 V100 为 90.478 秒,相对 CPU 分别达到 3.43 倍、5.32 倍加速。单卡 V100 为 354.889 秒,已快于该 CPU 基准;单卡 P100 为 486.089 秒,两者接近。
这里的数字描述的是这套固定输入下、已测参数中的最快结果,不构成“达到某个原子数就一定适合 GPU”的通用界线。实际使用时,还需结合精度要求、k 网格和空带数量选择资源。
合集
《VASP GPU 加速专题一:发展历程、GPU选型》
《VASP GPU 加速专题二:VASP 多版本与扩展功能支持》
《VASP GPU 加速专题三:性能实测》
《VASP GPU 加速专题四:计算准确性》
《VASP GPU 加速专题五:加速参数选择》
《VASP GPU 加速专题六:显存容量规划》