
LAMMPS性能与核时
Cu、Si和SPC/E水的CPU/GPU完成时间与参考核时。
阅读本篇目录
本指南比较鸢算科技 HPC 集群的8173m CPU56核、P100 16GB和V100 16GB。分别测试金属Cu/EAM、共价Si/Tersoff及带长程静电与约束的SPC/E水,覆盖六档规模及GPU单、双、四、八卡。GPU包为mixed,KOKKOS为double;两条路线分别展示。
如何读这些结果#
每个资源组运行相同的结构、势、物理时间步和正式计时步数。不同规模的步数由预先校准确定,因此图中统一换算为“每1,000步秒数”;同一小图内越短越快。核时则由该次完整运行的实际秒数折算,包含初始化、固体200步/水50步预热和正式计算。两者用途不同。
CPU始终使用完整56核。主表的MPI/线程及GPU布局来自中等规模的有效调参候选,之后保持该布局跨规模比较;它们是经过验证的实用候选,不是每个体系、每个规模的全局最优。每格一次有效测量,小差异应视为近优。静态能量和力通过后才参与排名。
若出现内存分配失败,只尝试一次已经验证且预检占用较低的容量备选,保持物理输入、数值精度和正式步数,并保留原始失败。实际布局和重试来源在参数表与CSV中标明,数值错误不靠更换布局静默掩盖。失败行不参加速度、显存或最低核时推荐。
不同势的计算工作量不同,不能用Cu的ns/day替代水或Si的性能。小体系的通信与启动占比通常更大,大体系还会受到显存和邻居表影响;最终选择以同一模型、同一规模下的时间和费用为准。
公共初态通过NVT 500步生成,温控目标300K,并从同一份高精度坐标/速度文件出发。它是统一基准的有限温度状态,没有把0.5ps固体或1ps水的准备过程认定为热力学充分平衡;实际温度和后续波动在原始记录与准确性章节给出。正式性能段为固定体积NVE,Cu/Si步长1fs、水2fs,水保留SHAKE。各平台使用相同势、截断、邻居更新策略和长程设置。
性能数据是否已经调到最优#
本指南展示“中等规模调参后选定配置”的跨规模实测,没有为每个原子规模重新穷举最优参数。 “已测配置中最快”指本轮有效结果中的最快项,不表示相同硬件能够达到的性能上限。此前仅简述了选择方法,下面直接列出图表实际采用的进程、线程和GPU布局。
调参覆盖了什么#
| 项目 | 本轮实际检查范围 | 选定后怎样使用 |
|---|---|---|
| 调参体系规模 | Cu108,000原子、Si110,592原子、水121,500原子 | 各模型在一个中等规模上筛选,再沿用到六档规模 |
| CPU实现与进程/线程 | 原生56MPI×1线程;OPENMP和INTEL分别比较56×1、28×2、14×4、7×8 | 每组总56CPU;三模型最后均选OPENMP、56MPI×1线程 |
| GPU包的MPI布局 | 比较每卡1、2、4MPI的合法候选,受节点CPU核数限制 | 按模型、平台及卡数分别选择,见下表 |
| GPU包的多线程 | Si和水另比较单卡1MPI×2/4线程 | 属于补充检查,没有把每种MPI/线程组合都全量扫描 |
| KOKKOS | 每卡1MPI,比较具体style允许的neighbor/Newton组合 | 非法或数值未通过的候选排除 |
| 水的计算分工 | 比较GPU包默认分工与pair/only on |
使用不同卡数下选出的分工,见下表 |
调参共165次尝试、156次有效,按每1,000步耗时比较,选出51组配置。不同调参候选的步数可能不同,选择时没有直接比较原始Loop time。进入正式矩阵后,同一模型、同一规模的各资源配置使用相同正式步数;调整步数用于计时校准,不代表该规模又完成了一轮并行参数优化。
本轮每格一次有效测量,接近的时间可能包含波动。除了进程、线程、实现和上述参数,没有对所有绑核、NUMA、输出频率及算法参数进行完整搜索。因此,读者可以把表中配置作为有实测依据的起点,不能将它称为“各规模都已调至最优”。
每个MPI进程实际使用多少CPU核心#
主性能图中所有有效配置均为每MPI进程1个CPU线程,并为该进程指定1个CPU核心。 所以本轮用于计算的CPU核心总数等于MPI进程总数;GPU包每张卡可以对应多个MPI进程。
| 模型 | CPU参考实现 | MPI进程数 | 每进程线程/CPU核数 | CPU总核数 |
|---|---|---|---|---|
| Cu / EAM | OPENMP,double | 56 | 1 | 56 |
| Si / Tersoff | OPENMP,double | 56 | 1 | 56 |
| SPC/E水 / PPPM | OPENMP,double | 56 | 1 | 56 |
这里的OPENMP是所选style实现名称;线程数为1,因此CPU图中的56核并行主要来自56个MPI进程,不是“1个MPI调用56线程”。OPENMP实现以1线程运行仍可以与原生实现有性能差异。
本轮设置OMP_NUM_THREADS=1、MKL_NUM_THREADS=1、OPENBLAS_NUM_THREADS=1,并按任务记录固定CPU亲和性。CPU图采用-sf omp -pk omp 1;只使用不带加速后缀的原生56MPI程序,不完全等同于图中的参考配置。资源已分配且模块匹配时,CPU的启动形式为:
mpirun -np 56 lmp -sf omp -pk omp 1 -in in.lammps
GPU包:主图采用的MPI总数#
下表数字为MPI进程总数,同时也是实际使用的CPU核心总数;所有单元格的每进程线程数均为1。例如“V100、Cu、4卡=8”表示4张GPU、8MPI、8CPU核,即每卡2MPI。
| 模型 | 平台 | 1卡:MPI/CPU核数 | 2卡:MPI/CPU核数 | 4卡:MPI/CPU核数 | 8卡:MPI/CPU核数 |
|---|---|---|---|---|---|
| Cu / EAM | P100 | 4 | 4 | 4 | 8 |
| Cu / EAM | V100 | 4 | 4 | 8 | 8 |
| Si / Tersoff | P100 | 4 | 4 | 8 | 8 |
| Si / Tersoff | V100 | 4 | 8 | 8 | 8 |
| SPC/E水 / PPPM | P100 | 4 | 8 | 16 | 32 |
| SPC/E水 / PPPM | V100 | 4 | 8 | 16 | 16 |
GPU包采用mixed精度、neigh yes、split 1.0、omp 1和pair Newton off。水的1卡、4卡配置在两平台均选用pair/only on,即pair走GPU加速而PPPM保留CPU路径;2卡、8卡使用本轮GPU包默认分工。Cu、Si没有启用pair/only on。
例如上表的V100四卡Cu配置,启动时MPI数是8,GPU数是4:
mpirun -np 8 lmp -sf gpu -pk gpu 4 neigh yes split 1.0 omp 1 -in in.lammps
不能把这条命令中的GPU数改成MPI数8。若用Slurm复现,该例应申请8MPI×1CPU和4GPU;通用公共模板默认是一进程一卡,需要同时核对资源行和命令中的GPU数量,详见参数指南与独立示例。
KOKKOS:主图采用的进程和邻居设置#
两平台、三个模型的KOKKOS均采用double精度,1、2、4、8卡分别对应1、2、4、8MPI,每MPI1线程/1CPU核。下表进一步列出实际neighbor / Newton组合。
| 模型 | 平台 | 1卡 | 2卡 | 4卡 | 8卡 |
|---|---|---|---|---|---|
| Cu / EAM | P100 | full / off | full / off | full / off | full / off |
| Cu / EAM | V100 | full / off | full / off | full / off | full / off |
| Si / Tersoff | P100 | half / on | half / on | half / on | half / on |
| Si / Tersoff | V100 | half / on | half / on | half / on | half / on |
| SPC/E水 / PPPM | P100 | half / on | half / on | half / on | full / off |
| SPC/E水 / PPPM | V100 | half / on | half / on | full / off | full / off |
本轮KOKKOS使用已匹配并验收的MPI路径,设置gpu/aware on。现有通用公共模板仍保留gpu/aware off,因此直接复制默认模板的运行条件与本轮实测不完全相同。这里说明实际测试配置;切换通信方式应使用匹配MPI和相应示例,不应只为复现一个开关而混用其他软件的MPI环境。
各规模是否完全沿用上述配置#
正常主矩阵沿用以上进程、线程、分工和邻居设置;以下容量处理需要单列:
- **230.4万原子水、两平台单卡KOKKOS:**为通过邻居表容量检查,skin从2Å改为0.5Å,仍为1MPI×1线程、double,物理截断、PPPM精度和正式步数不变。更频繁的邻居重建也会改变耗时,不能将这两行当成默认skin2Å的性能。
- **同一最大水盒、两平台双卡GPU包:**原8MPI布局分配失败,各用2MPI×1线程作一次容量备选也失败。这4次尝试保留在CSV中,不参加图表和最低核时选择。
此外,18组同规模原生56MPI CPU复核也已保存,但主性能图保持上述选定OPENMP配置,没有按每个点重新挑选不同实现拼接性能曲线。例如884,736原子Si,原生56MPI为35.291秒/1,000步,主图所用OPENMP56MPI为38.234秒/1,000步。这一实测例子说明,中等规模选出的配置不保证在其他规模仍是最快配置。完整同规模CPU对照见参数专题。
上述表格说明的是实际计算资源,而GPU核时按卡数折算收费。比如V100四卡、8MPI×1线程实际使用8个CPU核,参考计费核心数仍是4×32=128,配套CPU不另收费,两个数字不能混为同一概念。
逐次运行配置CSV列出全部308次正式尝试的模型、规模、卡数、MPI、每进程CPU数、CPU总核数、每卡MPI、neighbor/Newton、skin、调参来源、容量来源和有效状态,可按原子数定位任一图中的数据点。它与完整性能CSV采用相同任务ID;本次只补充配置说明,没有新增模拟或改变原始时间。
各类体系的时间与核时#
本轮安排306个资源组,取得304组有效结果;共保留308次正式尝试,其中4次未通过。失败配置不参与后续选择,备选重试与原失败分别保留。
Cu / EAM#
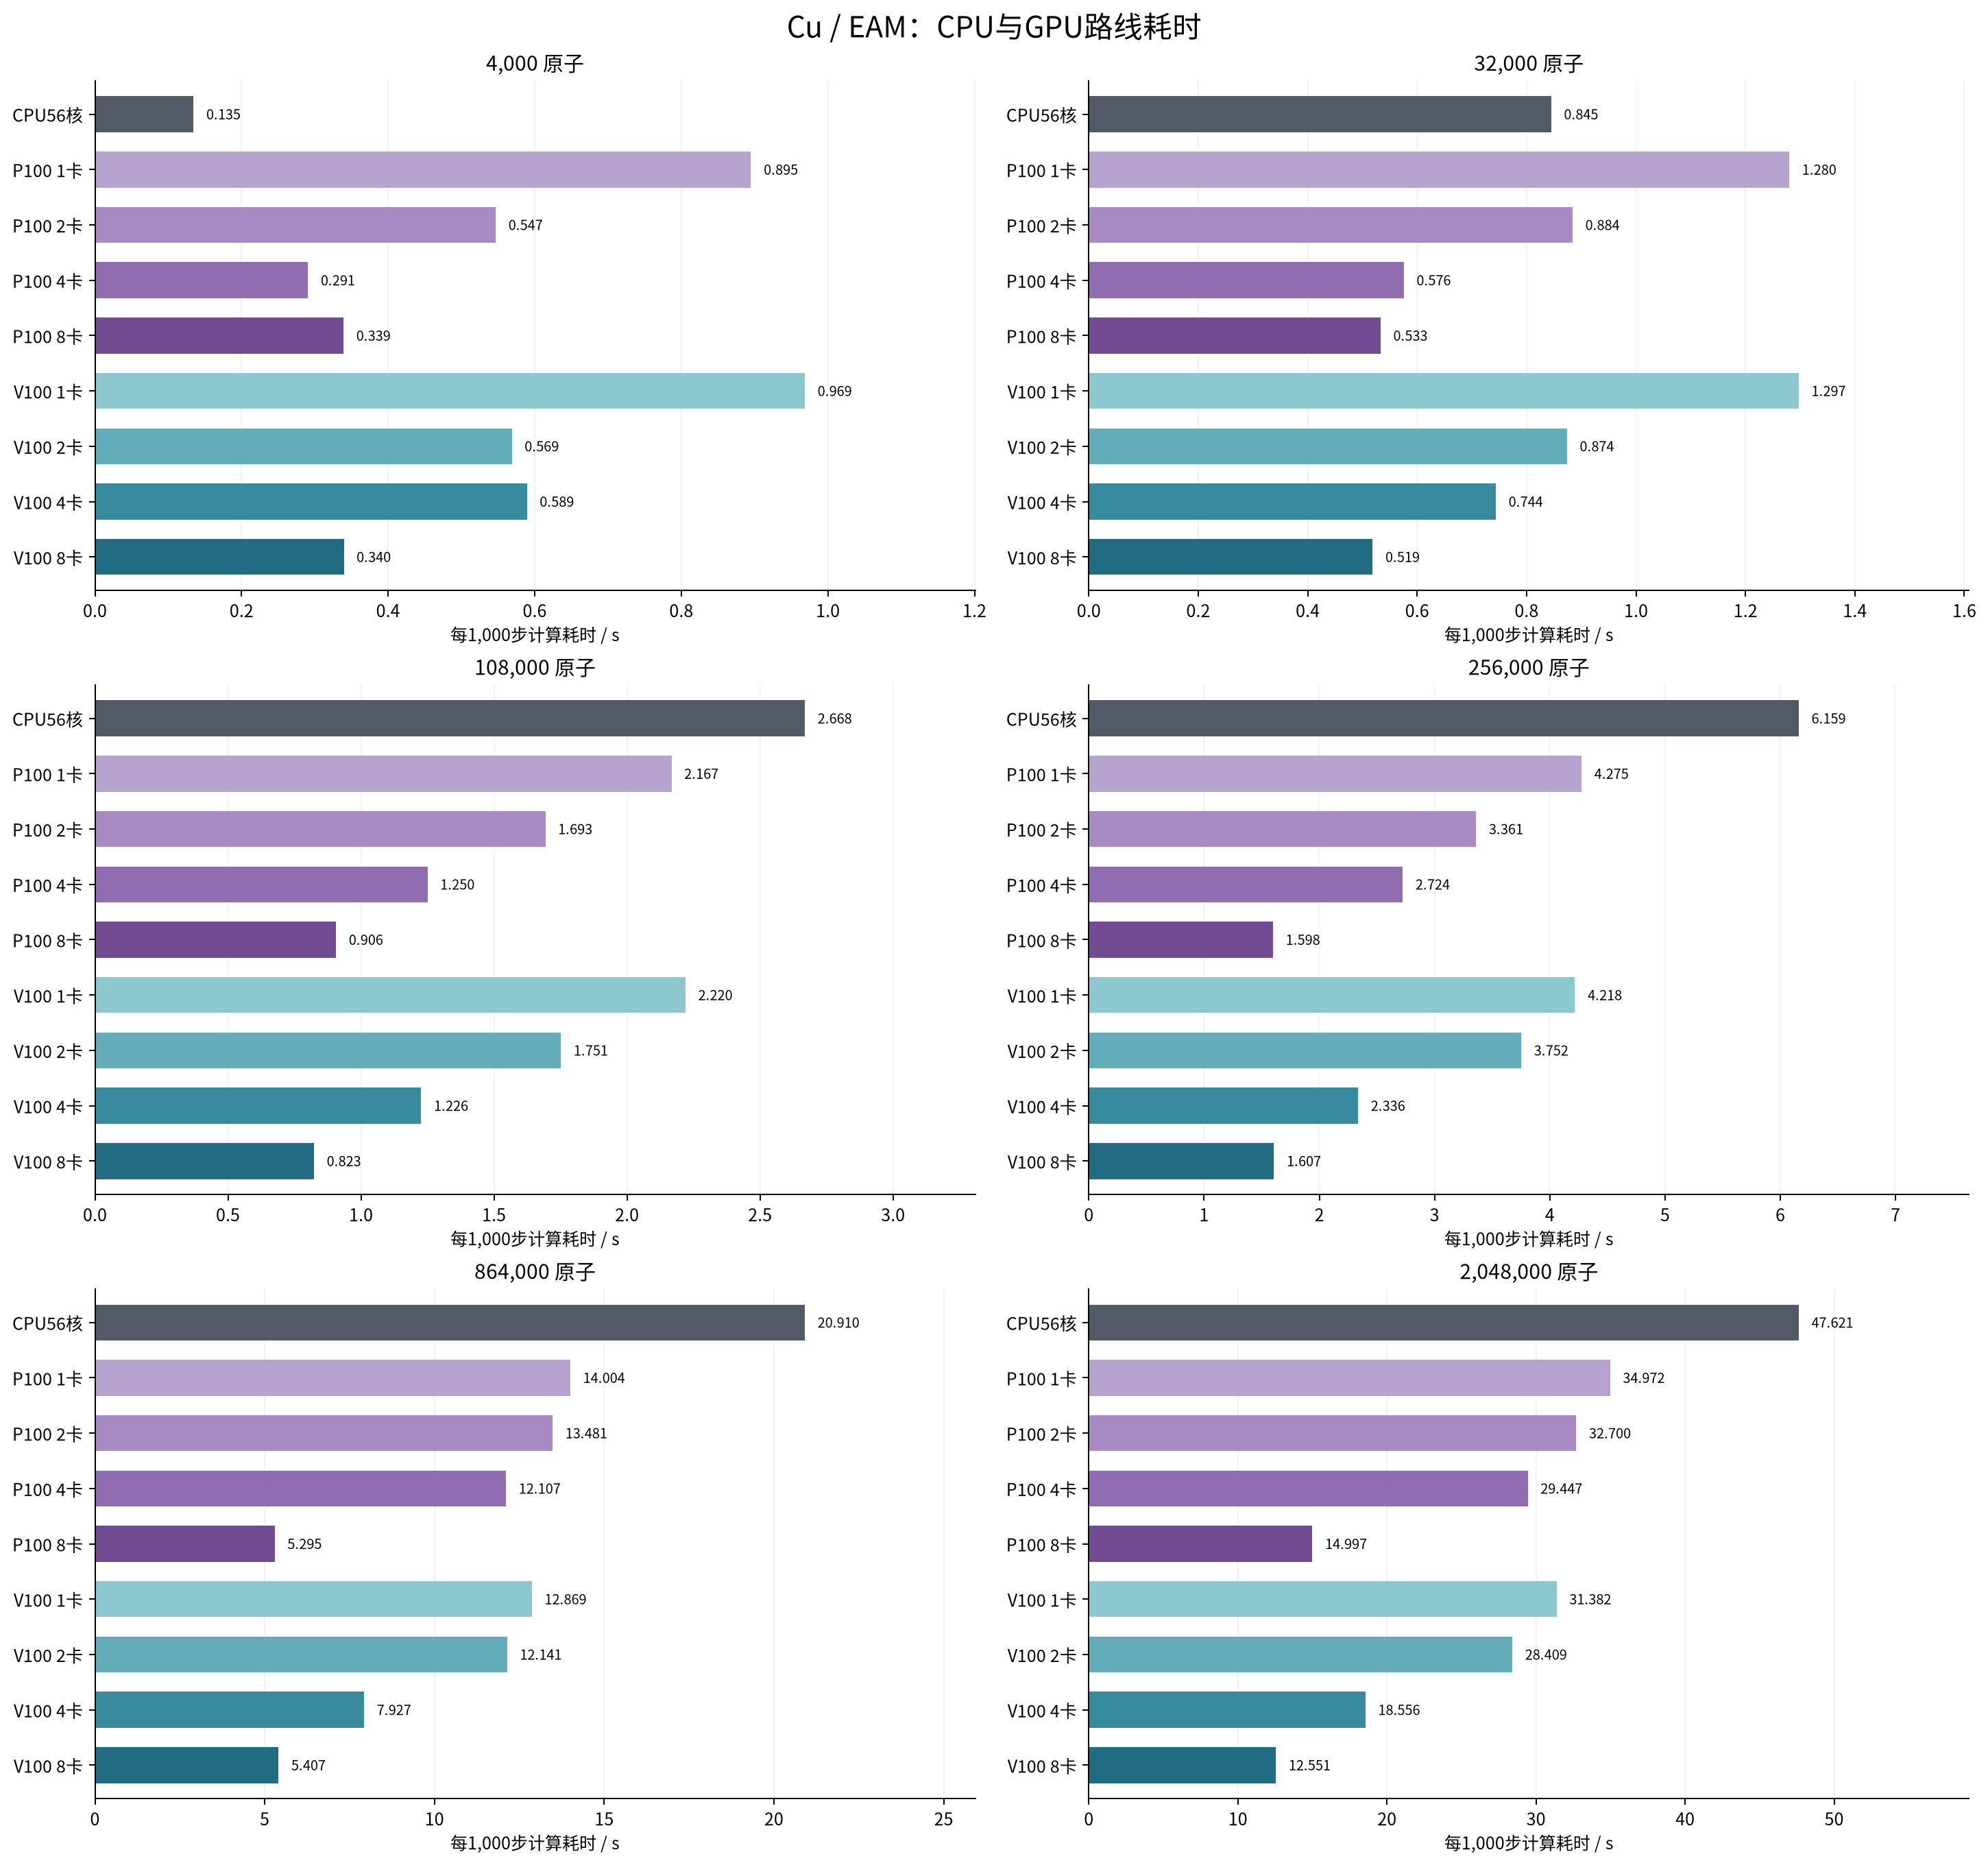
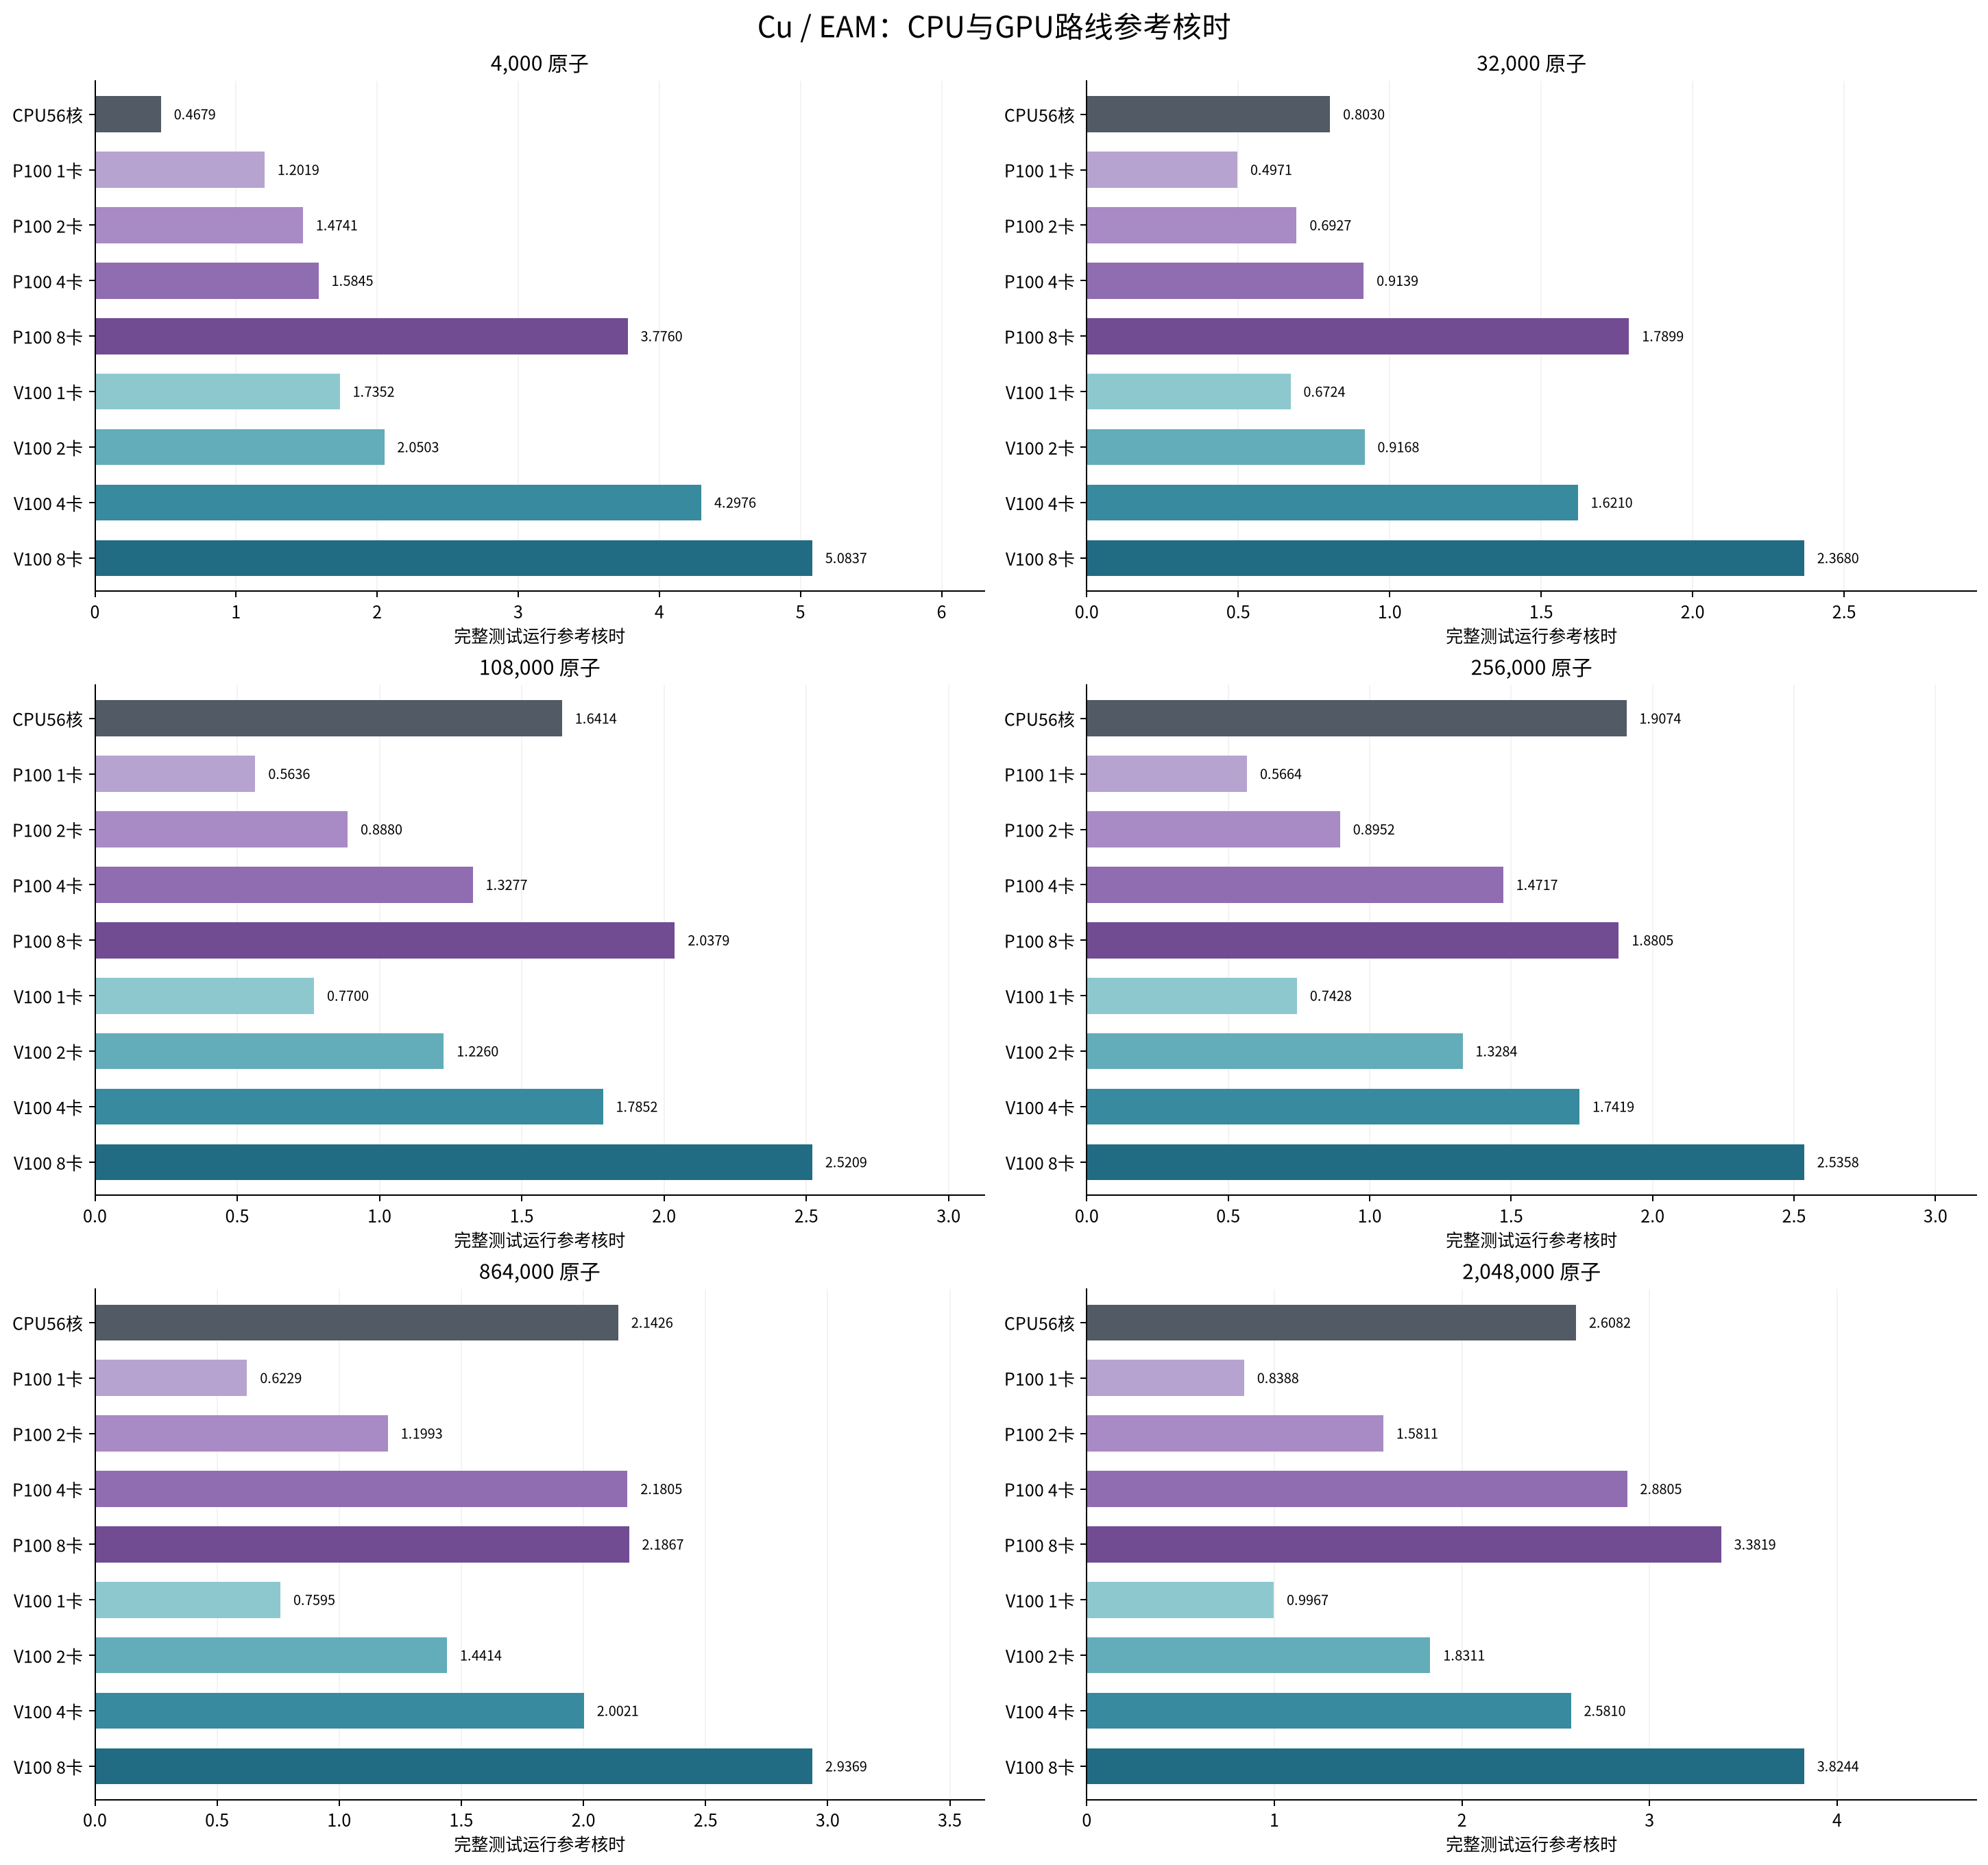
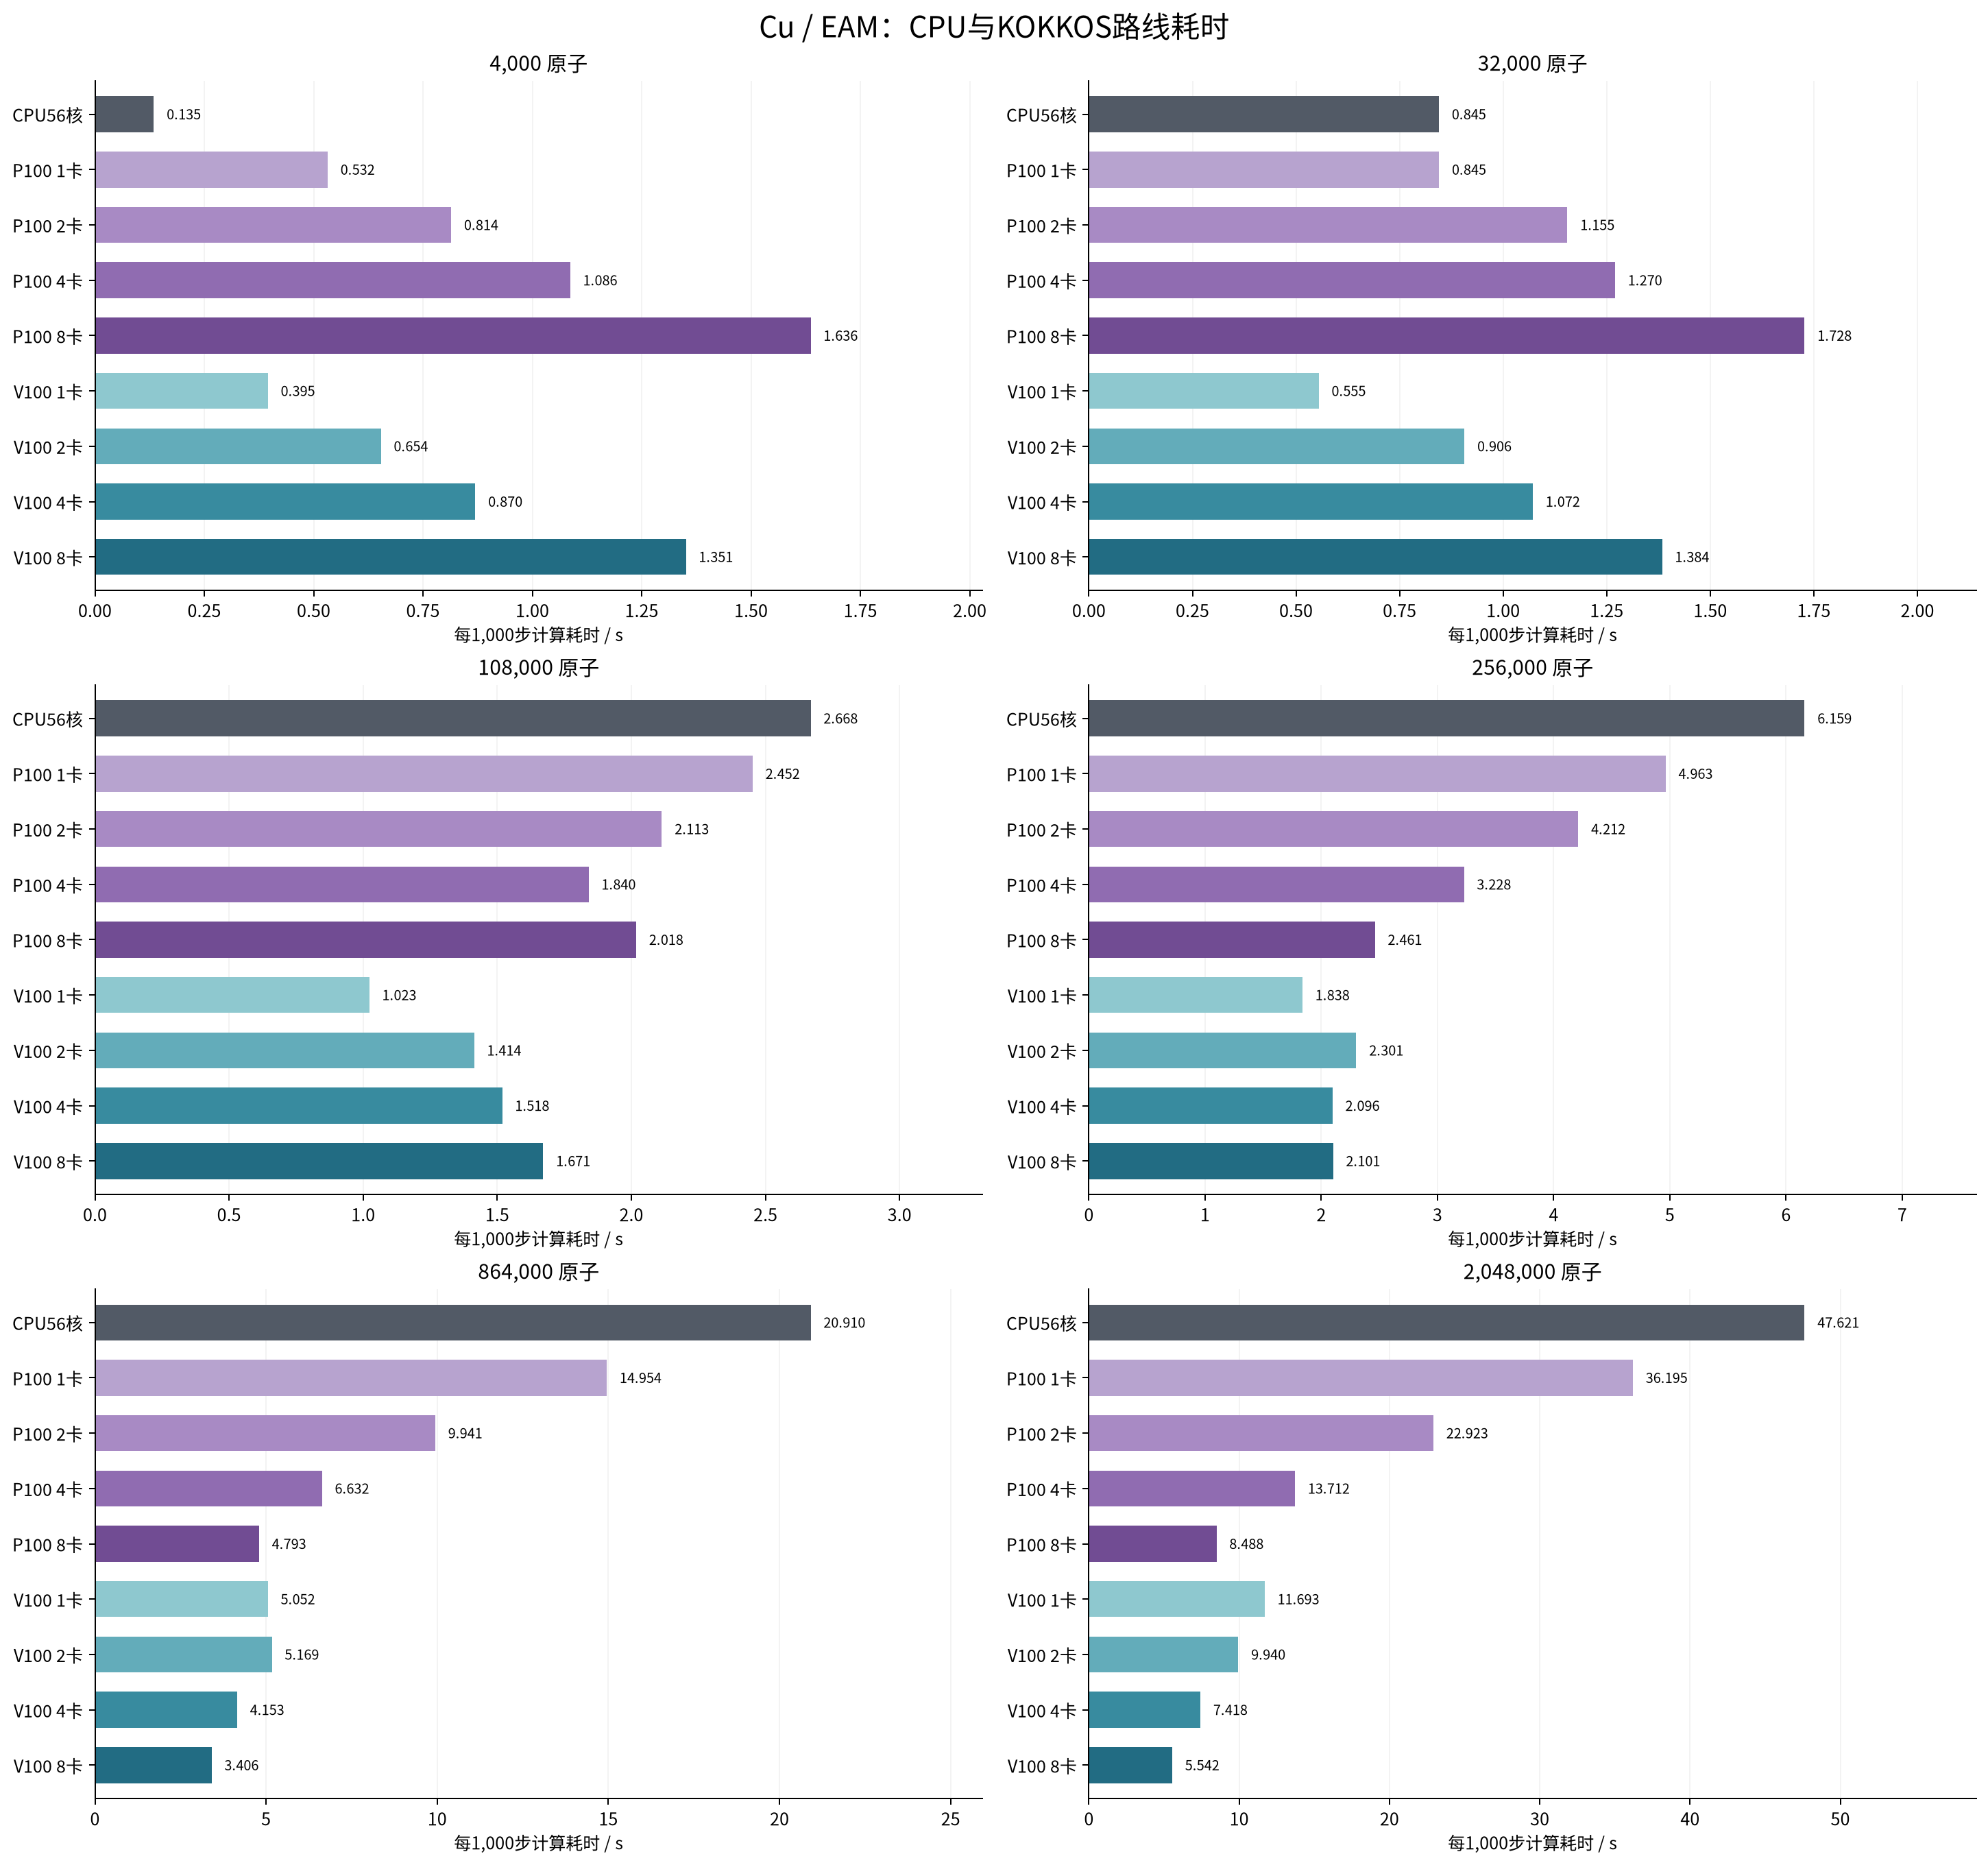
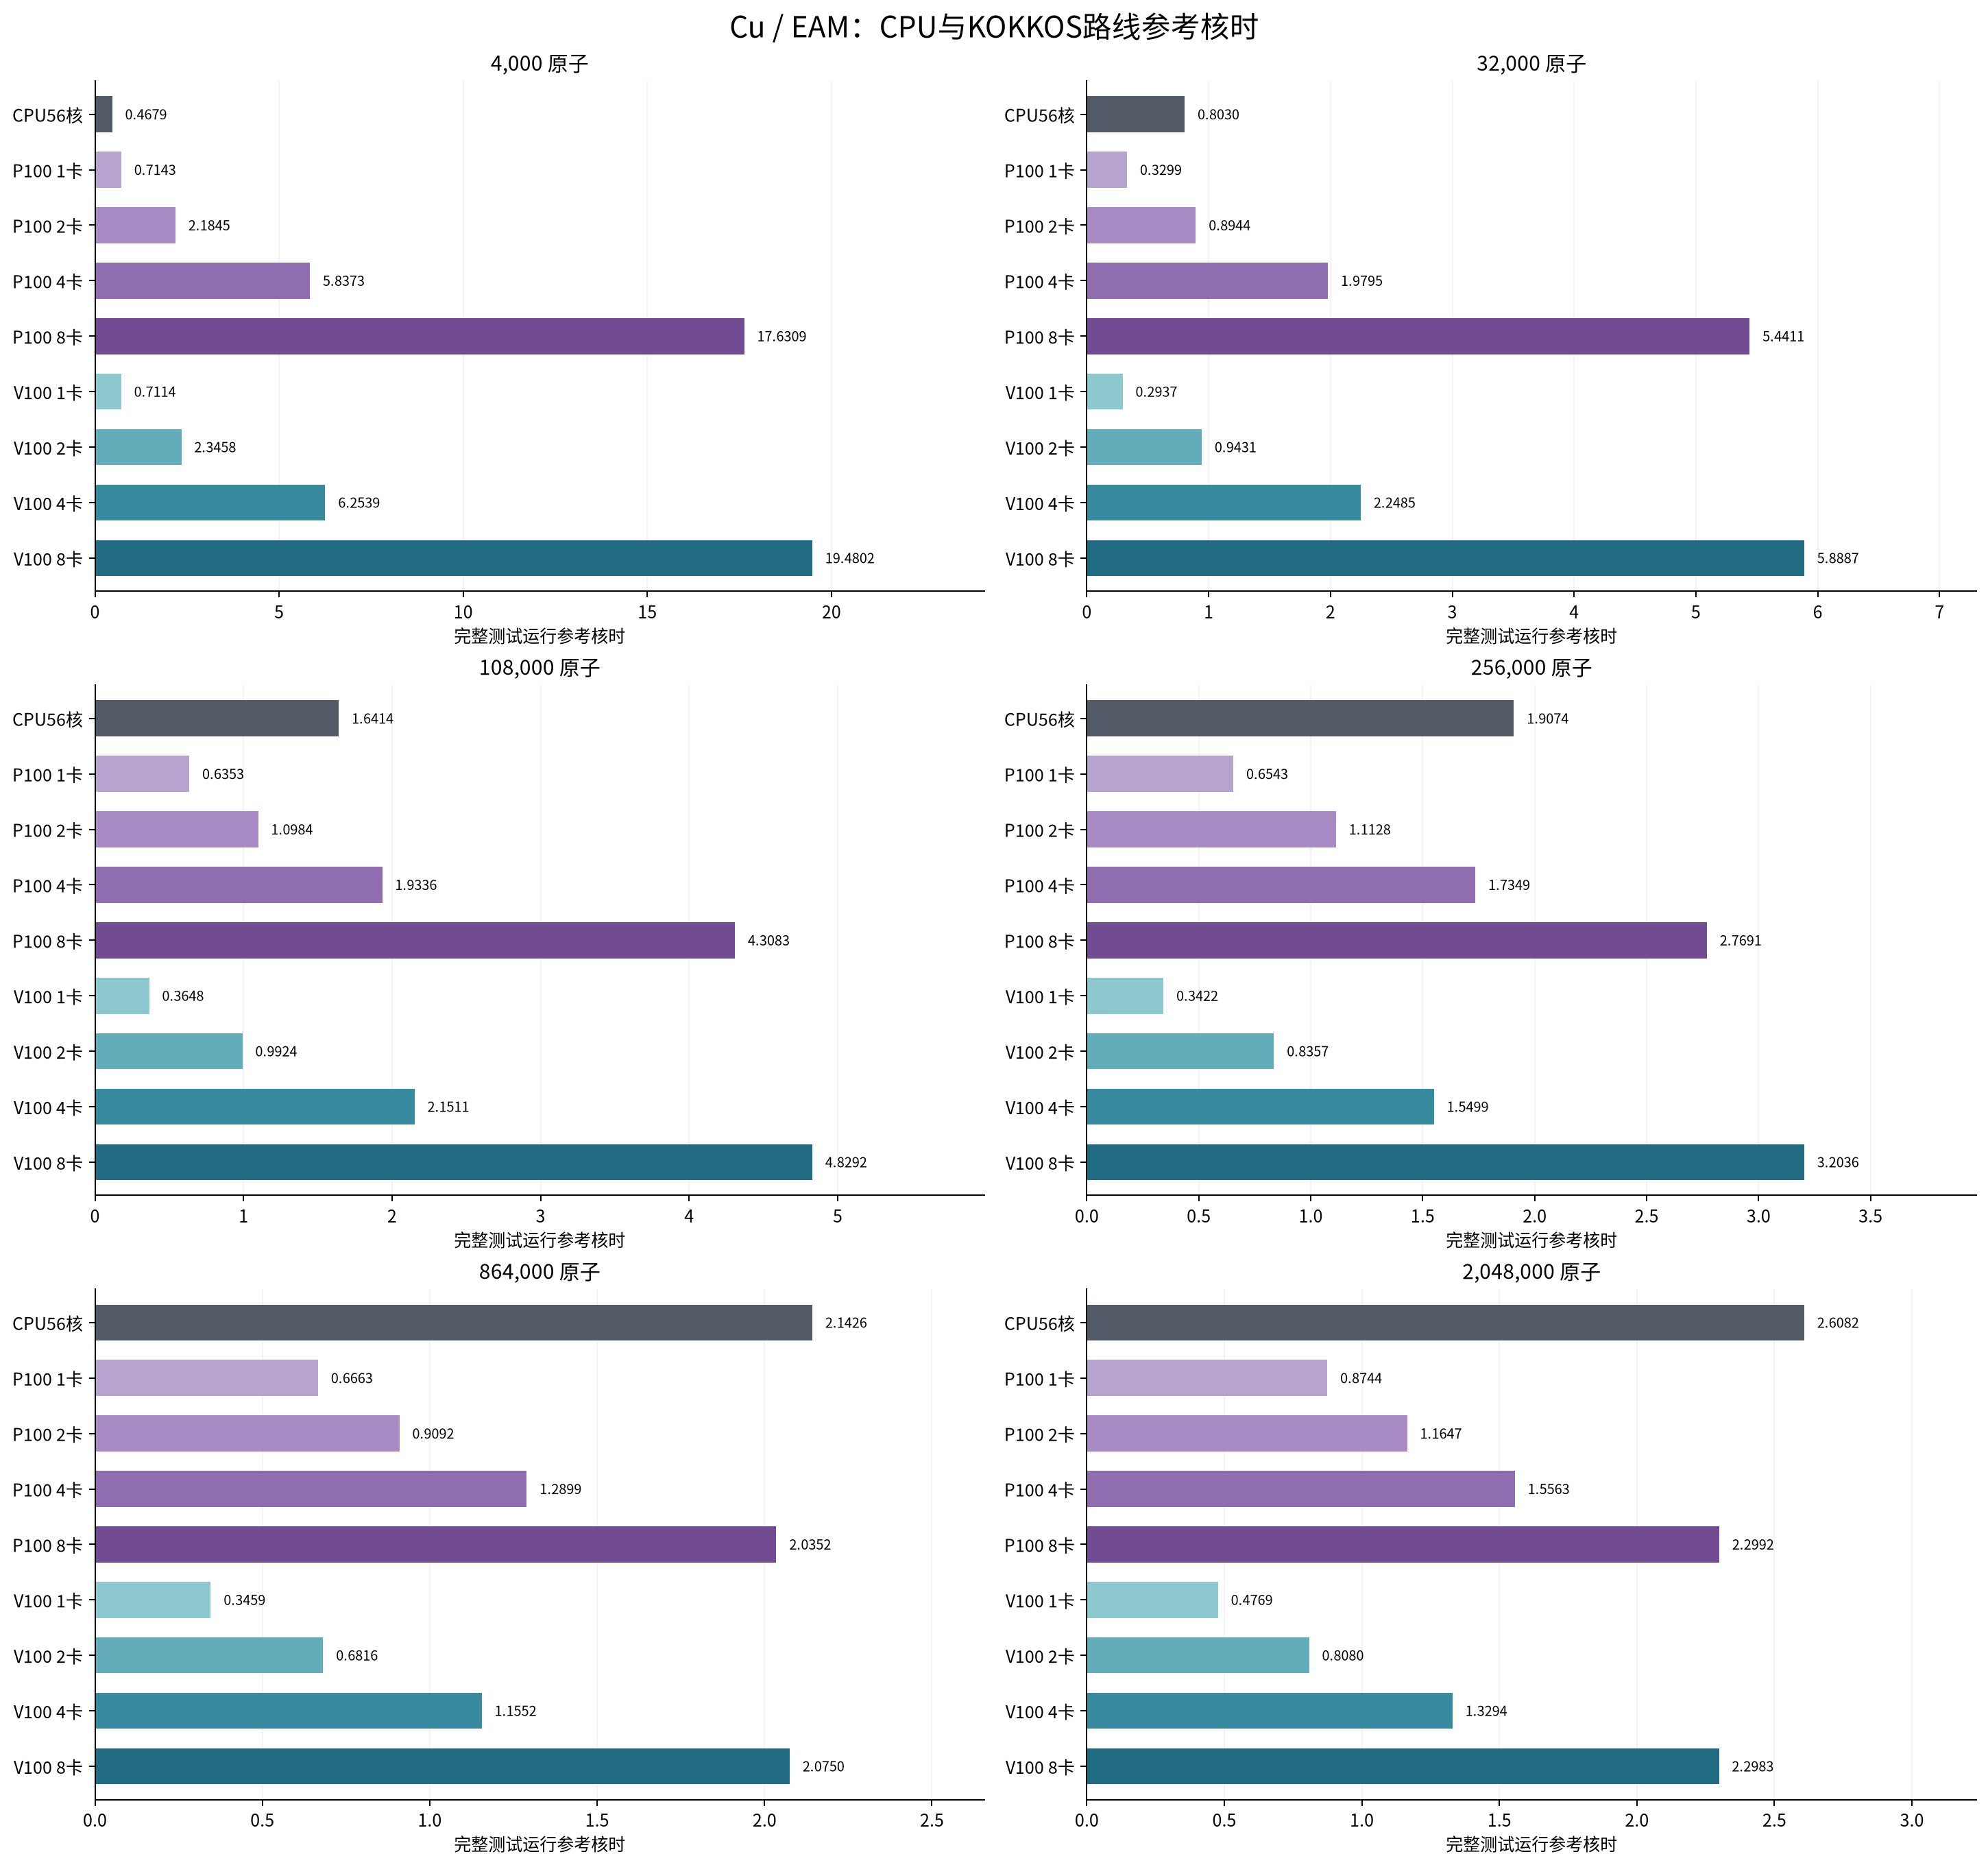
- **4,000原子:**已测候选中,计算段最快为CPU56核,每1,000步0.135秒;该次完整运行参考核时最少为CPU56核,0.4679核时。
- **32,000原子:**已测候选中,计算段最快为V100 8卡 / gpu,每1,000步0.519秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.2937核时。
- **108,000原子:**已测候选中,计算段最快为V100 8卡 / gpu,每1,000步0.823秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3648核时。
- **256,000原子:**已测候选中,计算段最快为P100 8卡 / gpu,每1,000步1.598秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3422核时。
- **864,000原子:**已测候选中,计算段最快为V100 8卡 / kokkos,每1,000步3.406秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3459核时。
- **2,048,000原子:**已测候选中,计算段最快为V100 8卡 / kokkos,每1,000步5.542秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.4769核时。
同一规模下,最快配置和最少核时配置可能不同。增加显卡会增加计费核心数;只有时间下降足以抵消资源增加时,核时才会随之下降。曲线出现平台或退化时,应结合每卡原子数、MPI通信和未卸载部分判断,不把更多显卡当作必然更快。
Cu / EAM:CPU与GPU路线耗时
Cu / EAM:CPU与GPU路线参考核时
Cu / EAM:CPU与KOKKOS路线耗时
Cu / EAM:CPU与KOKKOS路线参考核时
Si / Tersoff#
- **4,096原子:**已测候选中,计算段最快为CPU56核,每1,000步0.187秒;该次完整运行参考核时最少为P100 1卡 / kokkos,0.2851核时。
- **32,768原子:**已测候选中,计算段最快为V100 1卡 / kokkos,每1,000步0.277秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.2658核时。
- **110,592原子:**已测候选中,计算段最快为V100 1卡 / kokkos,每1,000步0.531秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.2718核时。
- **262,144原子:**已测候选中,计算段最快为V100 1卡 / kokkos,每1,000步1.028秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3020核时。
- **884,736原子:**已测候选中,计算段最快为V100 8卡 / kokkos,每1,000步2.841秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3522核时。
- **2,097,152原子:**已测候选中,计算段最快为V100 8卡 / kokkos,每1,000步4.429秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.4433核时。
同一规模下,最快配置和最少核时配置可能不同。增加显卡会增加计费核心数;只有时间下降足以抵消资源增加时,核时才会随之下降。曲线出现平台或退化时,应结合每卡原子数、MPI通信和未卸载部分判断,不把更多显卡当作必然更快。
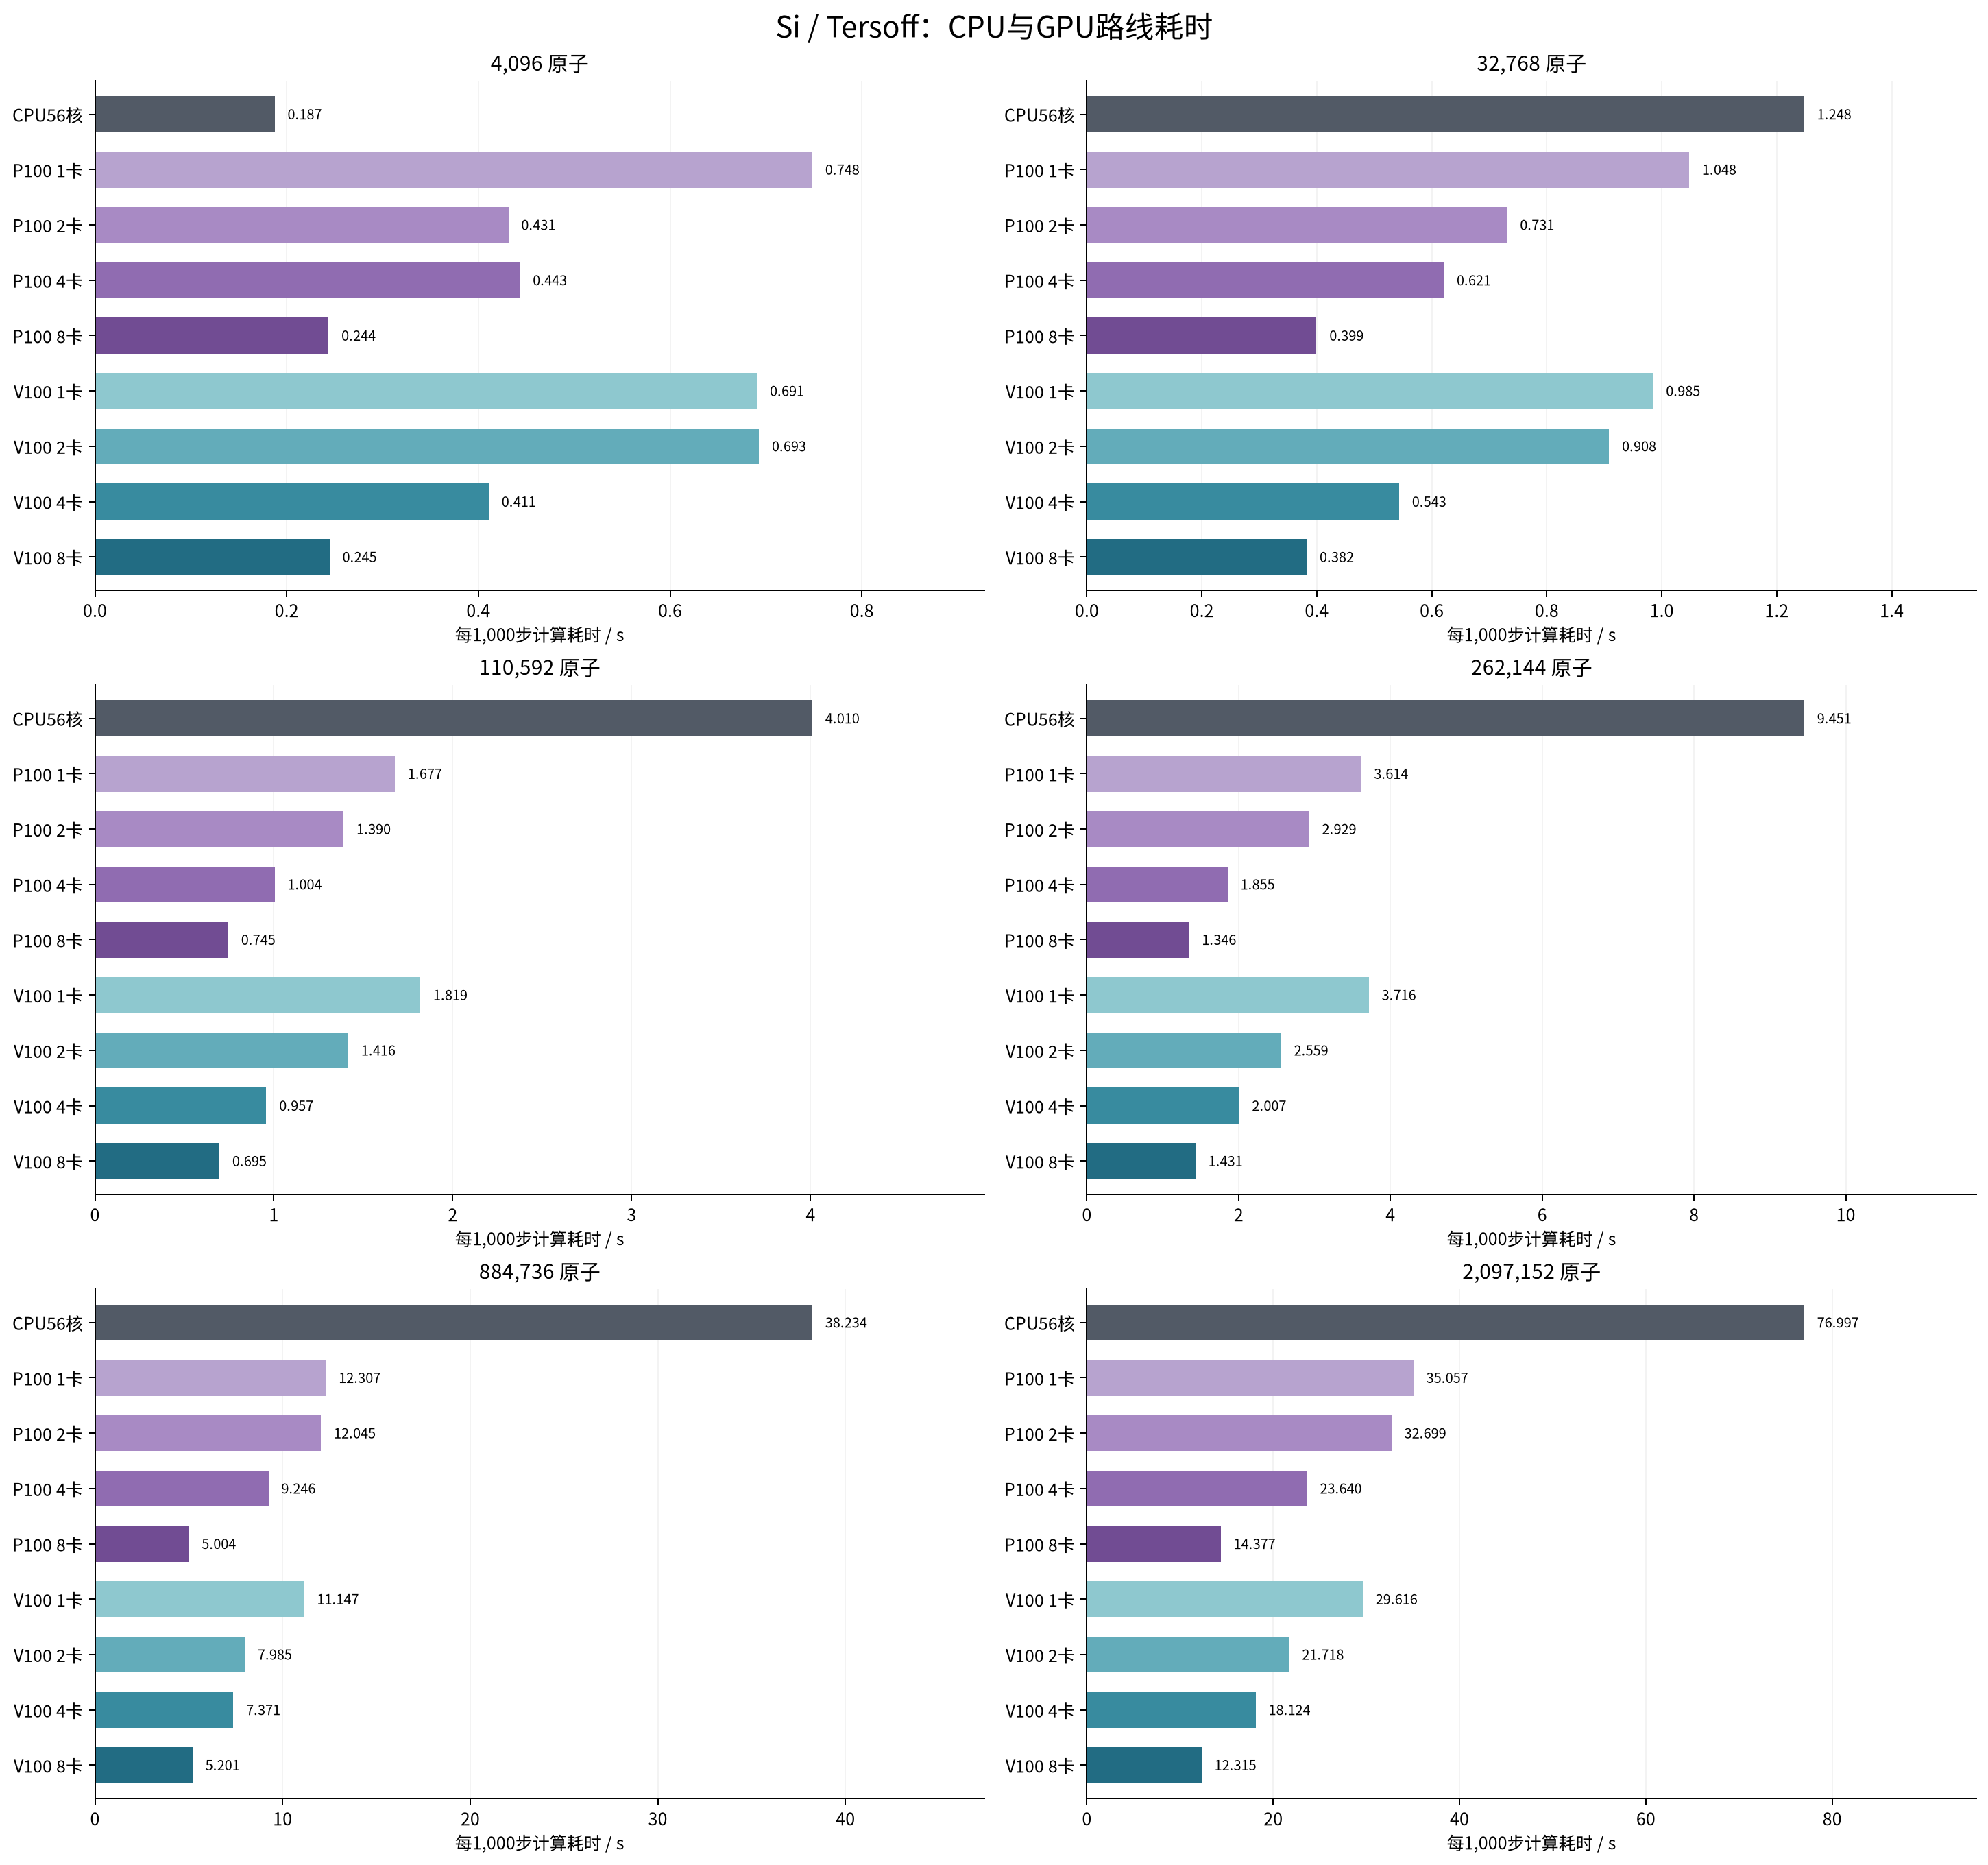
Si / Tersoff:CPU与GPU路线耗时
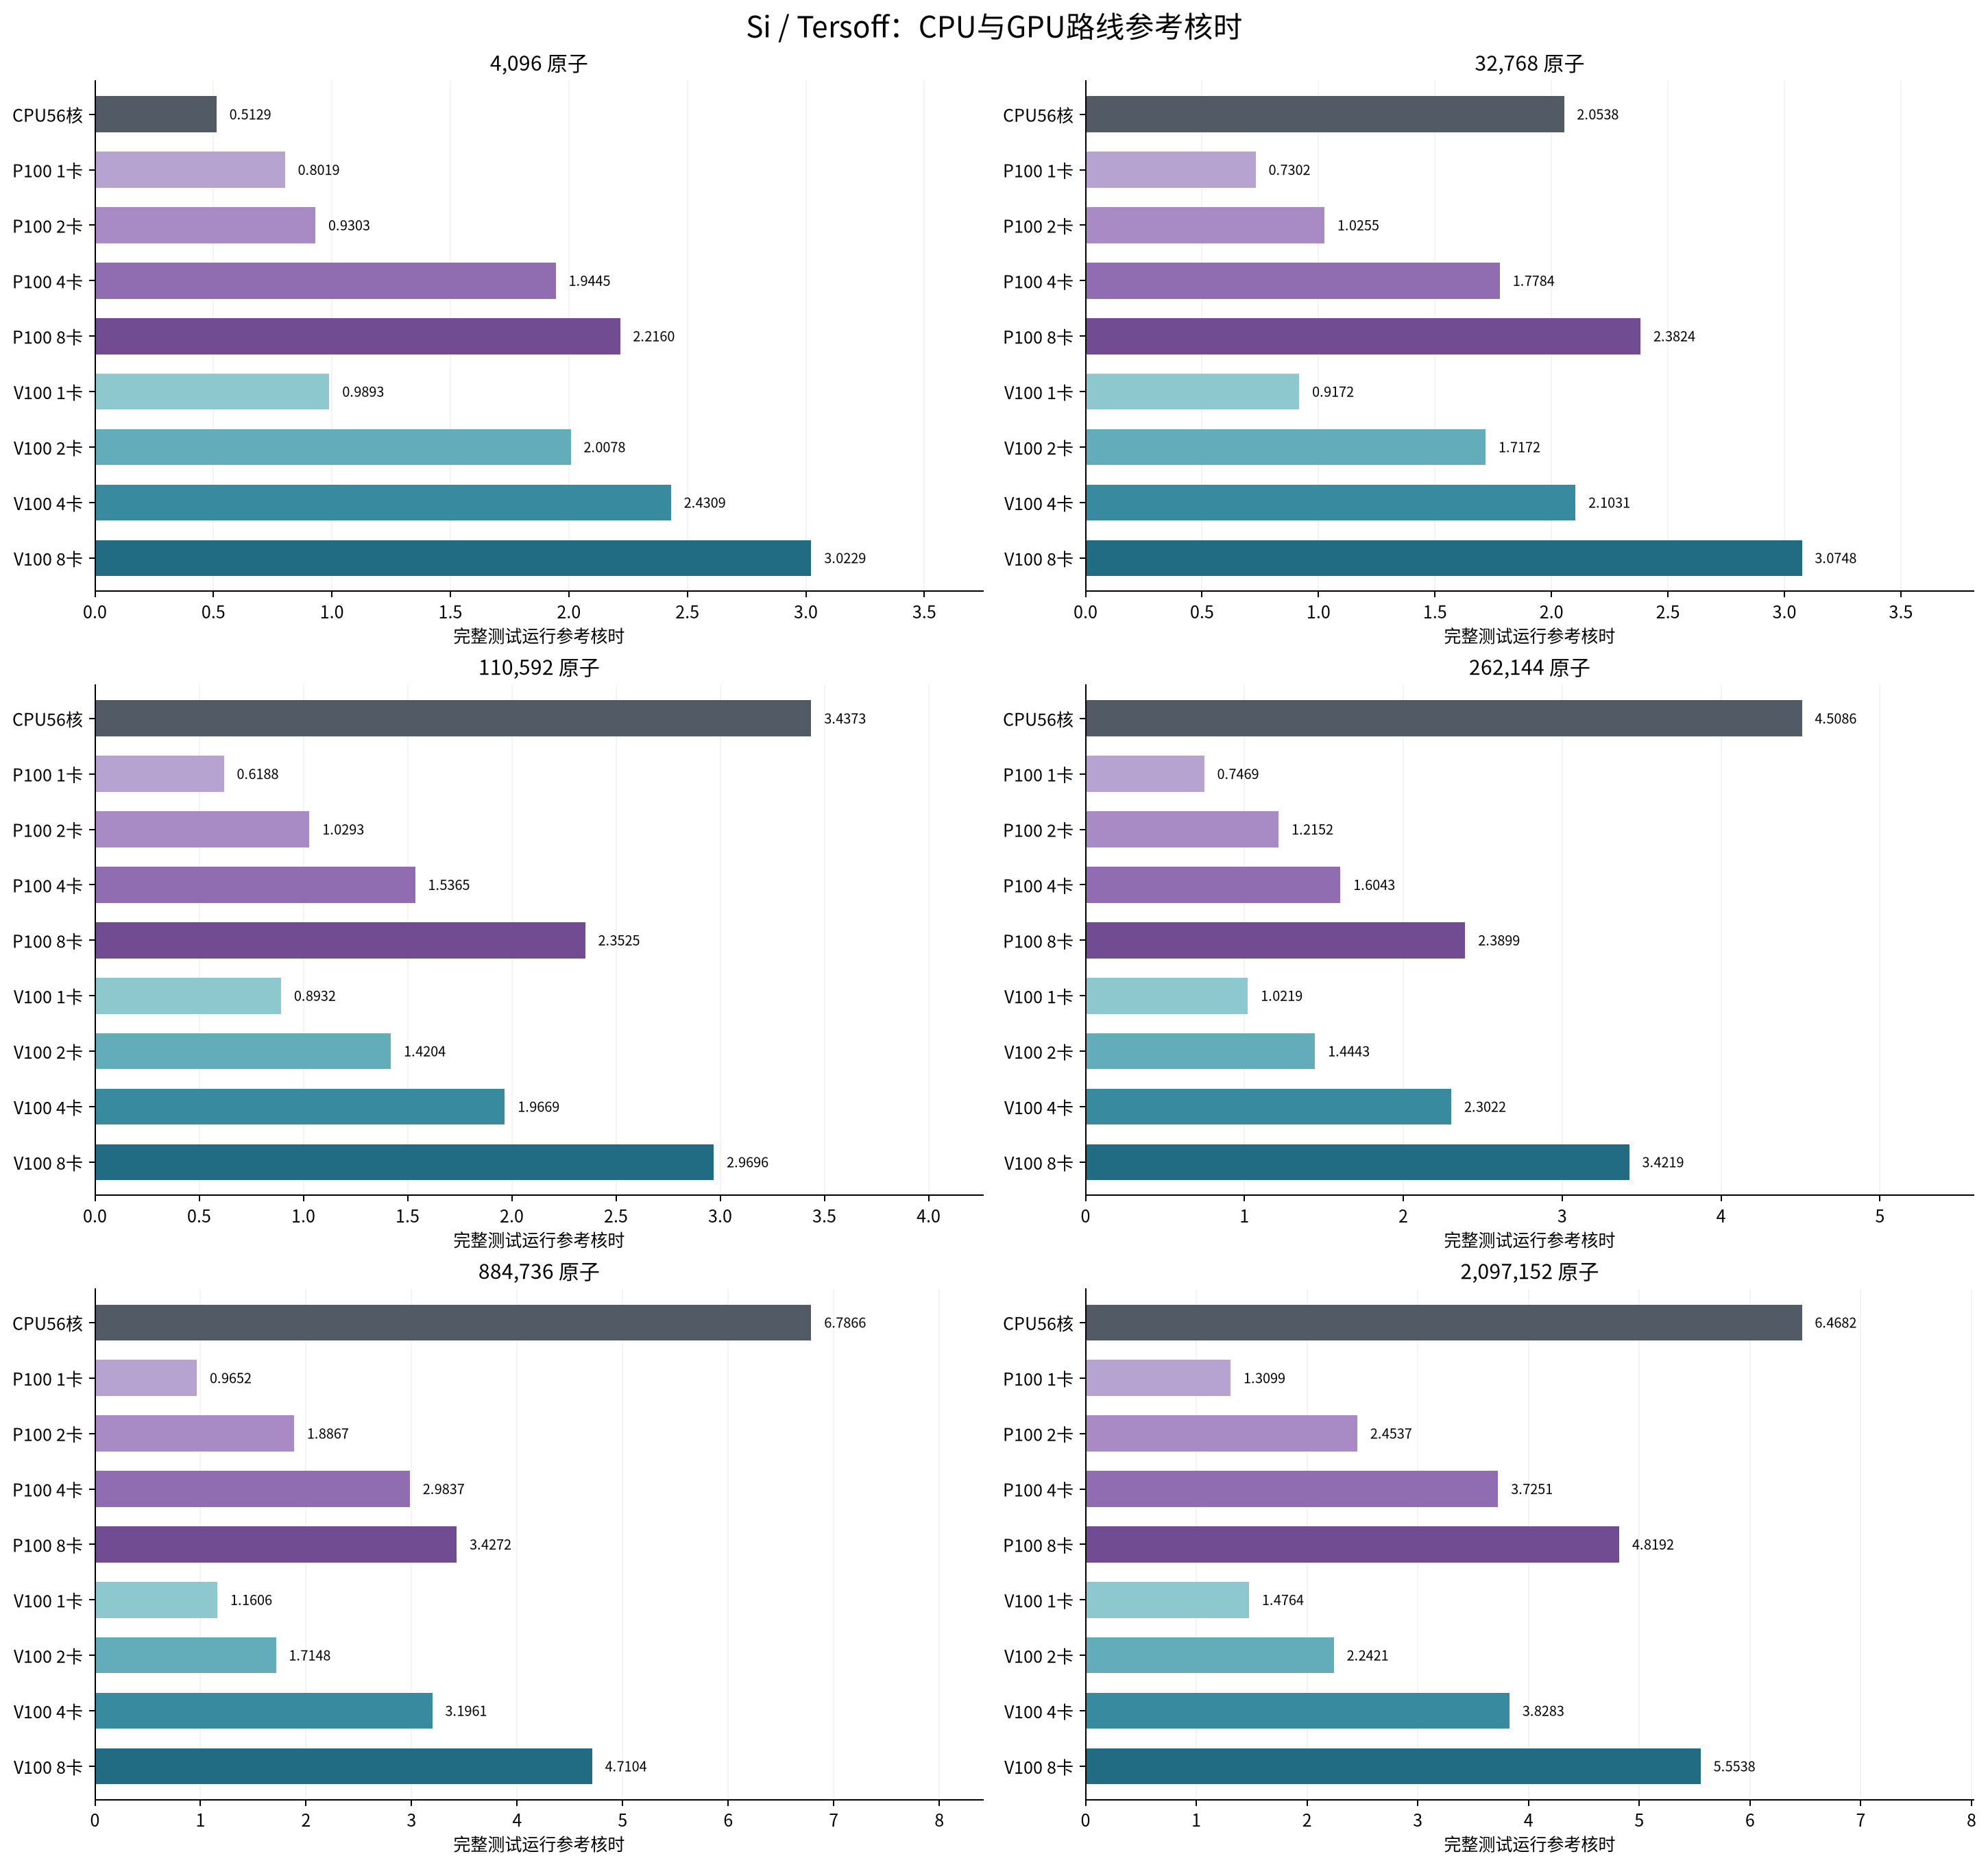
Si / Tersoff:CPU与GPU路线参考核时
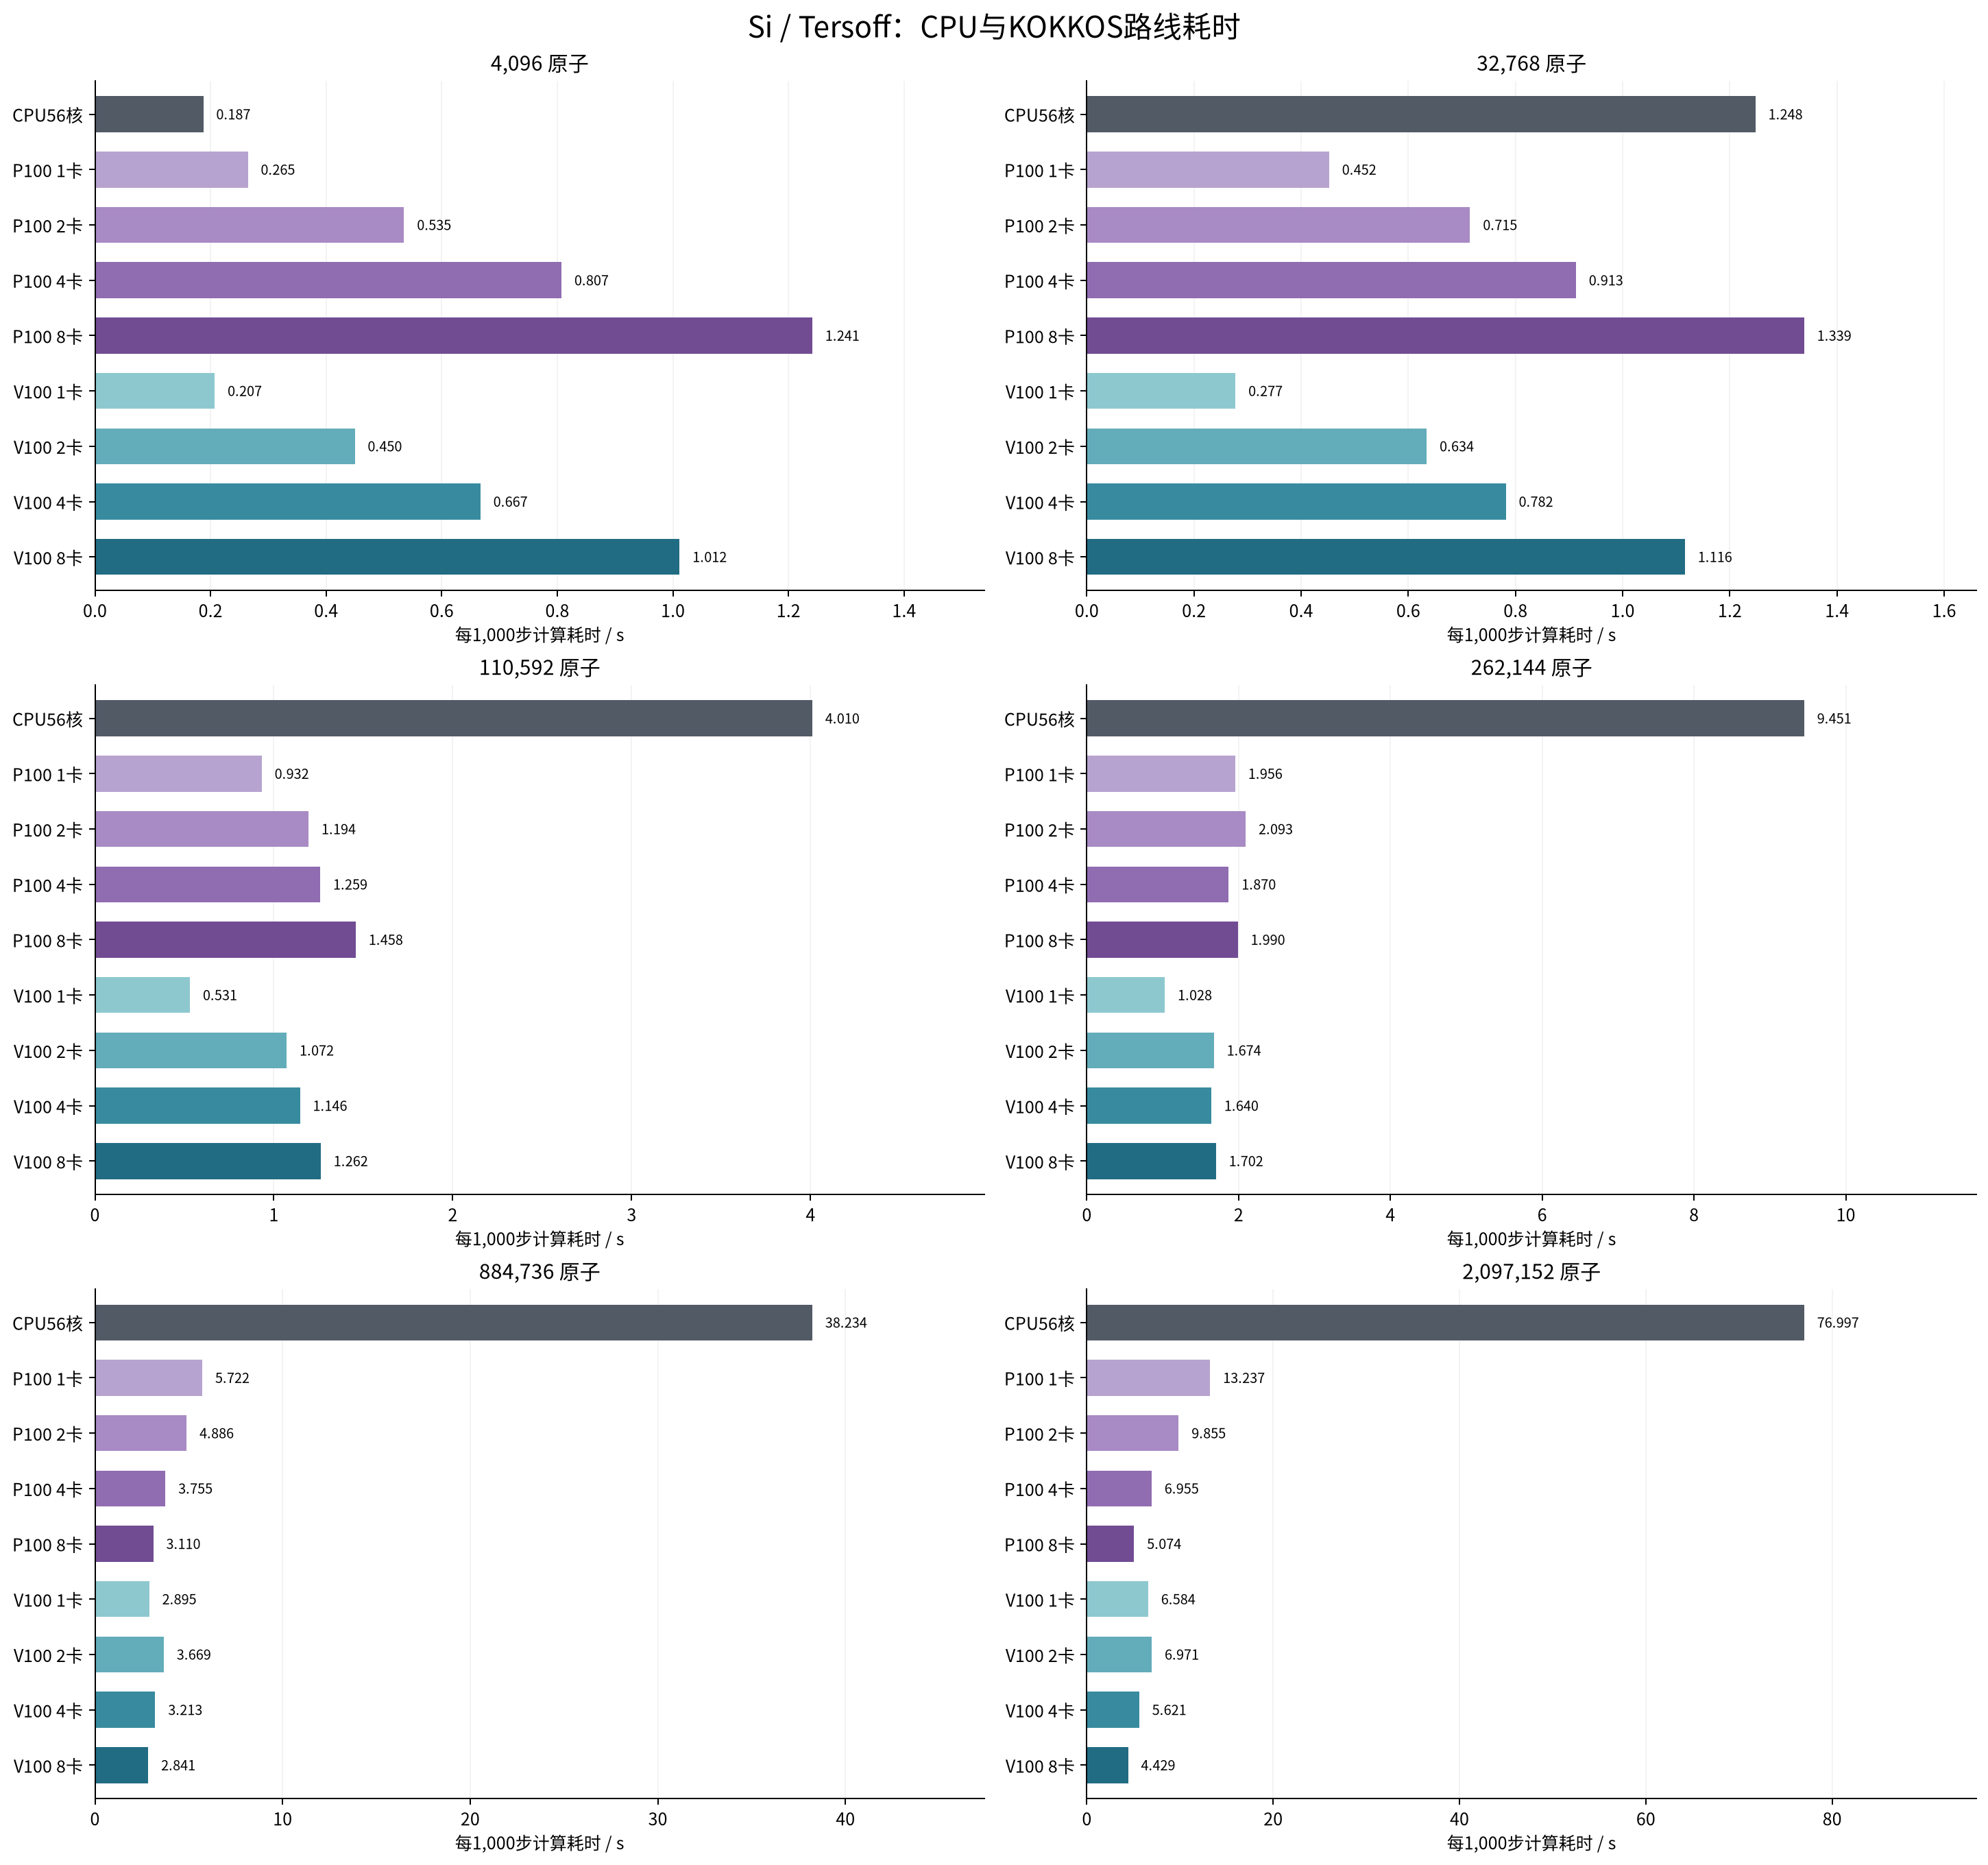
Si / Tersoff:CPU与KOKKOS路线耗时
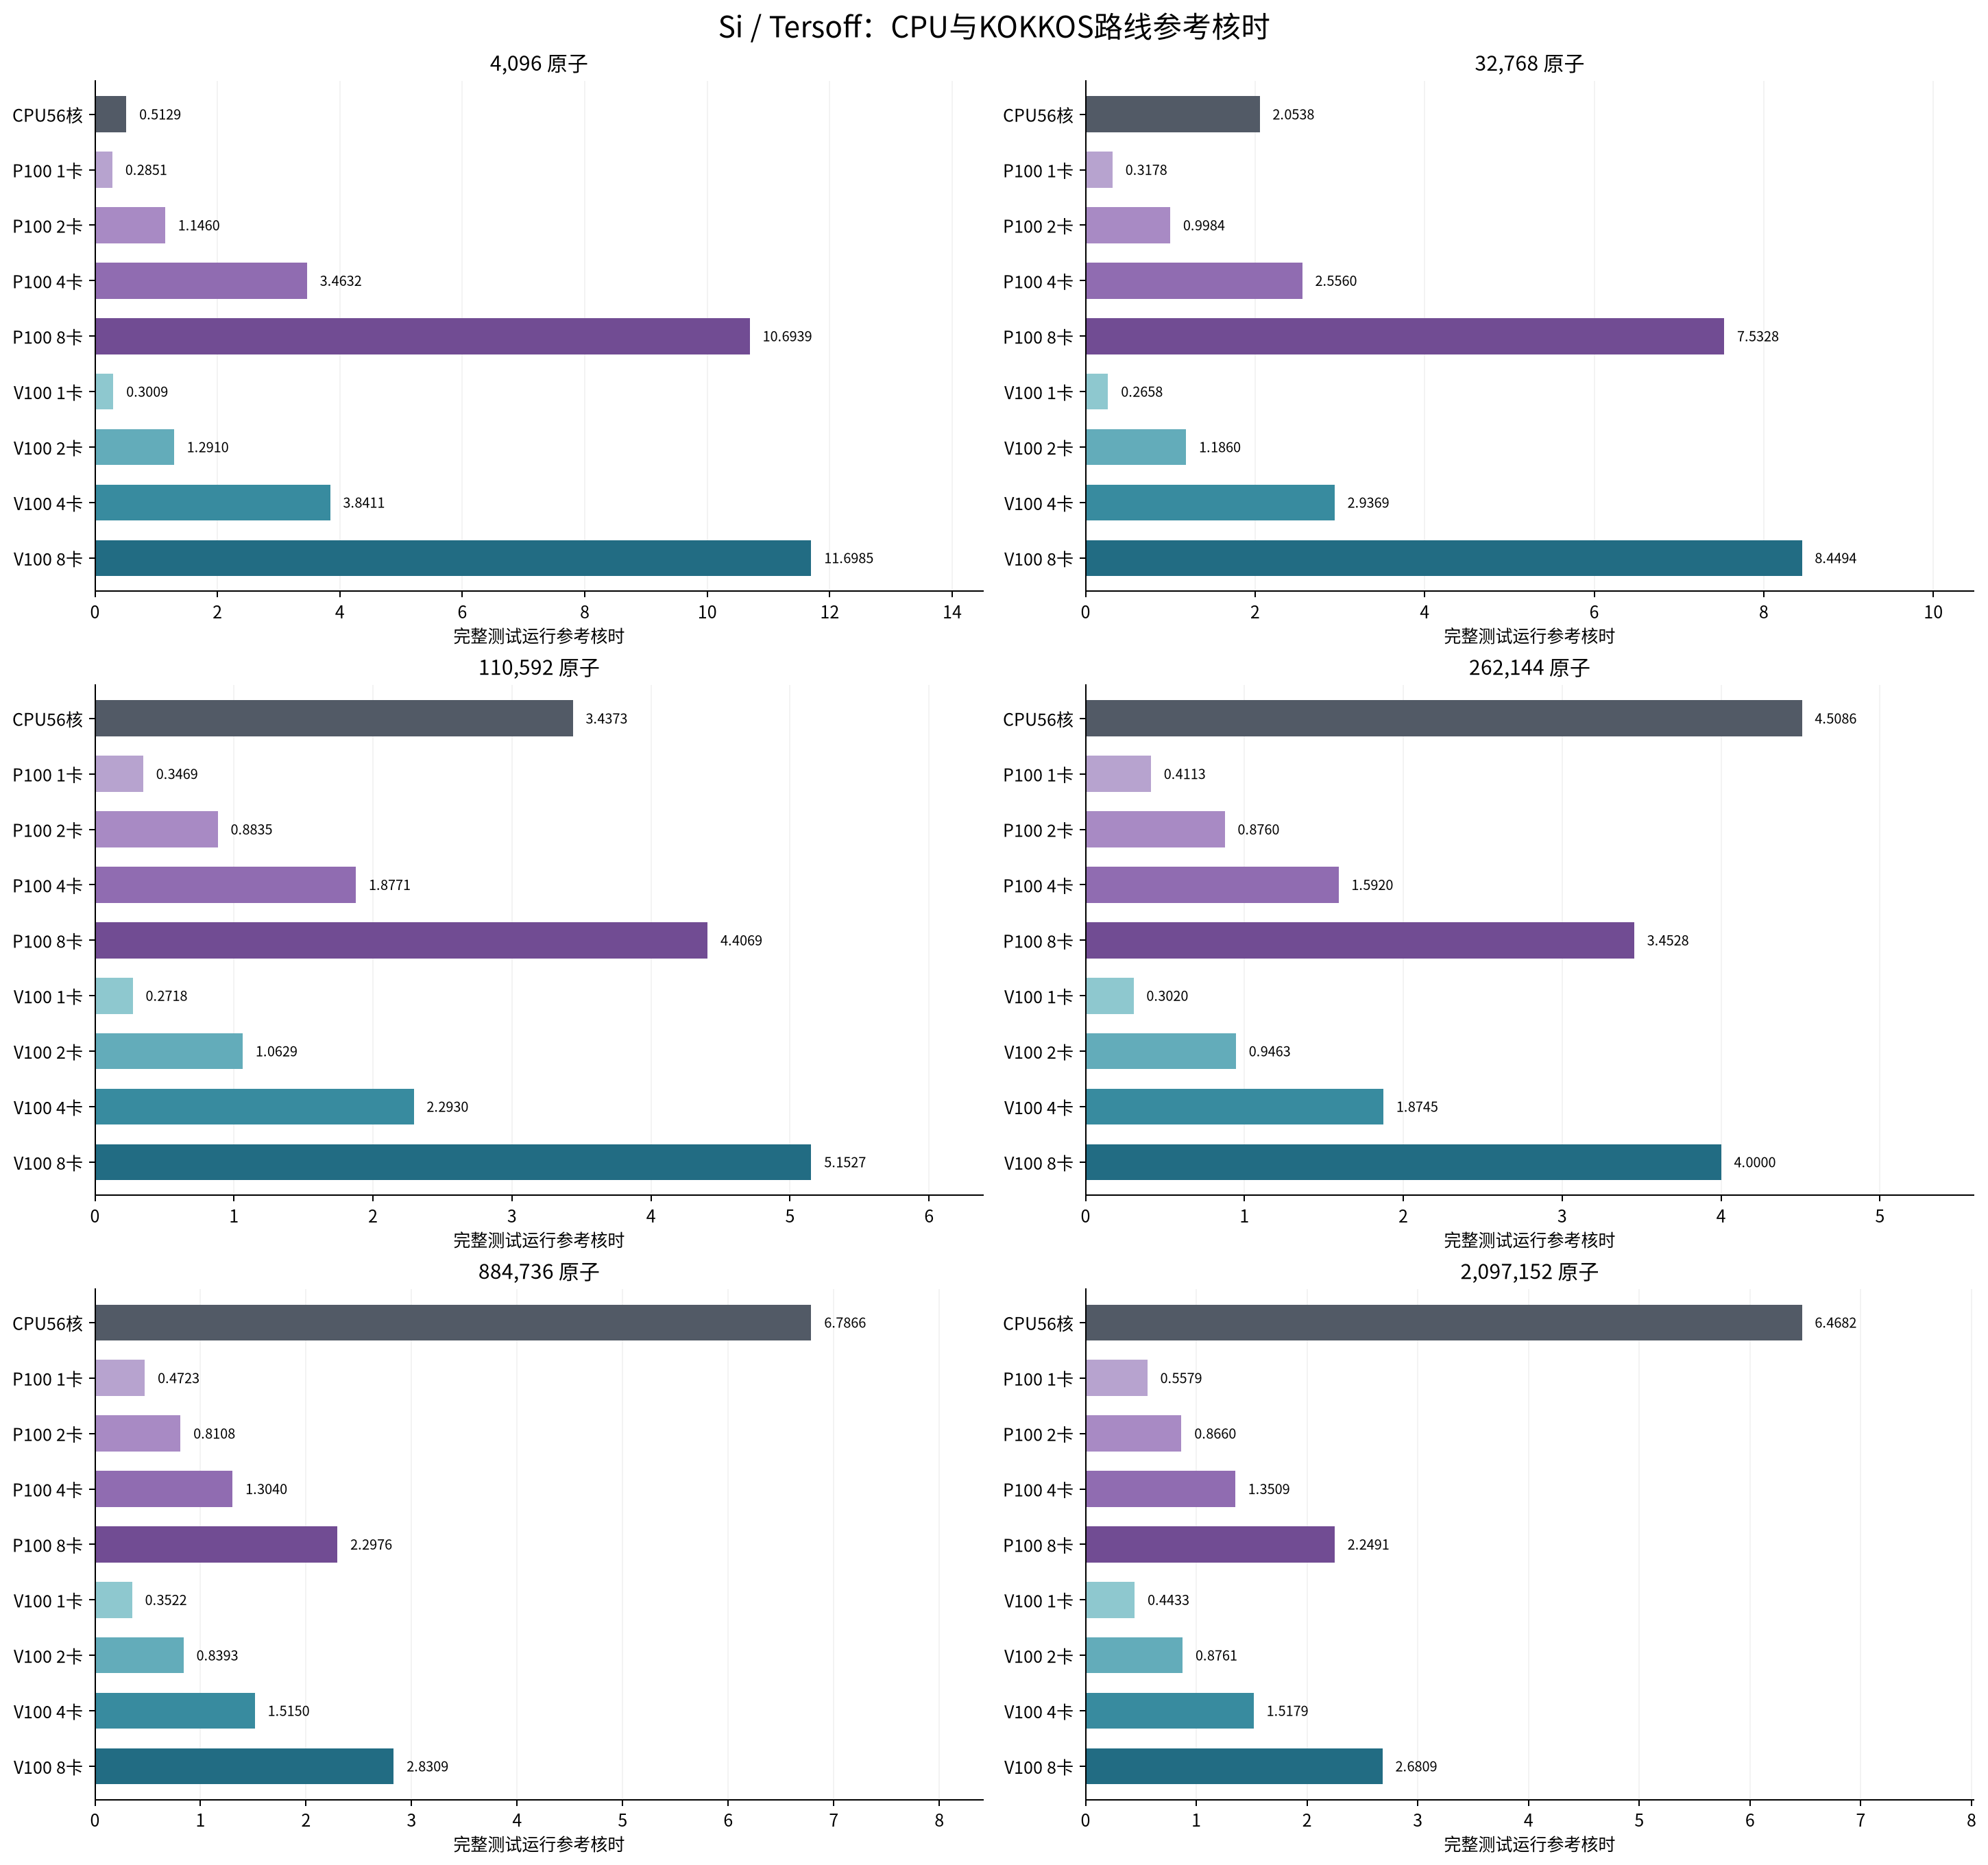
Si / Tersoff:CPU与KOKKOS路线参考核时
SPC/E 水 / PPPM#
- **4,500原子:**已测候选中,计算段最快为CPU56核,每1,000步1.510秒;该次完整运行参考核时最少为P100 1卡 / kokkos,0.4203核时。
- **36,000原子:**已测候选中,计算段最快为V100 1卡 / kokkos,每1,000步8.672秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.2978核时。
- **121,500原子:**已测候选中,计算段最快为V100 1卡 / kokkos,每1,000步39.711秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.3475核时。
- **288,000原子:**已测候选中,计算段最快为CPU56核,每1,000步133.140秒;该次完整运行参考核时最少为V100 1卡 / kokkos,0.5555核时。
- **972,000原子:**已测候选中,计算段最快为CPU56核,每1,000步512.270秒;该次完整运行参考核时最少为P100 1卡 / kokkos,1.5949核时。
- **2,304,000原子:**已测候选中,计算段最快为CPU56核,每1,000步1284.015秒;该次完整运行参考核时最少为P100 1卡 / kokkos,4.1803核时。
同一规模下,最快配置和最少核时配置可能不同。增加显卡会增加计费核心数;只有时间下降足以抵消资源增加时,核时才会随之下降。曲线出现平台或退化时,应结合每卡原子数、MPI通信和未卸载部分判断,不把更多显卡当作必然更快。
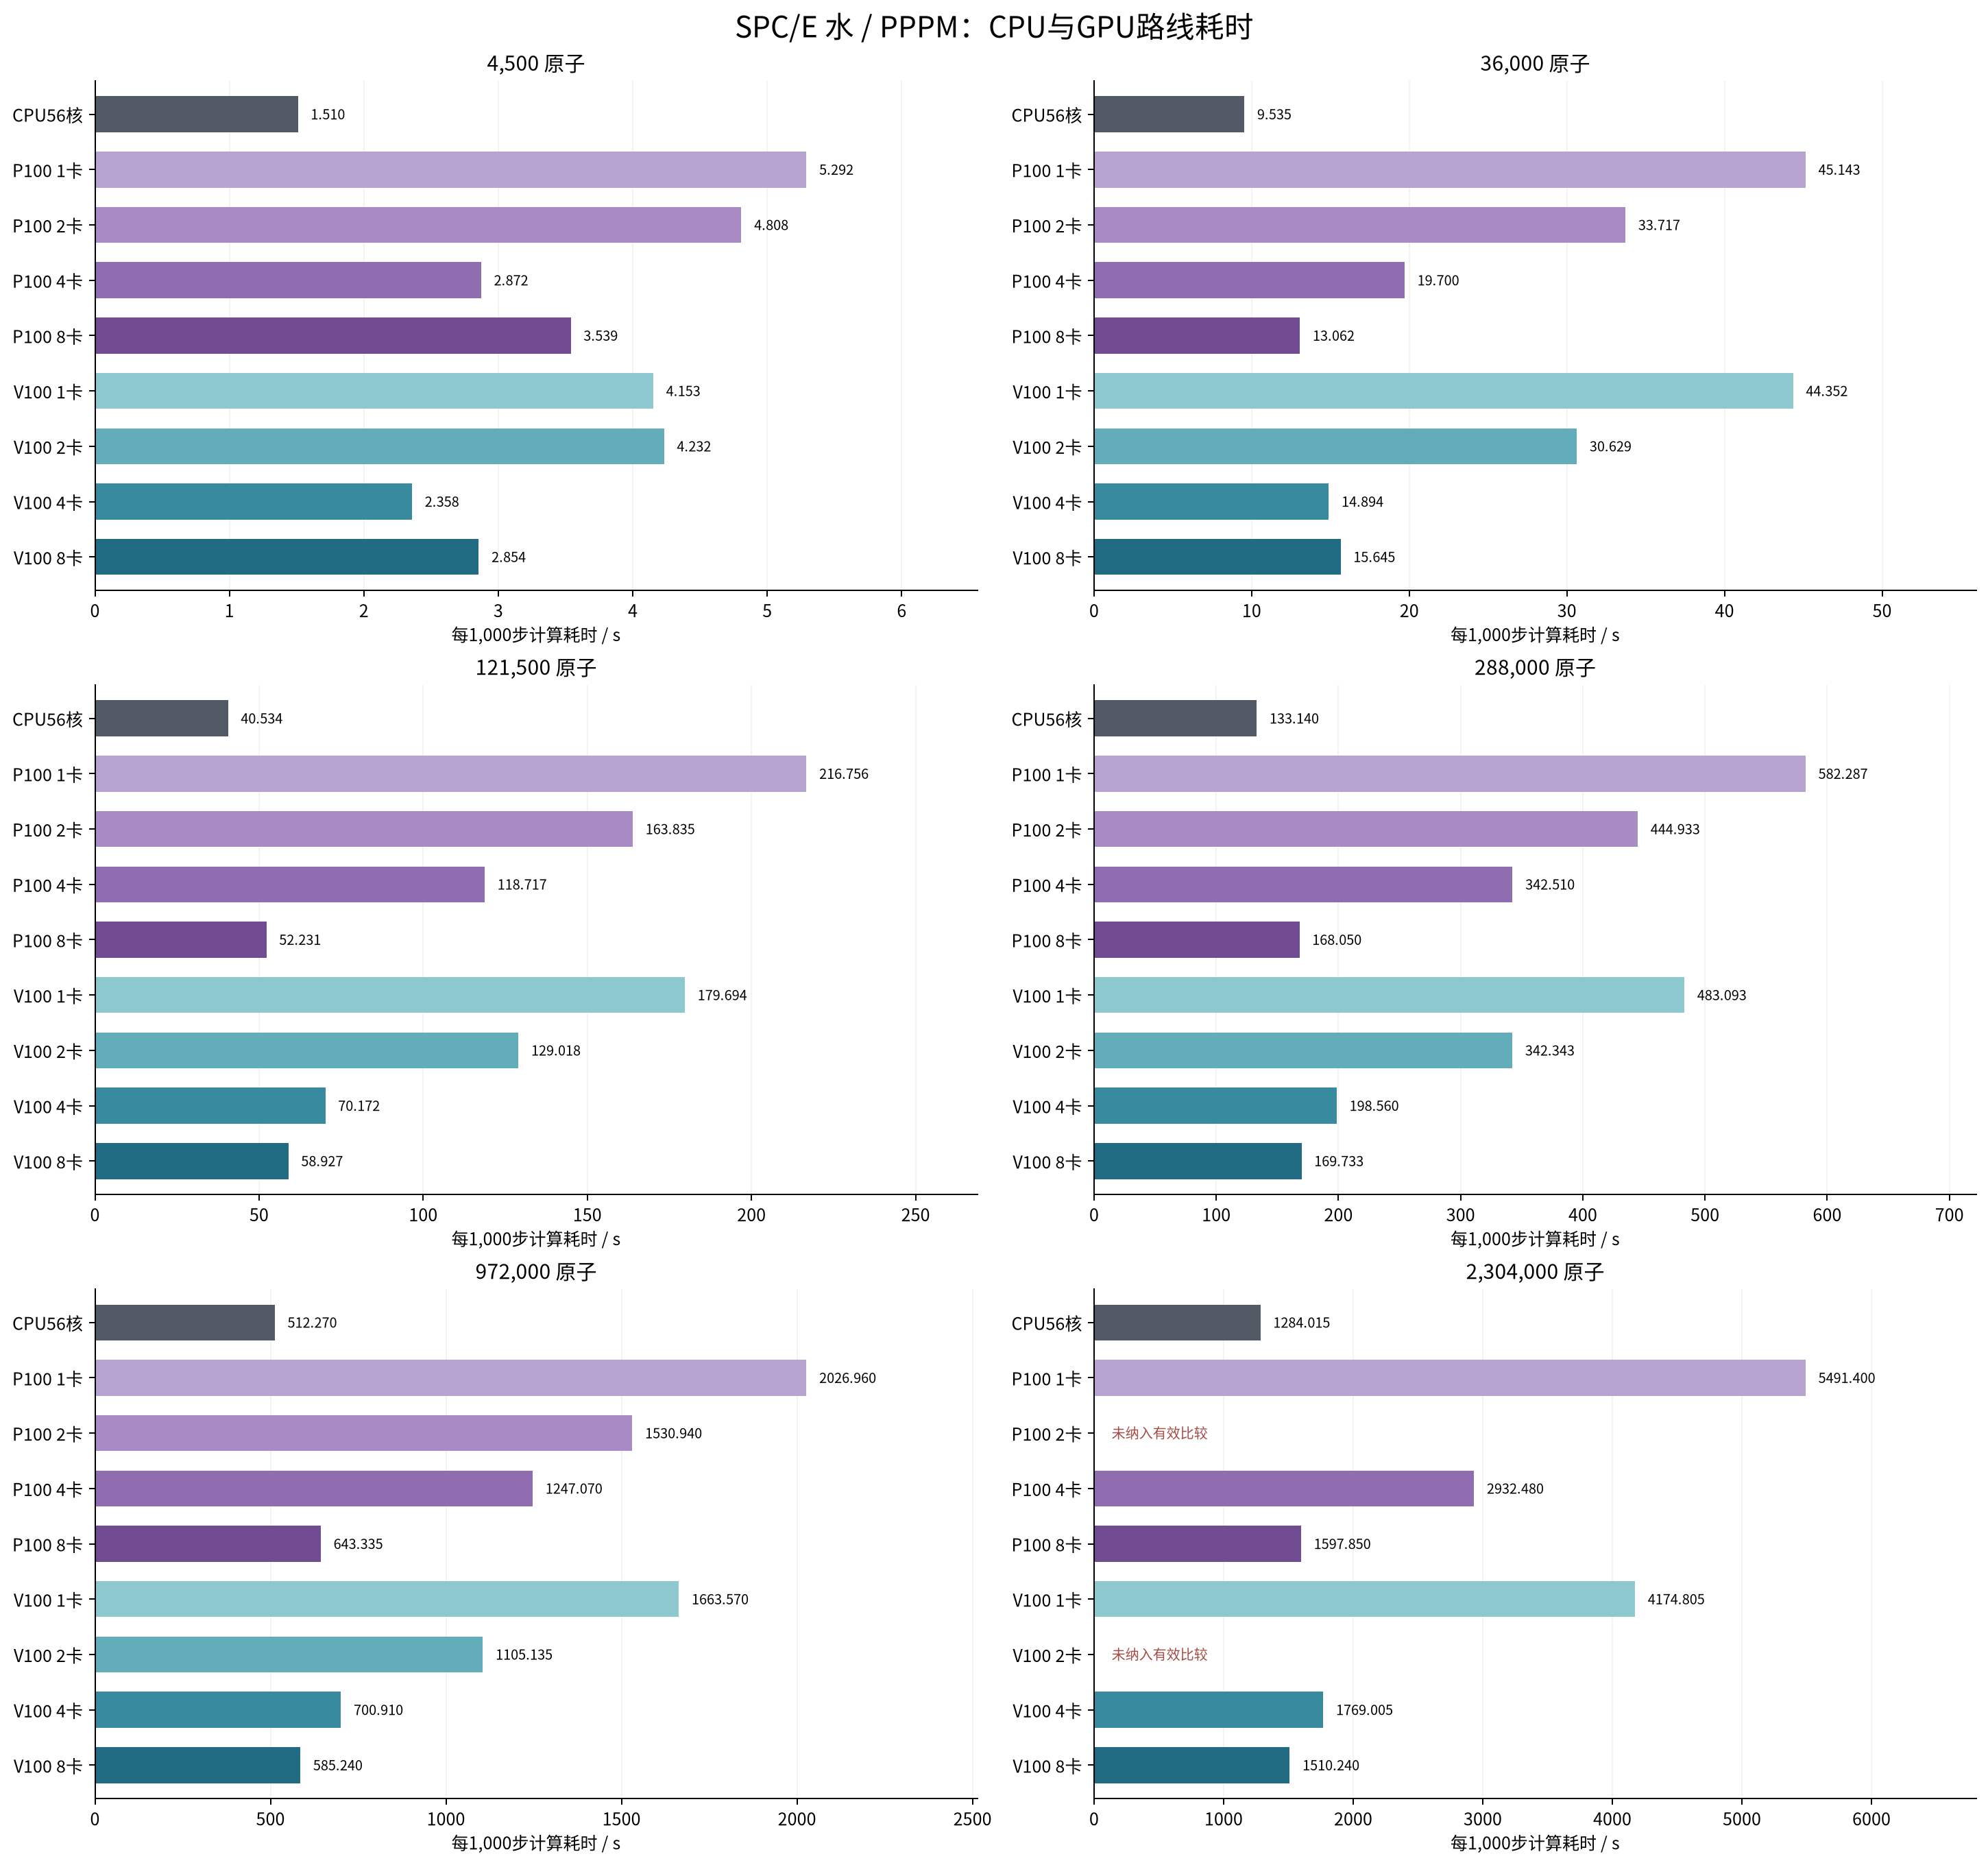
SPC/E 水 / PPPM:CPU与GPU路线耗时
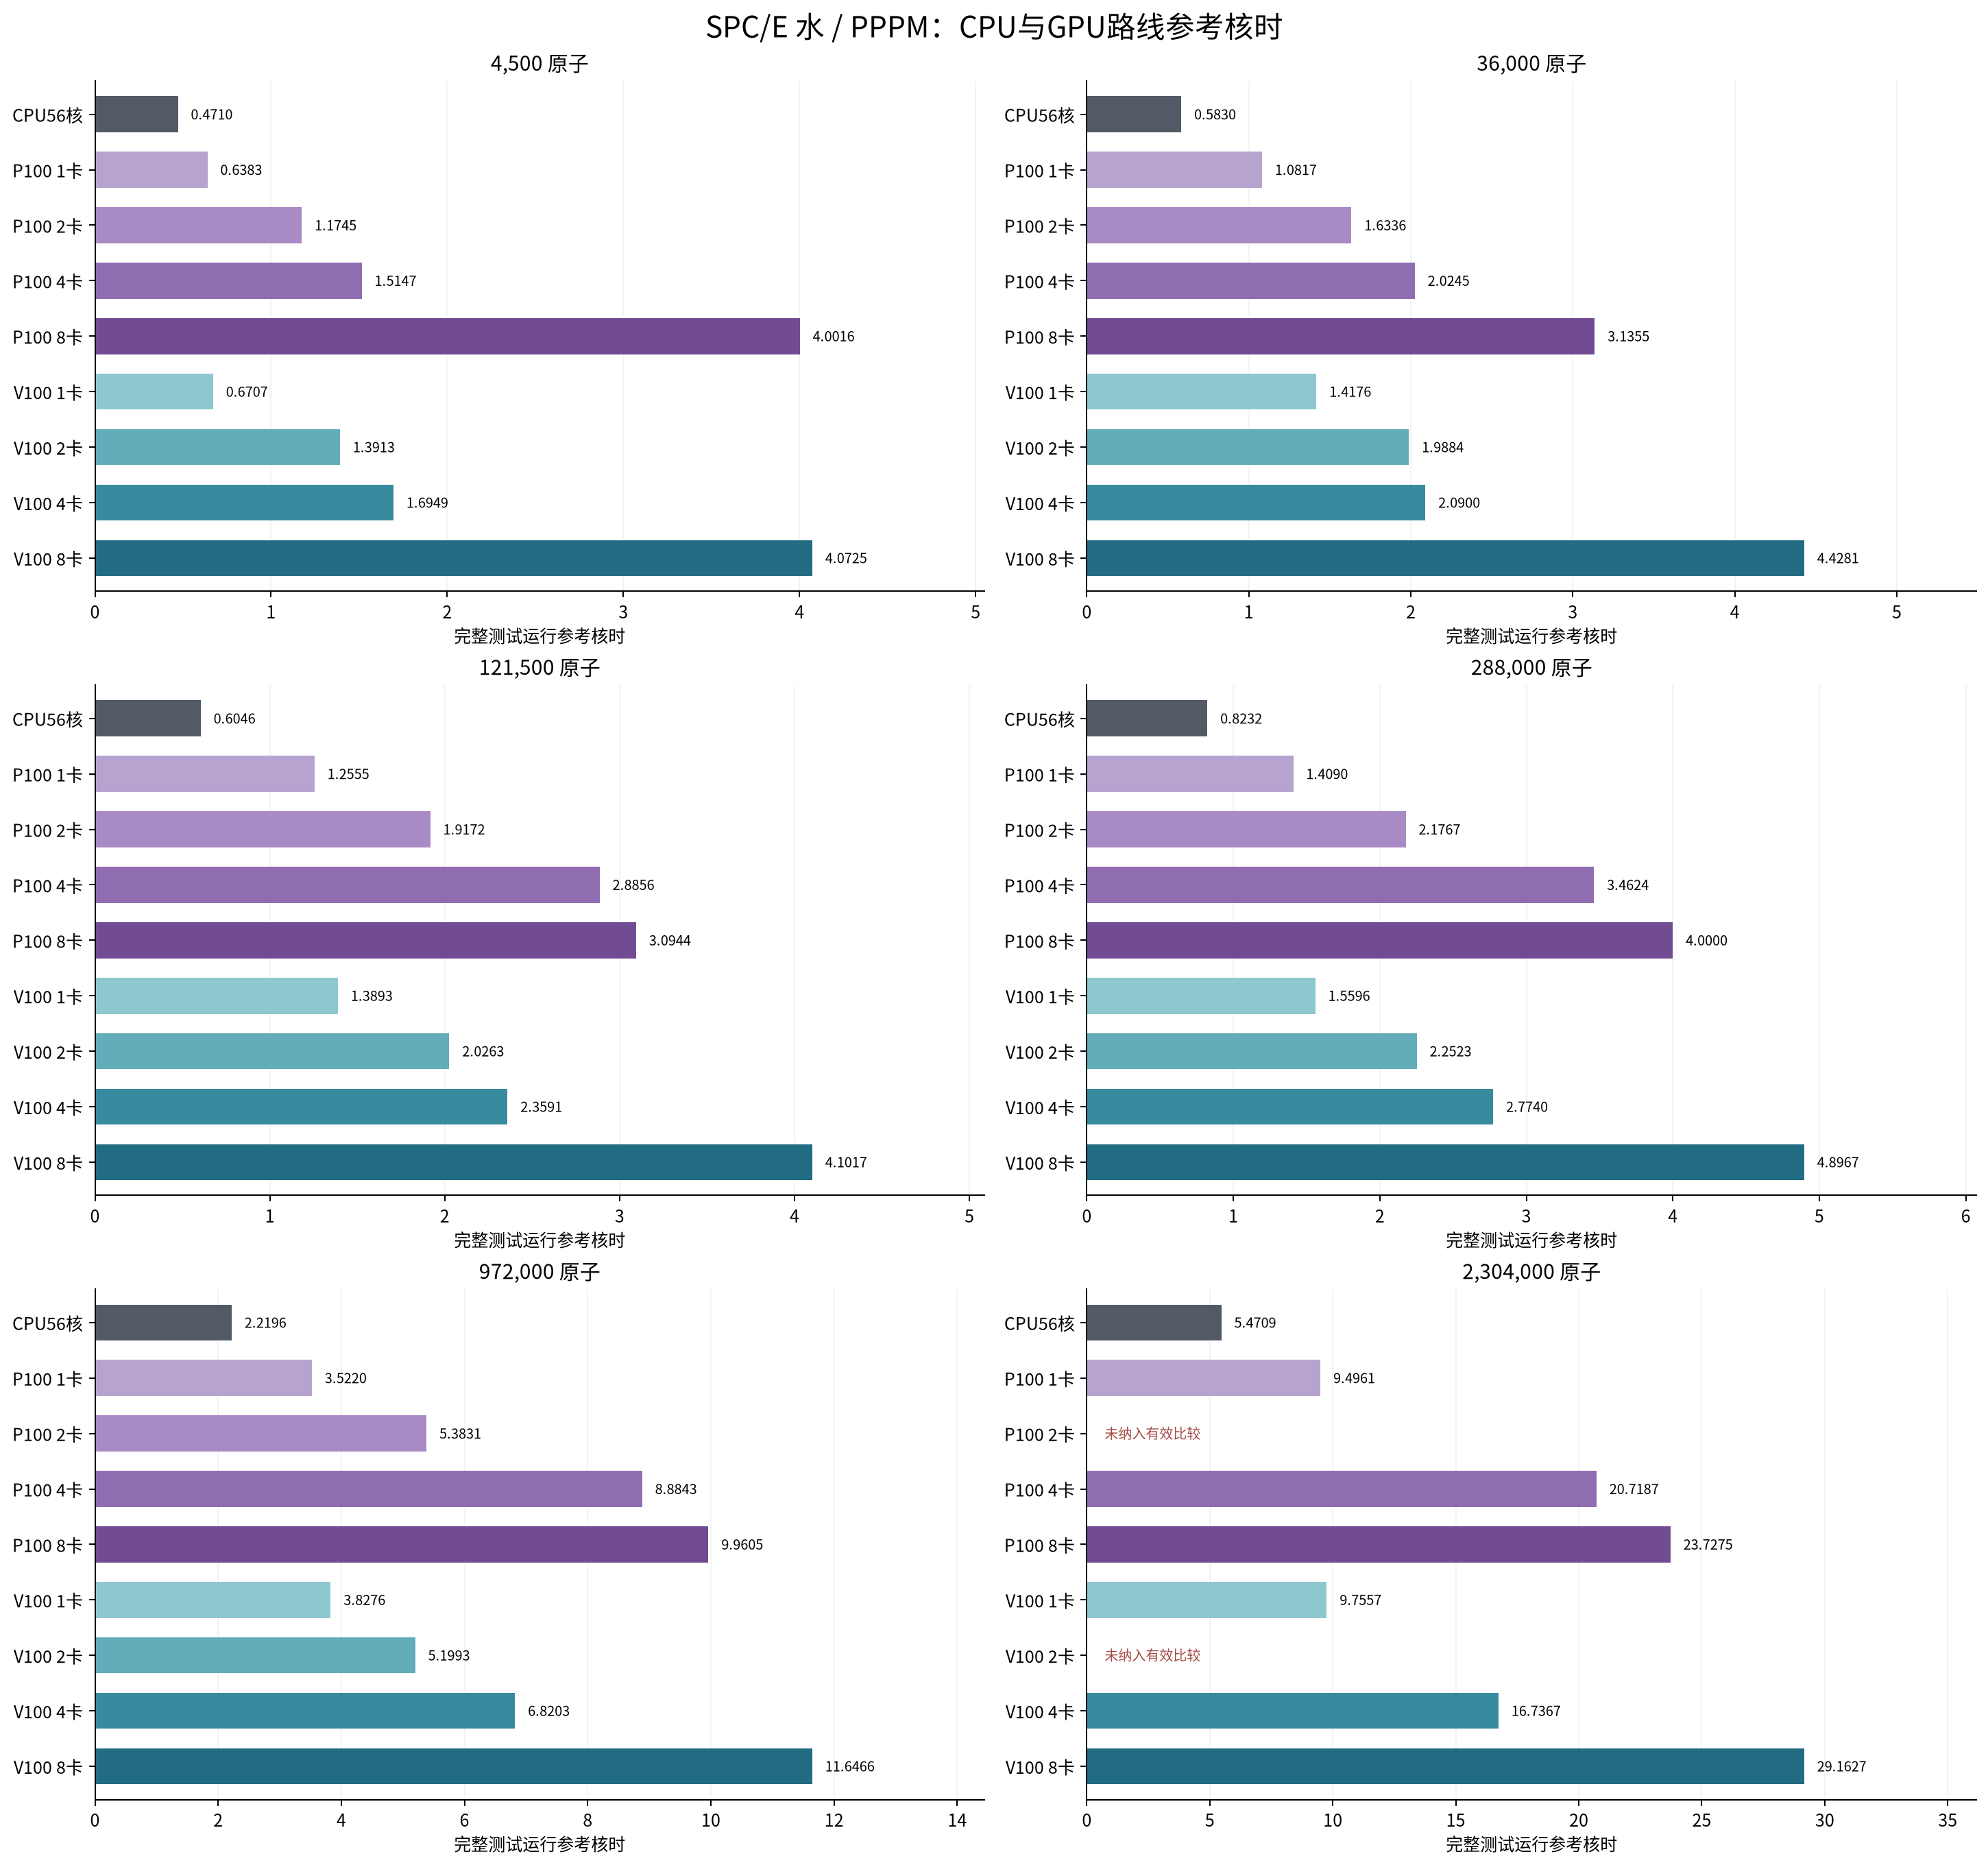
SPC/E 水 / PPPM:CPU与GPU路线参考核时
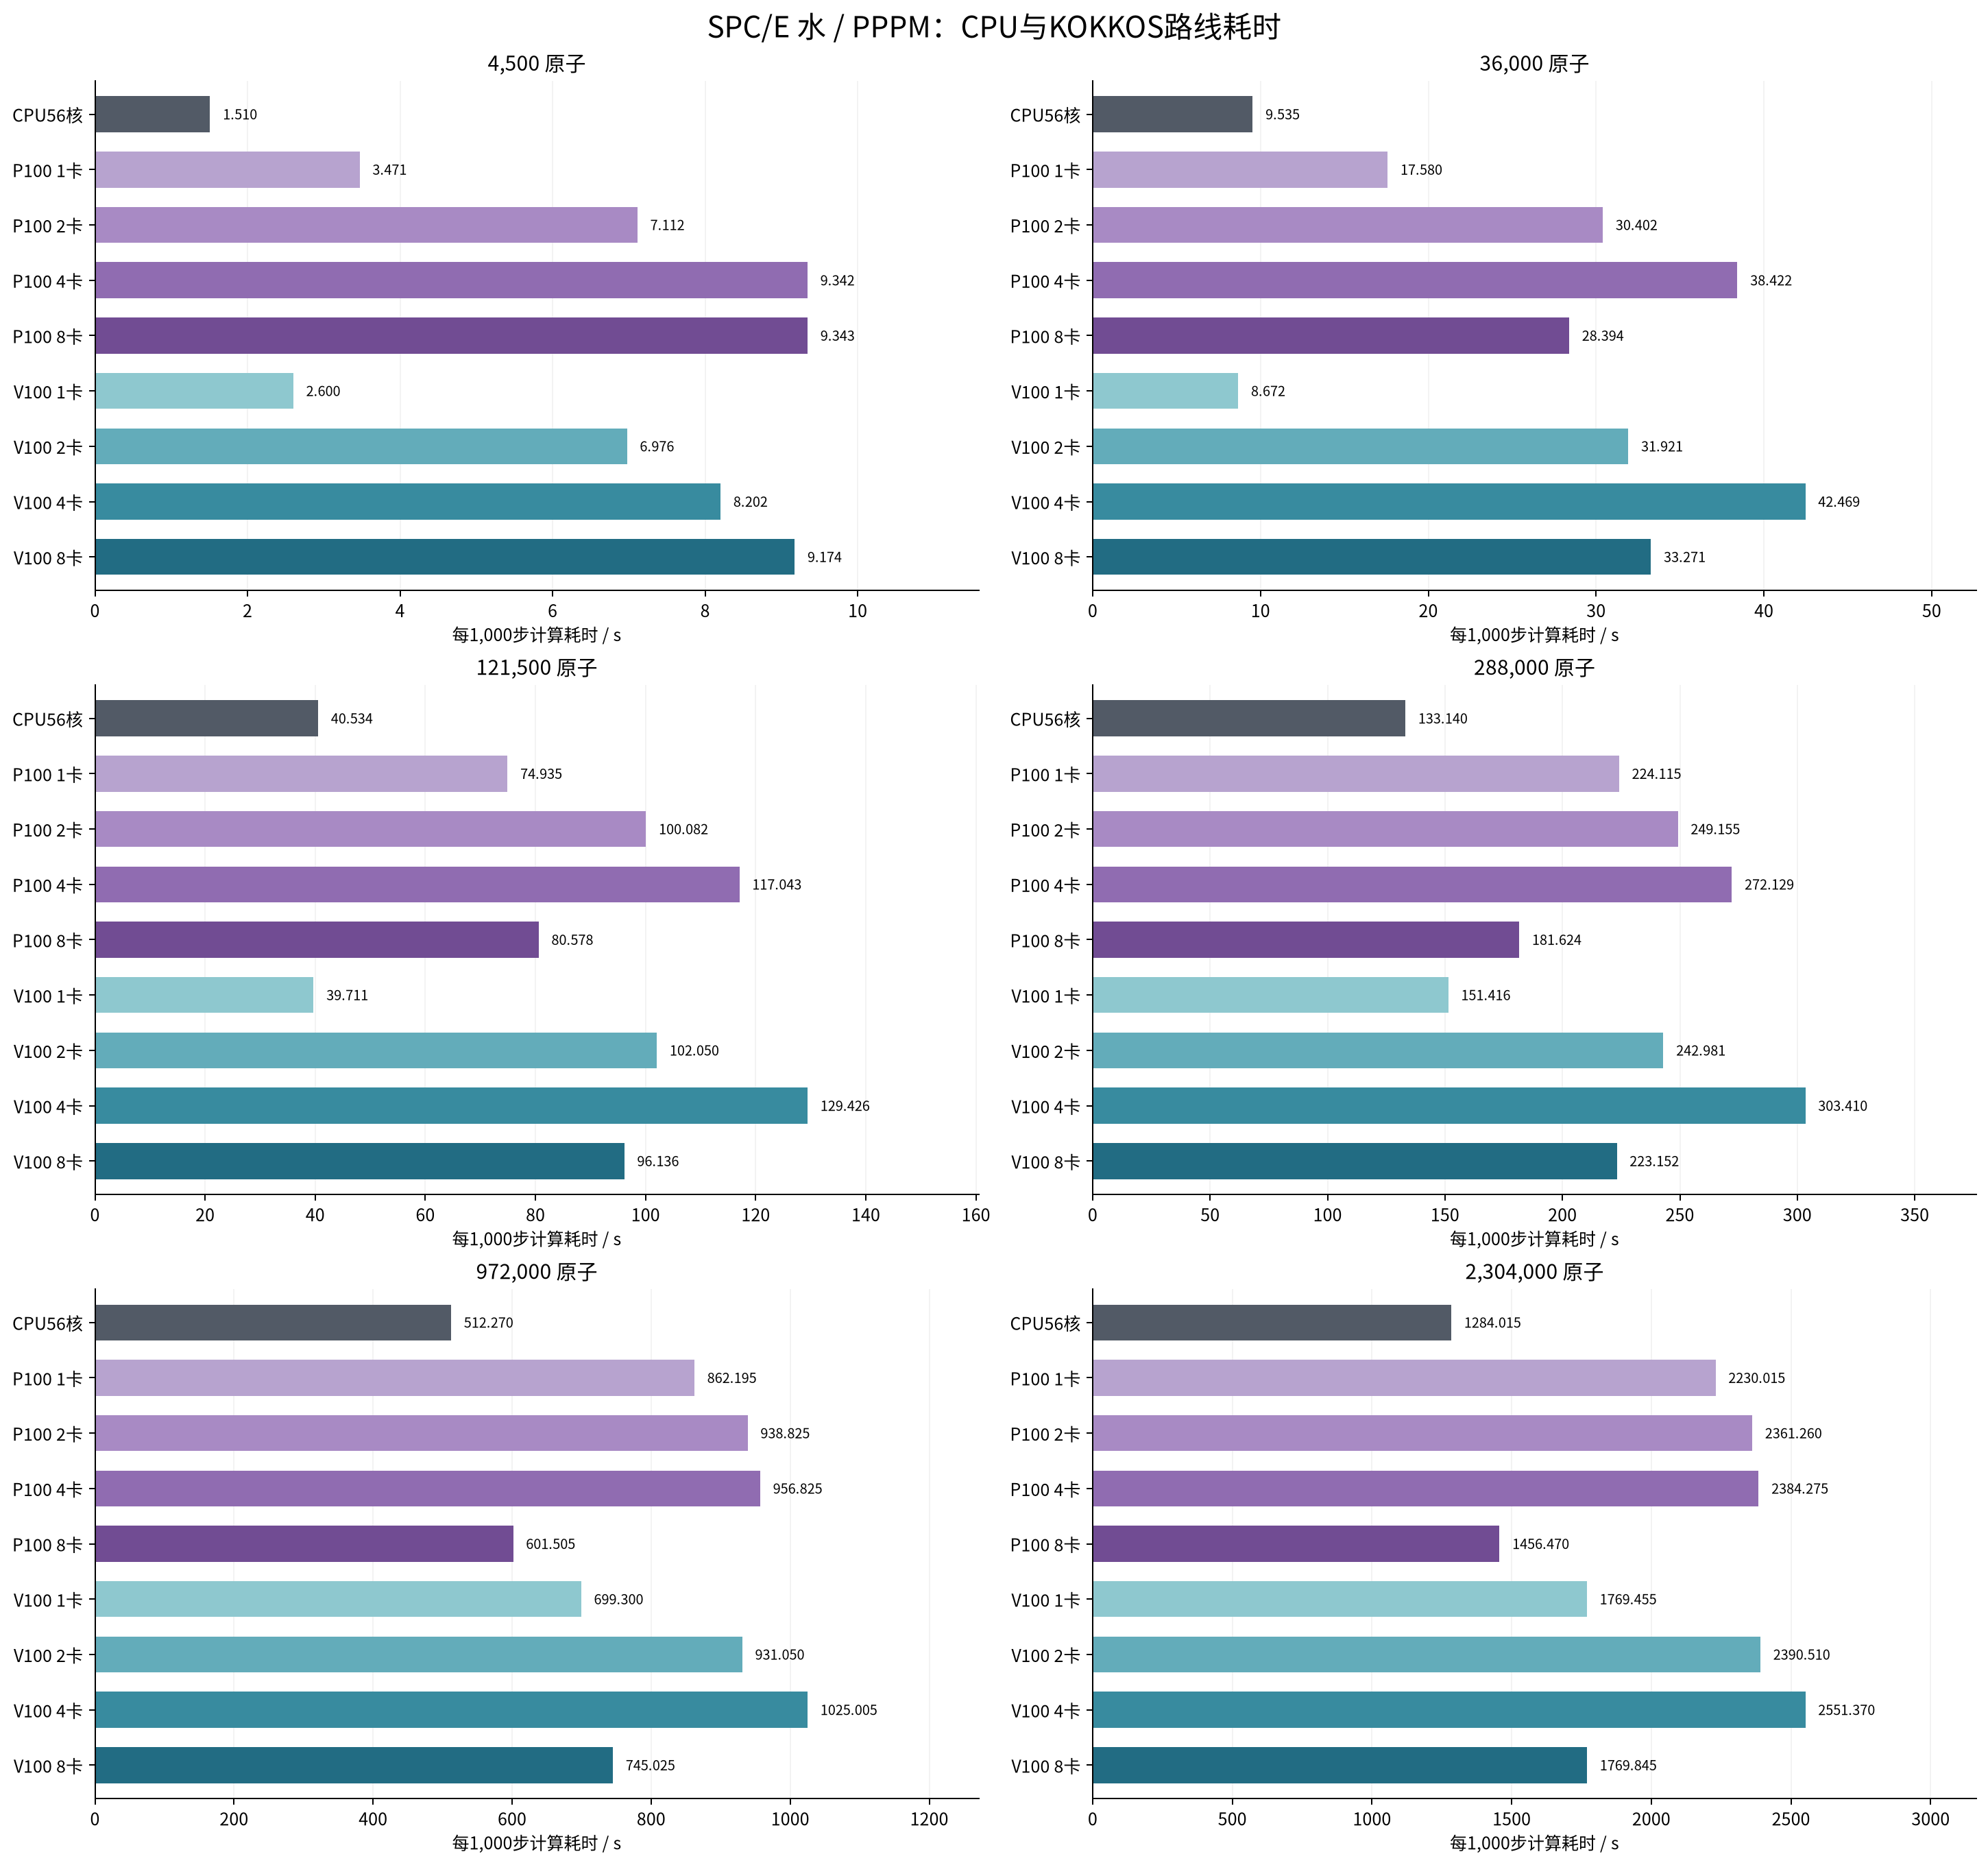
SPC/E 水 / PPPM:CPU与KOKKOS路线耗时
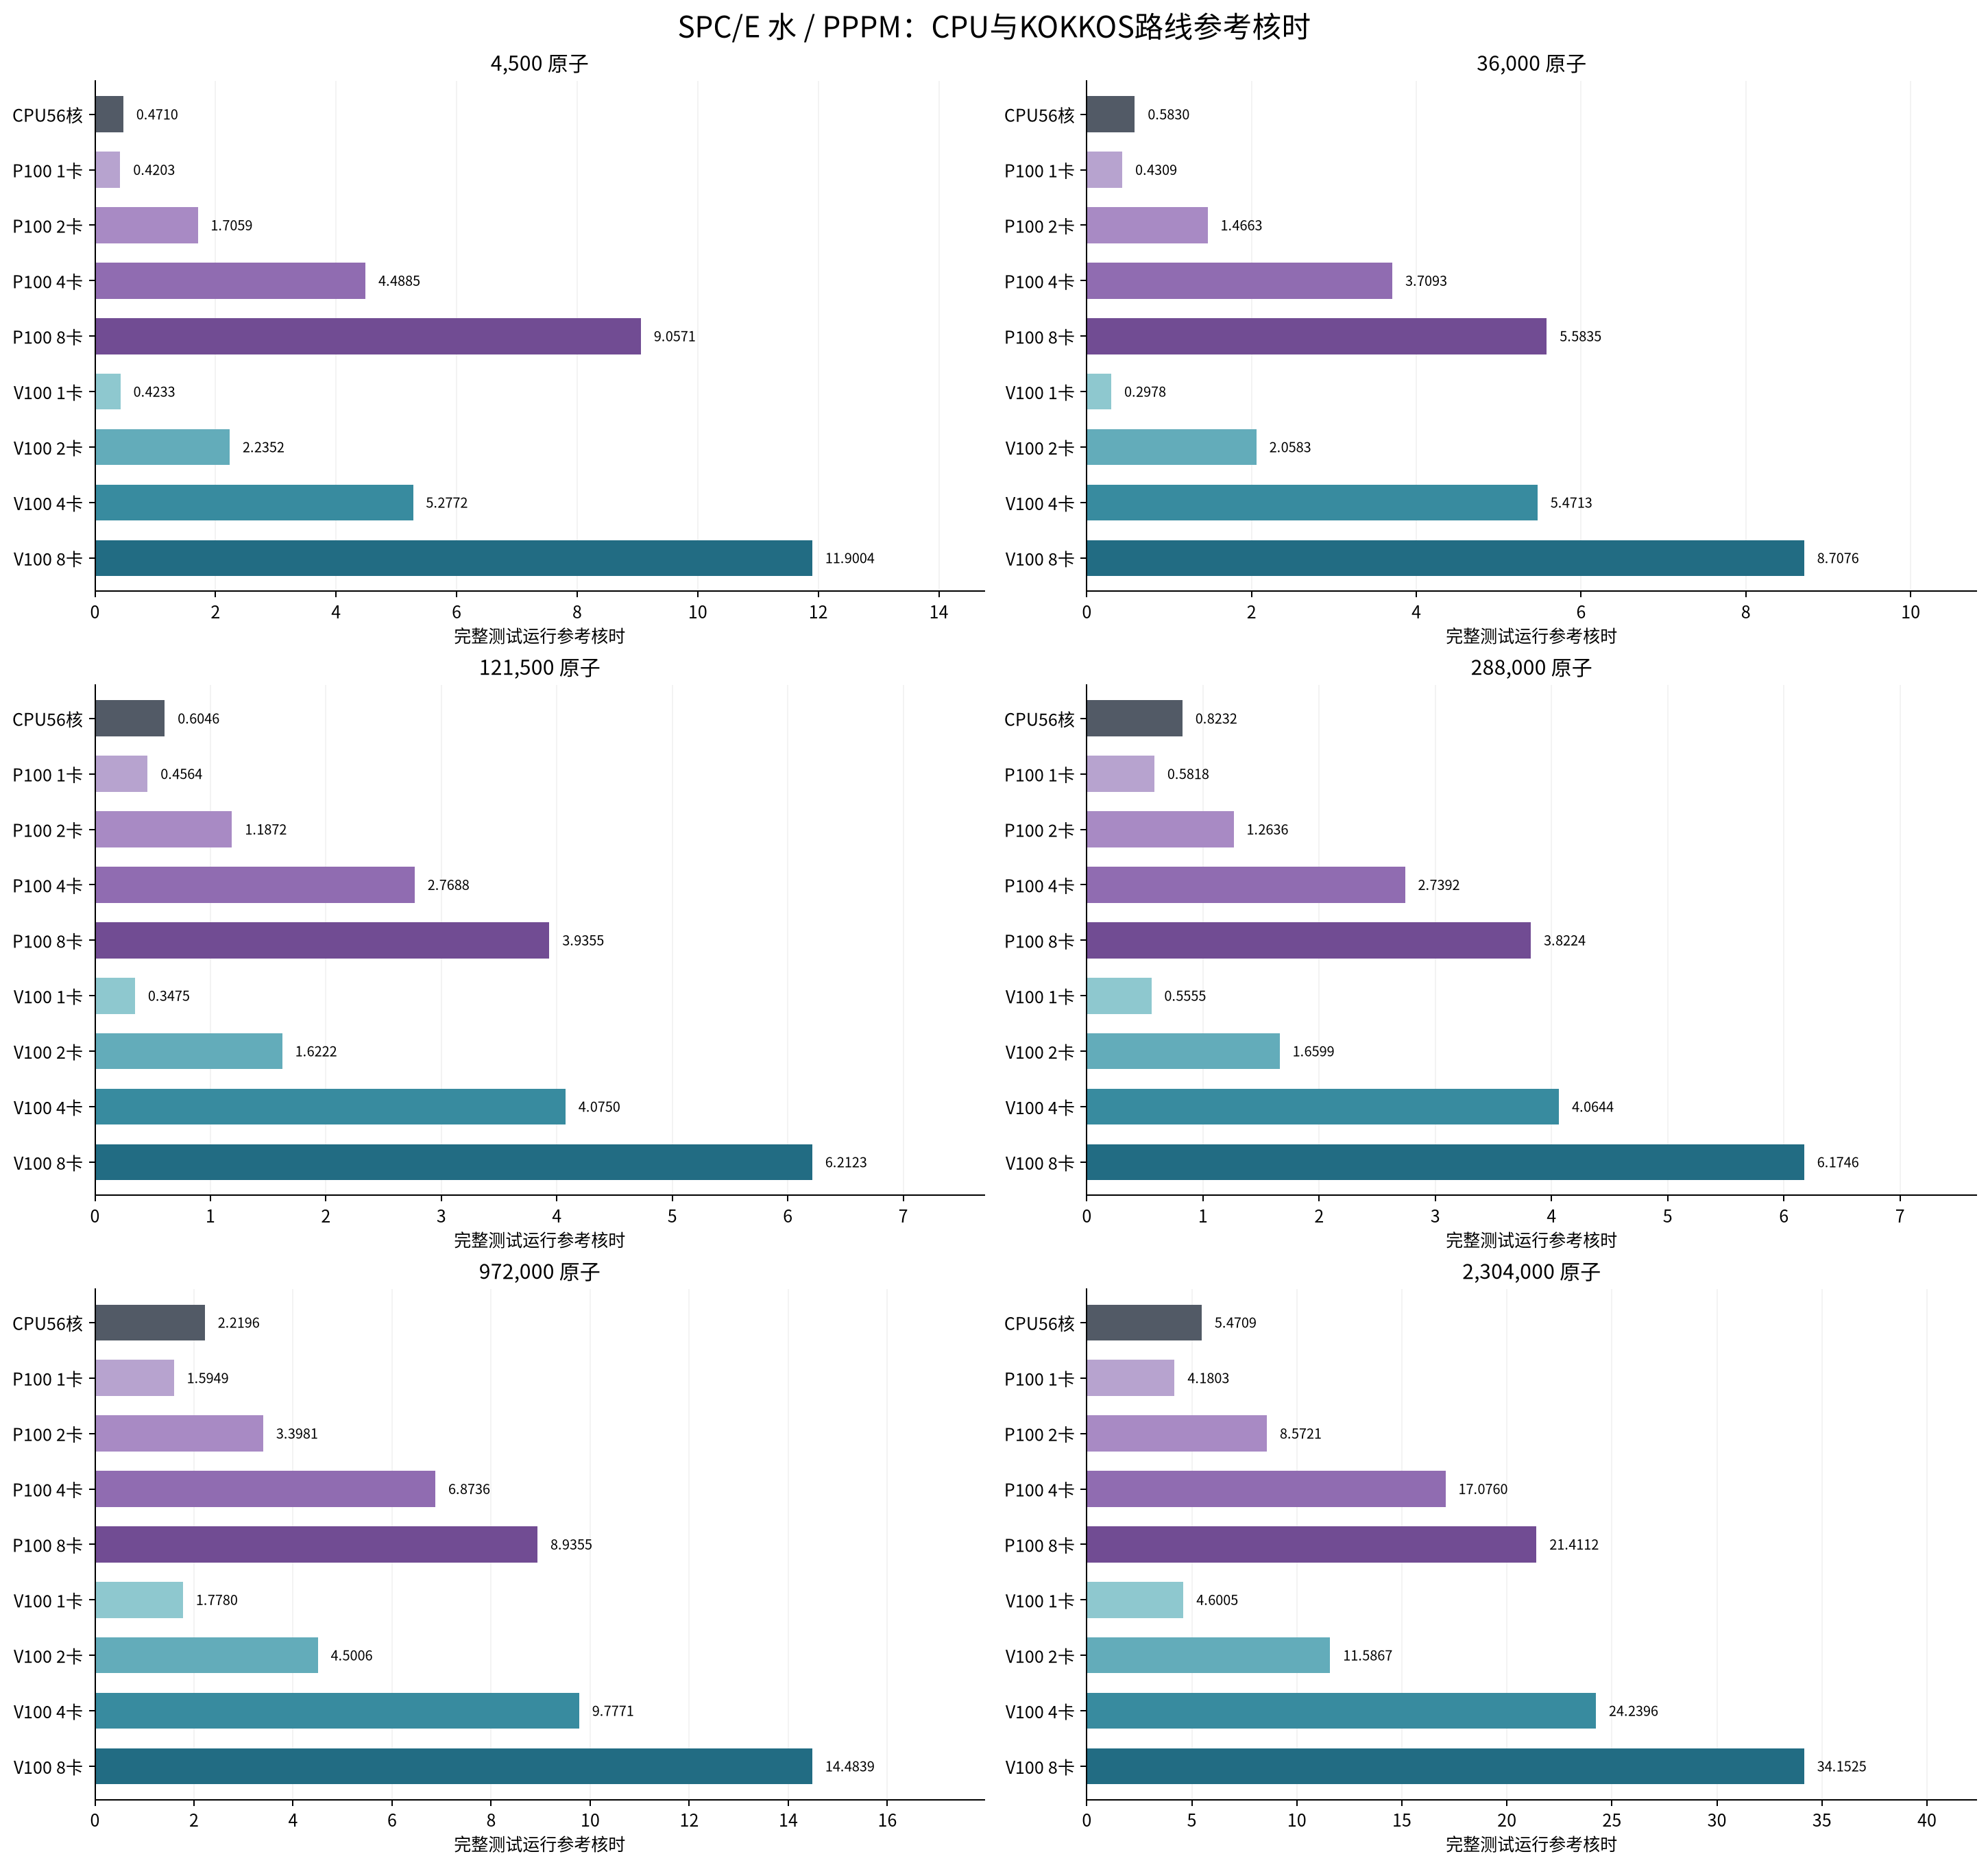
SPC/E 水 / PPPM:CPU与KOKKOS路线参考核时
费用口径与生产计算#
8173m按56核/节点,P100按24核/卡,V100 16GB按32核/卡。GPU配套CPU不额外收费,按运行秒数累计,没有最低扣费。参考核时=完整运行秒数×计费核心数÷3,600;费用区间按0.025~0.035元/核时。此次为独占节点SSH对照,展示的是参考折算,没有把它冒充实际Slurm扣费账单。
长生产任务可以用实测ns/day估算稳态计算时间,再加初始化和实际轨迹输出开销。短测预热与初始化的占比通常更大,不能将短作业的整段费用比例直接视为所有长MD的结论。这里的NVE、输出频率、势、截断和密度都是测试条件,用户生产任务应保持自己的科学精度和所需系综。
本轮根据实际吞吐量校准步数。水的GPU包慢路径与KOKKOS快路径差距较大时,对整个资源组统一控制步数预算,不只缩短某个资源的工作量。最快配置未必都能达到30秒目标,具体步数、实际时间和每1,000步归一值均在CSV中,不把较短样本的小差异当作稳定优势。
相同1ns生产长度的核时预算外推#
上面的完整短测核时包含预热,且不同规模的校准步数不同。下面另将每个规模外推到相同的1ns,以便比较长任务预算:Cu/Si为100万步,水为50万步。估算时间=本次完整墙钟时间-本次正式Loop time+实测每步时间×1ns所需步数;保留本次实测的初始化与预热开销,仅替换正式段长度,再乘相应计费核心数。预算费用可将图中核时乘以0.025~0.035元,本页下载CSV已按当前0.025与0.035两个端点重新计算费用派生列,原始计时与参考核时保持不变。
这是沿用本轮结构、固定体积NVE、输出频率与分解的吞吐量外推,没有真正运行1ns,也不是实付账单。实际生产的轨迹输出、分析、不同系综、密度变化或长时负载不均都可能改变耗时;水与固体的不同势不能仅凭1ns时间互相比算法优劣。
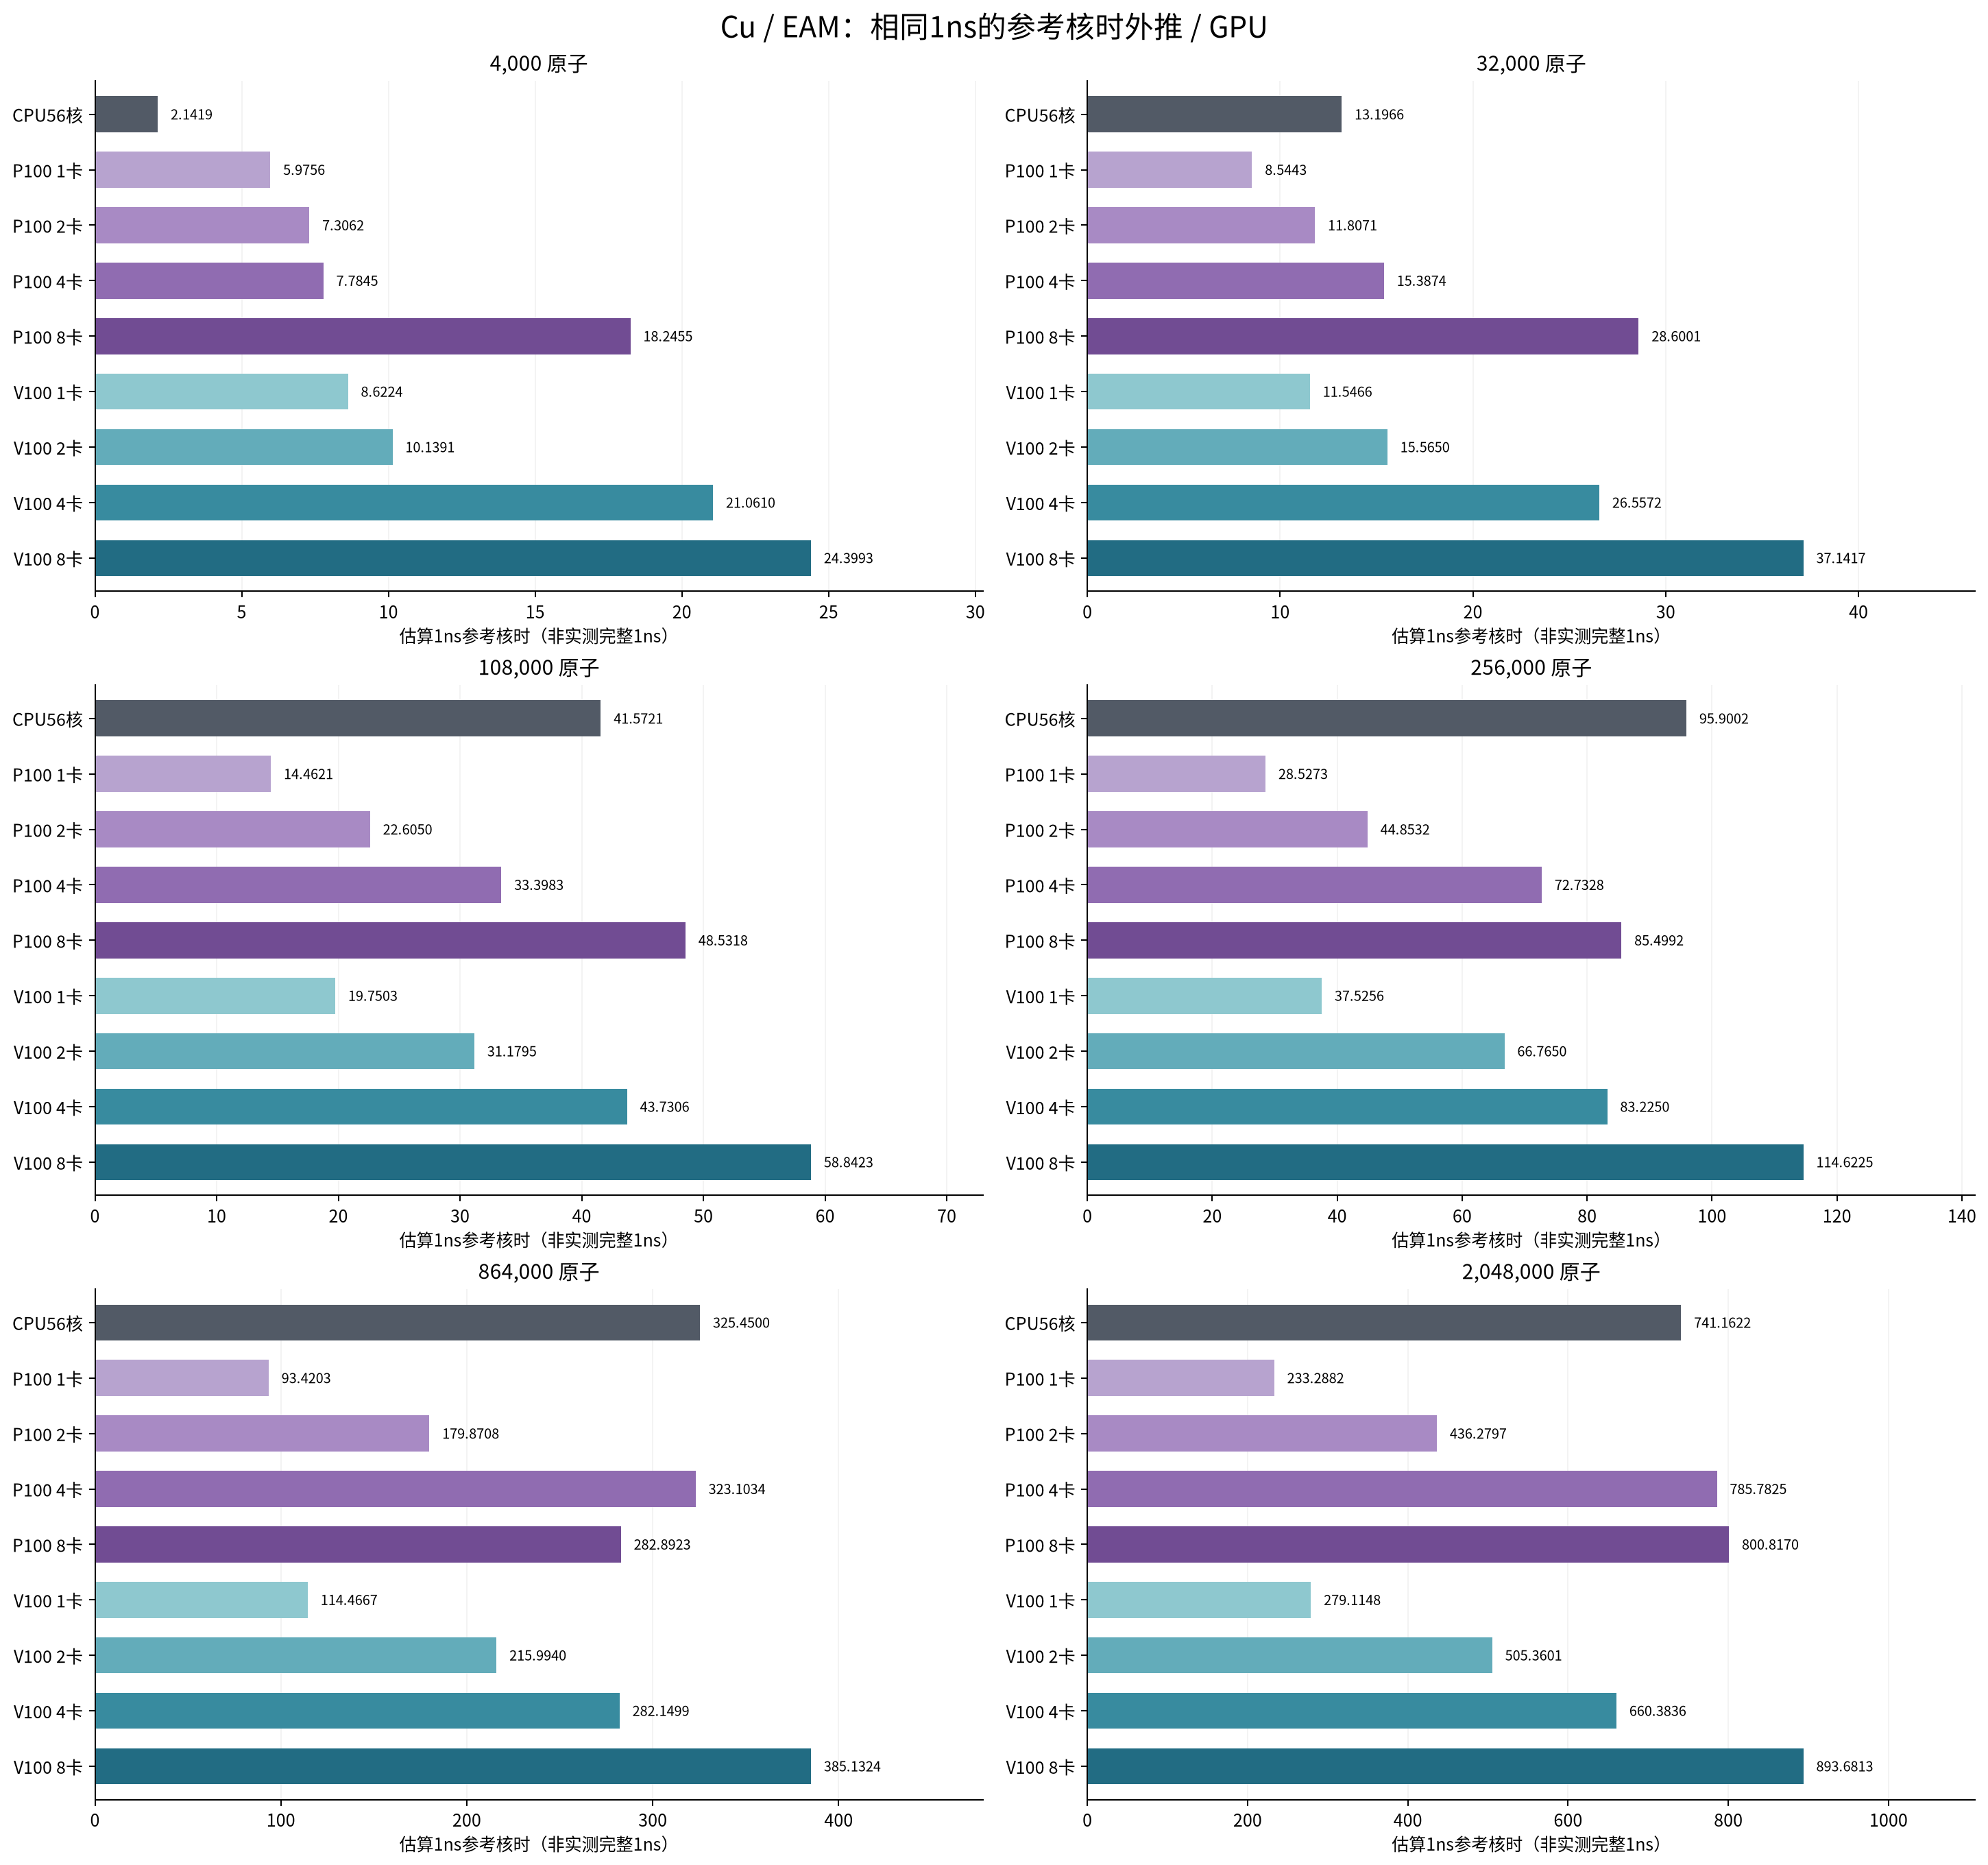
Cu / EAM:相同1ns的参考核时外推 / GPU
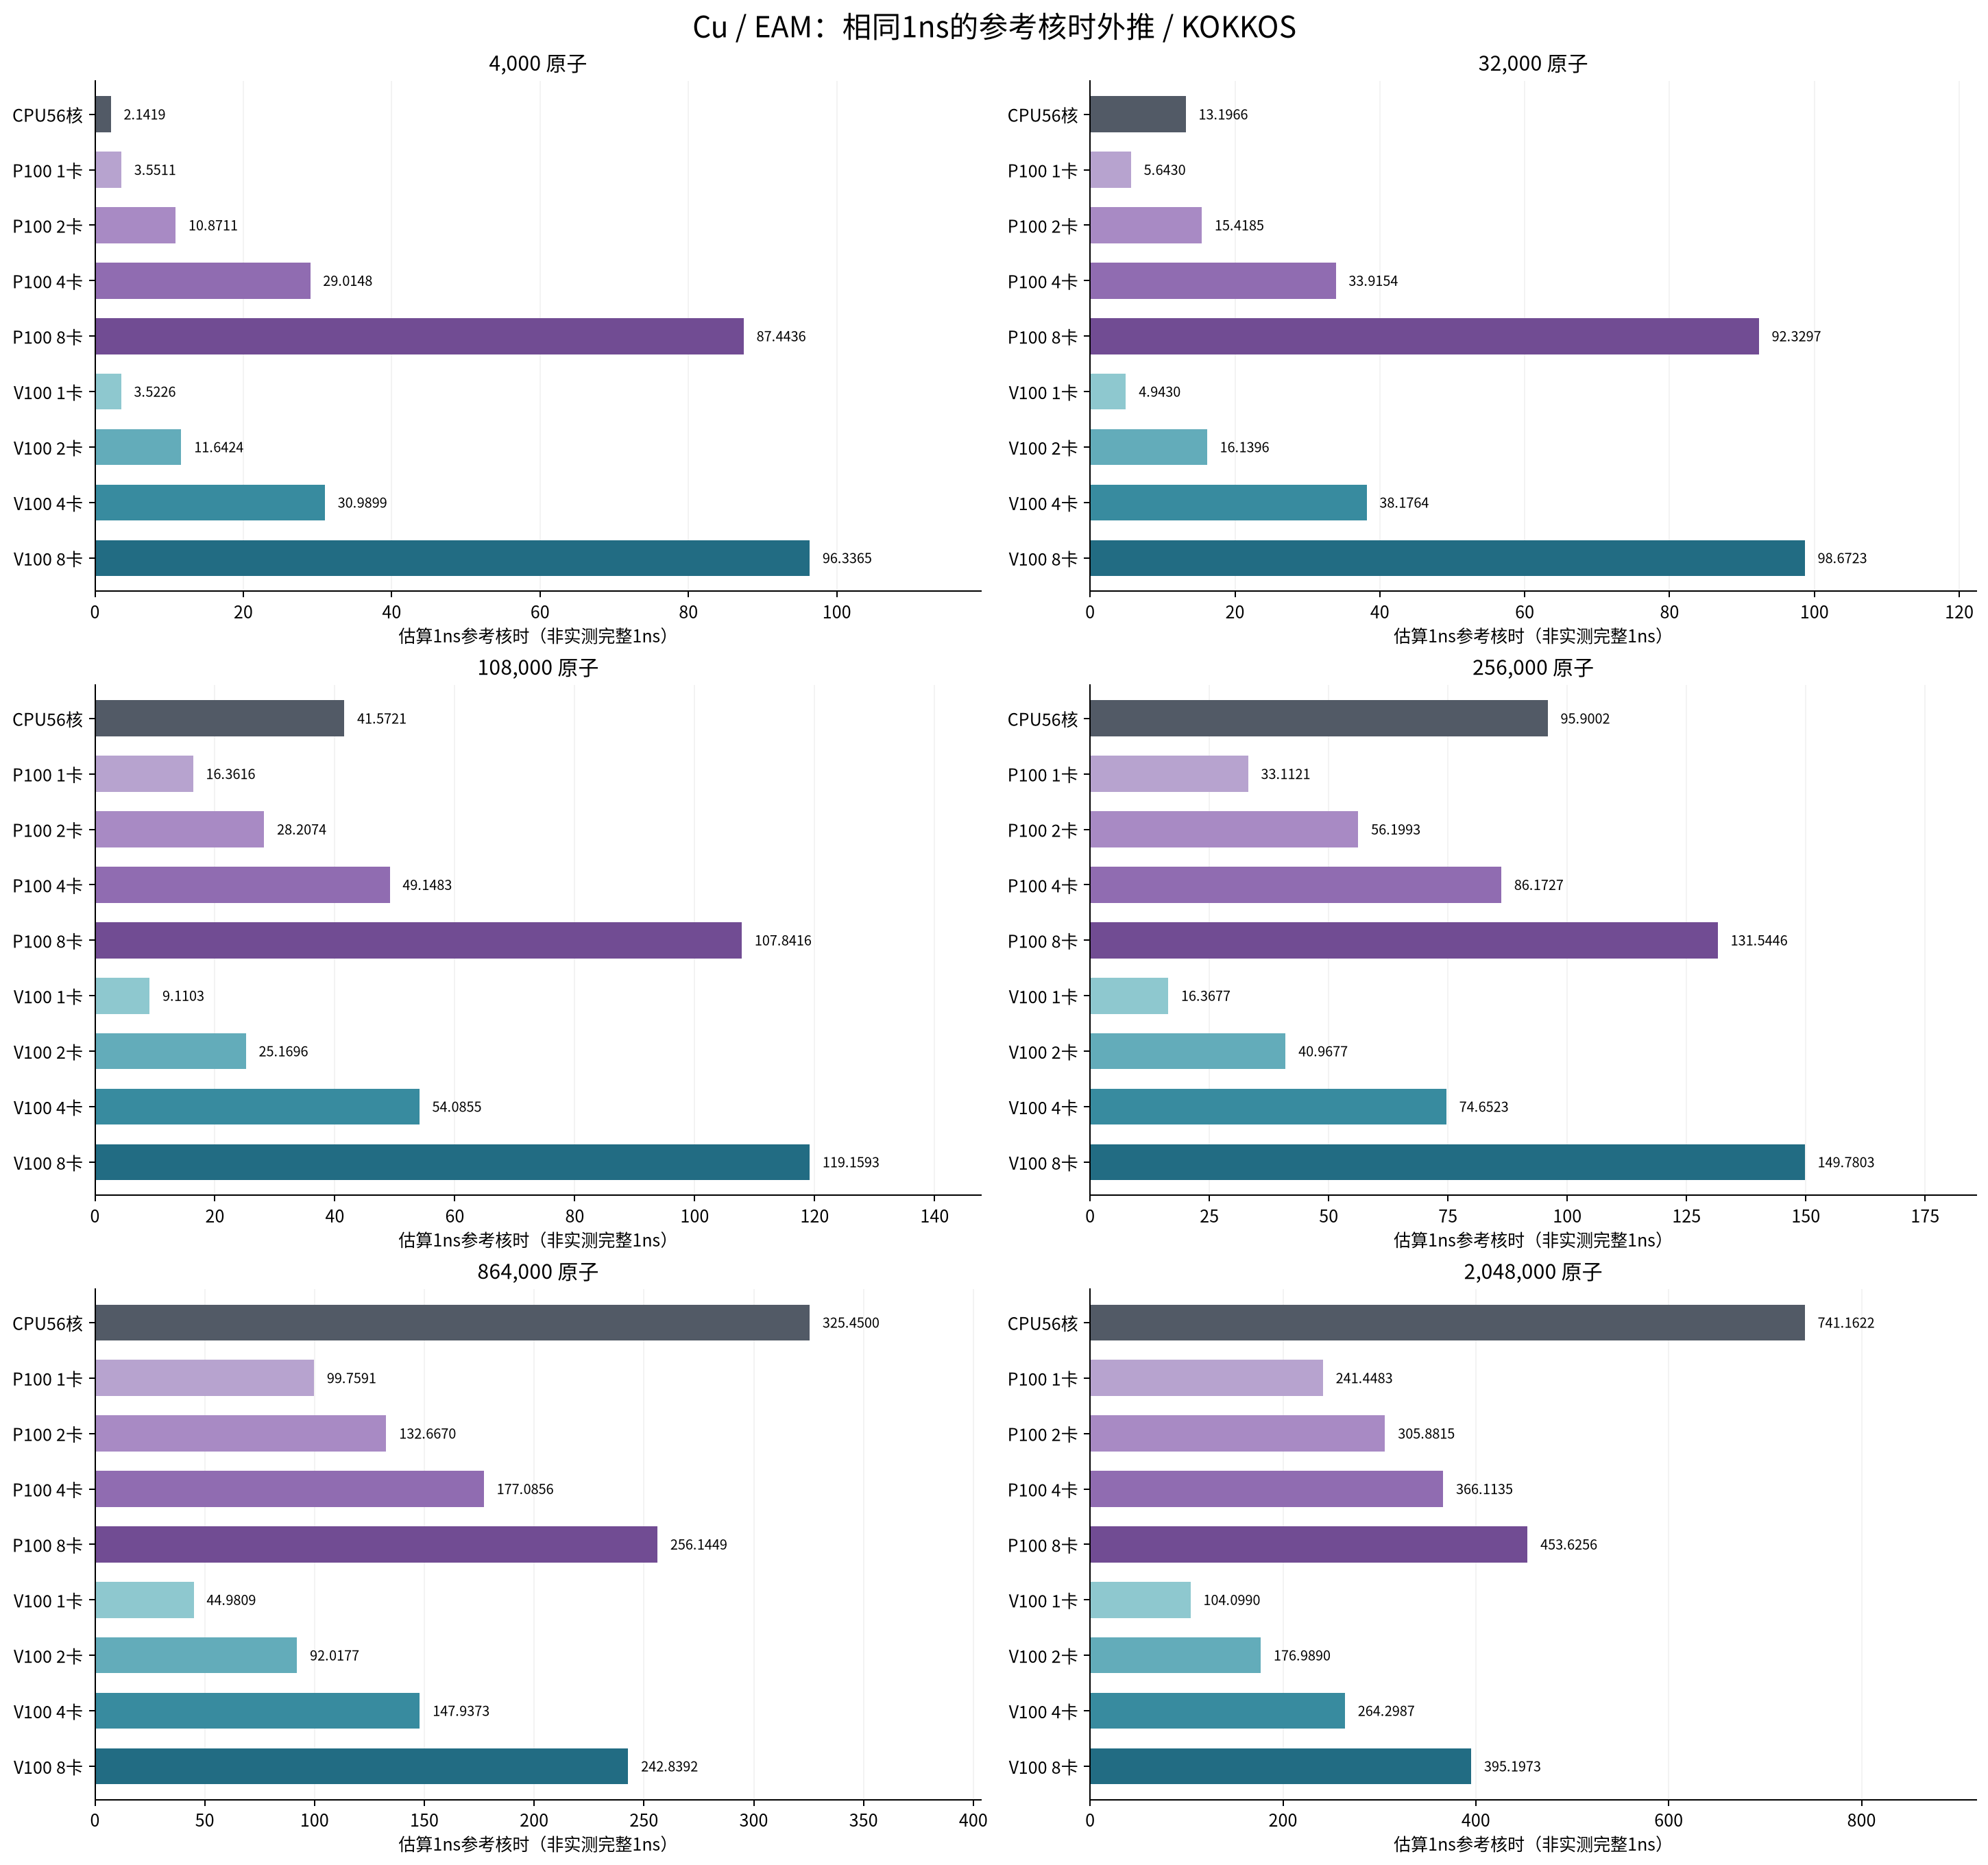
Cu / EAM:相同1ns的参考核时外推 / KOKKOS
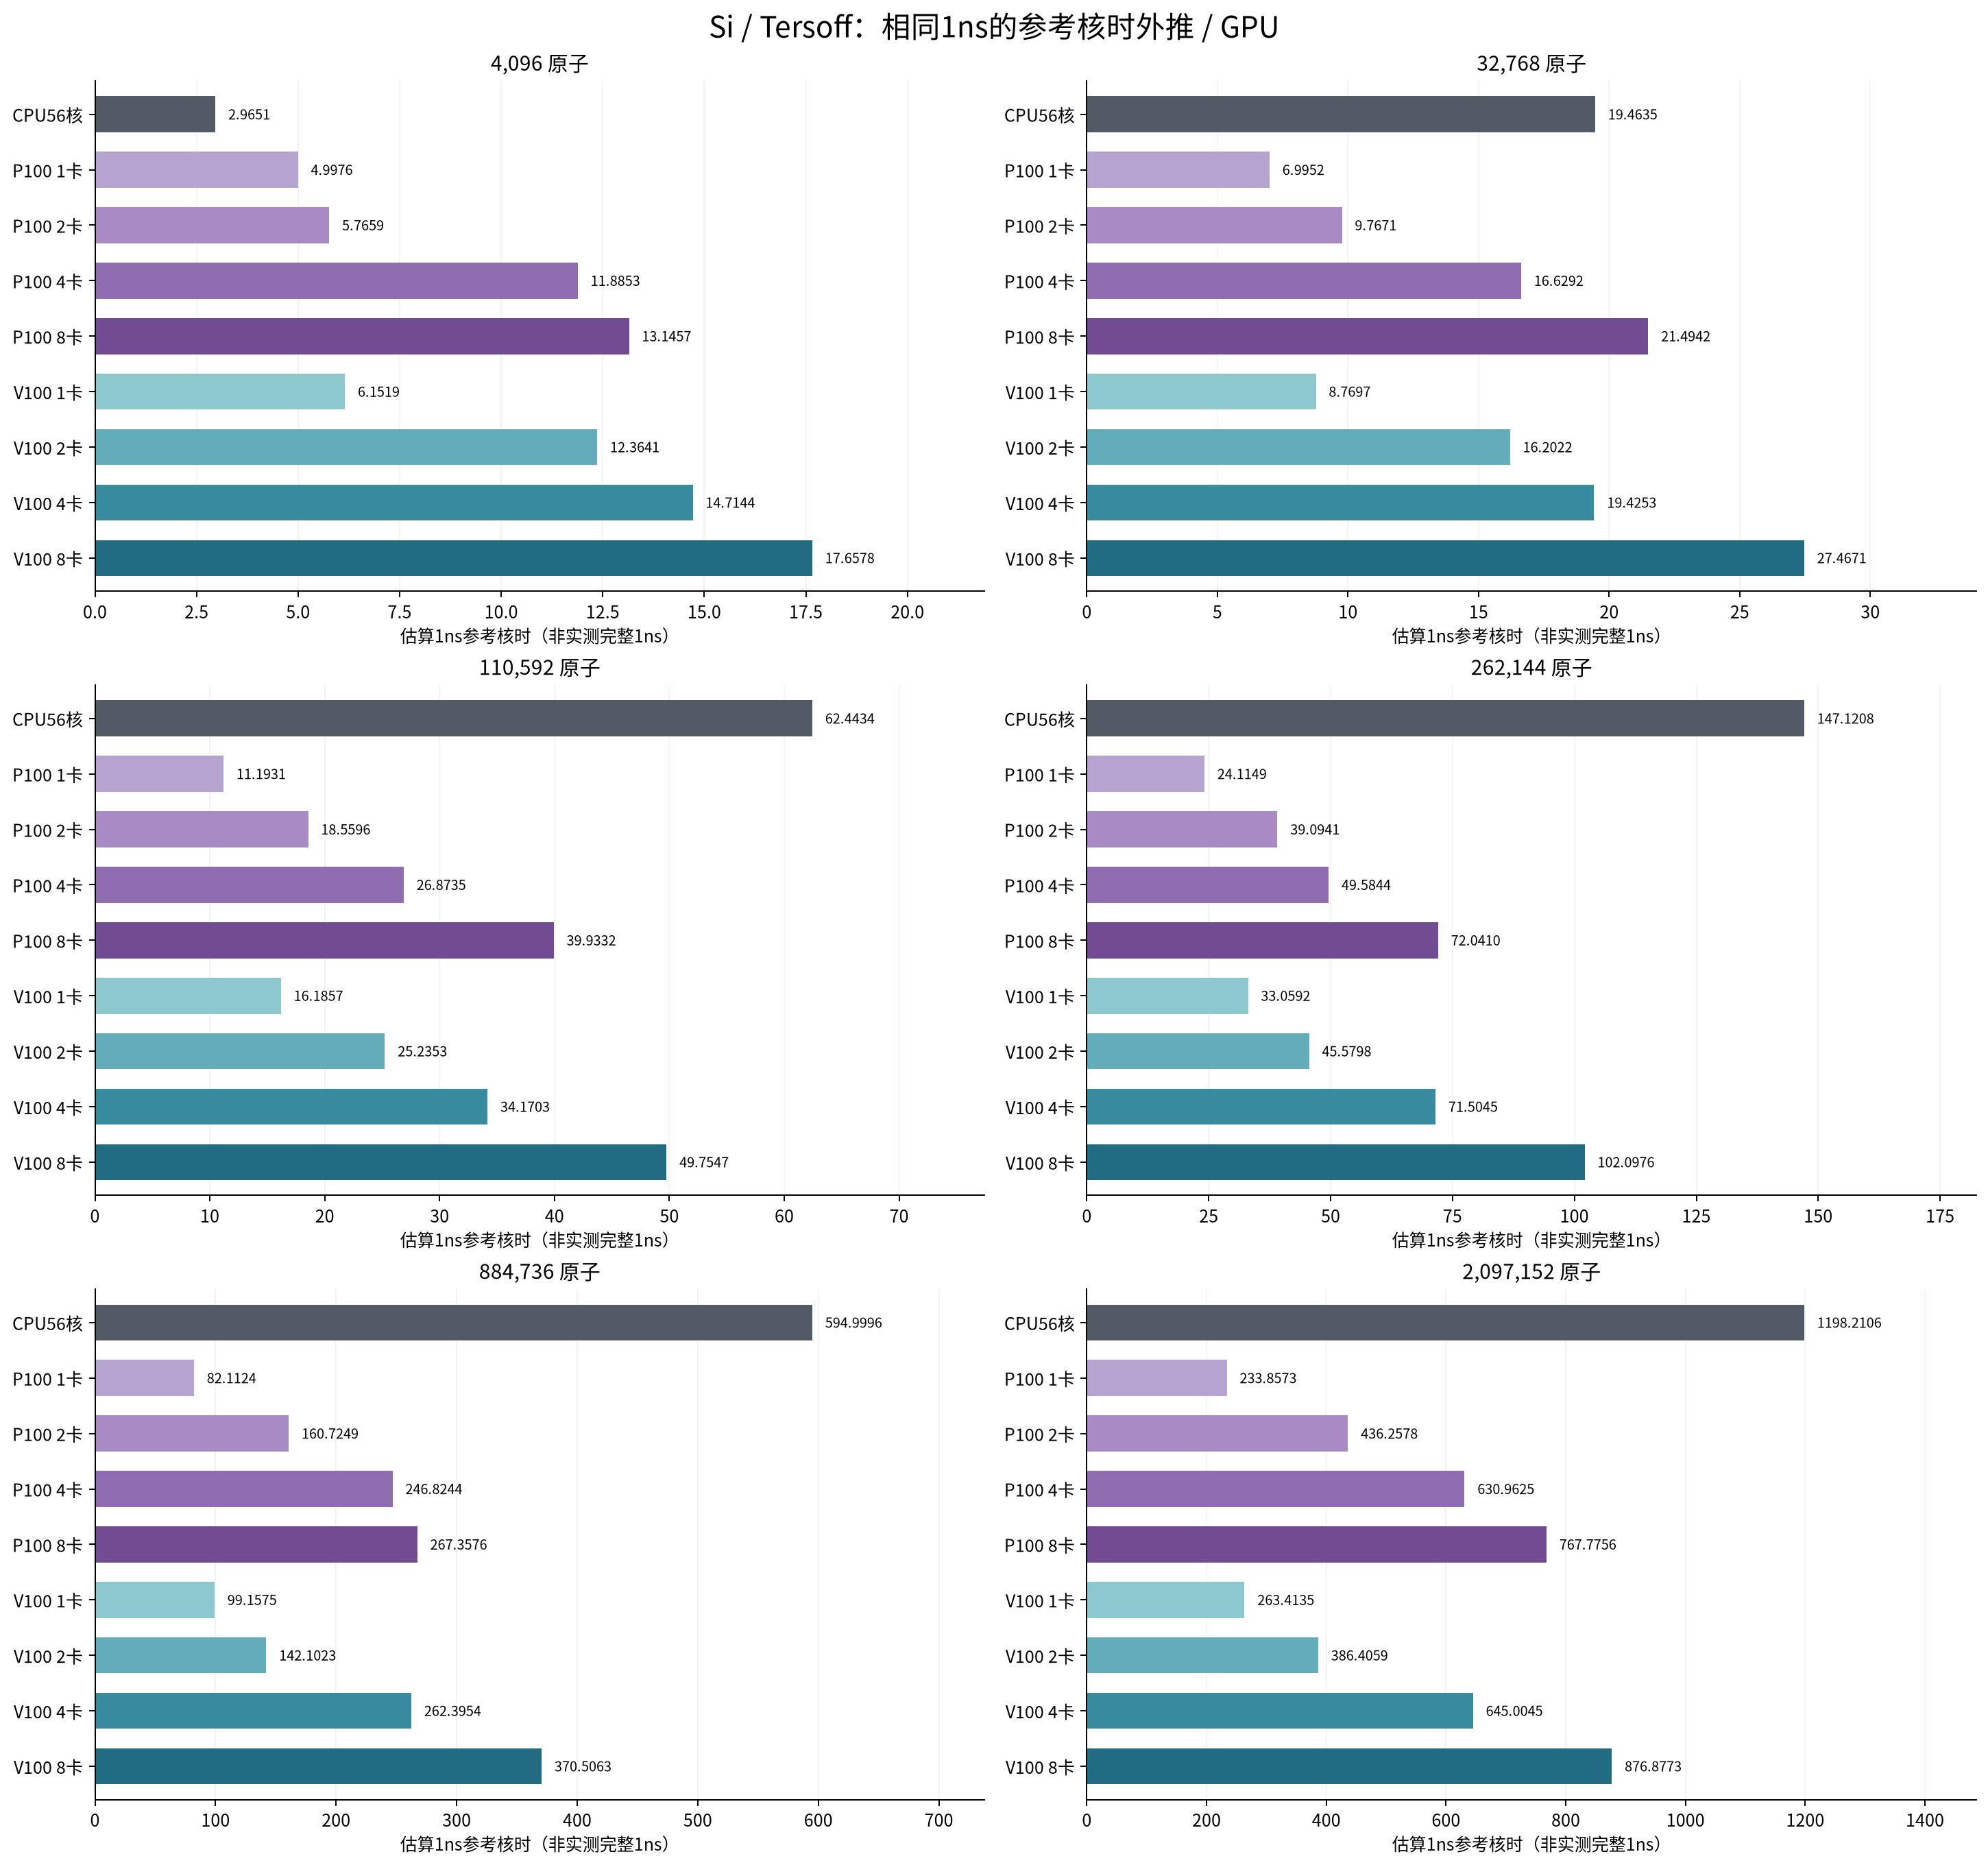
Si / Tersoff:相同1ns的参考核时外推 / GPU
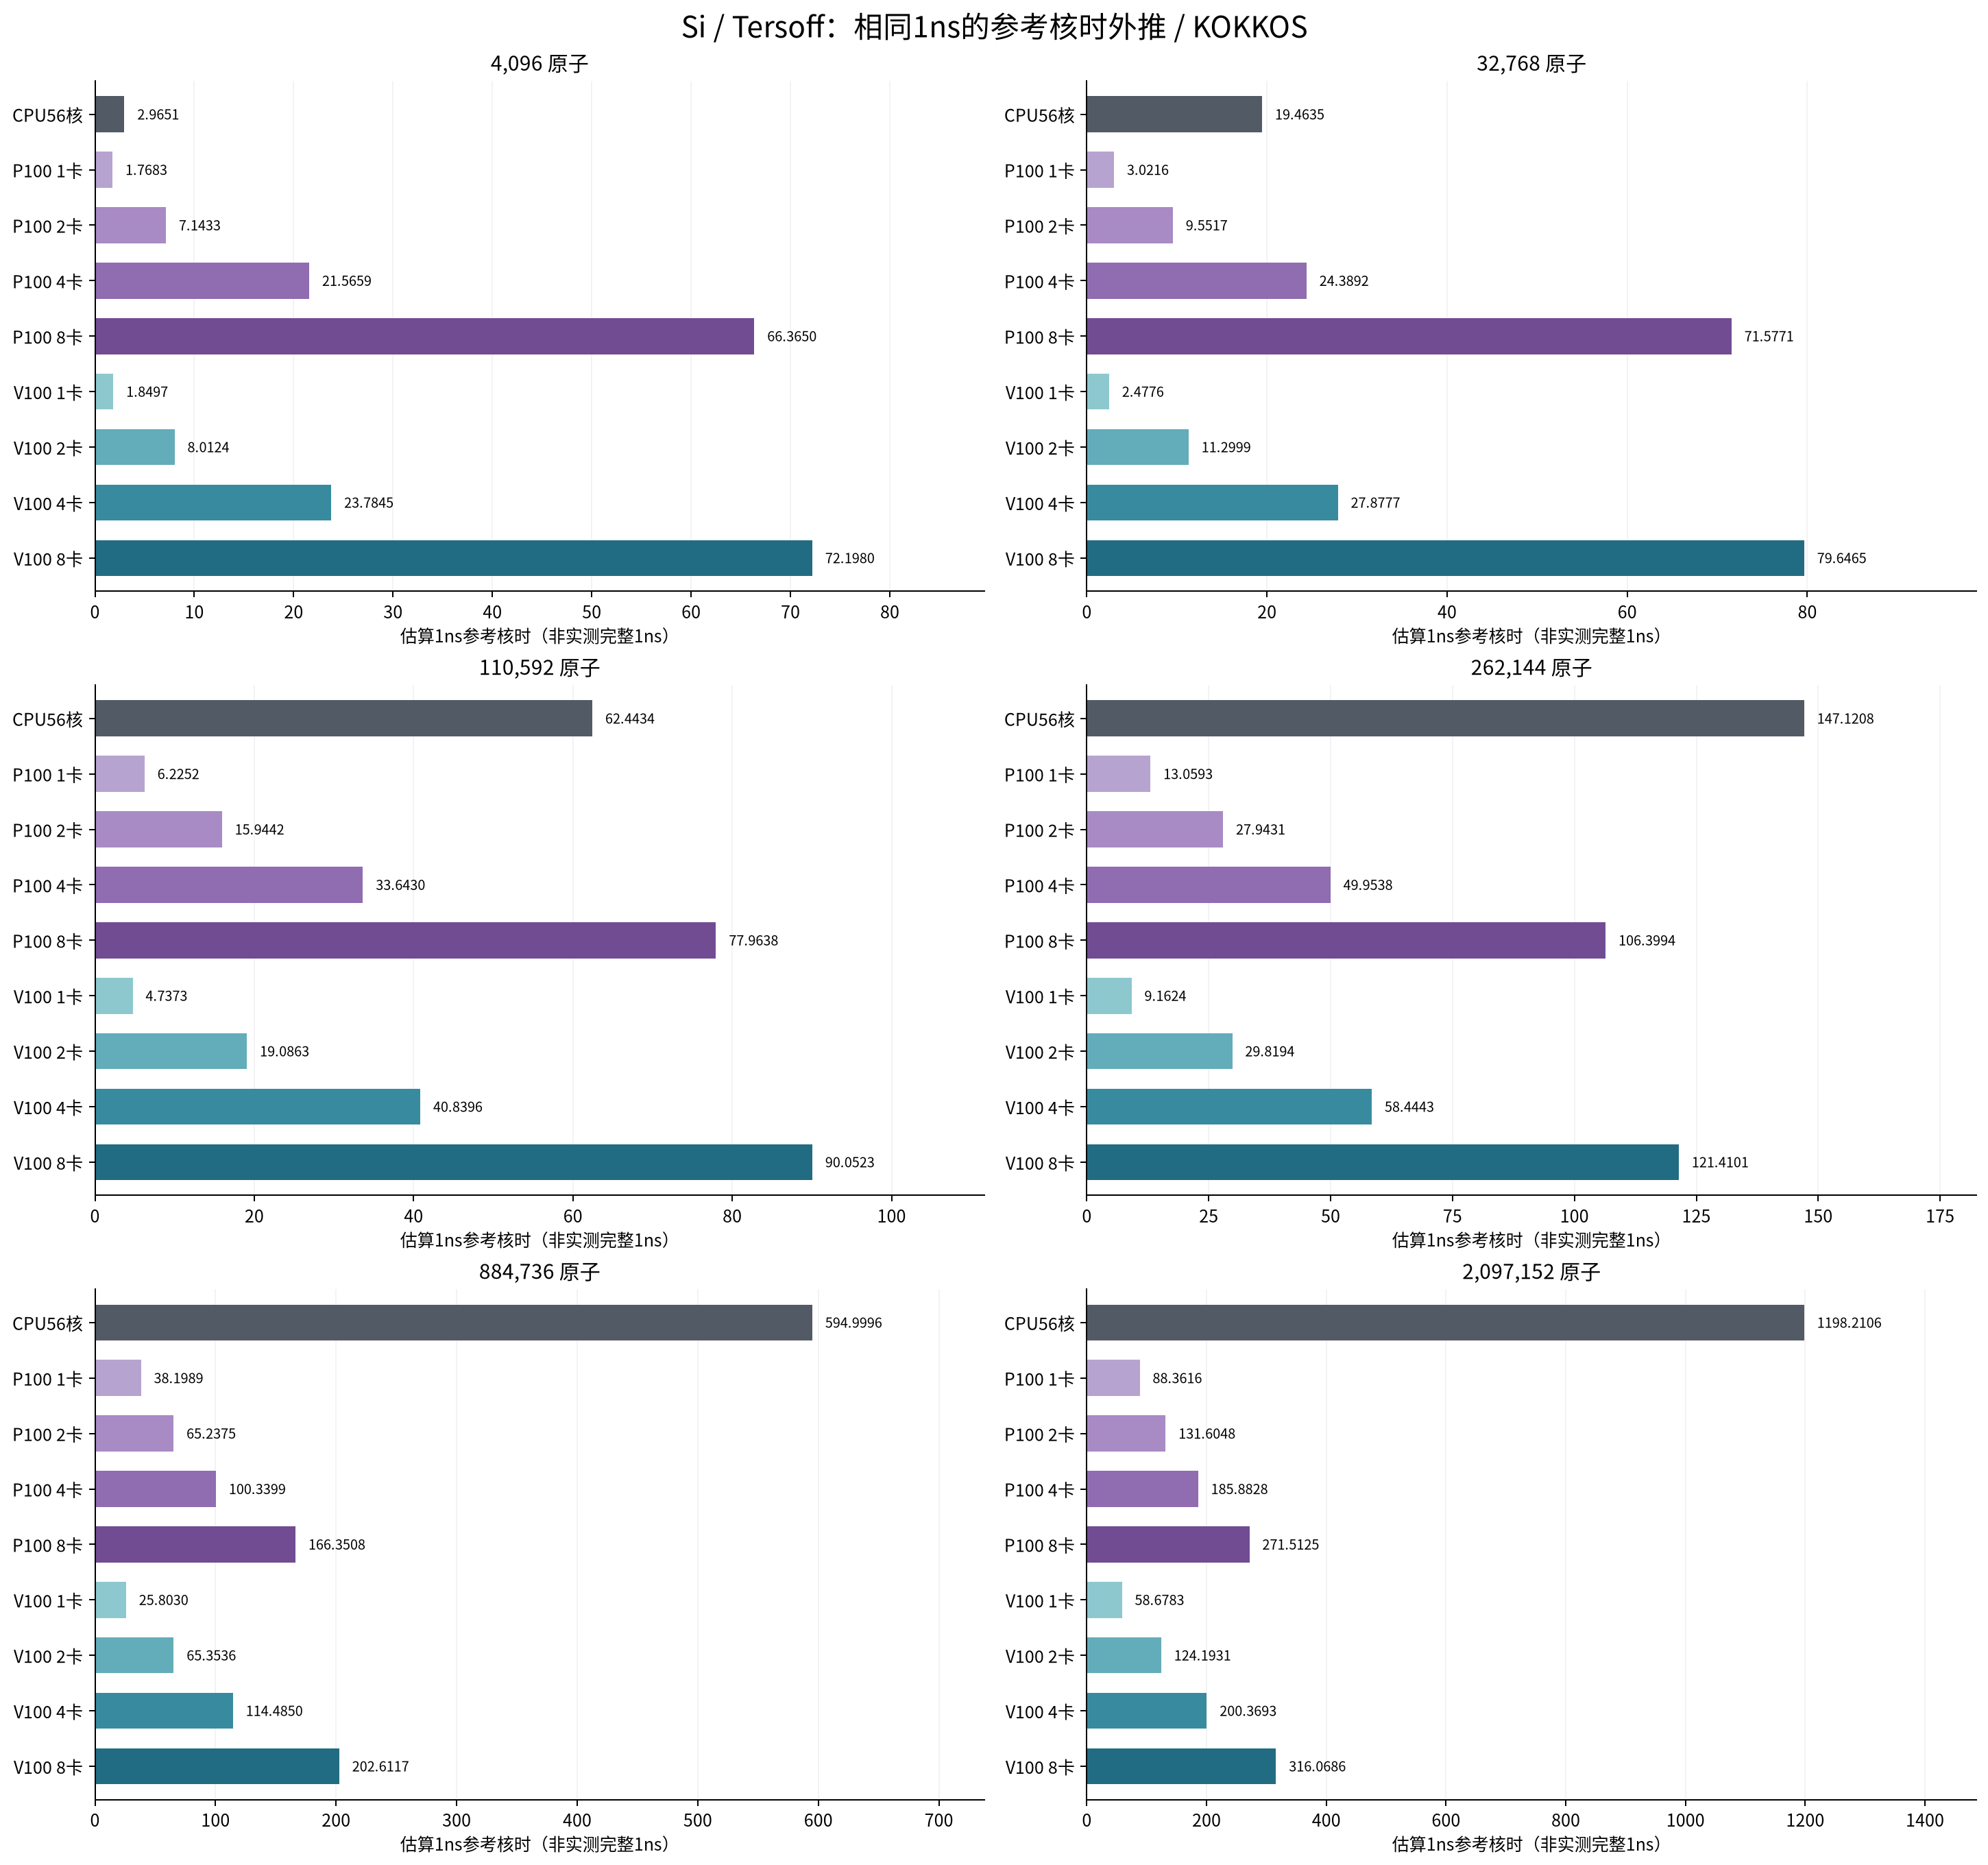
Si / Tersoff:相同1ns的参考核时外推 / KOKKOS
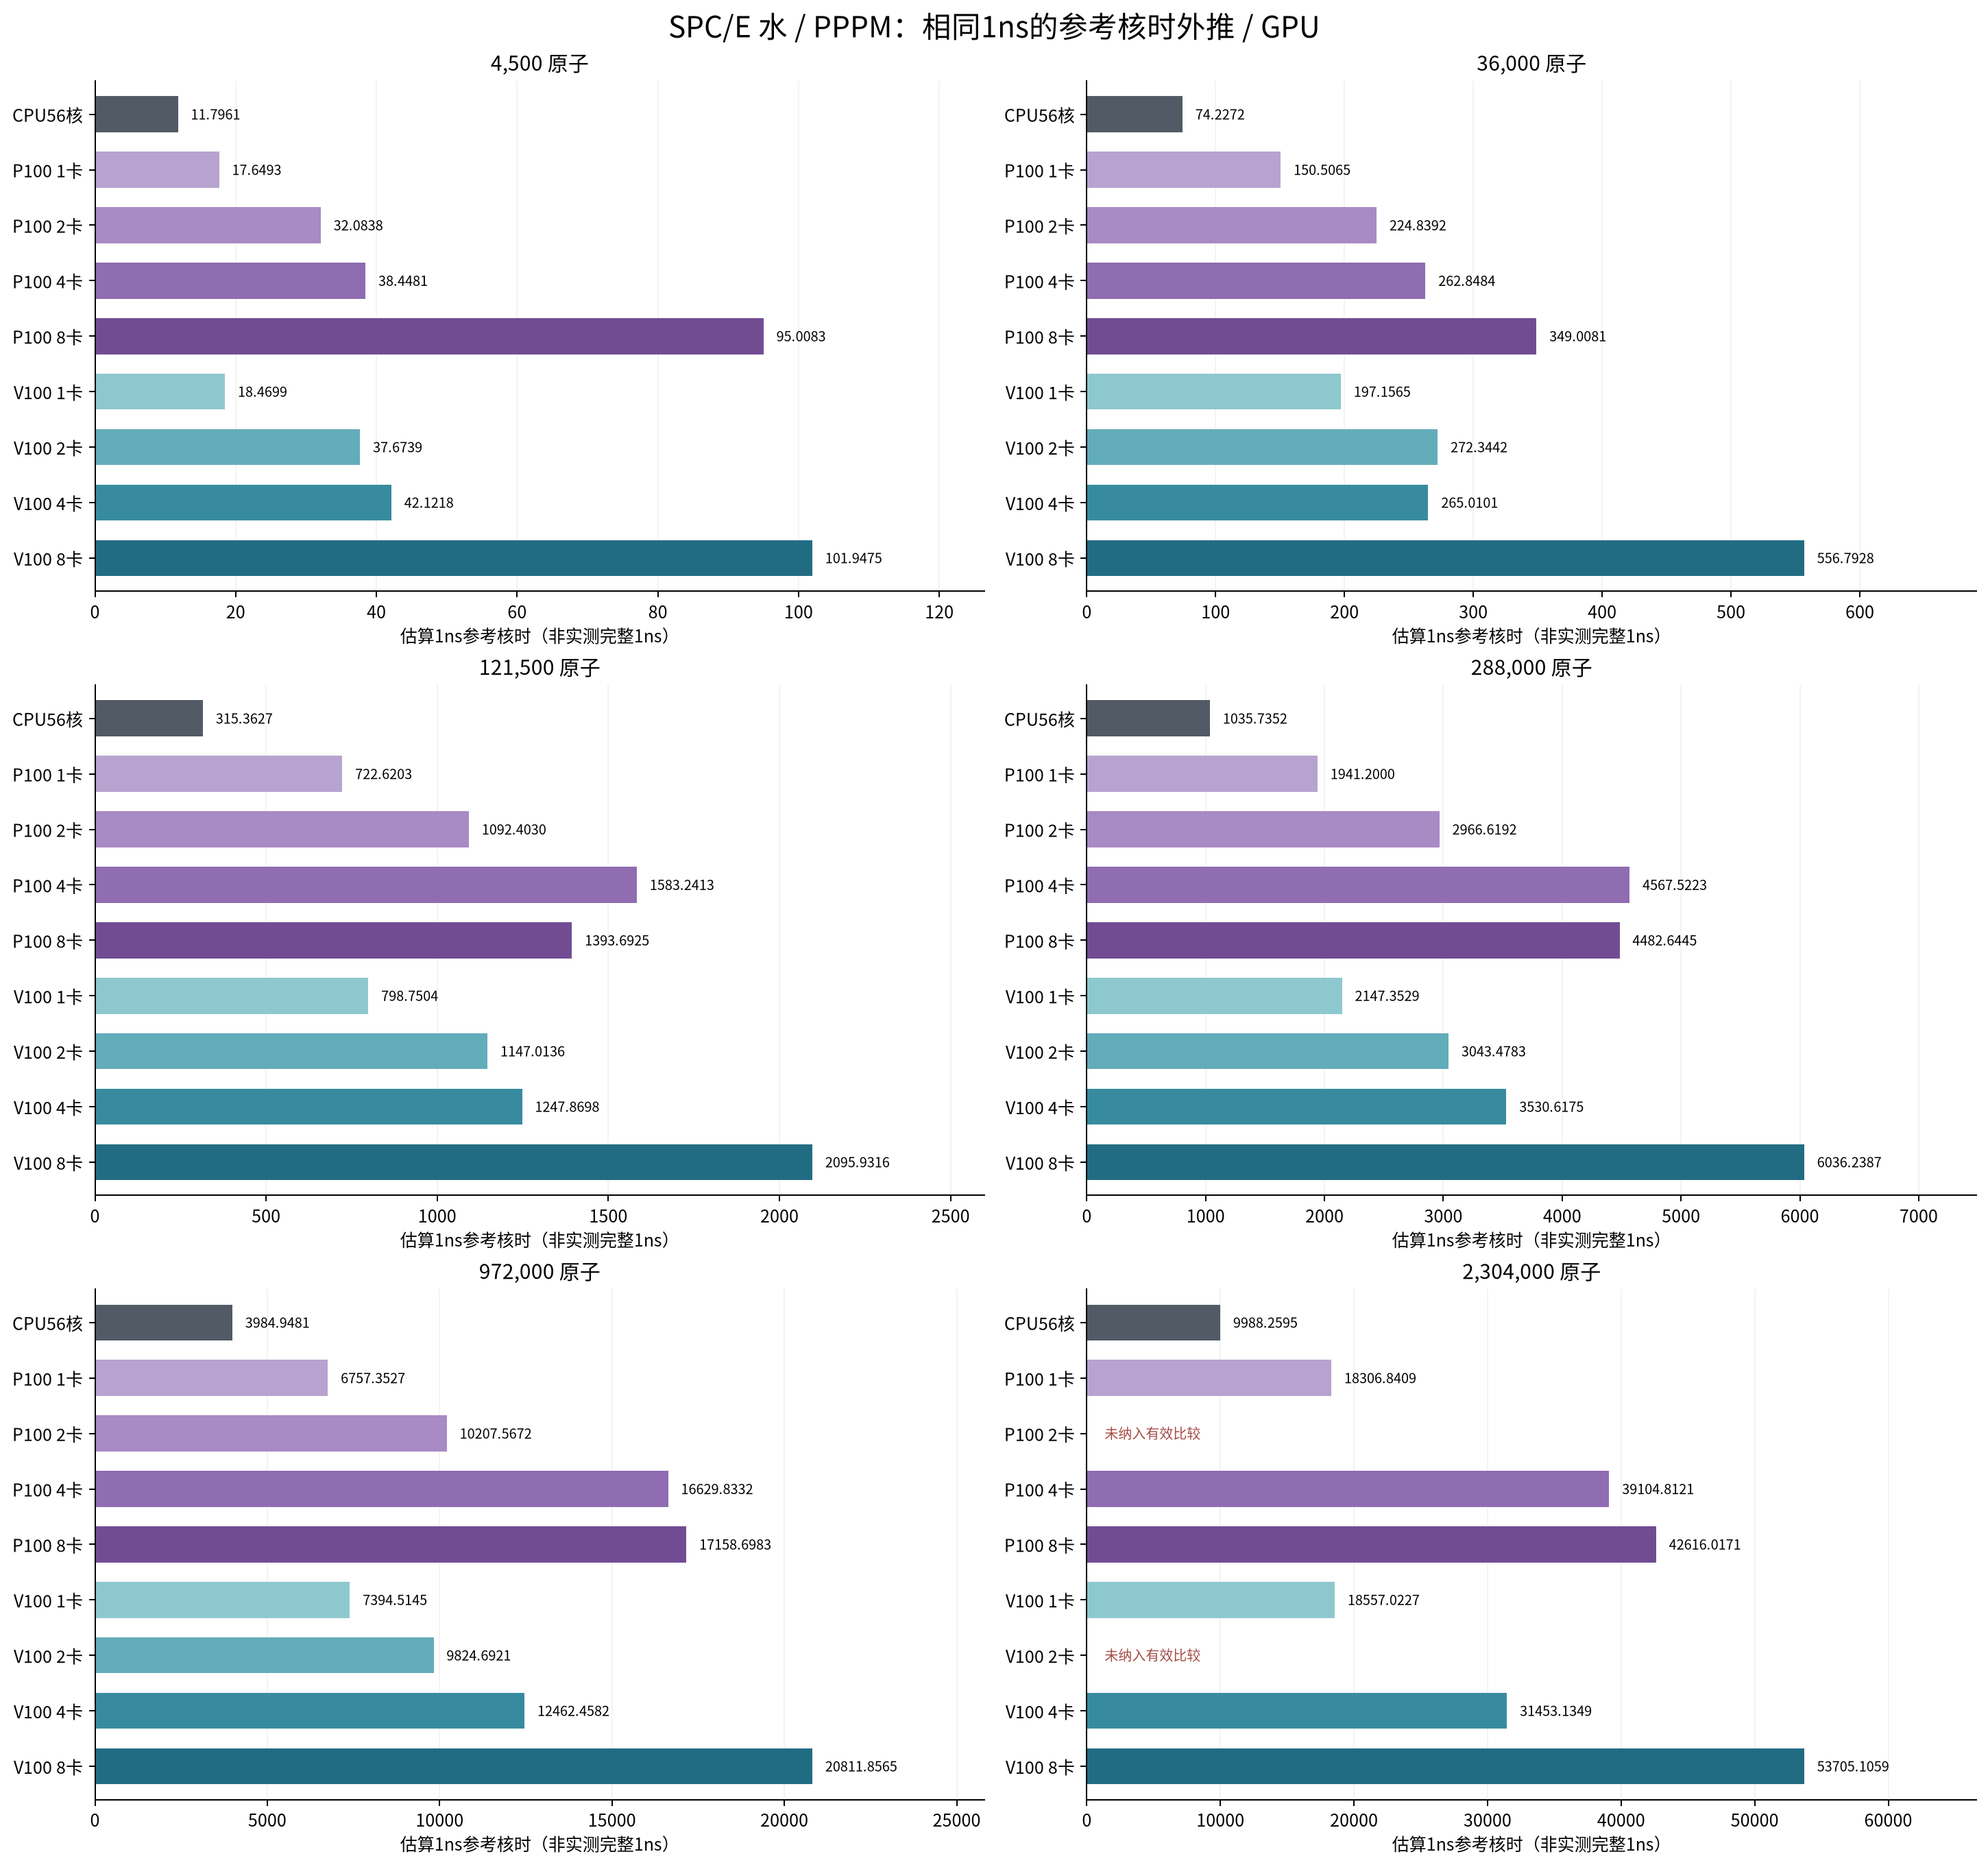
SPC/E 水 / PPPM:相同1ns的参考核时外推 / GPU
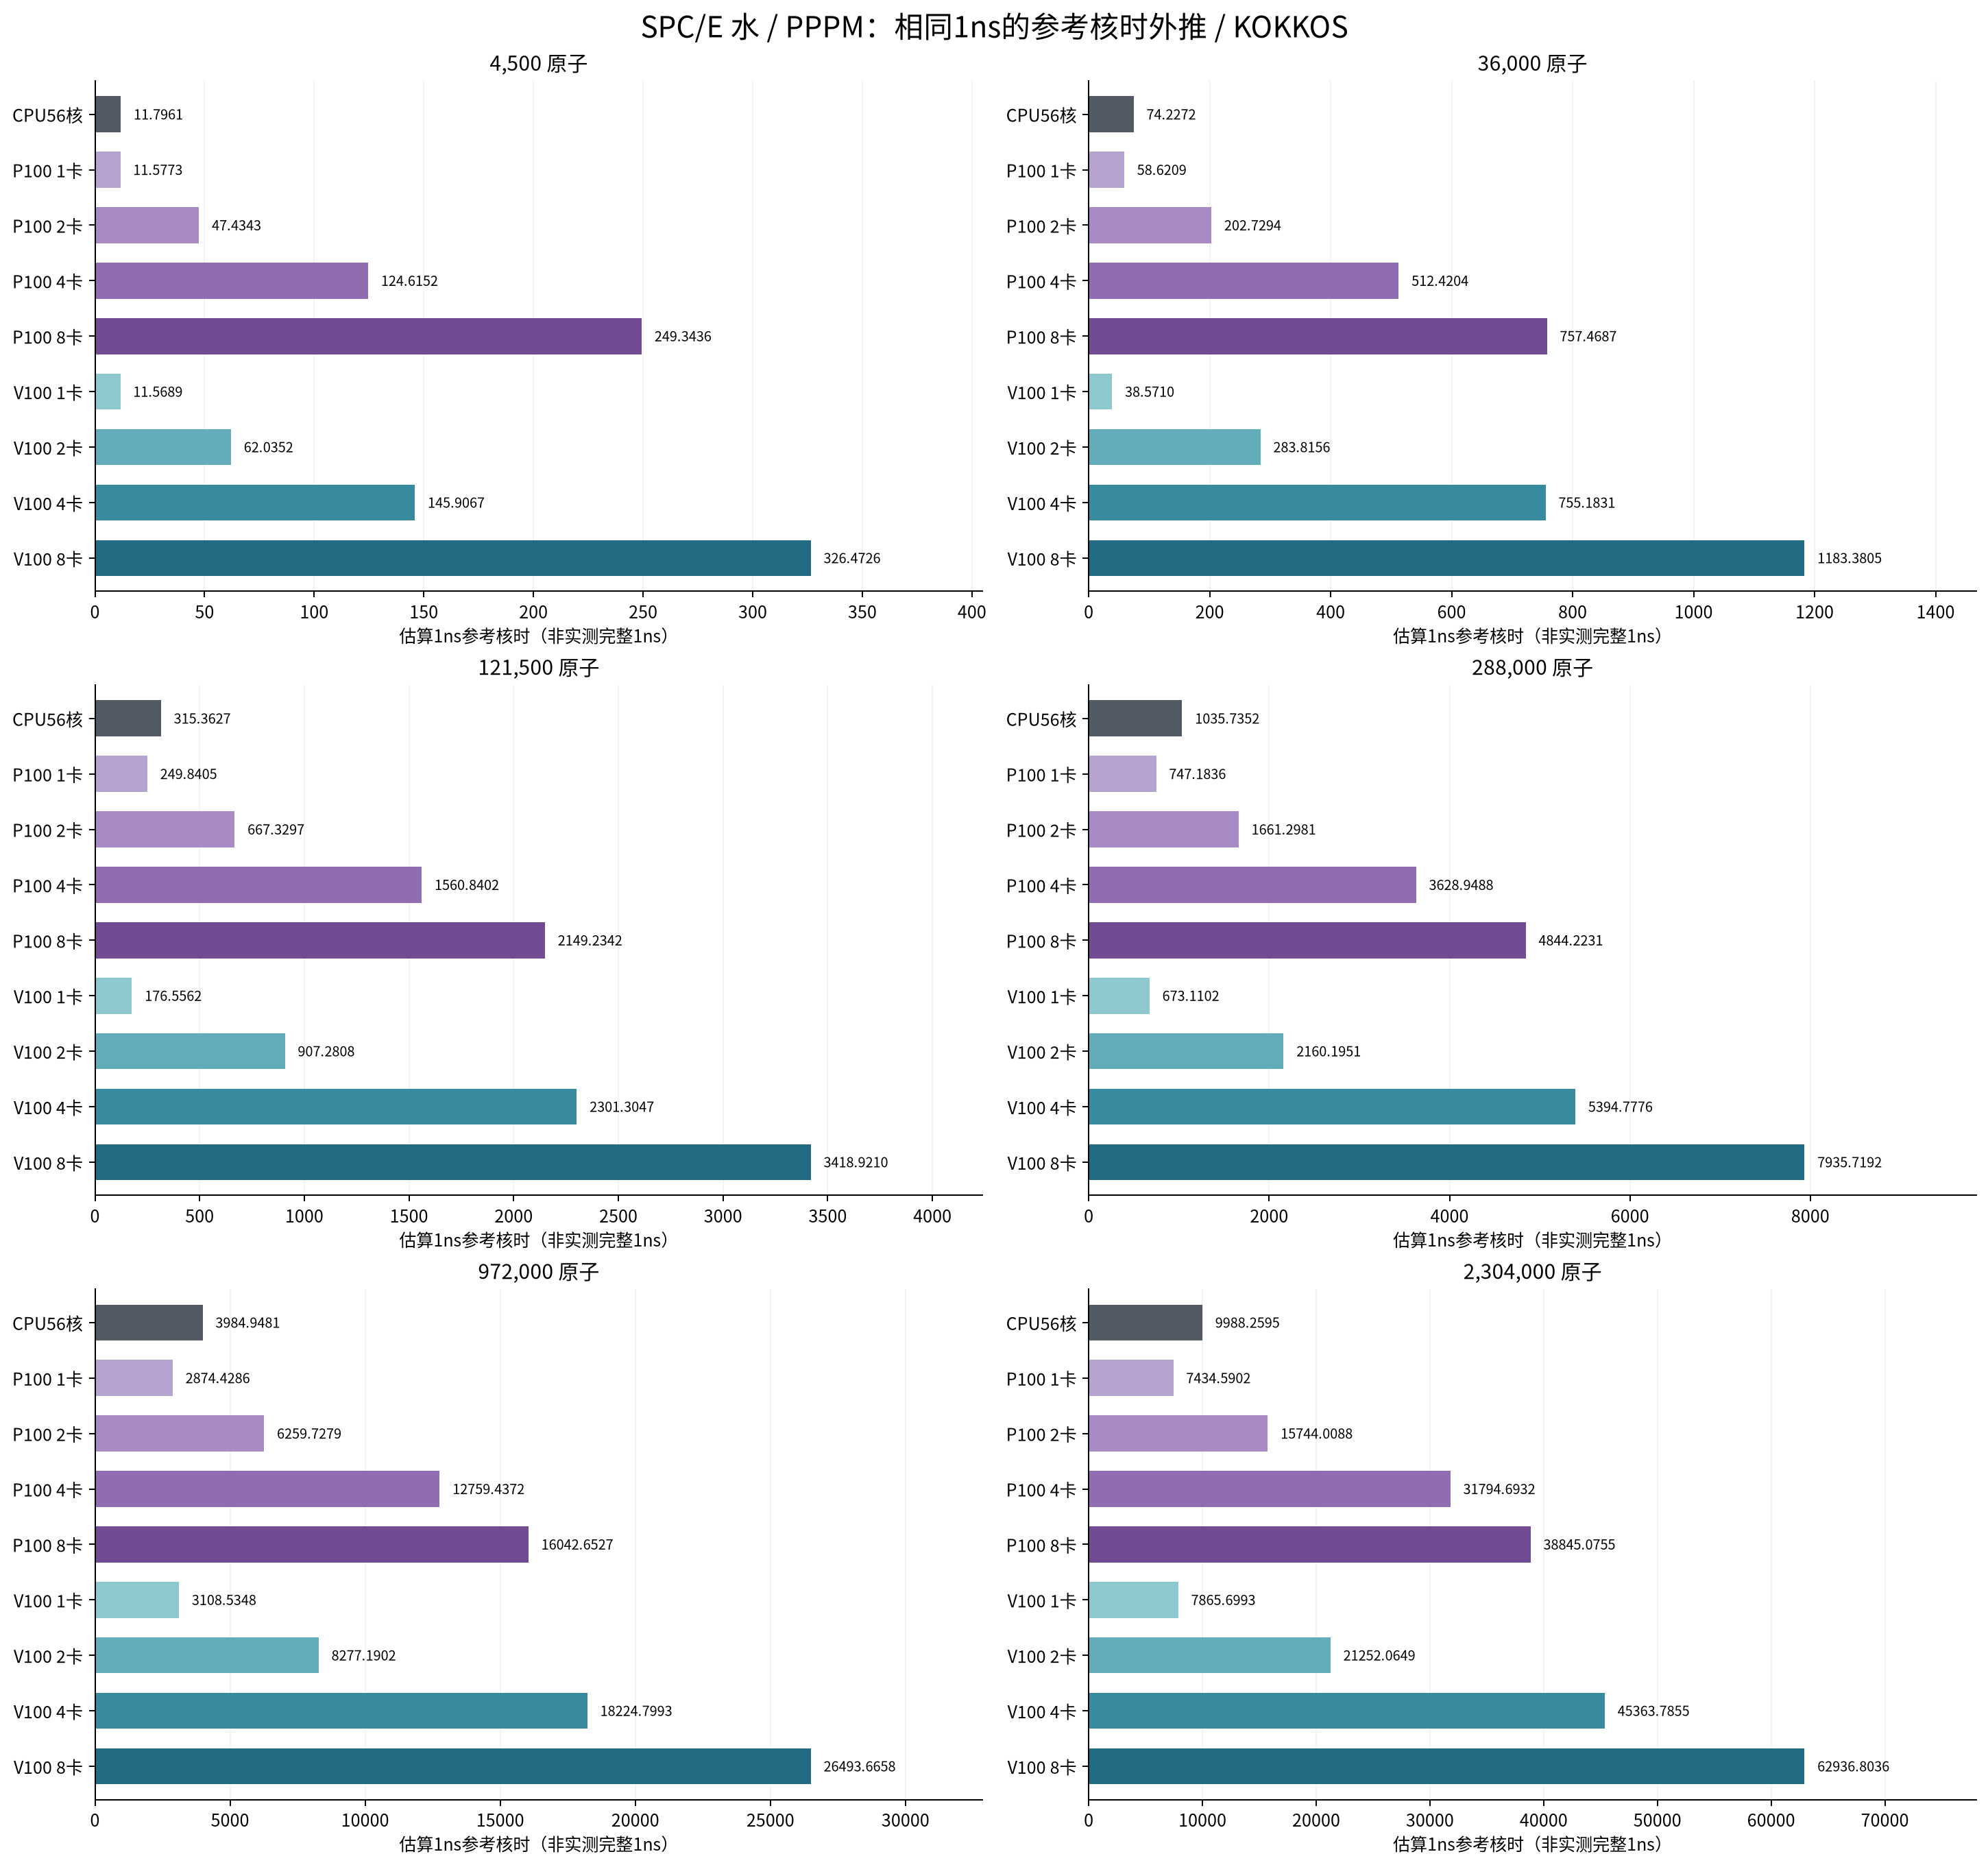
SPC/E 水 / PPPM:相同1ns的参考核时外推 / KOKKOS
测试环境与适用范围#
LAMMPS22Jul2025 Update6。CPU使用oneAPI2024.2/Intel MPI/MKL;GPU使用GCC13.3/独立Open MPI5.0.10/CUDA12.8/MKL,Kokkos4.6.2。通用构建所带PLUMED本轮未施加偏置。驱动、默认功耗、P2P和公共程序保持原状,硬件拓扑和每次MPI/线程布局归档。
| 平台/节点 | 主机CPU与物理核 | GPU型号/单卡显存 | 默认单卡功耗 |
|---|---|---|---|
| CPU/ccn001-8173m | 双路Xeon Platinum 8173M,56核 | — | — |
| P100/gcn001-8p100 | 双路Xeon E5-2696 v3,36核 | Tesla P100-PCIE,16GB | 250W |
| V100/gcn001-8v100-16g | 双路Xeon Gold 6146,24核 | Tesla V100-SXM2,16GB | 300W |
两GPU节点驱动均为580.173.02。这里比较的是实际交付节点和对应软件栈的综合表现;GPU包仍有CPU工作,主机CPU与拓扑也会影响结果,不能把P100与V100之间全部差异归给GPU芯片本身。
GPU包和KOKKOS的包覆盖范围、CPU/GPU分工、数值精度不同,因此两条路线的速度差不能全部归因于精度。没有测试的模型、跨节点、DeePMD、ReaxFF及增强采样不能直接套用本表。
完整性能与费用CSV · 参数选择 · 计算准确性 · 显存容量
显存监测对计时的控制检查#
性能主表同时使用5ms目标间隔的显存采样。另以相同输入、相同步数和四卡布局,顺序比较开启/关闭该采样的运行,GPU健康指标监测保持一致。每种只有一对,差异包含运行波动,不能解释为精确的固定监测开销,也没有据此校正原始时间。
| 模型 | 平台/实现 | 采样开启 / s | 采样关闭 / s | 时间差 / % |
|---|---|---|---|---|
| Cu / EAM | P100 / gpu | 47.4394 | 47.5022 | -0.13 |
| Cu / EAM | P100 / kokkos | 69.8925 | 69.6306 | +0.38 |
| Si / Tersoff | P100 / gpu | 54.0340 | 54.4715 | -0.80 |
| Si / Tersoff | P100 / kokkos | 68.2497 | 68.0933 | +0.23 |
| Cu / EAM | V100 / gpu | 46.4973 | 47.0488 | -1.17 |
| Cu / EAM | V100 / kokkos | 57.6966 | 57.3401 | +0.62 |
| Si / Tersoff | V100 / gpu | 52.0002 | 51.7743 | +0.44 |
| Si / Tersoff | V100 / kokkos | 62.0806 | 61.7086 | +0.60 |