
VASP CPU参数:NCORE、KPAR与NPAR
56核CPU布局、合法分组与六种规模七张实际耗时图。
阅读本篇目录
面向鸢算科技 HPC 集群用户。适用起点:
cpu-8173m单节点、56 个 MPI 进程、每进程 1 个 CPU 核心。参数规则于 2026-10-13 核对 VASP 官方文档;性能参考来自本集群 VASP 6.6.1 的 Si 算例及本次定向补测。
推荐使用 KPAR + NCORE,不同时填写 NPAR。 先读取实际 k 点数,再选择能够正确划分 56 个 MPI 进程的组合。没有自己的计时数据时,可从 KPAR=1、NCORE=7 开始;多个 k 点的中等规模体系再比较 KPAR=2/4 与相应合法的 NCORE。合适值还取决于能带、晶胞、算法和运行版本,下面的实测帮助缩小候选范围。
1. 先把提交脚本配对#
8173M 队列按整节点 56 核计费,公共 VASP 模板也按整节点配置。下面采用已经部署的 CPU 模块和 Intel MPI;参数调优主要在 INCAR 中进行。
#!/bin/bash
#SBATCH --job-name=vasp
#SBATCH --partition=cpu-8173m
#SBATCH --nodes=1
#SBATCH --ntasks-per-node=56
#SBATCH --cpus-per-task=1
#SBATCH --exclusive
#SBATCH --output=%j.out

module load vasp/6.6.1-8173m
ulimit -s unlimited
export OMP_NUM_THREADS=1
export MKL_NUM_THREADS=1
export I_MPI_PIN=1
export I_MPI_PIN_DOMAIN=core

mpirun -np "${SLURM_NTASKS}" vasp_std
在准备好输入文件的目录中执行 sbatch sub_vasp.sh。也可以使用 yskit 获取已有模板;现有 6.6.1 CPU 模板是 /public/slurm_scripts/hs_user/vasp/vasp/6.6.1/8173m/sub_vasp_6.6.1_8173m.sh。选择其他版本或扩展时,换用对应模块/模板;资源仍为整节点 56 核。
这里的 --cpus-per-task=1 是每个进程申请一个 CPU 核心,不是让整个作业只用一核。56 个进程各一核正好使用整节点。不要因为 INCAR 里设置 NCORE=7,就把 OMP_NUM_THREADS 或 --cpus-per-task 同时改为 7。
2. 三个参数分别划分什么#
| 参数 | 控制的内容 | 在 56 MPI 进程中的解释 |
|---|---|---|
KPAR |
k 点组数 | 56 个进程先分为 KPAR 组,每组处理一部分 k 点 |
NCORE |
协同处理一条能带的 MPI 进程数 | 每个 k 点组内部,再把进程划分为大小为 NCORE 的带组 |
NPAR |
每个 k 点组内部的带组数 | 与 NCORE 表达同一层划分的不同角度 |
普通单体系、纯 MPI、没有其他专门并行标签时:
每个 k 点组的 MPI 进程数 = 56 / KPAR
NPAR = 56 / (KPAR × NCORE)
56 = KPAR × NCORE × NPAR
例如 KPAR=4、NCORE=7:4 个 k 点组,每组 14 个 MPI 进程;每组内部又分成 2 个带组,每个带组 7 个进程。等效 NPAR 为 2。这不是“只使用 4×7=28 核”,所有 56 个 MPI 进程仍参与计算。NCORE 定义、NPAR 与可用进程关系。
NCORE 是 MPI 数据/计算分组,不是 OpenMP 线程数,也不是“给每个原子分几核”。参数主要改变数据分布、FFT 和能带之间的通信;理想情况下改变的是性能,不改变研究模型。
3. NCORE 与 NPAR 只选一个#
现代 VASP 推荐通过 NCORE 控制带组大小。旧输入文件若保留 NPAR,应该先处理它:两者同时存在时,NPAR 优先,修改 NCORE 可能没有得到预期分组。VASP 的兼容规则。
下面两份设置在本指南的运行条件下等效,分别选择一种:
# 推荐写法
KPAR = 4
NCORE = 7
# 兼容旧输入的写法
KPAR = 4
NPAR = 2
如果同时写 KPAR=4、NCORE=14、NPAR=2,NPAR 指定两个带组,每组实际为 7 个 MPI 进程,而不是输入中期望的 14。本次补测已把启动输出中的实际分组与能量/力一起核对,结果列在第 9 节。
NPAR 没有独立于 NCORE 的额外加速能力。对于相同进程数和 KPAR,比较等价的两种写法主要用于核对配置,不是再增加一个独立扫描维度。
4. 56 核允许哪些组合#
需要同时满足:KPAR 整除总 MPI 进程数,NCORE 整除每个 k 点组的进程数。下表列完整的整数分组,不代表每个合法组合都值得运行。
| KPAR | 每个 k 点组的 MPI 进程 | 合法 NCORE | 示例 NCORE → 等效 NPAR |
|---|---|---|---|
| 1 | 56 | 1、2、4、7、8、14、28、56 | 7 → 8;14 → 4;28 → 2 |
| 2 | 28 | 1、2、4、7、14、28 | 4 → 7;7 → 4;14 → 2 |
| 4 | 14 | 1、2、7、14 | 7 → 2;14 → 1 |
| 7 | 8 | 1、2、4、8 | 1 → 8;4 → 2 |
| 8 | 7 | 1、7 | 1 → 7;7 → 1 |
| 14 | 4 | 1、2、4 | 1 → 4;2 → 2 |
| 28 | 2 | 1、2 | 1 → 2 |
| 56 | 1 | 1 | 1 → 1 |
所以 KPAR=4、NCORE=4 不满足组内整除:每组只有 14 个进程,不能平均分成 4 进程的带组。常见的 48/64 核建议不能原样套到本机;例如 KPAR=3/6、NCORE=6/12 都需要重新检查,而不是只看值是否常见。
公式使用的是 MPI 进程数。若使用 IMAGES、GW/RPA 的专门分组或经过验证的混合并行配置,还需要扣除对应分组,不能直接套用这个 56 核表。VASP 并行层次。
5. KPAR 按实际 k 点数选择#
5.1 怎样查实际点数#
已有计算完成初始化后,在该算例目录读取:
grep -m 1 'NKPTS' OUTCAR
awk 'NR==2 {print "实际 k 点数 =", $1}' IBZKPT
例如完整的 6×6×6 网格有 216 个网格点,本集群 8 原子应变 Si 算例实际 NKPTS=64。对称性、磁性、SOC 和结构改变都会影响实际点数;不要只把 KPOINTS 三个数字相乘。IBZKPT 输出说明。
没有历史输出时,可在独立的预检查目录中使用版本支持的 --dry-run,或参考官方 ALGO=None 初始化方法取得实际点数与能带。预检查设置与生产输入分开保存,初始化本身不是性能测试。官方预检查方法。
5.2 单点、多点与分组平衡#
| 实际 k 点情况 | 优先比较的 KPAR | 为什么 |
|---|---|---|
| 1 个点,包括纯 Γ 点 | 1 | k 点之间没有可并行工作 |
| 2 个点 | 1、2 | 两组可以各处理一个点 |
| 3 个点 | 1、2 | KPAR=3 不整除 56;KPAR=2 会形成 2/1 点的分配,需看实际时间 |
| 4 个点 | 1、2、4 | 可比较组间并行与组内能带并行 |
| 8 个点,中等或较多能带 | 2、4、8,并保留 1 对照 | 本集群中等 Si 体系常以 4 为较好候选,但需要配对 NCORE |
| 较多点、少量能带 | 4、7、8、14;需要时再试 28/56 | 每个点工作小,可比较更细的 k 点并行;大值不保证更快 |
VASP 按轮转方式分配 k 点。KPAR 必须整除 MPI 进程数;能均分实际 k 点数通常更有利于负载平衡,但不是合法运行的强制条件。KPAR 分配机制。
例如 125 个点、KPAR=14 时,各组取得 8 或 9 个点,仍可运行;第 8 节给出它在本机小体系上的补测。本指南通常不把 KPAR 设得超过实际点数,以避免空组或过度分组;特殊方法另按其官方规则判断。
KPAR 增大还能改变内存分布,通常需要更多内存,容量紧张时应检查峰值。它的合理值取决于每个点的能带数、平面波数量和组间/组内通信,不能只由 NKPTS 决定。官方调优建议。
6. 为什么这台机器适合试 4、7、14、28 等 NCORE#
本次只读硬件查询确认:ccn001-8173m 为双路 Intel Xeon Platinum 8173M,每路 28 个物理核心,共 56 核;超线程当前关闭。两个 NUMA 域对应 CPU0–27 和 CPU28–55。硬件查询记录。
| 候选因素 | 对选择的意义 |
|---|---|
| 每 NUMA 域 28 核 | 7、14、28 能形成与28核相容的工作组,值得比较 |
| 总数 56 核 | KPAR=1 时 NCORE=8 也合法,虽然不能整除单路28 |
| KPAR=2 | 每 k 点组28核,可以试4、7、14 |
| KPAR=4 | 每组14核,只能从1、2、7、14中选择 |
| 能带少 | NCORE=1 也可能合适;小体系不能机械使用大 NCORE |
| 能带与平面波较多 | 可试7、14及相应合法候选,比较FFT、正交化和通信成本 |
NUMA 是选择候选的依据,不是单独的强制除数条件。本机 Γ 单点的32/64原子数据中,NCORE=8与4/7接近或稍快,说明“必须整除28”过于绝对。
保持 MPI 进程绑定可减少核间迁移;本集群 CPU 模板使用 I_MPI_PIN=1、I_MPI_PIN_DOMAIN=core。本次补测抽查的56个进程分别绑定到56个不同核心,rank0对应CPU0、rank28对应CPU28,见实际进程亲和性记录。实际进程排列仍由 MPI 与调度环境决定,不能仅凭 NCORE=14 就认定所有带组一定落在同一 NUMA 域。MPI 进程放置与 NUMA。
7. 已有 Si 测试:用实测缩小候选#
原 CPU 扫描保存270条结果,其中269条满足完成和数值检查,一条32原子密网格失败结果排除。覆盖8、32、64、96、144、216原子,Γ单点、较疏网格和较密网格。程序为普通 vasp_std 6.6.1,56 MPI × 1,固定30电子步、ALGO=Normal、NSIM=32、ENCUT=350 eV、LREAL=Auto,每尺寸固定NBANDS。
下表是原候选集合中单次测量最短的 LOOP+ real 时间;原扫描KPAR取1/2/4/8,NCORE取相应合法的1/2/4/7/8/14/28,没有宣称遍历所有可能参数。这里的 NPAR 是公式换算值,并非另写进这些测试的 INCAR。
| 网格 | 原子数 | 实际 k 点 | NBANDS | KPAR | NCORE | 等效 NPAR | LOOP+ real / s |
|---|---|---|---|---|---|---|---|
| Γ单点(1×1×1) | 8 | 1 | 56 | 1 | 7 | 8 | 1.290 |
| Γ单点(1×1×1) | 32 | 1 | 112 | 1 | 8 | 7 | 5.248 |
| Γ单点(1×1×1) | 64 | 1 | 168 | 1 | 8 | 7 | 9.674 |
| Γ单点(1×1×1) | 96 | 1 | 280 | 1 | 14 | 4 | 21.039 |
| Γ单点(1×1×1) | 144 | 1 | 392 | 1 | 14 | 4 | 43.432 |
| Γ单点(1×1×1) | 216 | 1 | 560 | 1 | 28 | 2 | 88.311 |
| 较疏网格 | 8 | 64 | 56 | 8 | 1 | 7 | 18.992 |
| 较疏网格 | 32 | 16 | 112 | 4 | 1 | 14 | 32.248 |
| 较疏网格 | 64 | 8 | 168 | 4 | 7 | 2 | 45.969 |
| 较疏网格 | 96 | 8 | 280 | 4 | 7 | 2 | 104.007 |
| 较疏网格 | 144 | 8 | 392 | 4 | 14 | 1 | 236.844 |
| 较疏网格 | 216 | 8 | 560 | 4 | 14 | 1 | 481.058 |
| 较密网格 | 8 | 125 | 56 | 8 | 1 | 7 | 31.890 |
| 较密网格 | 32 | 45 | 112 | 8 | 1 | 7 | 76.500 |
| 较密网格 | 64 | 27 | 168 | 4 | 7 | 2 | 137.855 |
| 较密网格 | 96 | 18 | 280 | 4 | 7 | 2 | 233.891 |
| 较密网格 | 144 | 12 | 392 | 4 | 14 | 1 | 340.217 |
| 较密网格 | 216 | 8 | 560 | 4 | 14 | 1 | 479.787 |
来源:原始269条有效CPU结果。
其中8原子Γ单点的时间只有约1秒,4/7/8之间的细微差别不宜认定为稳定排名。32/64原子Γ单点可优先比较4/7/8;96~216原子可把7/14/28纳入对应合法组。对多k点的64~216原子Si,KPAR=4与NCORE=7或14是已有测试中的较好起点。
7.1 全部原子数怎样看图#
下面七张图均包含 8、32、64、96、144、216原子六个面板,直接使用LOOP+ real秒数,不再按各尺寸最快值归一化。横纵轴上的参数只是原扫描候选,不表示所有合法值都已测完。每幅图的六个面板采用各自的秒数刻度,比较某一体系的候选时应在对应面板内读取。
| 想比较什么 | 图号与控制条件 |
|---|---|
| 同时选择KPAR和NCORE | 图1较疏网格、图2较密网格;每格一个实际组合 |
| 固定KPAR后怎样选择NCORE | 图3Γ单点、图4较疏网格、图5较密网格;每条曲线固定KPAR |
| 只改变KPAR会怎样 | 图6较疏网格、图7较密网格;统一固定NCORE=7 |
Γ单点仅比较KPAR=1;没有多k点工作可供KPAR分组,因此不绘制KPAR=2/4/8的Γ点性能曲线。图6/7用合法且在所有尺寸、各KPAR下均已测量的NCORE=7进行对照,不把每个KPAR下不同NCORE的最快值连成同一条参数曲线。
7.2 KPAR与NCORE的联合耗时:六种规模全部展示#
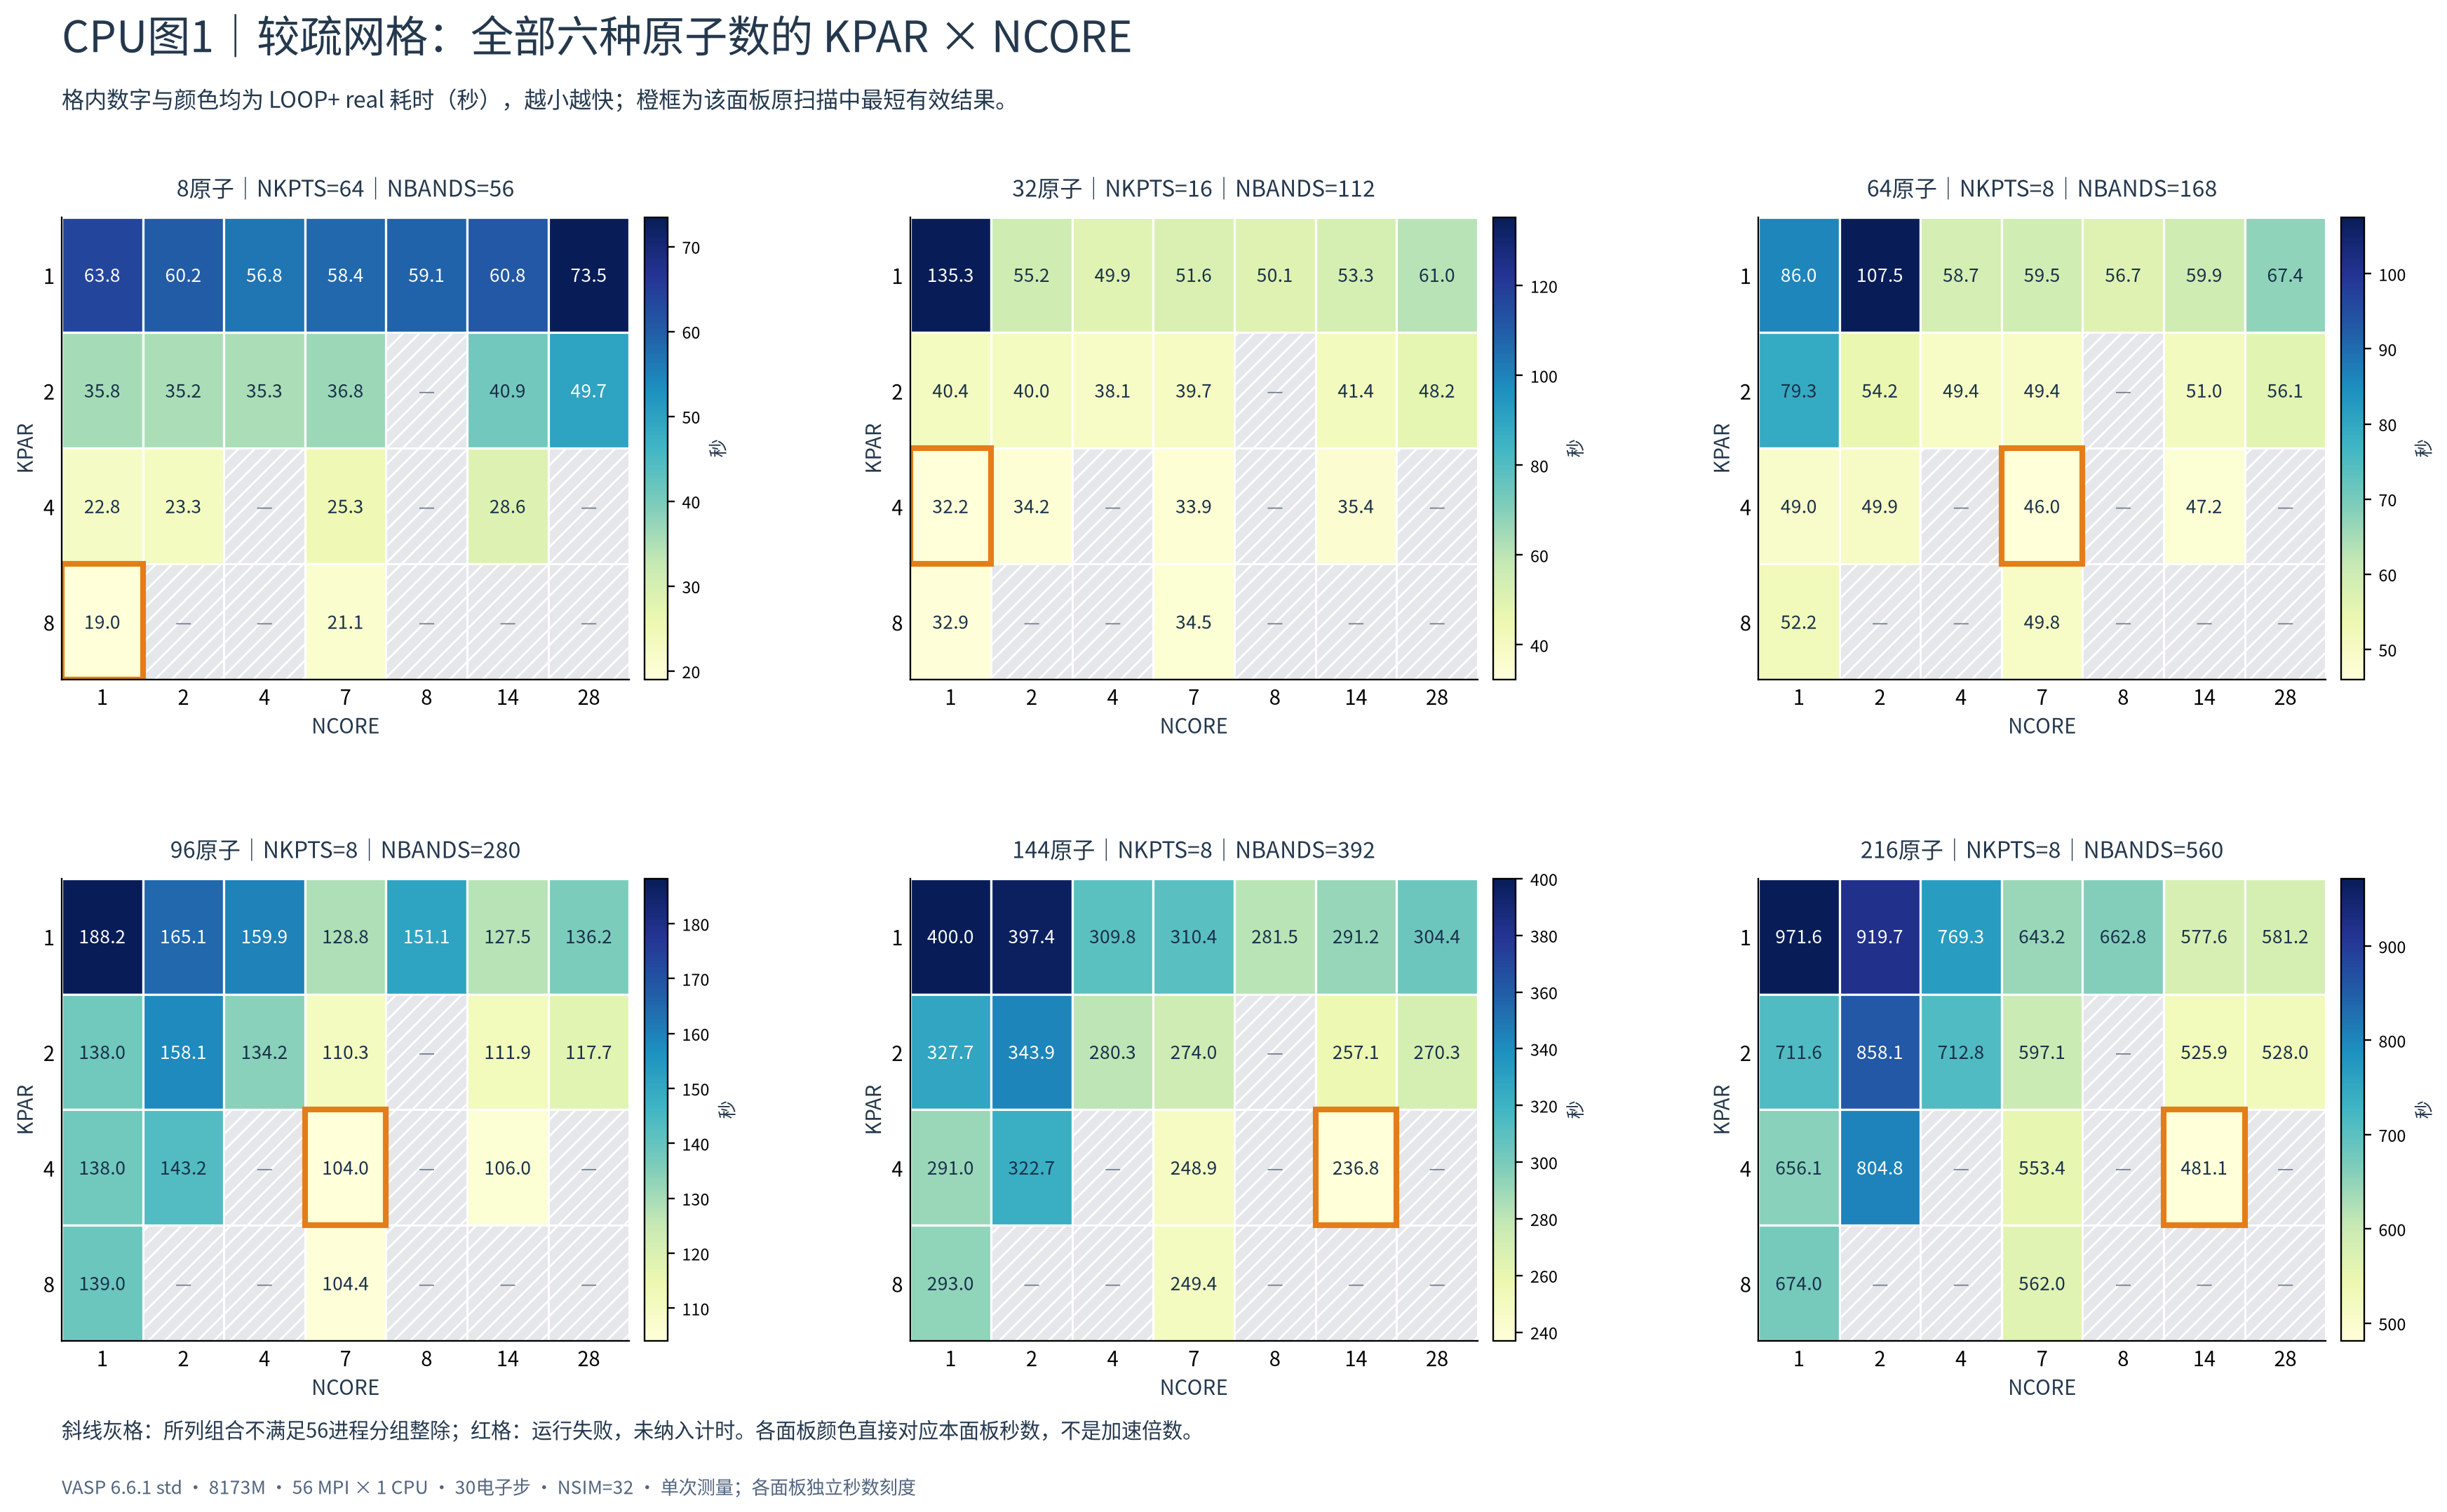
CPU图1:较疏网格,格内数值与颜色均为耗时(秒)。每个面板列出实际NKPTS和NBANDS,橙框标该面板原扫描中最短的有效结果。斜线灰格不满足所列56MPI分组的整除条件。各面板色条独立,不能把不同面板的相同颜色当成相同秒数。
较疏网格的8原子体系实际有64个k点,已测最快是KPAR=8/NCORE=1;32原子有16个k点,已测最快为4/1。64、96原子的最快组合为4/7,而144、216原子为4/14。这里同时改变了体系规模、能带数和实际k点工作量,不能把原子数单独作为选择NCORE的公式。96与216原子的数据分别完整保留在六面板中的对应位置。
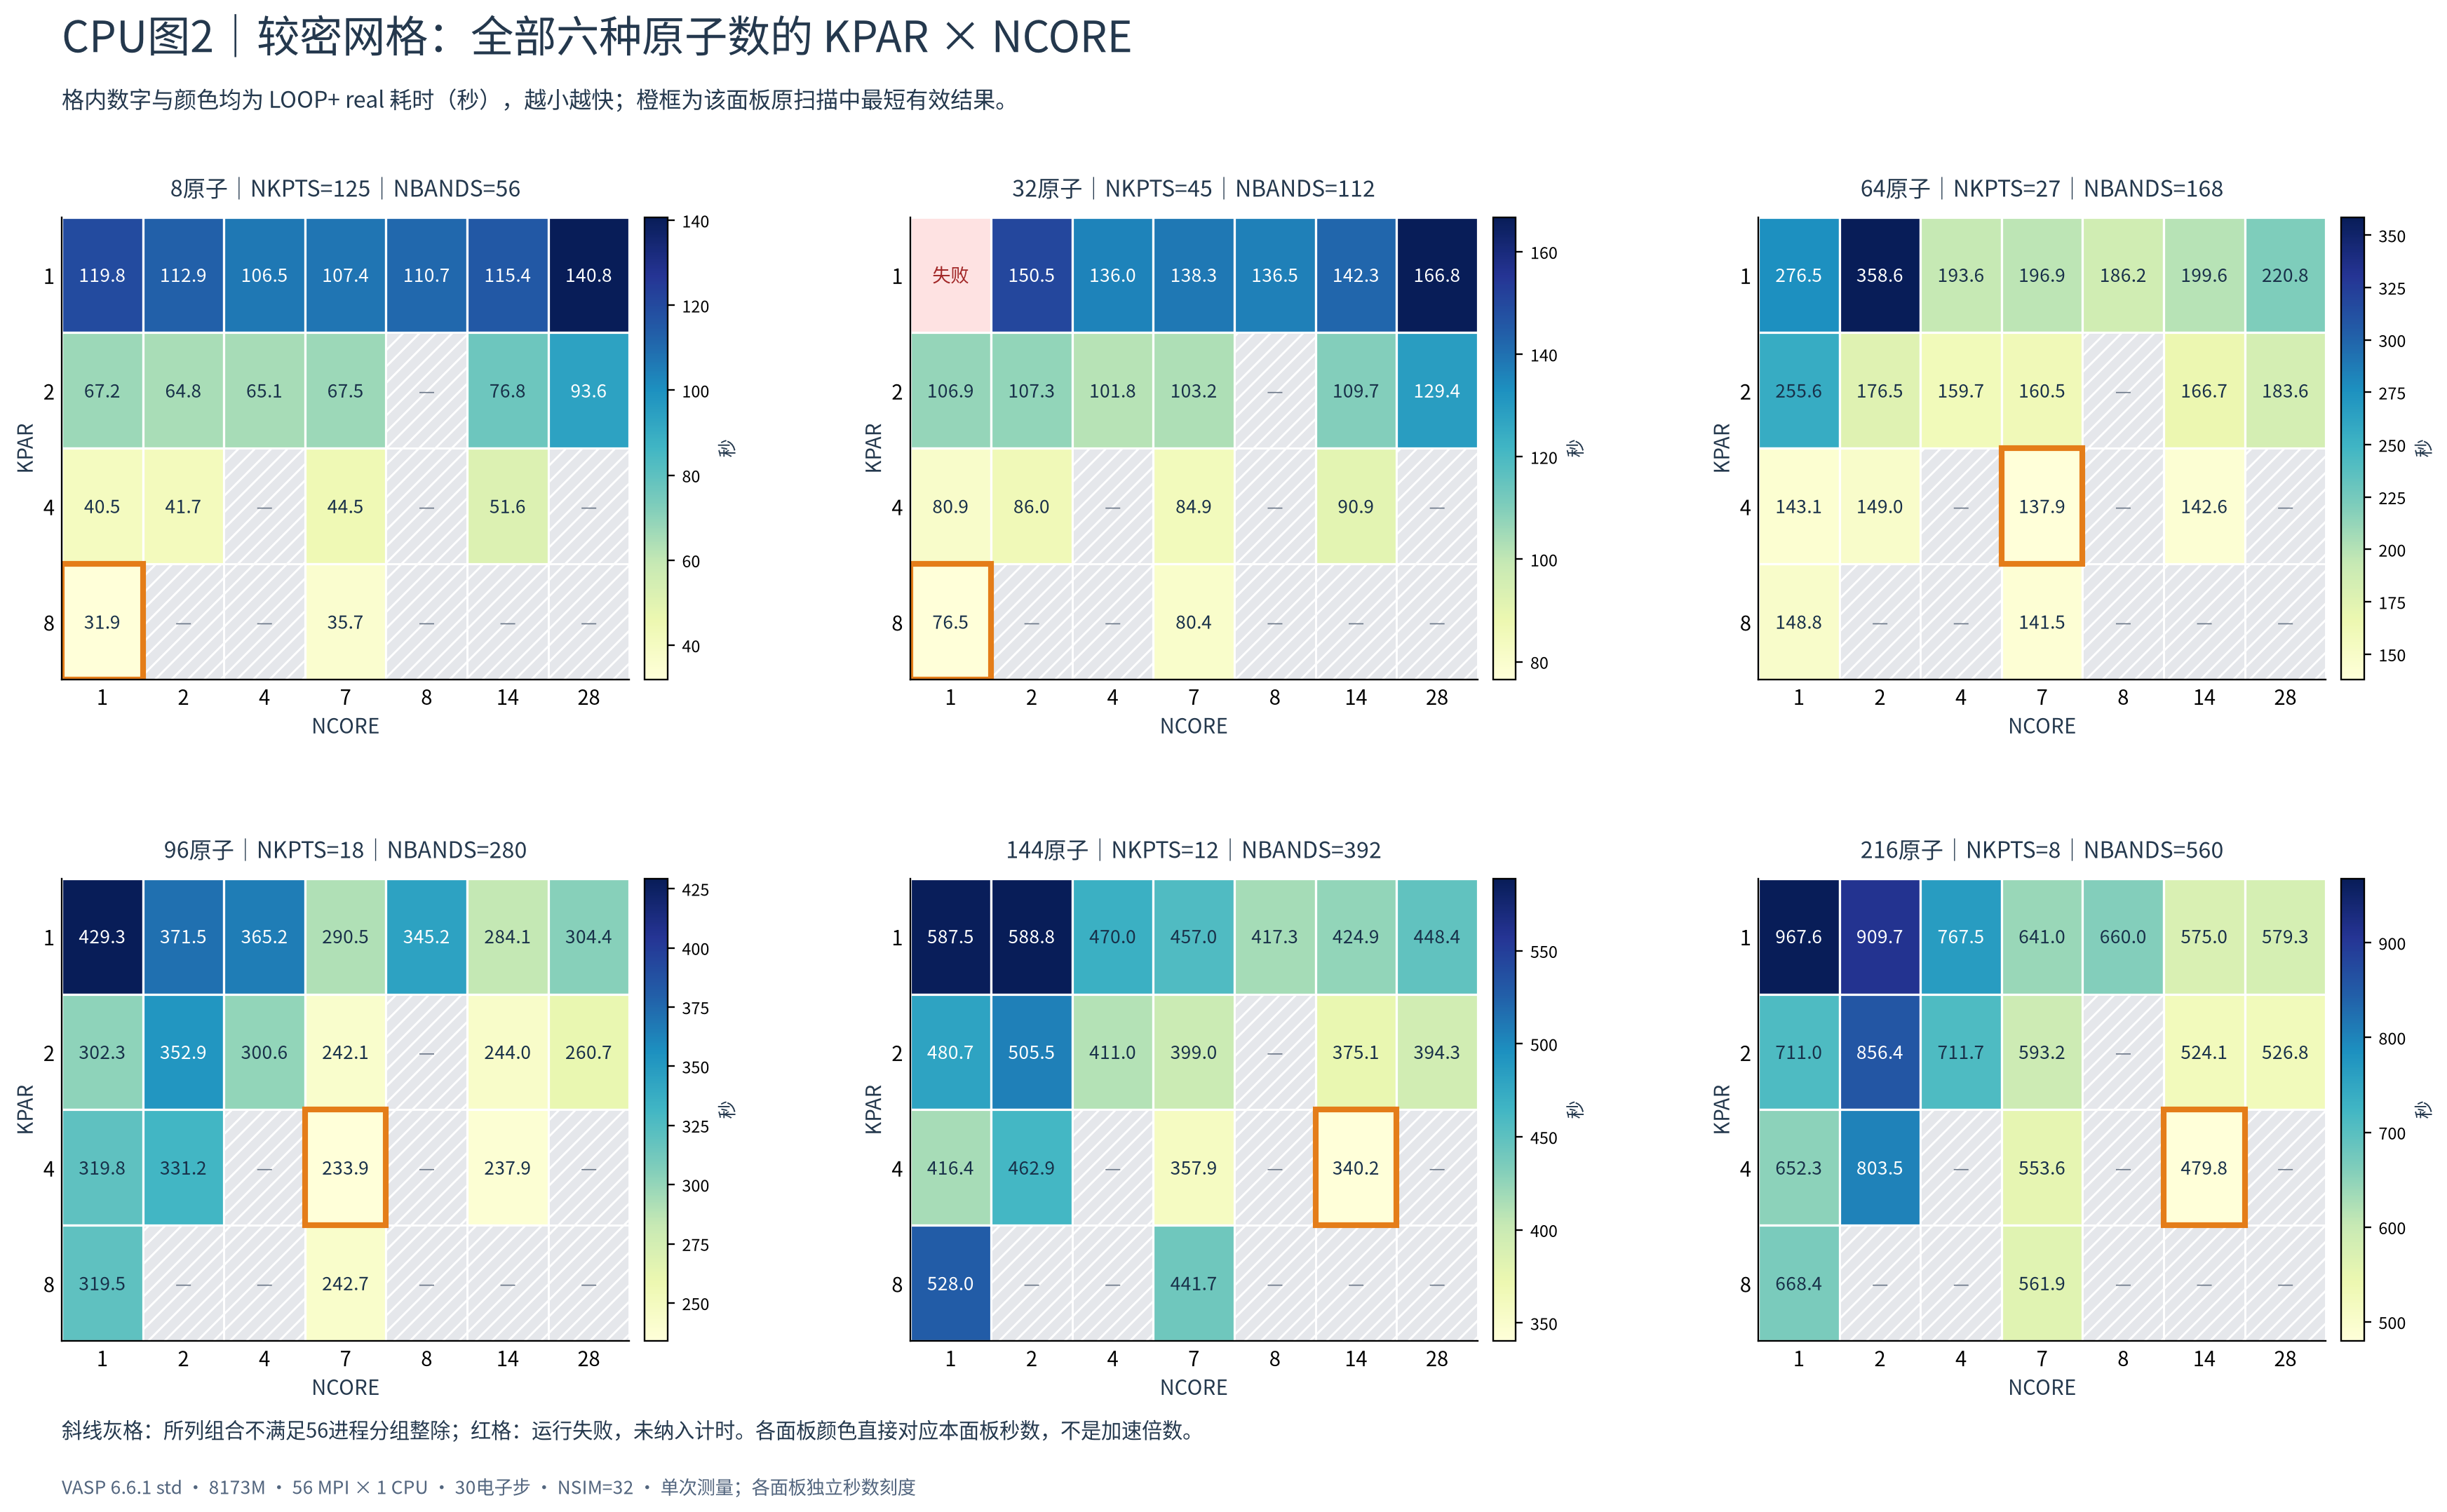
CPU图2:较密网格,同样显示实际耗时。32原子、KPAR=1/NCORE=1的运行只完成29步,红格明确标为失败,没有用不完整运行时间补格或参与最短值选择。
较密网格中,8、32原子的实际k点数分别为125、45,原扫描较快组合均为KPAR=8/NCORE=1;64、96原子为4/7,144、216原子为4/14。点数更多不意味着KPAR必须随之增大,例如144原子仍应结合NCORE比较KPAR=4与8,不能仅凭12个实际k点选一个更大的组数。8原子的额外高KPAR测试仍单列在第8节,没有混入本组原扫描图。
7.3 固定KPAR观察NCORE:Γ、疏网格和密网格#
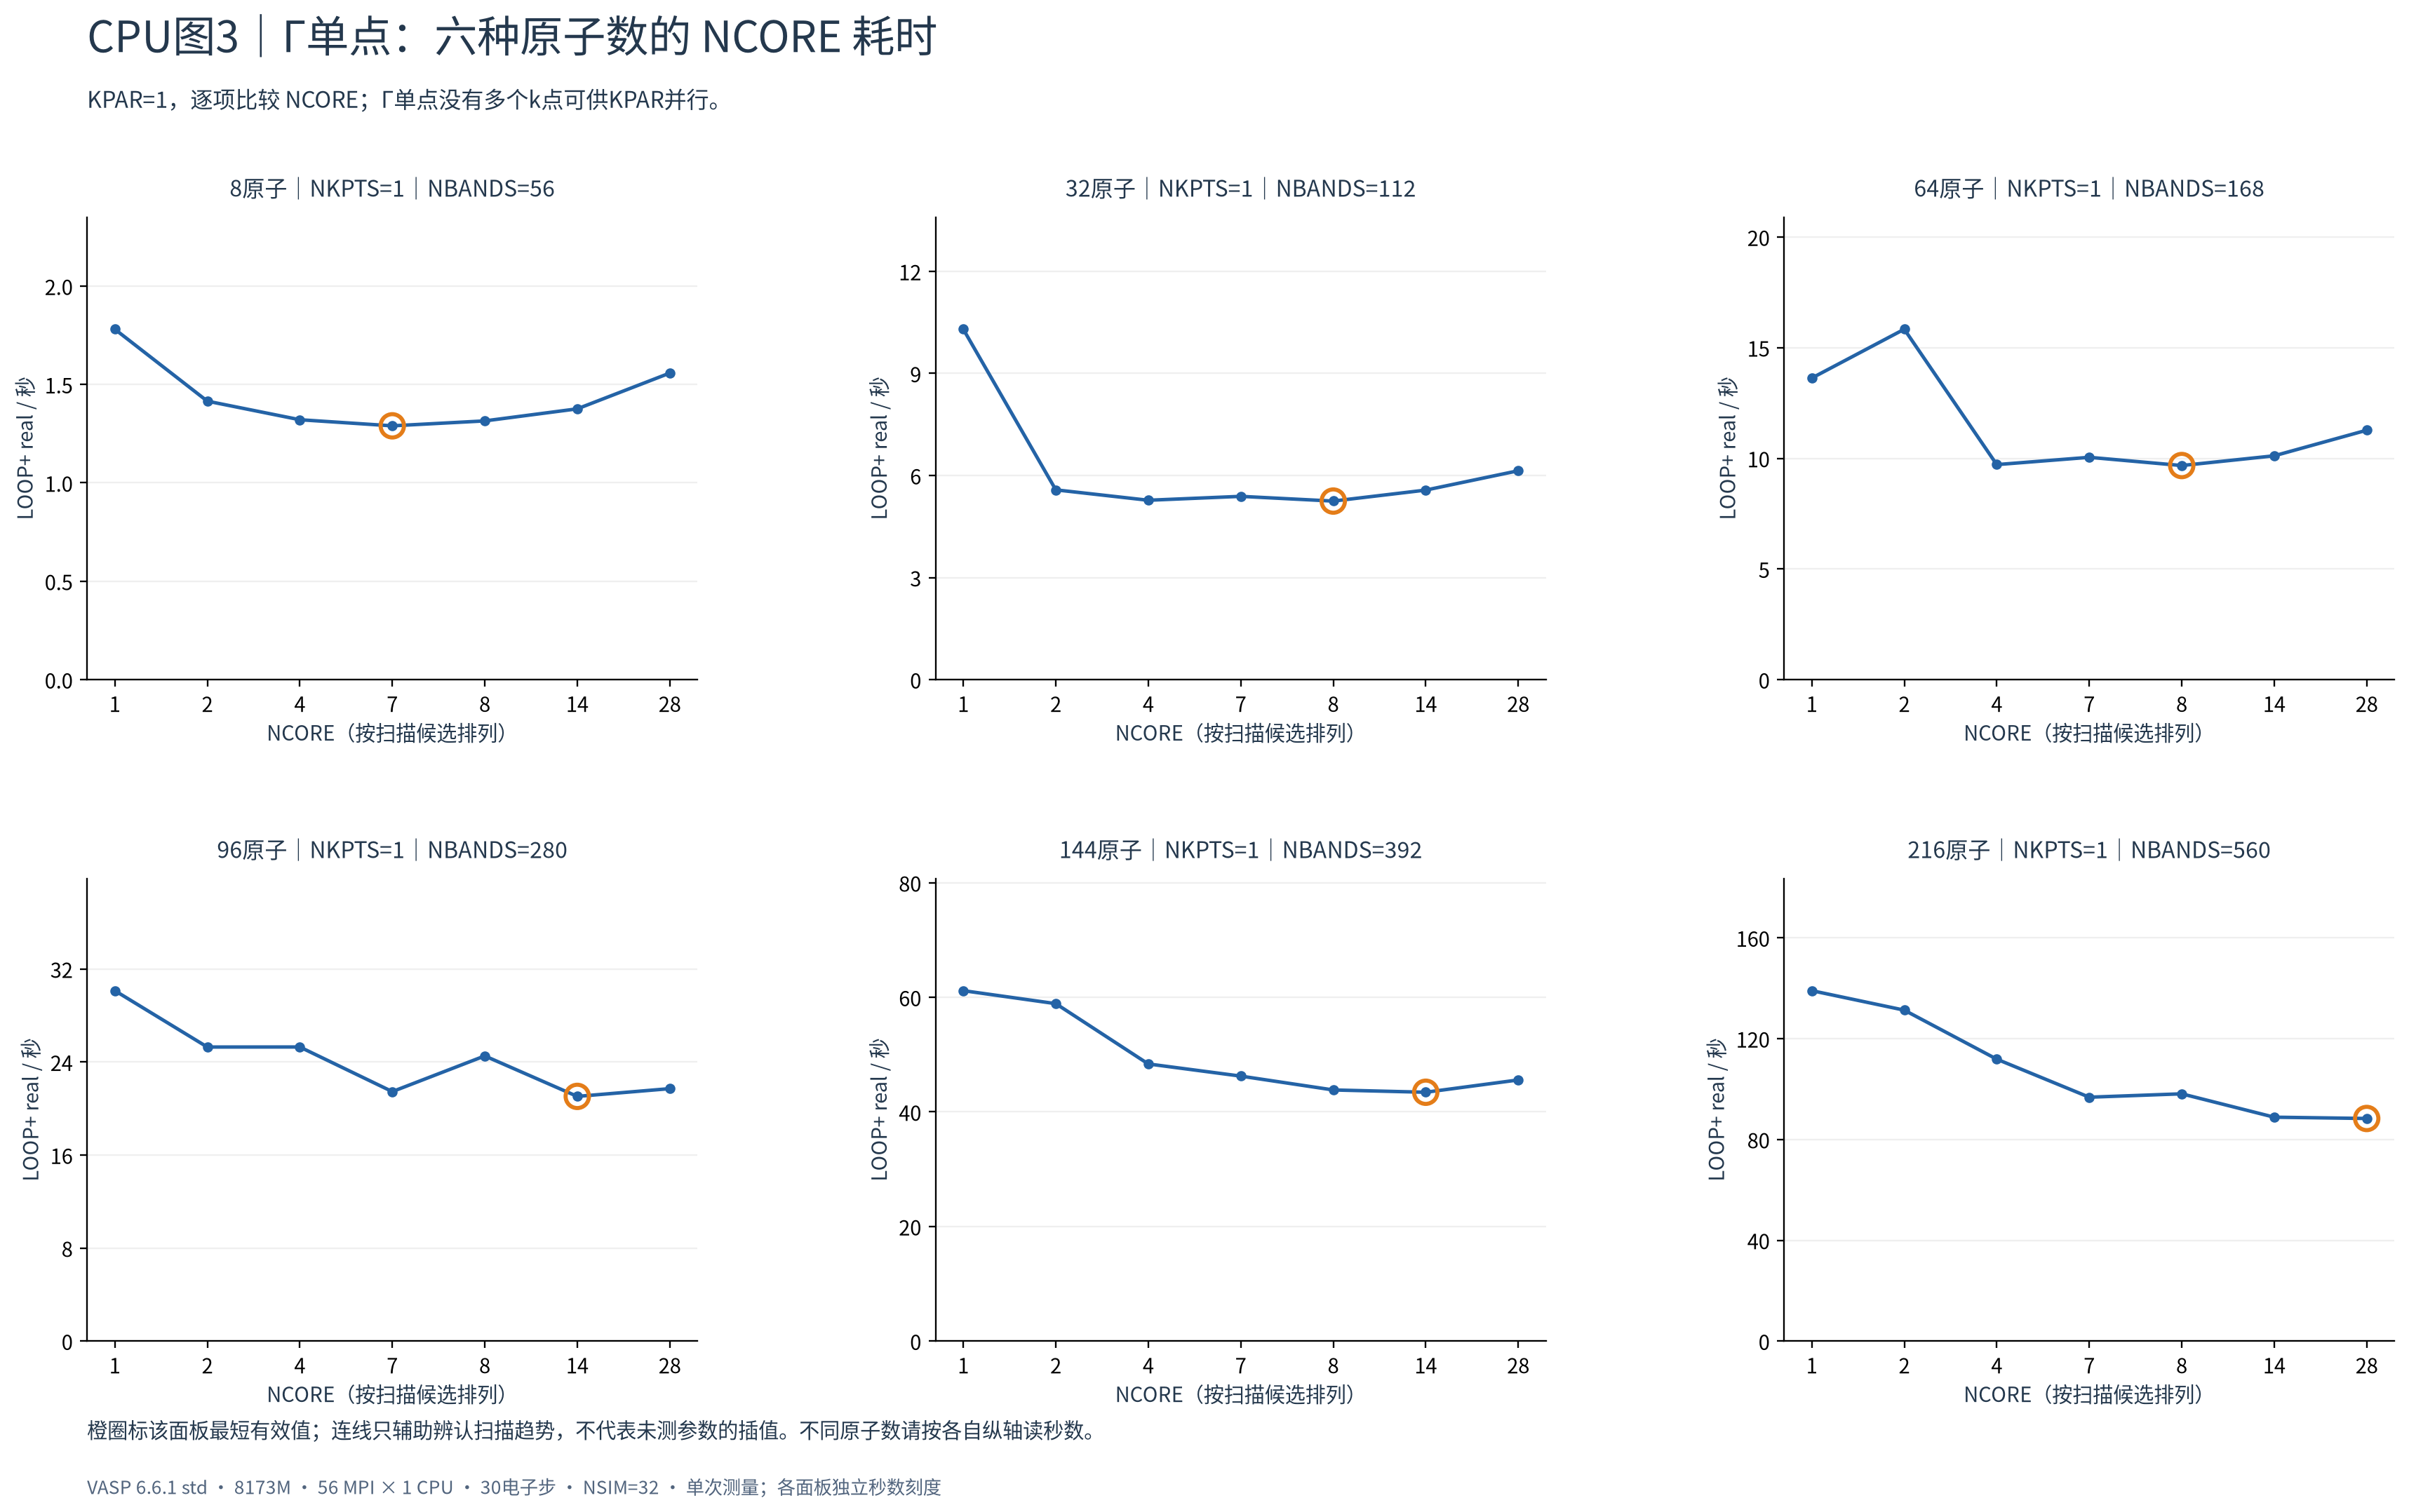
CPU图3:Γ单点,KPAR固定为1,每个原子规模单独显示NCORE与秒数;橙圈标该面板最短值。这里使用普通vasp_std,不能作为专用vasp_gam的计时。
Γ点的32、64原子分别在NCORE=8时测得5.248、9.674秒,NCORE=4也很接近;96、144原子的最短值在NCORE=14,216原子在28。216原子的14与28分别为88.822和88.311秒,单次结果接近,不宜据此给出稳定的严格排名。8原子的最快时间约1.290秒,微小差异更容易受到运行波动影响。
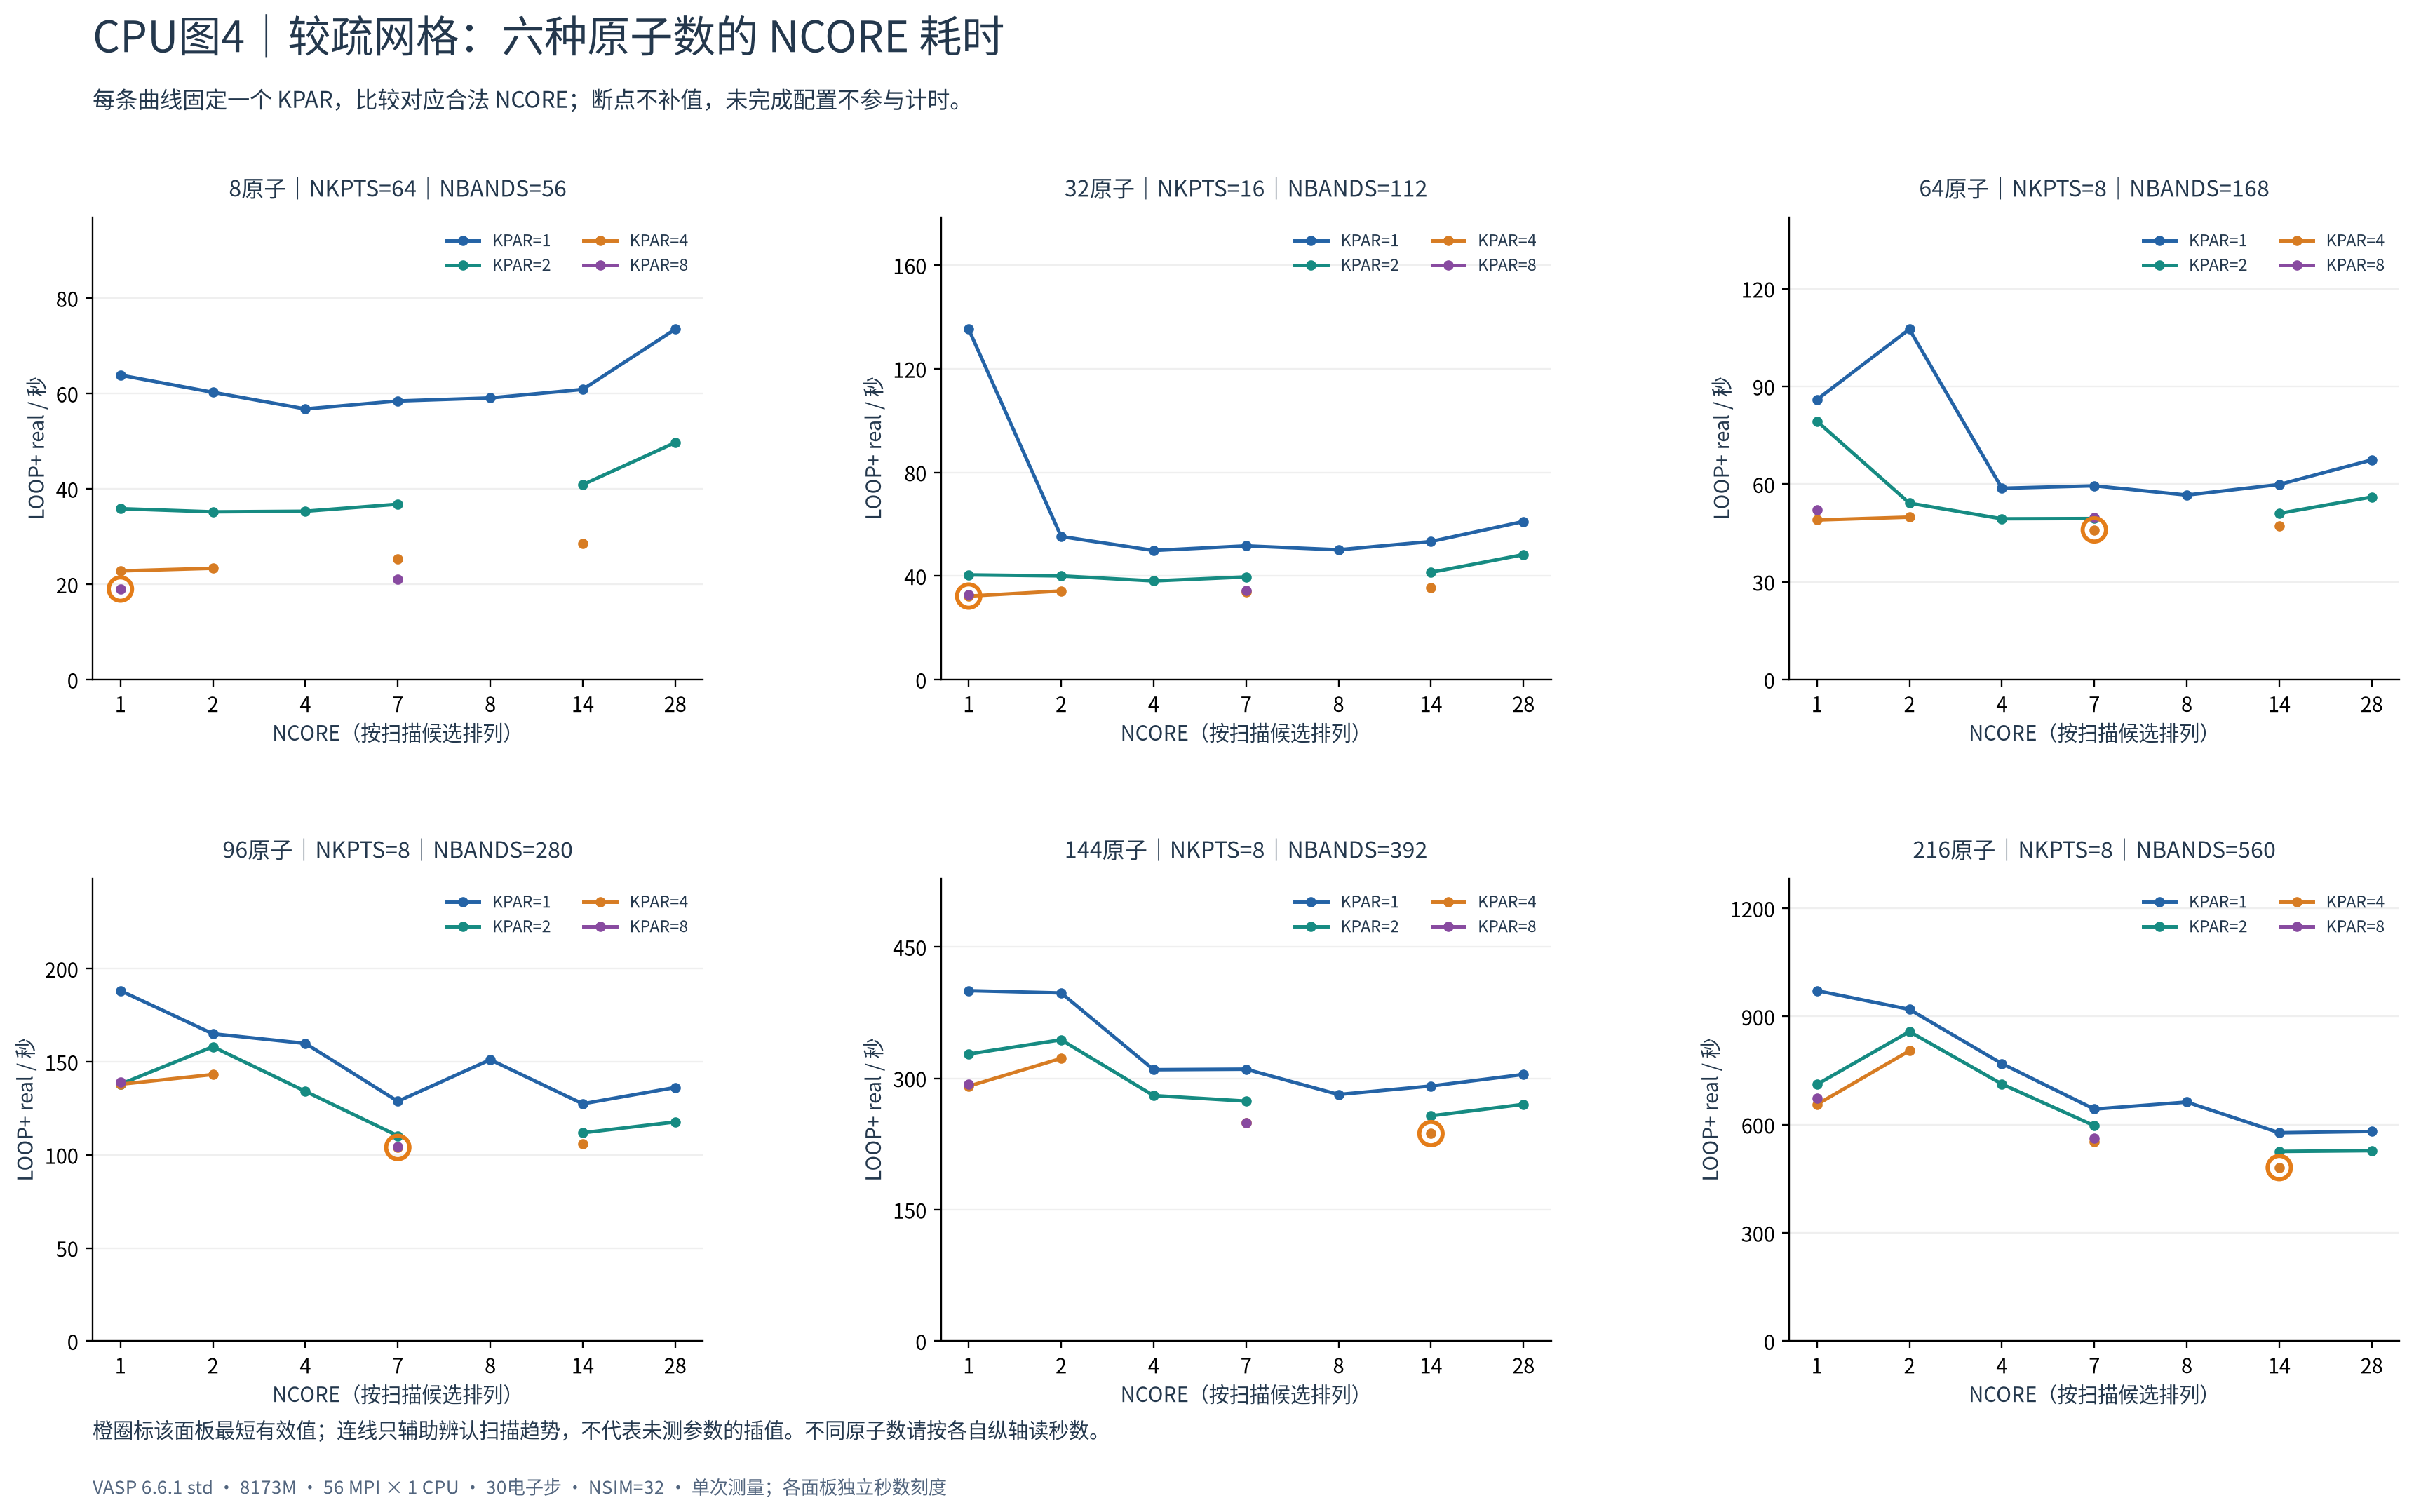
CPU图4:较疏网格,每条曲线固定KPAR,只比较对应合法NCORE。非法或未完成点不补值;曲线连接仅辅助识别已测候选。
这组图可以看出,NCORE的影响与KPAR有关:KPAR增加后每个k点组分到的MPI进程减少,可用NCORE候选也随之减少。不能脱离KPAR只说“NCORE越大越快”。例如144、216原子的KPAR=4曲线在NCORE=14较快,而8、32原子相应曲线的NCORE=1较快。
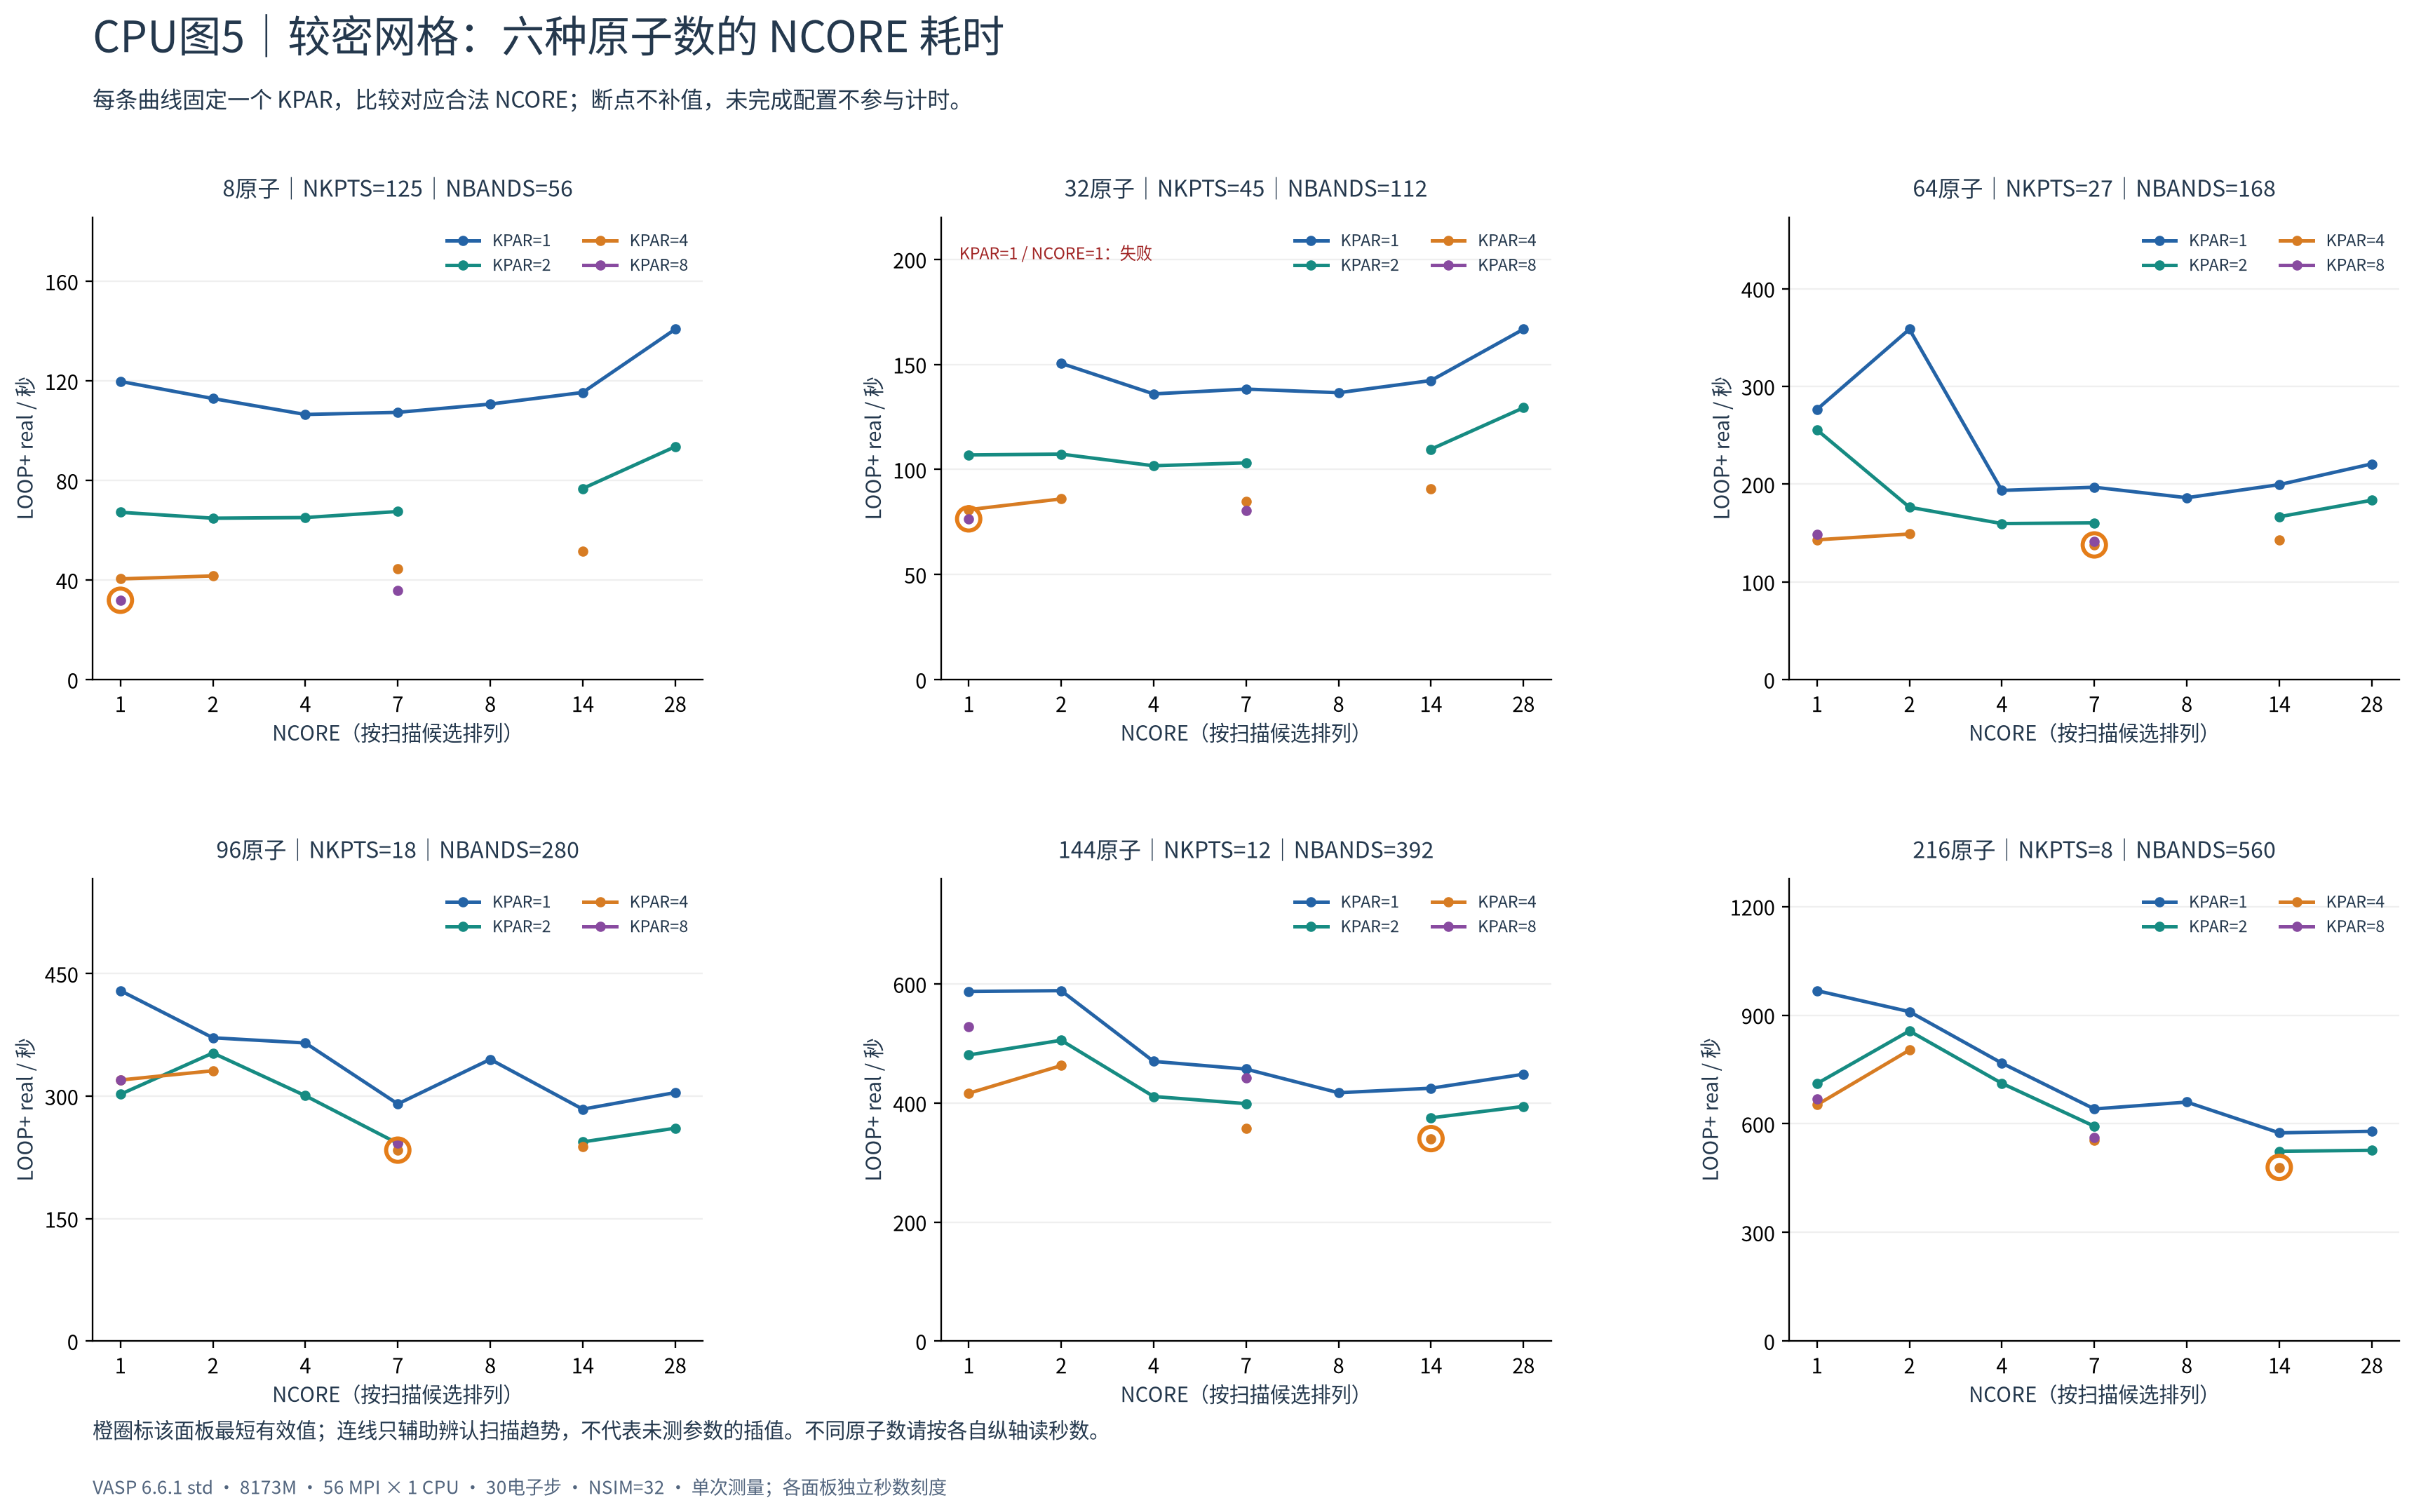
CPU图5:较密网格的全部NCORE曲线,失败配置保留缺口。各尺寸的实际NKPTS、NBANDS随面板给出,方便核对同一体系内的比较条件。
较密网格并没有消除NCORE调优的必要性。对于64、96原子,KPAR=4/NCORE=7较好;对于144、216原子,还应比较同一KPAR下的NCORE=14。原扫描中某些最快组合对应等效NPAR=1,它们是这些特定输入的测量结果,不能作为所有材料的默认设置。
7.4 固定NCORE=7观察KPAR:分清参数本身的影响#
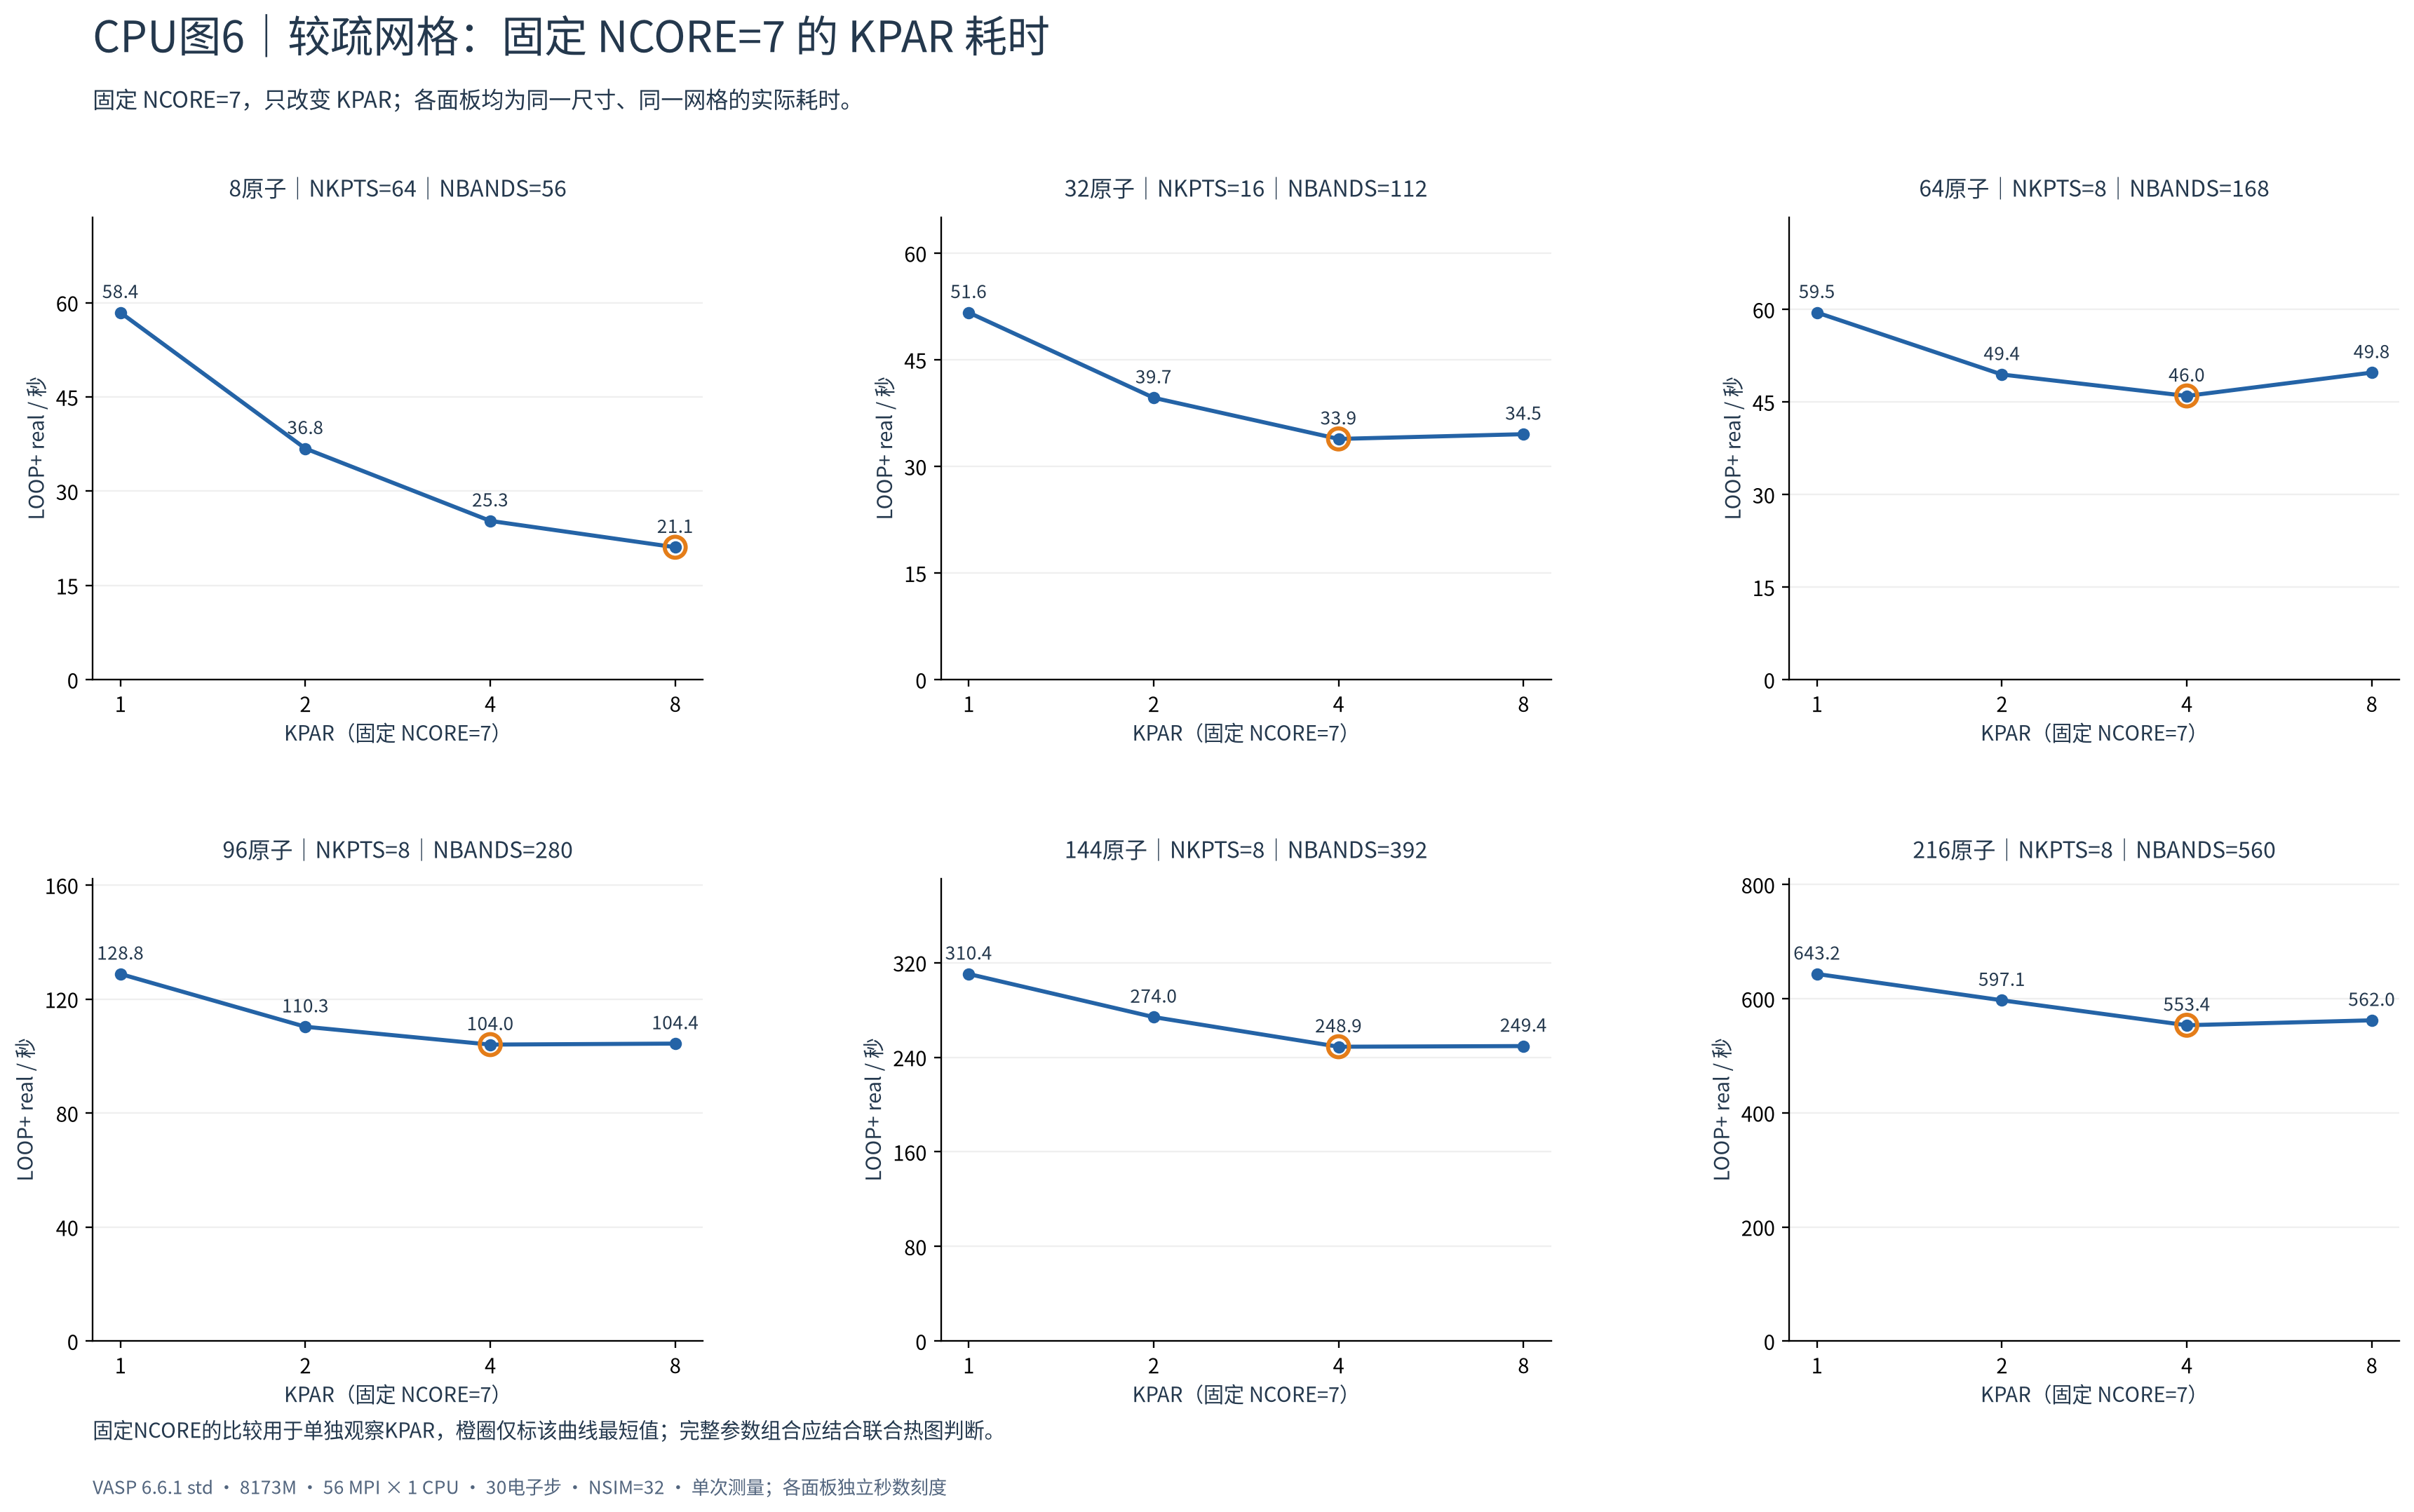
CPU图6:较疏网格,所有面板固定NCORE=7,横轴只改变KPAR。橙圈仅标这条固定NCORE曲线中的最短点,不一定等于联合热图的全候选最短值。
8原子在这条曲线上从KPAR=1增至8持续缩短耗时;32原子在4附近较好;64~216原子也应比较4与8,更多k点组并非必然更快。96原子的4与8分别为104.007、104.356秒,两者很接近。144、216原子的固定NCORE=7曲线还未使用它们在联合扫描中更快的NCORE=14,最终选择应返回图1核对。
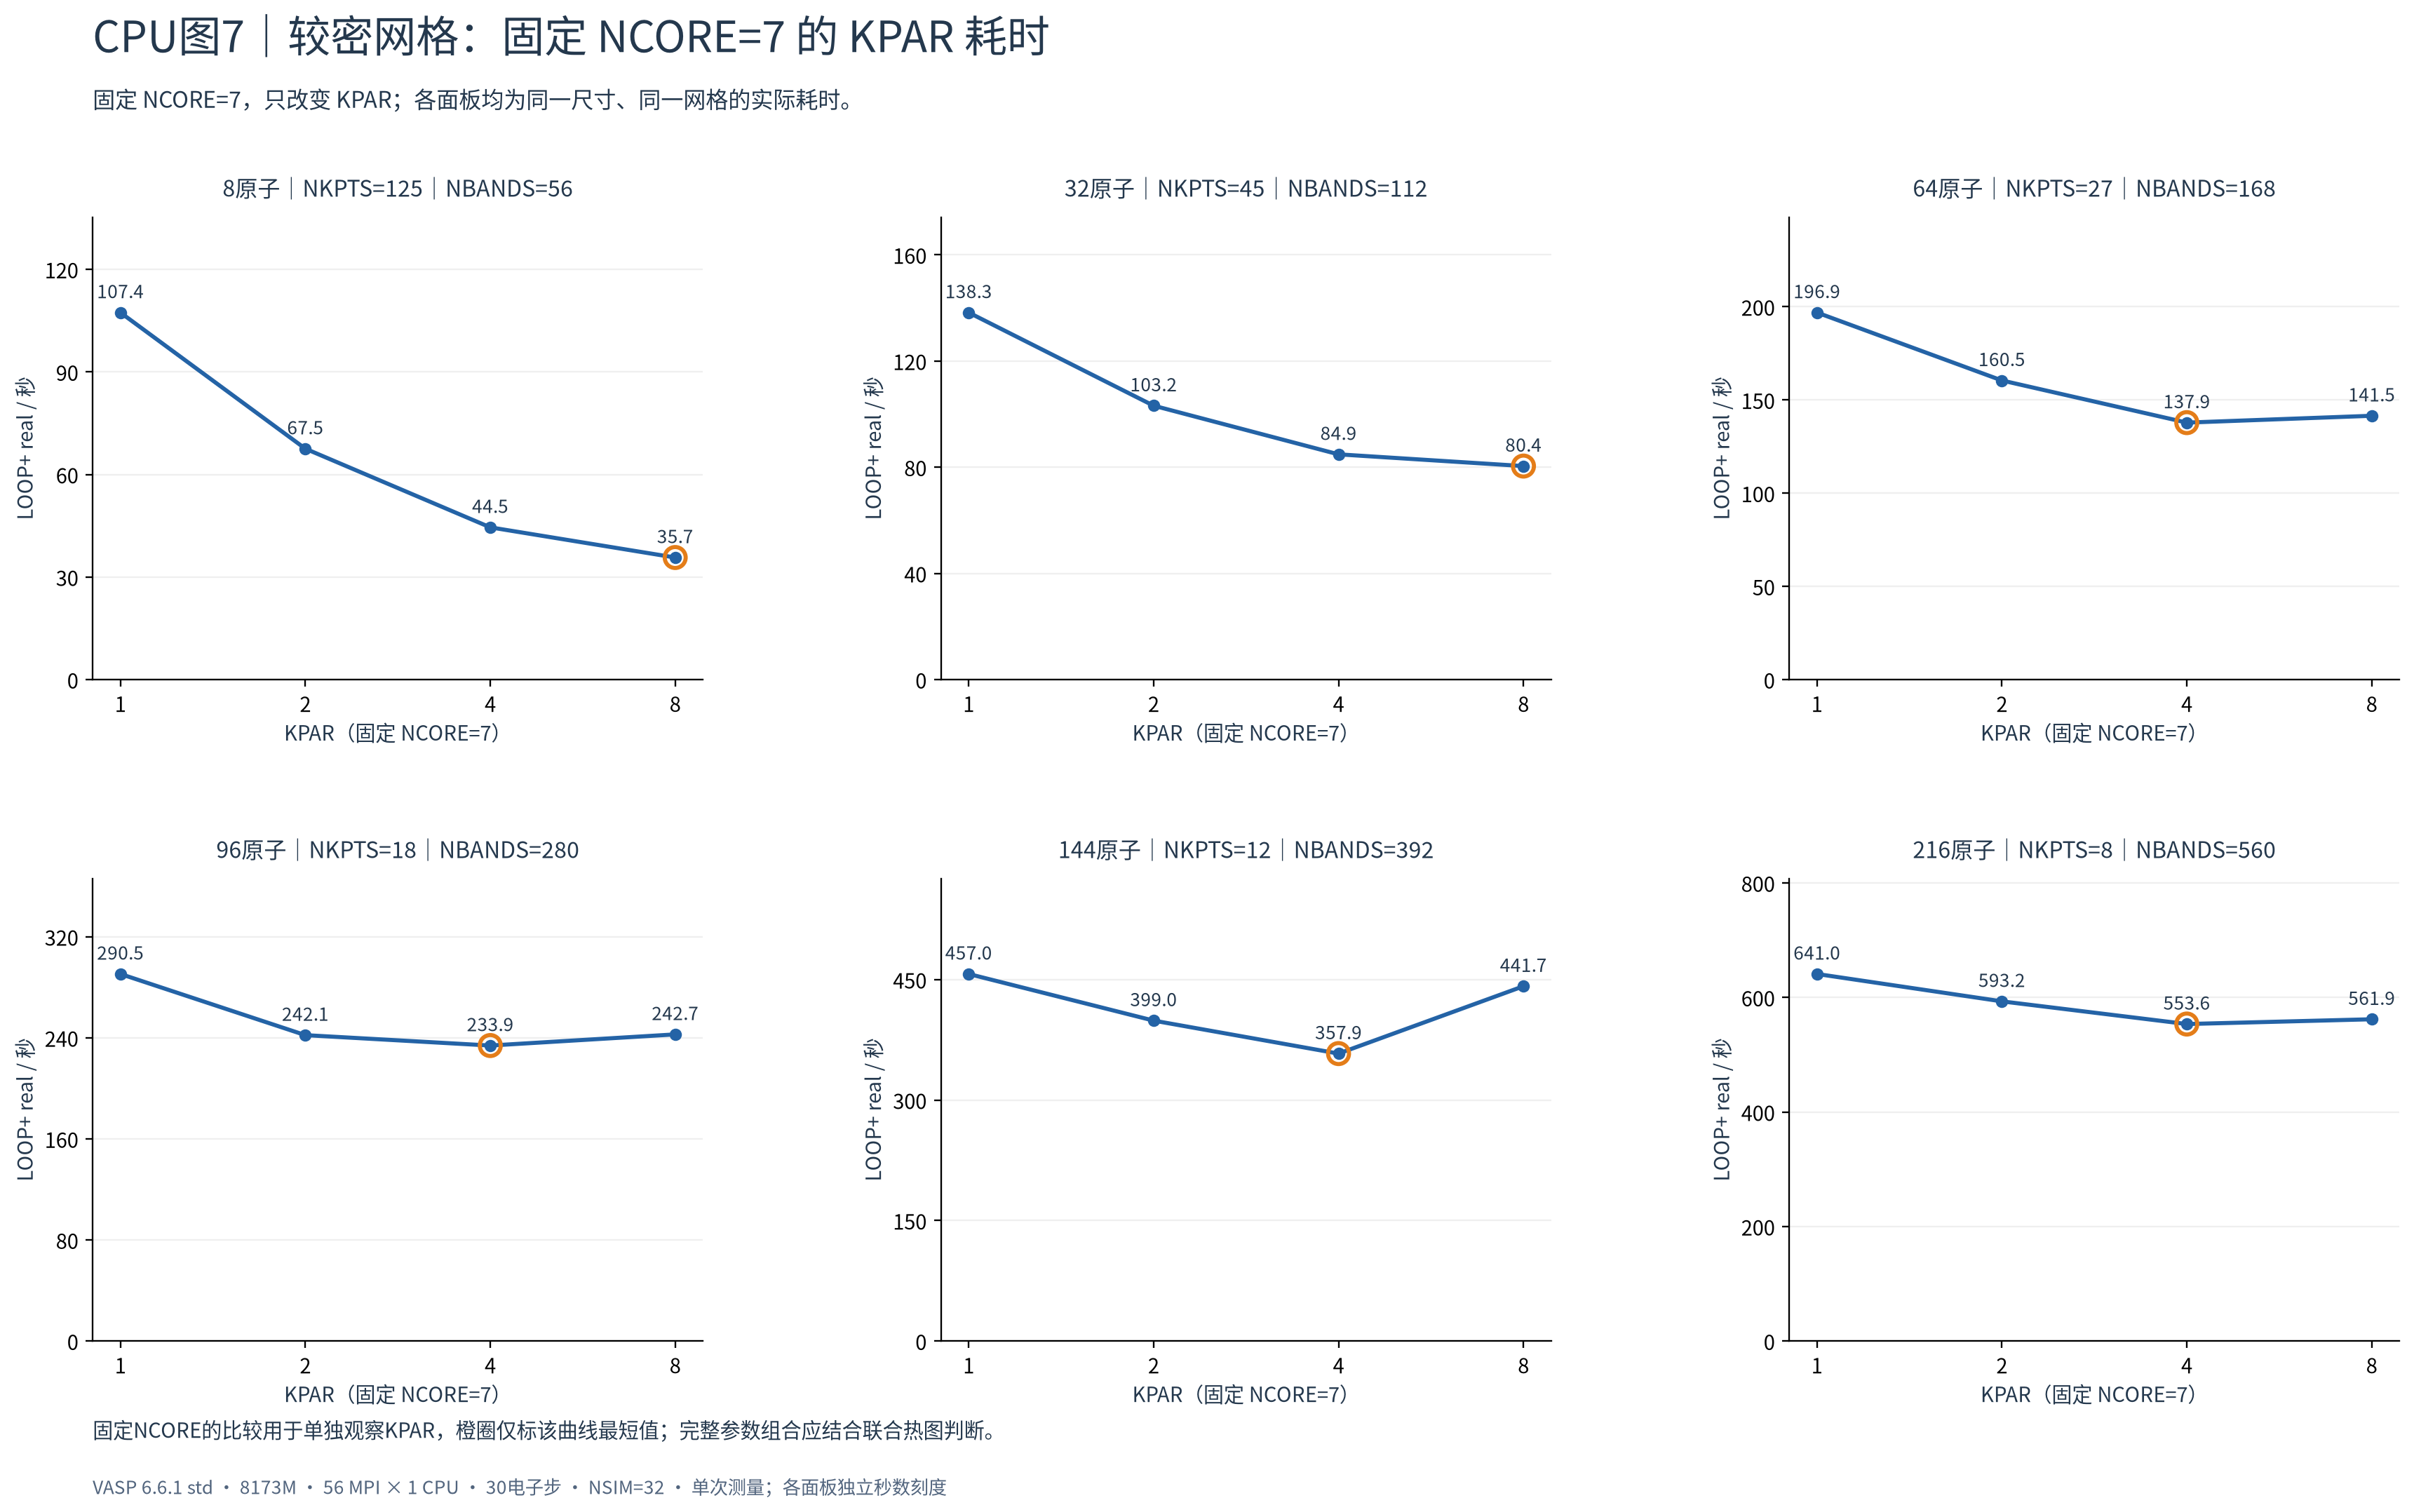
CPU图7:较密网格,仍固定NCORE=7;保持同一尺寸、网格、能带数及电子步数,便于独立观察KPAR变化。
在这条固定NCORE曲线上,8、32原子以KPAR=8较快,64~216原子以4较快。144原子从4增加到8,耗时由357.908秒增至441.736秒,说明k点组更多也可能带来额外开销。32原子的固定NCORE=7最短值为80.444秒,而图2中允许联合调整NCORE后为76.500秒;这正是需要同时检查两个参数的原因。
七图共使用原来的269条有效CPU结果,未生成新的性能测量,也未把第8节的补测或第9节的等价NPAR验证与原扫描混为一次扫描。全部数值、参数及来源可下载绘图数据CSV,PNG/SVG/PDF图件索引提供可放大的独立文件。
这些数据表明,不填写并行标签对应的 NCORE=1/KPAR=1 并非总是合适,NCORE也没有适用于所有规模的单一最优值。某些较大Si算例的已测最快配置对应NPAR=1;官方一般不推荐把它当作默认起点,本机这些特定输入的结果仍应如实保留,而不是据此推广“NPAR=1总是更快”。NPAR 的一般建议。
Si 原子数只是这些算例的规模标签。含半芯态赝势的过渡金属、较多空带、磁性/SOC、杂化泛函、大真空晶胞和不同ALGO都可能需要重新选择;本表没有验证它们的最优参数。
8. 补测:小体系可以尝试更大的 KPAR,但不能一味增加#
本次对8原子Si增加7/14/28/56等KPAR候选,NCORE=1,物理输入与原对应网格保持一致,并在同批重跑KPAR=8作为对照。各配置仍只运行一次,56MPI、固定30步。
| 原子数 / 实际 k 点 | KPAR | 每组MPI | NCORE | 实际 NPAR | LOOP+ real / s | 完整 Elapsed / s |
|---|---|---|---|---|---|---|
| 8 / 64 | 7 | 8 | 1 | 8 | 18.094 | 20.026 |
| 8 / 64 | 8 | 7 | 1 | 7 | 19.027 | 21.044 |
| 8 / 64 | 14 | 4 | 1 | 4 | 18.159 | 20.232 |
| 8 / 64 | 28 | 2 | 1 | 2 | 23.018 | 25.473 |
| 8 / 64 | 56 | 1 | 1 | 1 | 31.410 | 34.226 |
| 8 / 125 | 8 | 7 | 1 | 7 | 31.788 | 34.152 |
| 8 / 125 | 14 | 4 | 1 | 4 | 27.987 | 30.631 |
| 8 / 125 | 28 | 2 | 1 | 2 | 31.654 | 34.450 |
| 8 / 125 | 56 | 1 | 1 | 1 | 39.202 | 42.734 |
125点的同批比较中,KPAR=14相对8的LOOP+时间减少约12.0%;提高到28/56没有继续获益。64点时,7/14与8是接近的候选,56相对8耗时增加约65.1%。这说明点数均分和更多k点组都需要结合实际测试。
来源:本次12组定向补测。
这类小单胞与多k点计算值得比较更细的k点分组,但“合法的大KPAR”不自动意味着更快;组内效率、轮转分配尾部、公共工作和通信仍影响最终耗时。接近的单次结果用于选候选,不能当作重复测量后的稳定胜负。
9. 补测:NPAR 等价设置与覆盖优先级#
96原子Si、8个实际k点、280条能带、KPAR=4,比较以下三份输入。除NCORE/NPAR写法外,物理输入、总MPI数、NSIM与电子步数一致。
| INCAR写法(均 KPAR=4) | 实际 NCORE | 实际 NPAR | LOOP+ real / s | 完整 Elapsed / s |
|---|---|---|---|---|
| 只写 NCORE=7 | 7 | 2 | 104.213 | 108.451 |
| 只写 NPAR=2 | 7 | 2 | 103.793 | 108.019 |
| 同时写 NCORE=14、NPAR=2 | 7 | 2 | 104.133 | 108.332 |
三组均正常完成30步并有收敛标志;相对原同物理输入,能量与力在OUTCAR打印精度下均一致。启动输出都为“每条带7个进程、2个带组”,直接支持等价关系及NPAR优先级;这些Si对称结构的力为零,不能把该项当作非零力全面回归。
完整输入标签、实际分组和输出SHA见补测记录。
两种等价写法的耗时不必逐毫秒相同;系统状态和启动过程仍有波动。判断配置是否等价,首先看实际进程分组与完成/数值一致性,不能仅以时间完全相等作为标准。
10. 从自己的算例得到可靠参数#
先在生产目录之外准备参数试算,保持结构、POTCAR、k点、ENCUT、算法、自旋和输出要求一致;重启条件也统一。先做一次初始化,记录实际 NKPTS、NBANDS 与FFT网格,然后选少量合法候选。
| 步骤 | 做什么 | 记录什么 |
|---|---|---|
| 1 | 用同一56核模板和同一物理输入建立对照 | 版本、节点、MPI/线程、实际点数和能带 |
| 2 | 比较KPAR=1/2/4等适用值 | 每组进程数,完成时间与内存 |
| 3 | 每个KPAR内比较合法NCORE | 实际带组分布,不保留冲突NPAR |
| 4 | 比较前几名,并检查科学结果 | 能量、力、收敛、NaN/错误和是否完成 |
| 5 | 把合适值用于同类生产任务 | 不把试算的固定步数设置带到生产输入 |
这里也可以直接联合比较,例如8个实际k点的中等规模体系先试 (KPAR,NCORE)=(2,7)、(2,14)、(4,7)、(4,14)、(8,1)、(8,7)。它们全部合法;更全面的扫描应按第4节结合实际需求筛选。
短试算可以固定电子步数,例如本集群性能测量采用 NELM=NELMIN=30,使各组合比较相同工作量。它是计时协议,不表示生产计算必须至少30步或最多30步,也不表示达到步数就已收敛。正常生产应恢复适用于体系的收敛设置和足够的NELM。VASP 的短试算流程。
看实际分组,而不是只看 INCAR#
在Slurm标准输出中读取:
grep -m 1 'running.*mpi-ranks' 作业号.out
grep -m 1 'distrk:' 作业号.out
grep -m 1 'distr:' 作业号.out
56进程、KPAR=4、NCORE=7的典型信息为:
distrk:  each k-point on   14 cores,    4 groups
distr:  one band on    7 cores,    2 groups
第一行确认k点组,第二行确认带组。若显示与预计不同,先检查NPAR遗留、进程数、线程模式、专门并行标签,以及该版本/算法的实际限制。
统一计时口径#
# 所有已输出LOOP+段的real time之和,单位秒
awk '/^[[:space:]]*LOOP\+:/ {s += $NF; n++} END {if(n) printf "LOOP+ real total = %.4f s\n", s}' OUTCAR

# VASP完整运行时间
grep 'Elapsed time (sec)' OUTCAR

# 完成标志与实际工作规模
grep 'General timing and accounting' OUTCAR
grep -m 1 'NKPTS' OUTCAR
grep -m 1 'NBANDS' OUTCAR
LOOP+适合比较相同电子/离子工作量,包含该段电子计算及后续工作;完整Elapsed包括更多初始化和输出开销。正式任务还应看从启动到收敛完成的总体时间。若改变ALGO导致步数变化,只比较单步快慢不足以决定整体收益。
NBANDS可能随并行分组自动向上调整。公平比较应核对输出中的实际NBANDS,并在满足所需空带的前提下保持相同工作量;不要仅因为输入写同一个NBANDS就认为实际一定相同。NBANDS 与并行分组。
11. 其他相关设置:先分清是否改变科学近似#
| 设置 | 在CPU队列的使用原则 |
|---|---|
NSIM |
是处理能带的批量,不是CPU核数;本文测试固定32,没有做CPU的完整NSIM优化。先固定,再按自己的算法比较 |
ALGO |
Normal/Fast等改变求解流程与收敛表现;本文证据来自Normal。比较完整收敛时间及结果后再采用 |
LREAL |
Auto对较大体系可能有性能收益,但包含投影近似,需与False检查误差;不能当作纯并行参数 |
LSCALAPACK |
当前CPU程序提供相应库;一般先沿用交付默认,不凭旧网络教程关闭 |
LWAVE、LCHARG、HDF5输出 |
只生成工作流确实需要的文件;重启、Bader、Wannier或后处理需要的数据仍应保留 |
ENCUT、k网格、PREC、收敛阈值 |
由研究的精度要求决定;比较NCORE/KPAR时保持一致 |
相关依据:NSIM、ALGO、LREAL、LSCALAPACK。
Γ单点与gam版本也要分开。 确实只有Γ点且满足gam功能限制的任务可以评估专用 vasp_gam,但本指南的时间表使用 vasp_std;不能把std计时当作gam加速结论。SOC/非共线等需要相应程序和方法限制核对,不能仅因k网格是1×1×1就换gam。
12. 为什么不把它直接改成 28MPI × 2线程#
本指南和已测CPU模板采用56MPI×1。混合并行需要程序确实支持OpenMP,并重新设置进程/线程绑定;仅修改OMP_NUM_THREADS或减少MPI进程,不能保证开启有效的混合加速。
对支持的混合版本,多线程运行时VASP会把NCORE重置为1,FFT工作由线程承担;MPI分组公式此时使用实际MPI数,而不是申请到的总CPU核数。MPI/OpenMP 与 NCORE。
例如28MPI×2线程仍申请整节点56核,但不是本表的56MPI参数环境。本轮没有进行混合并行的性能扫描,不把它写成已经验证更快的方案。当前普通6.6.1抽验链接为MKL sequential,未见OpenMP运行库/入口,实际选择线程模式前还应核对对应构建。
13. NEB、杂化、响应与扩展分支怎样用这份指南#
| 任务 | 可以沿用的部分 | 需要重新核对 |
|---|---|---|
| 普通结构优化/AIMD | 56核资源、分组规则、短试算方法 | 实际收敛和每离子步成本;固定结构测试不是完整优化性能 |
| NEB / 多IMAGES | 总MPI仍为56,分组公式增加IMAGES因子 | 每图像剩余进程、根/图像目录设置;图像数由研究需求决定 |
| 杂化泛函 | 资源配置与合法性检查 | 所用算法和交换工作可能改变最优分组,不能套Si-PBE耗时 |
| GW/RPA/BSE/DFPT | 检查并行标签及实际输出的原则 | 专门频率/算法并行与相关限制,普通SCF公式需调整 |
| VTST/sol/sol++/optcell/Wannier/HDF5 | 对应8173m模块与56核模板 | 功能适配、附加工作和结果验证;不同分支独立选择 |
有IMAGES时,普通MPI分组可先写为 56 = IMAGES × KPAR × NCORE × NPAR;其他算法标签再另计。例如IMAGES=7、KPAR=1时,每图像8MPI,NCORE=4对应NPAR=2。这只是整数分组示例,不是对NEB图像数或最快配置的推荐。并行层次与专门标签。
14. 常见配置问题速查#
| 现象 | 优先检查 |
|---|---|
| 改NCORE后实际带组不变 | 是否还保留NPAR;是否启用了线程/GPU或其他分组 |
| KPAR=4、NCORE=4报错或分组不符合预期 | 56/4=14不能被4整除,改为合法值 |
| 只有一个实际k点,却设置KPAR=8 | 采用KPAR=1,再调组内NCORE |
| 多k点用更大的KPAR反而慢 | 同时看组内NPAR/NCORE、点分配尾部、公共工作与内存 |
| 总核申请正确但实际启动进程少 | 查看mpirun的-np、SLURM_NTASKS与启动输出 |
| 56MPI又每进程开启56线程 | 已经超出56核;恢复匹配的进程×线程设置 |
| 两组时间不同,但实际能带也不同 | 先统一实际NBANDS及物理输入再比较 |
| 试算很快但生产结果不收敛 | 恢复生产收敛设置,检查算法/初始态,不把短计时当科学验收 |
15. 数据、来源与使用范围#
本文给出的是8173m单节点CPU帮助文档。VASP5.4.4~6.6.1的一般标签含义可以参考官方说明,但具体性能数据来自6.6.1;没有声称所有版本、扩展、材料和计算方法都通过同样参数的全量回归。
- 本次CPU指南与补测记录:协议、来源、完整参数和验收。
- 原CPU参数汇总:最短与5%范围内的已测组合。
- 原较疏网格完整测量。
- 原Γ与较密网格完整测量。
- 集群软件与提交指南、VASP多版本与扩展。
使用相同56核节点时,更快完成同一任务通常也能减少核时。选参数时同时考虑收敛后的完整时间和可用内存;以上分组与计时方法可直接用于自己的短试算,最终采用自己体系中完成且结果可靠的组合。