
LAMMPS显存与体系规模
逐卡显存、邻居表、长程网格和多MPI共享的影响。
阅读本篇目录
显存取决于实际加速实现和计算任务。原子数只能给出第一层尺度,邻居数、ghost原子、截断半径、skin、GPU数量、每卡MPI进程数、PPPM网格及所用fix/compute都可能改变占用。GPU包mixed与KOKKOS double分别测量,不能只看精度名称推算两者显存比例。
六档规模与单/多卡显存#
下面显示每次运行中最满的一张卡的采样最大值;每张卡独立读取NVML,目标间隔5ms,实际间隔保留在原始结果。该指标包含进程上下文及运行库,不能理解为瞬时峰值的数学保证,也不等于所有卡占用之和。不同卡占用不均时,容量由最满卡约束。
采样时间分辨率#
CSV逐行提供八张卡各自的最大值、采样次数,以及实际采样间隔的中位数、99分位和最长间隔;某次最长间隔并不能代表其通常采样频率。下面按平台汇总各有效任务的范围,不把目标5ms写成每次都精确达到5ms。
| 平台 | 有效显存记录数 | 各任务间隔中位数范围 / ms | 各任务99分位范围 / ms | 最长一次间隔 / ms |
|---|---|---|---|---|
| P100 | 143 | 5.132~5.239 | 5.152~16.176 | 5148.507 |
| V100 | 143 | 5.144~5.204 | 5.162~16.521 | 673.491 |
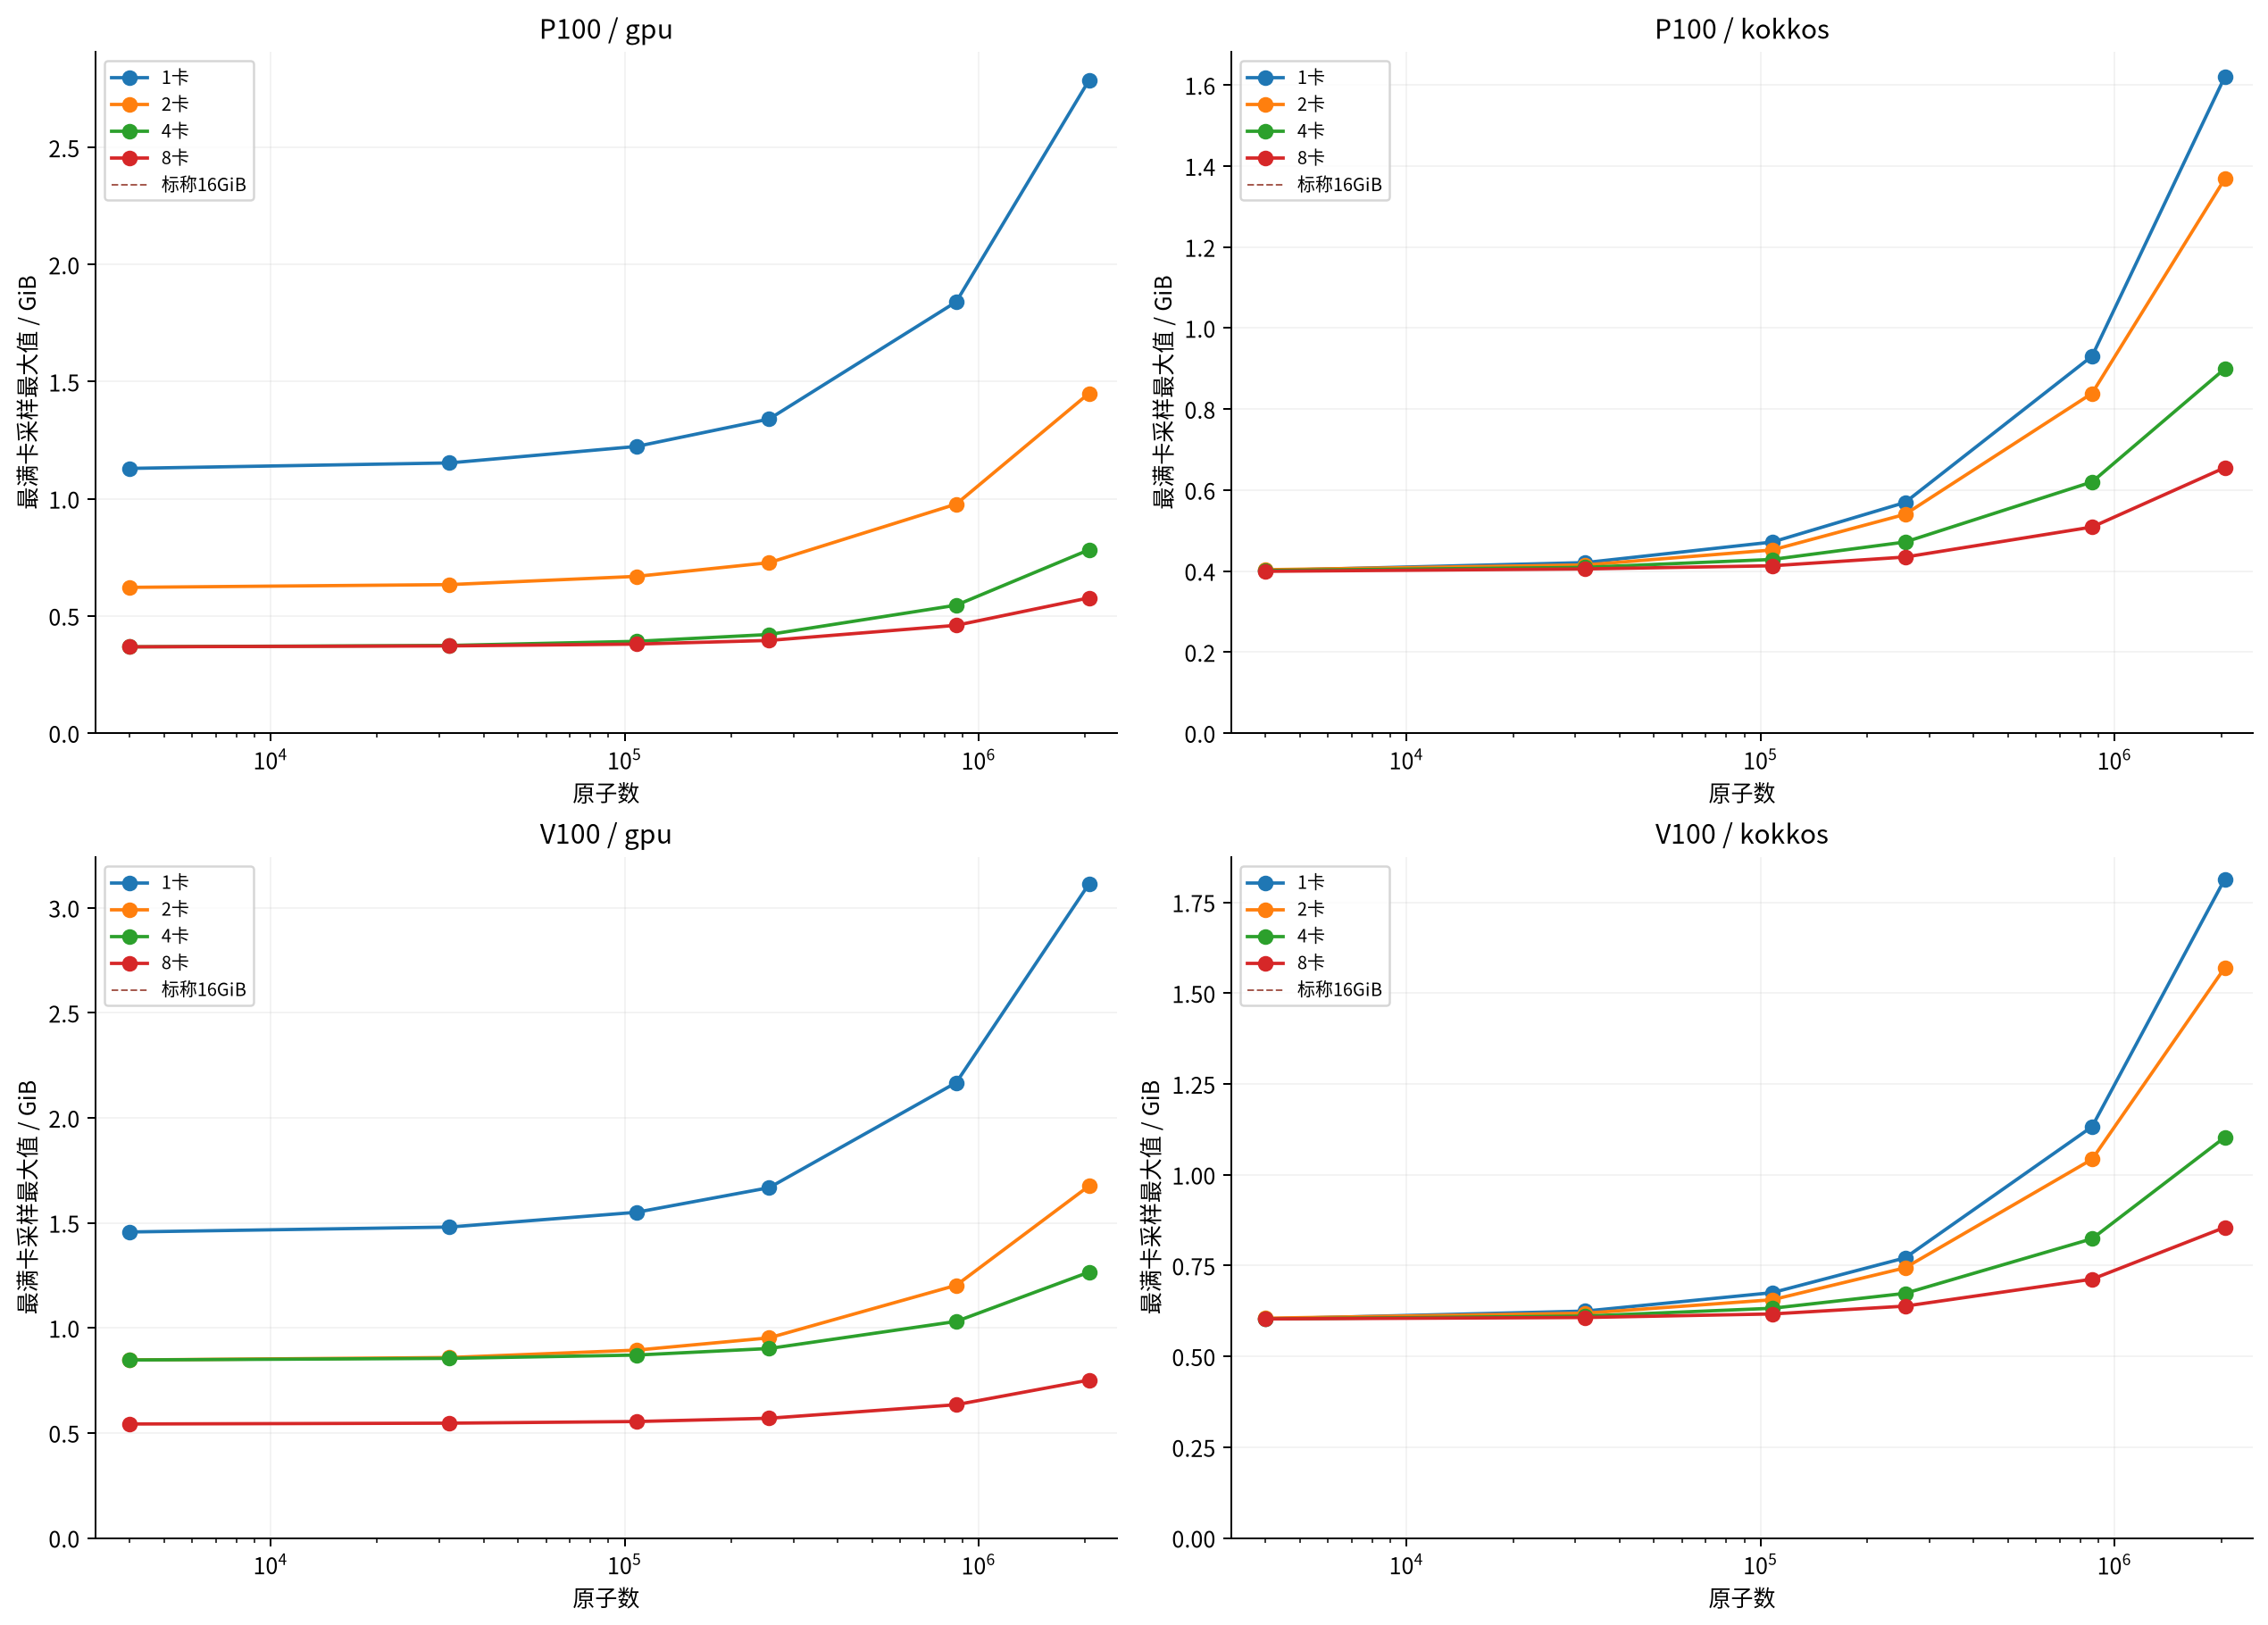
Cu / EAM:每卡显存随体系规模与卡数的变化
本次可用单卡数据范围:
- P100/gpu:4,000原子为1.130GiB,2,048,000原子为2.786GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- P100/kokkos:4,000原子为0.401GiB,2,048,000原子为1.620GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/gpu:4,000原子为1.457GiB,2,048,000原子为3.113GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/kokkos:4,000原子为0.603GiB,2,048,000原子为1.814GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
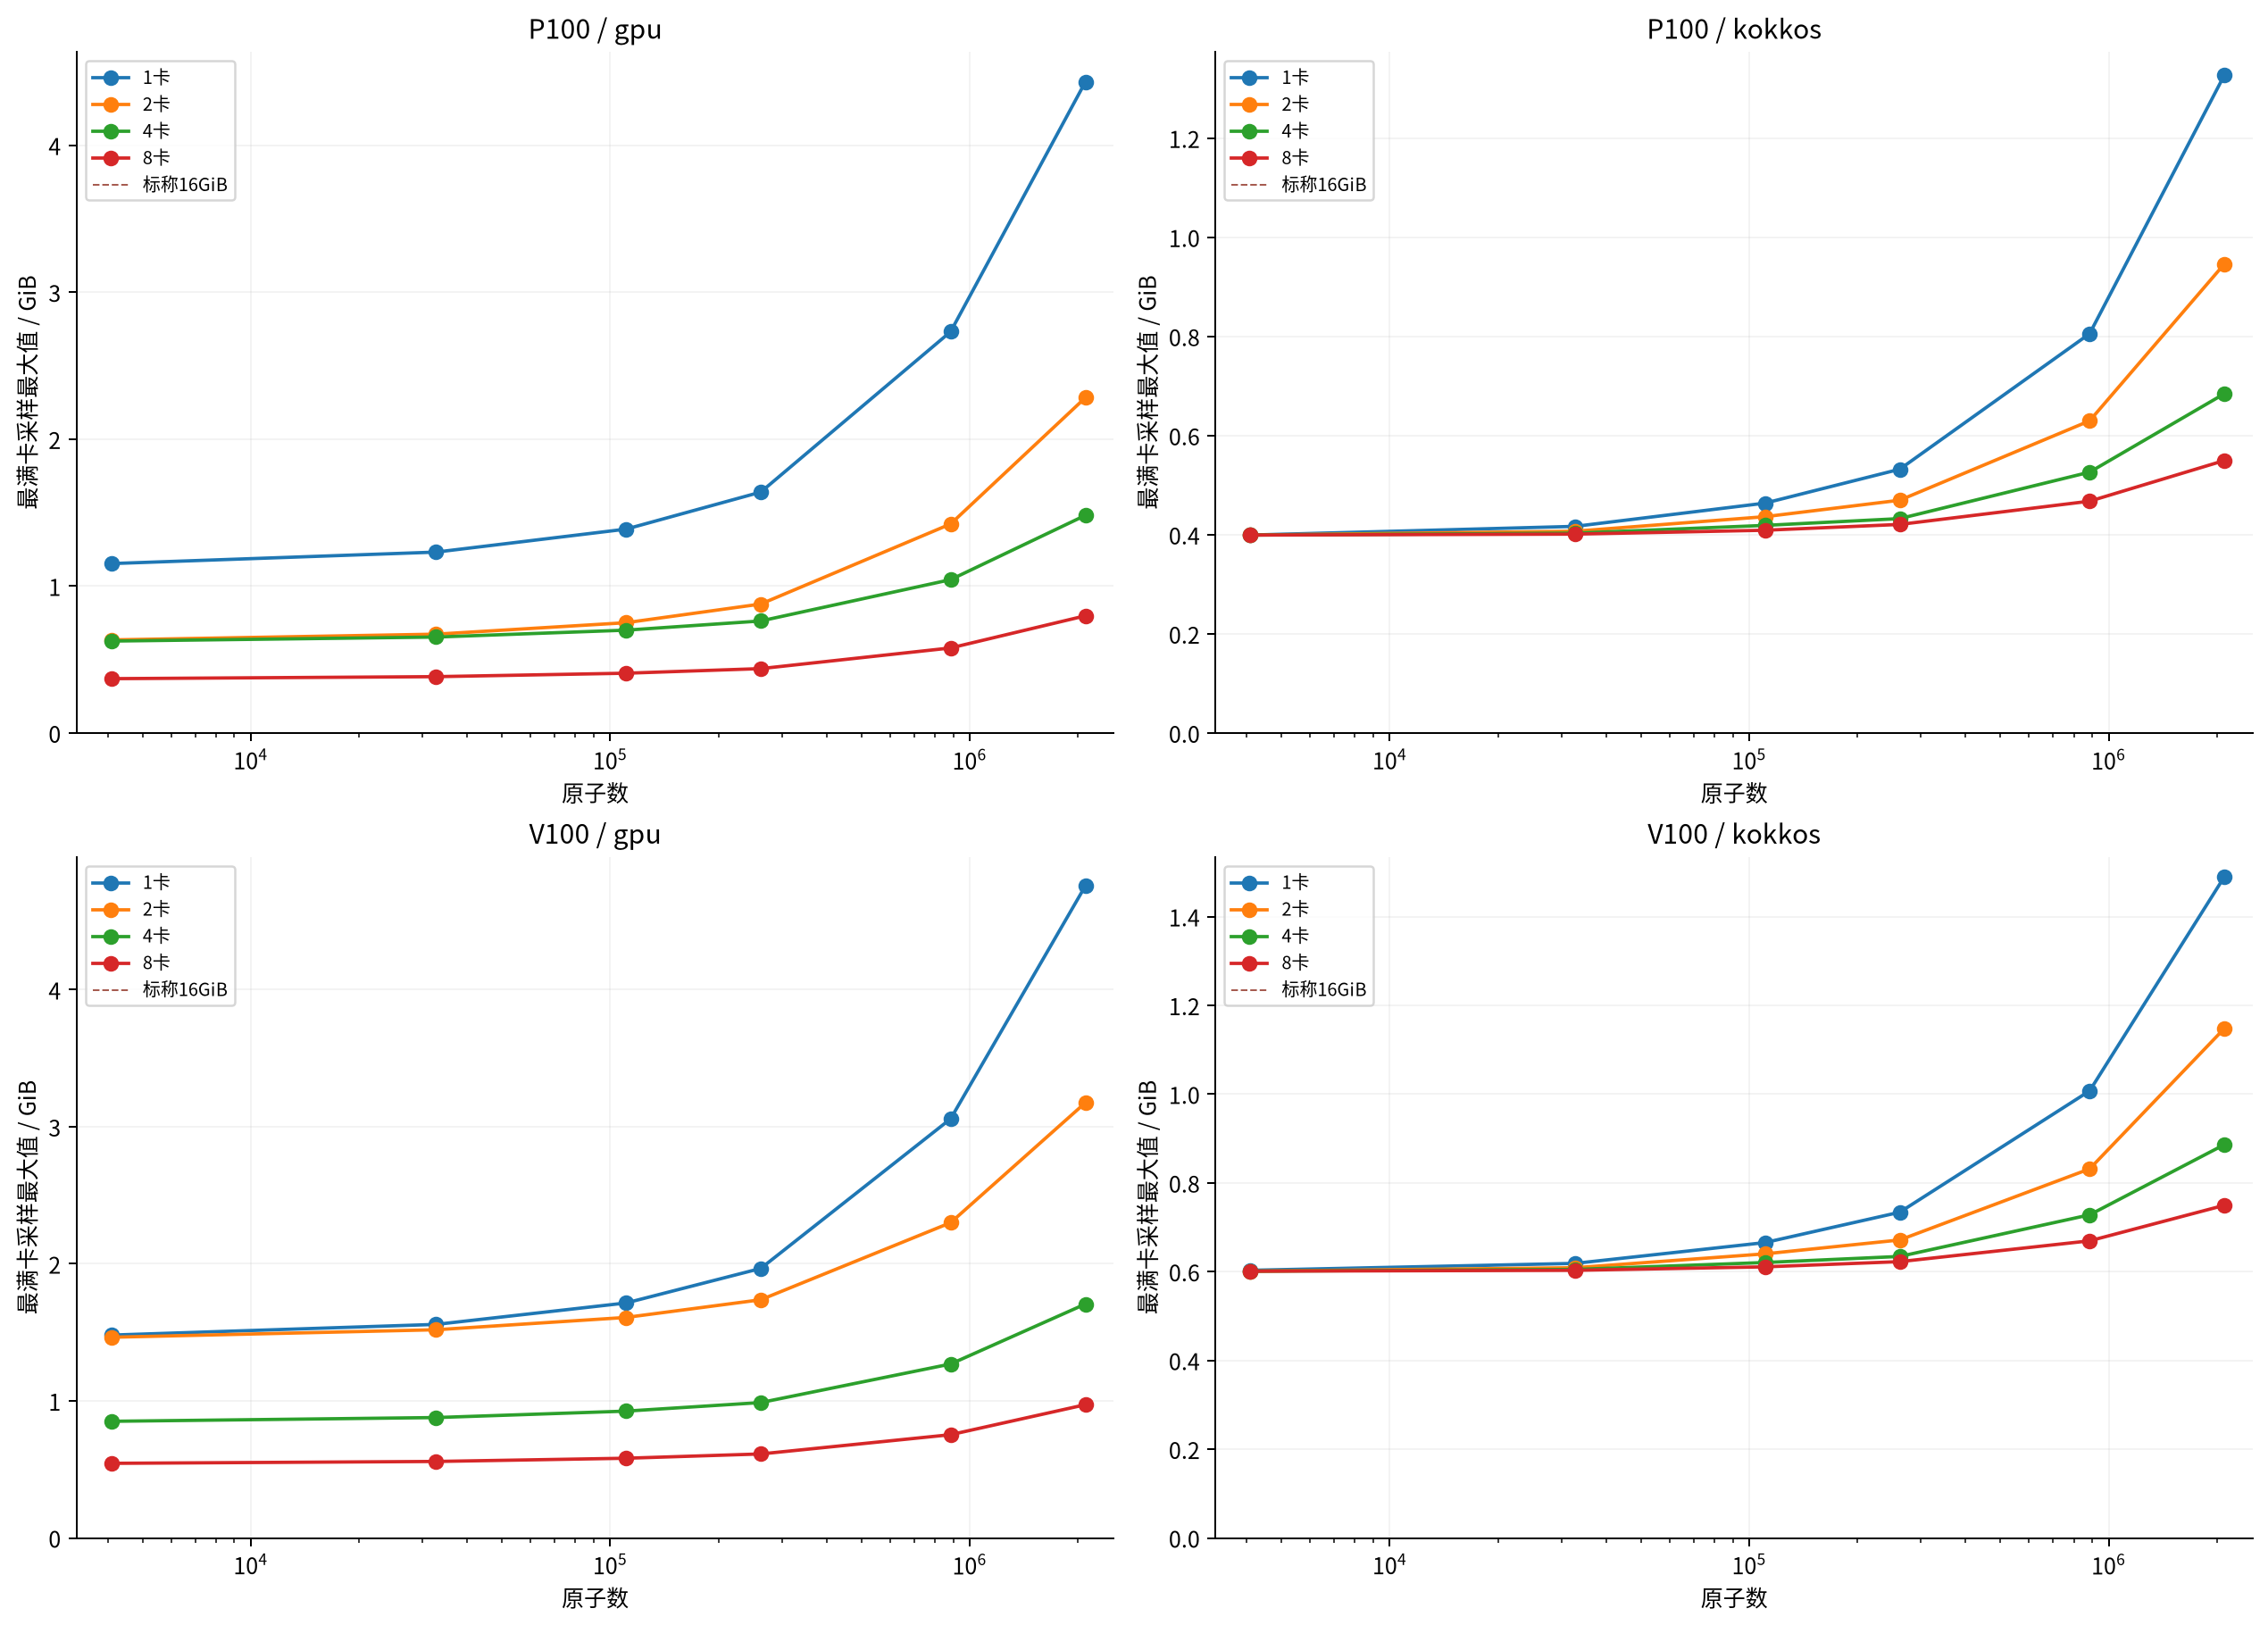
Si / Tersoff:每卡显存随体系规模与卡数的变化
本次可用单卡数据范围:
- P100/gpu:4,096原子为1.153GiB,2,097,152原子为4.431GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- P100/kokkos:4,096原子为0.399GiB,2,097,152原子为1.327GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/gpu:4,096原子为1.480GiB,2,097,152原子为4.757GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/kokkos:4,096原子为0.603GiB,2,097,152原子为1.490GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
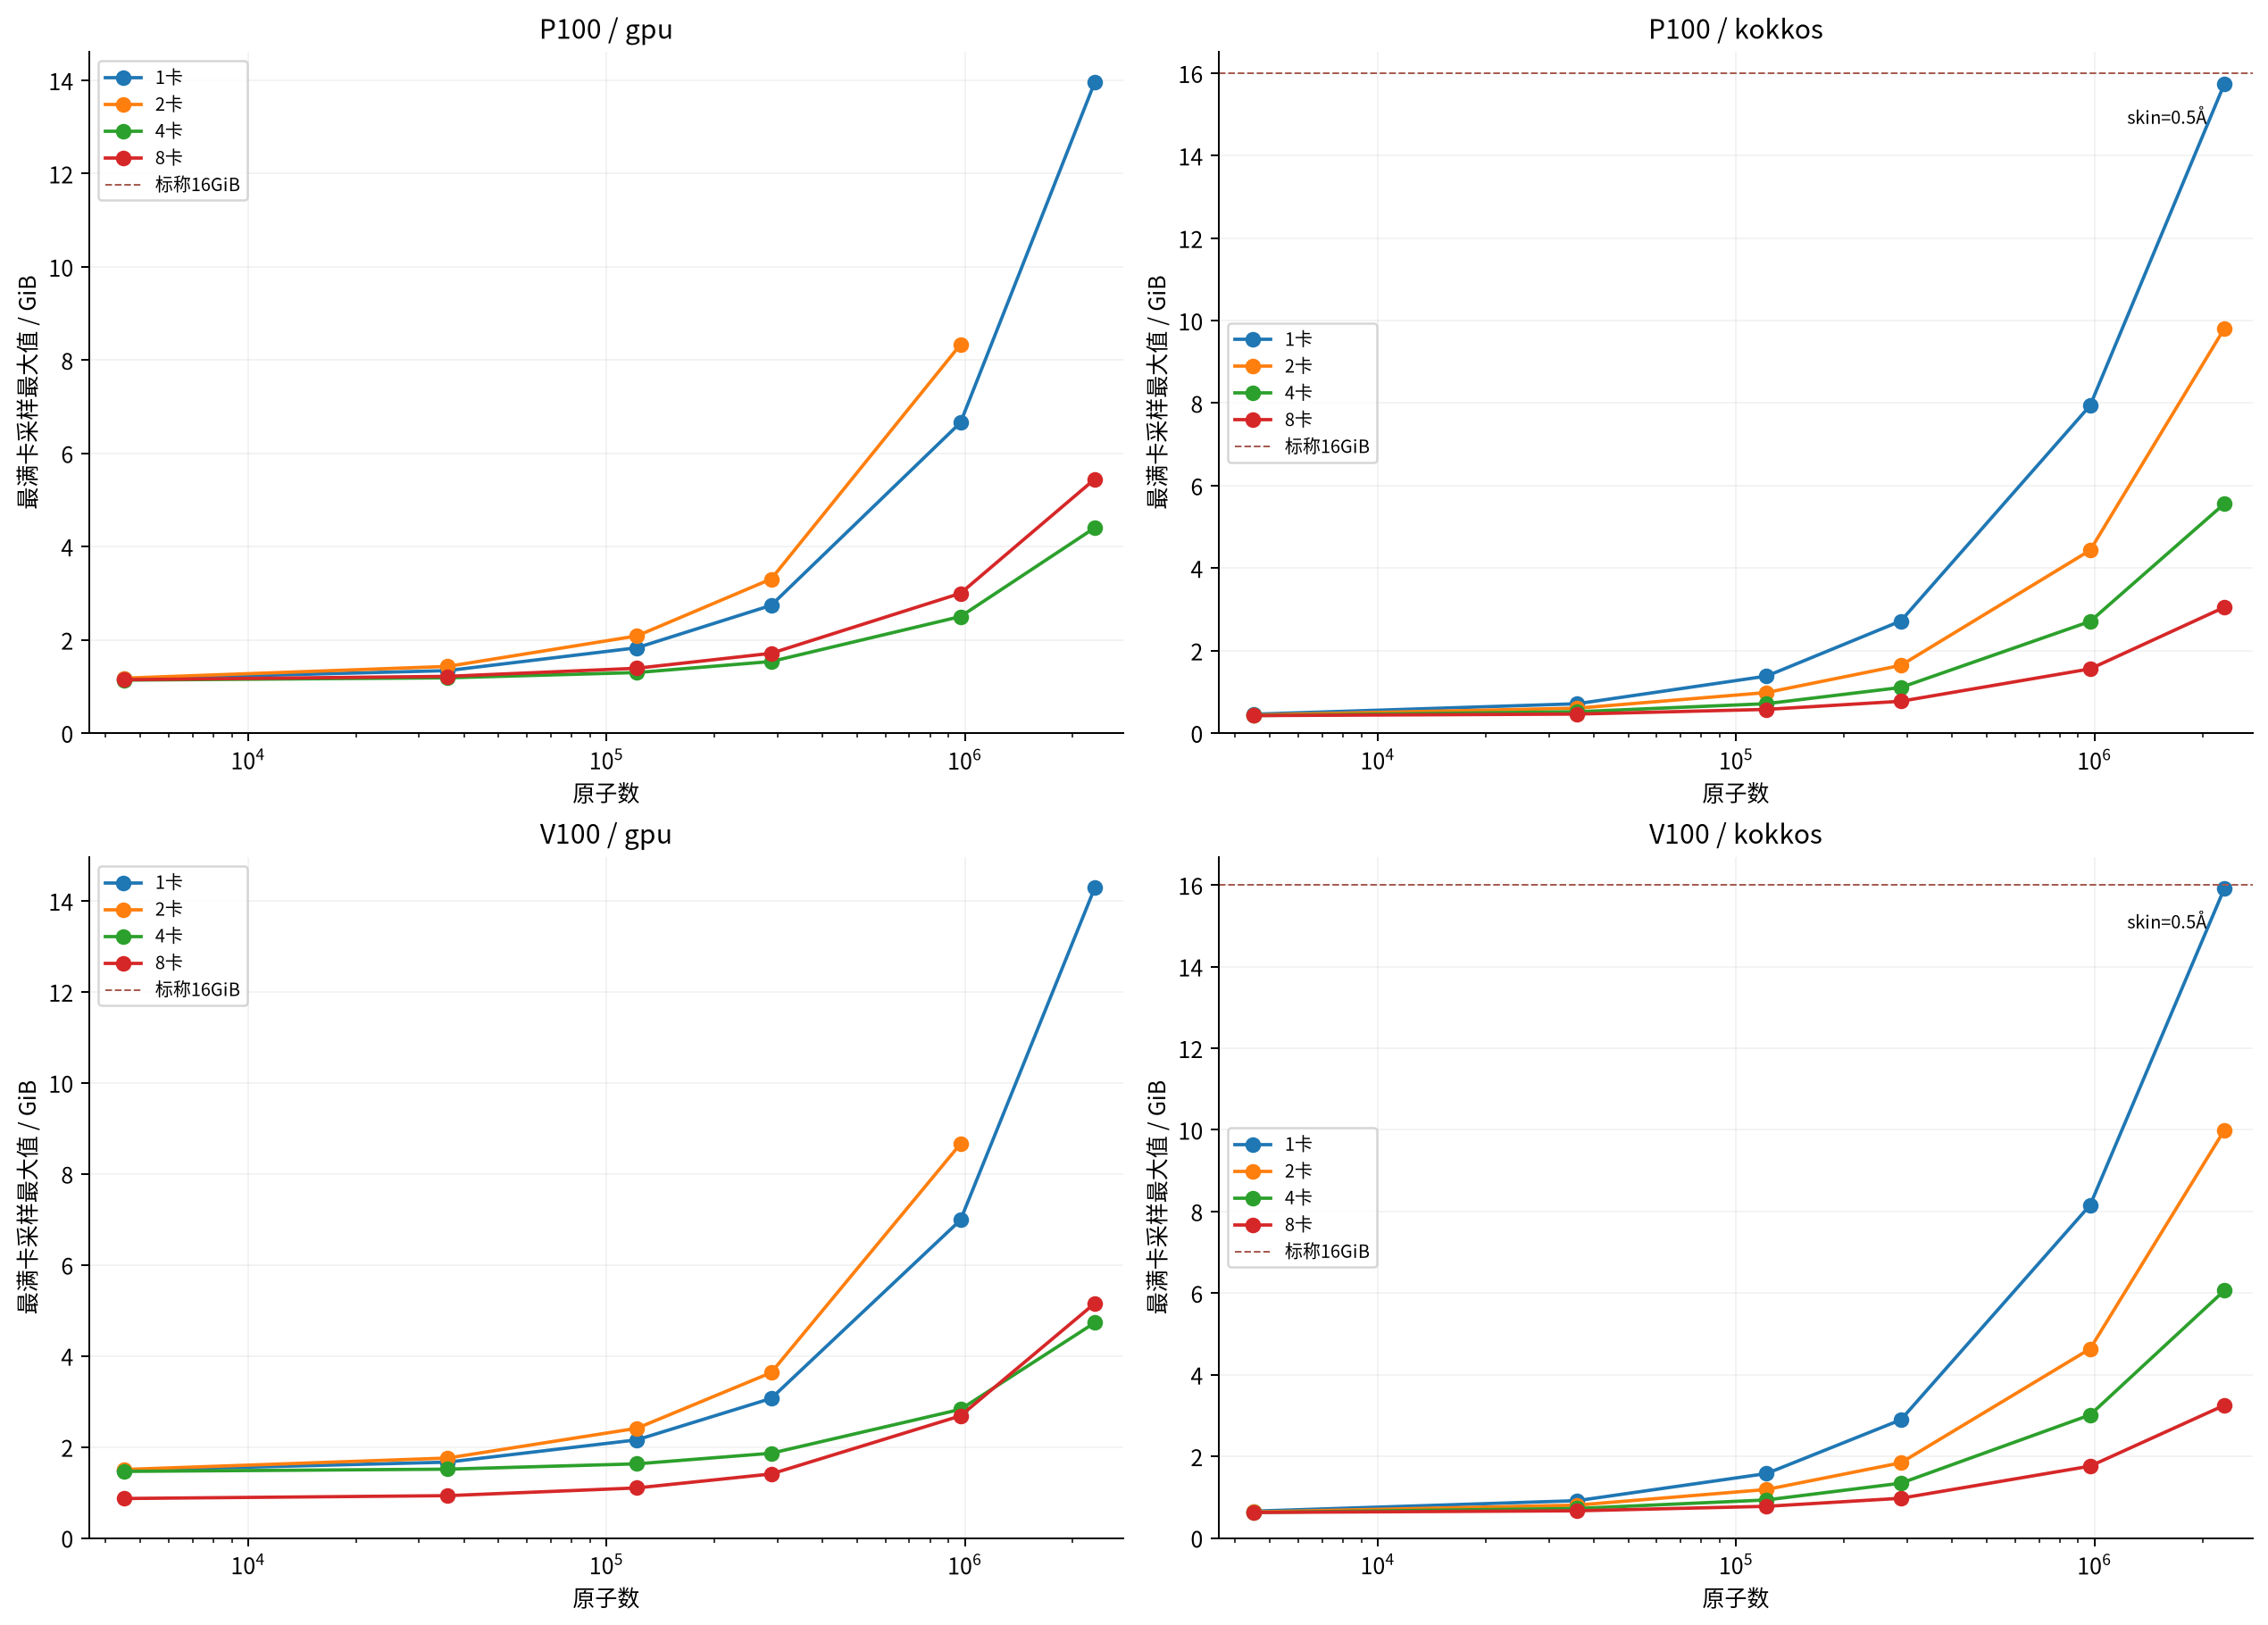
SPC/E 水 / PPPM:每卡显存随体系规模与卡数的变化
本次可用单卡数据范围:
- P100/gpu:4,500原子为1.161GiB,2,304,000原子为13.964GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- P100/kokkos:4,500原子为0.456GiB,2,304,000原子为15.743GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/gpu:4,500原子为1.488GiB,2,304,000原子为14.291GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
- V100/kokkos:4,500原子为0.656GiB,2,304,000原子为15.919GiB。只覆盖有效计算,不把容量不足或数值失败前的低占用加入曲线。
增加卡数通常降低每卡拥有的局部原子数,但ghost原子、通信缓冲、每进程上下文和不可完全分摊的数组仍然存在。因此每卡显存不保证严格按1/GPU数下降;小体系也可能由固定开销主导。显存曲线出现相近或非单调点时,应同时查看每张卡原始曲线、MPI布局和上下文开销,不仅凭一个峰值推断原因。
如果某个规模因分配失败改用了已验证的容量备选,曲线应结合实际参数一起阅读;这种折线展示可运行配置,不能解释为只改变原子数的严格控制实验。原失败前采到的低占用不作为容量优势。
最大水盒的单卡KOKKOS正式输入单独改用skin0.5Å,图中已标注;默认skin2Å的V100容量预检曾因邻居表分配失败,原记录保留。较小邻居缓冲会改变重建频率和性能,因此这个点不能当成默认skin2Å的容量结果。具体短测与正式状态见参数指南。
多MPI进程共享一张GPU的实测#
以下固定同一中等规模初态与力场,比较GPU包每卡1、2、4个MPI进程;每进程1线程,图中每条线固定GPU张数。PPPM保持默认GPU包分工,没有将pair/only额外候选混入。增加进程会同时改变空间分解、ghost通信和GPU上下文,因此不能只用“数组按卡数均分”解释占用。
这些是已完成且数值有效的调参短测,步数见CSV。部分水候选按预先记录的预算使用200步,其余500步;采样最大值是各自完整窗口的观察,不将微小差异解释为严格的长任务峰值排序。
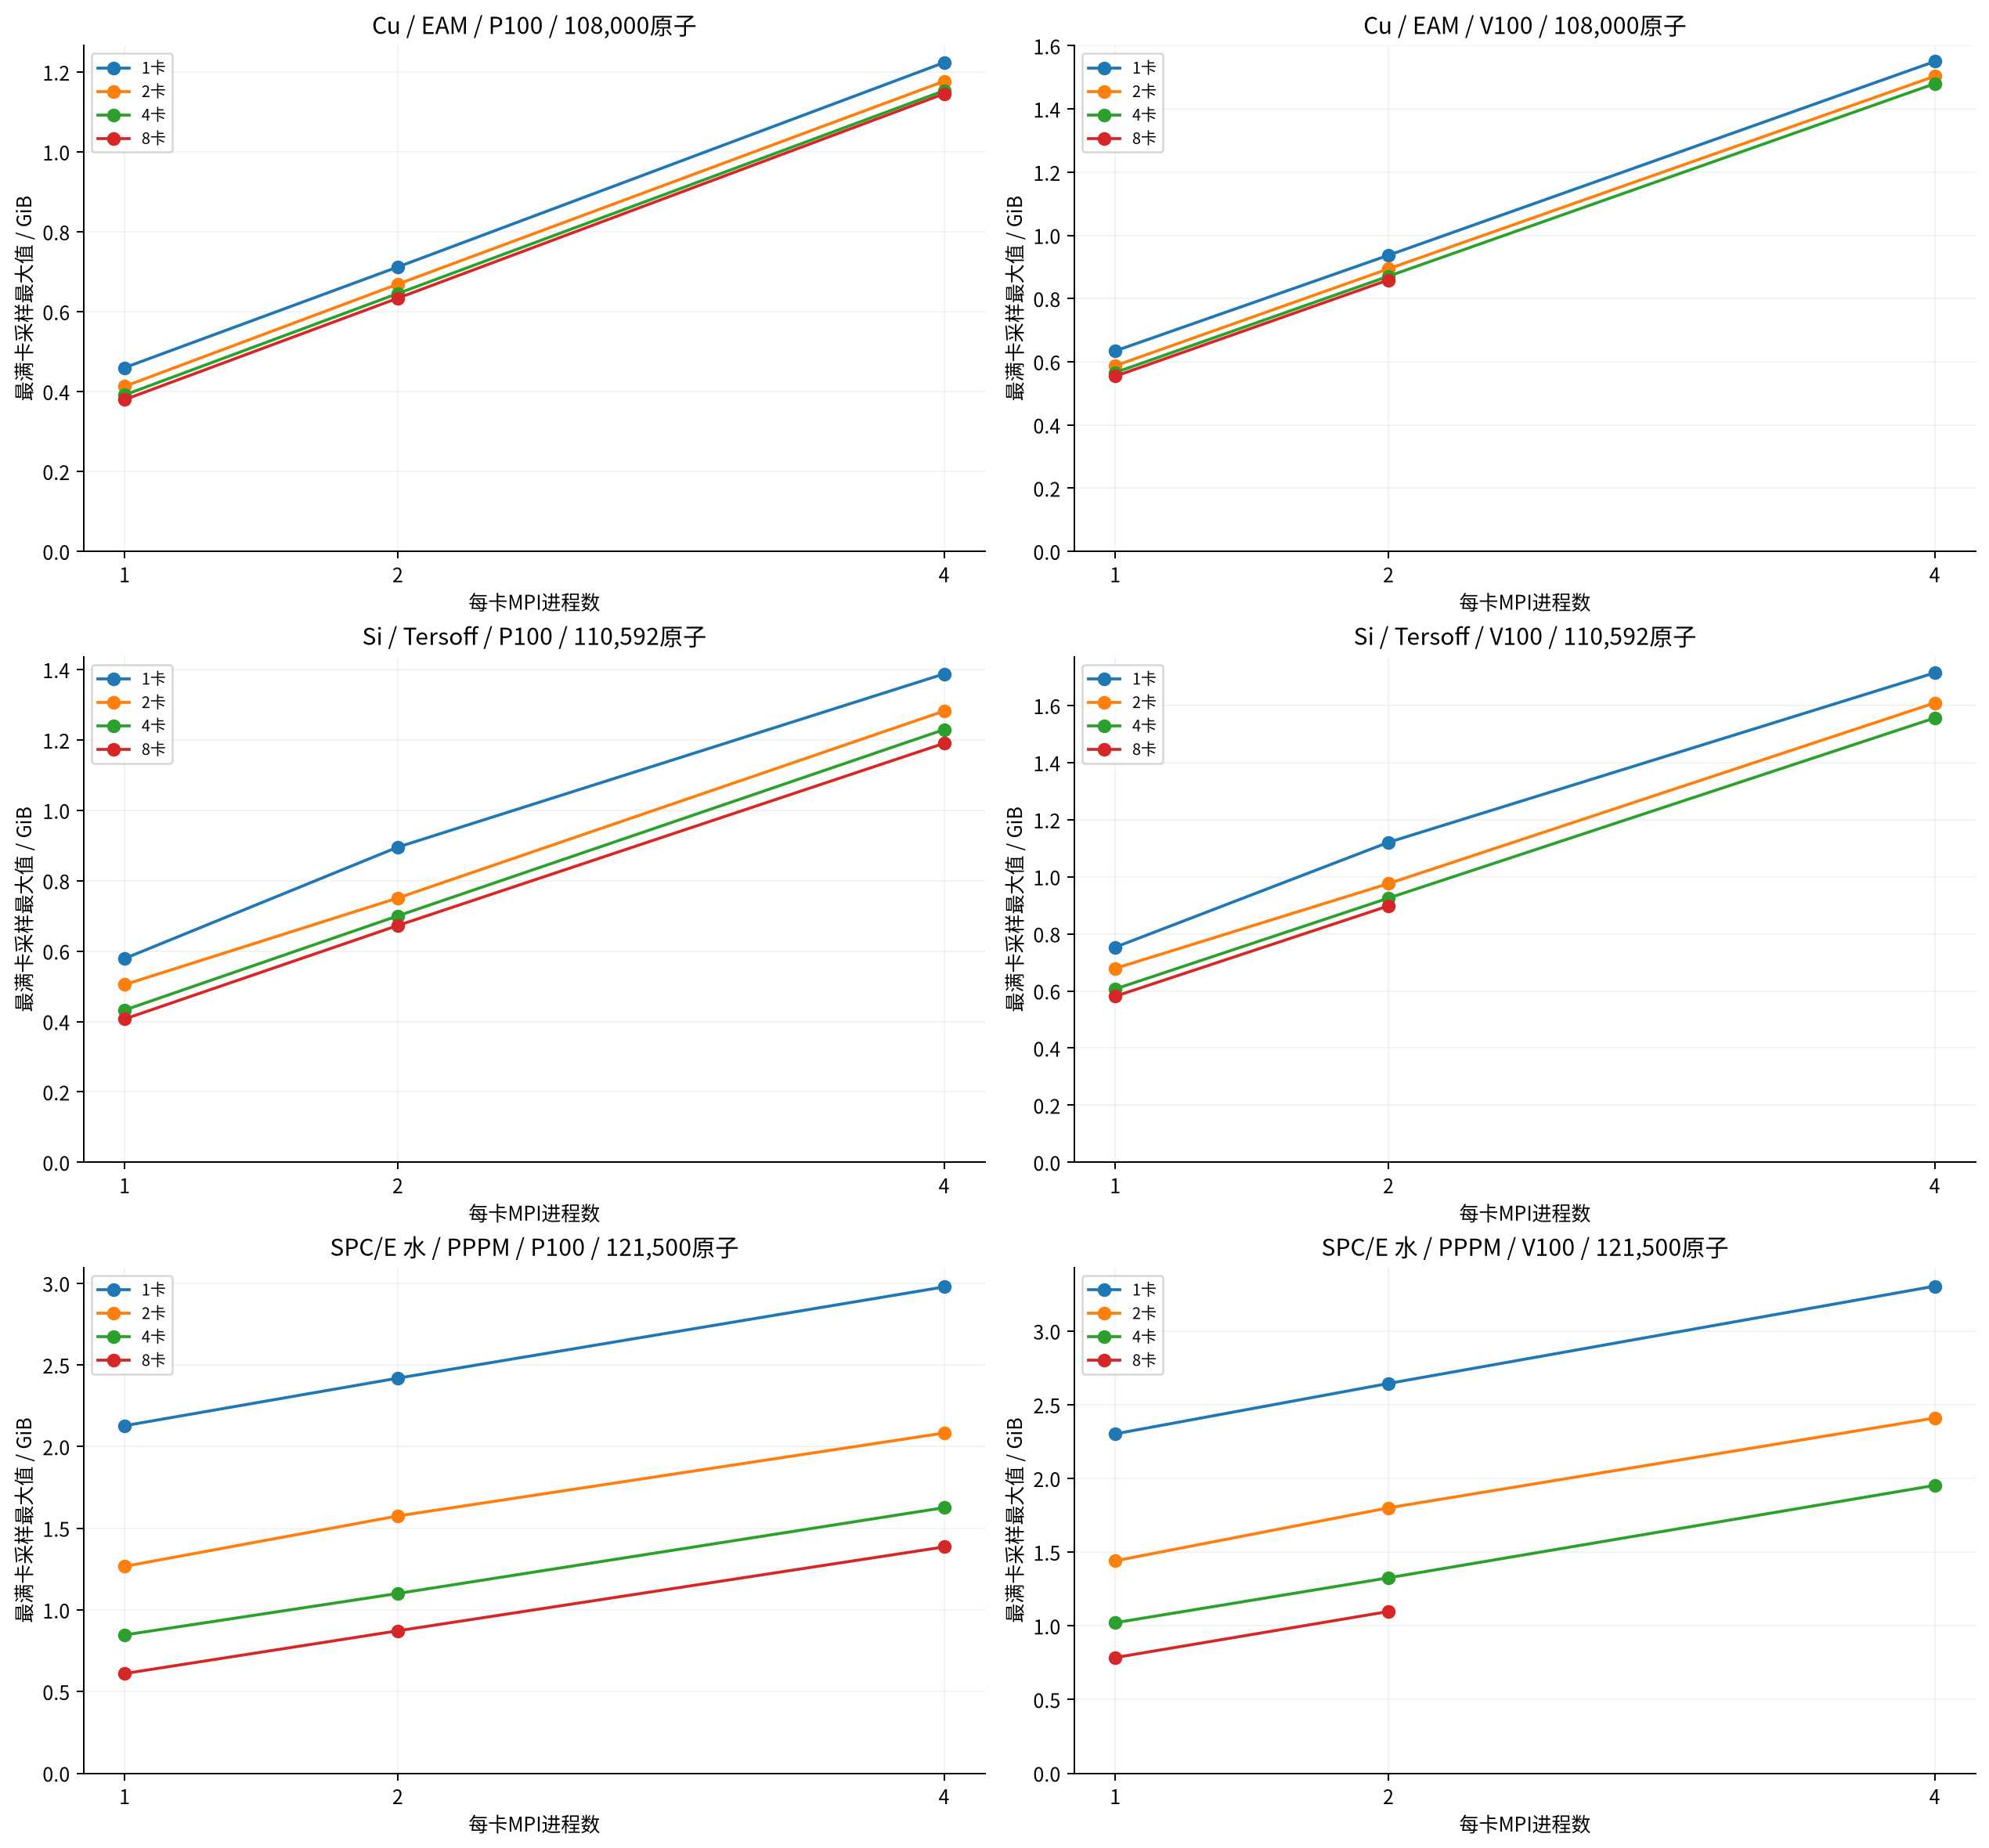
固定模型与规模:GPU包每卡MPI数和逐卡显存观察
速度收益与显存余量应同时检查。适合某个体系的多进程布局不能直接套用给内存更紧张的大体系;本图也不能替代KOKKOS的进程建议,后者本轮从每卡一进程开始。
邻居表和长程静电#
在均匀三维体系中,截断加skin范围内的平均邻居数随密度和有效半径的三次方增长,邻居表可能成为主要占用。这里的立方关系是均匀密度的几何估计,不能替代多体势、非均匀界面或不同neighbor实现的实际分配。skin改变邻居表规模和重建频率,不改变物理势截断;势本身的截断则不能单纯为了省显存随意降低。
水的PPPM还需要三维网格和FFT工作区。固定密度下增大体系通常也需要更大的网格;改变长程精度会改变工作量。正式比较统一了每规模的mesh、order及gewald,避免不同MPI布局自动选网格后混淆。真空或稀疏区域可能使网格、通信几何与局部粒子密度不再同步,单看原子数更不充分。
本轮以同一中等规模、同一初态改变skin,保持物理相互作用和PPPM设置,记录如下。只列通过能量/力检查的控制项。
| 模型 | 平台 | 实现 | skin / Å | 最满卡采样最大值 / GiB | 每1,000步 / s |
|---|---|---|---|---|---|
| Cu / EAM | P100 | gpu | 0.5 | 1.2001 | 1.993 |
| Cu / EAM | P100 | gpu | 2.0 | 1.2235 | 2.377 |
| Cu / EAM | P100 | kokkos | 0.5 | 0.4637 | 1.915 |
| Cu / EAM | P100 | kokkos | 2.0 | 0.4989 | 3.387 |
| Cu / EAM | V100 | gpu | 0.5 | 1.5269 | 2.180 |
| Cu / EAM | V100 | gpu | 2.0 | 1.5503 | 2.354 |
| Cu / EAM | V100 | kokkos | 0.5 | 0.6636 | 0.874 |
| Cu / EAM | V100 | kokkos | 2.0 | 0.7007 | 1.432 |
| Si / Tersoff | P100 | gpu | 0.5 | 1.3661 | 1.716 |
| Si / Tersoff | P100 | gpu | 2.0 | 1.7001 | 1.880 |
| Si / Tersoff | P100 | kokkos | 0.5 | 0.4520 | 0.956 |
| Si / Tersoff | P100 | kokkos | 2.0 | 0.4637 | 0.948 |
| Si / Tersoff | V100 | gpu | 0.5 | 1.6929 | 1.877 |
| Si / Tersoff | V100 | gpu | 2.0 | 2.0269 | 1.904 |
| Si / Tersoff | V100 | kokkos | 0.5 | 0.6538 | 0.552 |
| Si / Tersoff | V100 | kokkos | 2.0 | 0.6655 | 0.521 |
| SPC/E 水 / PPPM | P100 | gpu | 1.0 | 1.5360 | 218.675 |
| SPC/E 水 / PPPM | P100 | gpu | 3.0 | 1.9188 | 219.845 |
| SPC/E 水 / PPPM | P100 | kokkos | 1.0 | 1.3309 | 75.616 |
| SPC/E 水 / PPPM | P100 | kokkos | 3.0 | 1.4833 | 75.008 |
| SPC/E 水 / PPPM | V100 | gpu | 1.0 | 1.8628 | 179.024 |
| SPC/E 水 / PPPM | V100 | gpu | 3.0 | 2.2456 | 179.827 |
| SPC/E 水 / PPPM | V100 | kokkos | 1.0 | 1.4937 | 40.161 |
| SPC/E 水 / PPPM | V100 | kokkos | 3.0 | 1.6851 | 39.948 |
用户怎样预估与避开容量不足#
- 先用自己的势、密度、cutoff、skin及长程精度,在目标GPU上运行能够覆盖邻居重建和所需输出的小样;观察每张卡,保留容量余量。
- 扩大体系时同时检查局部/ghost原子数、每卡MPI进程和网格。不要将GPU包输出的Max Mem / Proc直接视为整张卡的峰值。
- 容量紧张时先减少不必要的GPU共享进程、检查负载不均和输出/分析工作;增加GPU后仍要复验最满卡。科学参数是否能降低需做精度收敛检查。
- 这份曲线适用于本轮模型与现有构建。DeePMD网络权重、描述符和框架缓存不在其中,不能据此估算机器学习势容量;也没有据本轮数据发布通用显存拟合命令。
完整显存与性能CSV · MPI与KOKKOS参数 · 准确性。