
LAMMPS声子矩阵与有限差分精度
8组Ni EAM小算例,对照CPU双精度与GPU力的有限差分结果。
阅读本篇目录
先下载完整输入、操作脚本与实际结果并解压。gromacs/reference和各LAMMPS输入目录中的矩阵为参考结果;请在新建工作目录复现。
1 计算什么#
使用LAMMPS 30Sep2026 P100 GPU构建与公开Ni_u3 EAM势。构造32和108原子的fcc Ni,晶格常数3.52 Å、固定周期晶胞,比较0.001、0.0003、0.0001、0.00003 Å四种有限位移。每种输入分别用CPU双精度eam和GPU加速势计算,共8组条件。
这些是经验势、超胞Γ点动力学矩阵,包含折叠到超胞Γ点的原胞波矢;不是一条高对称声子色散路径,也不是已收敛的声子态密度。
2 准备并提交一个小例子#
mkdir -p work/ni-phonon
cp lammps/ni-32-d0.0001/in.lammps lammps/ni-32-d0.0001/Ni_u3.eam lammps/ni-32-d0.0001/run.sh work/ni-phonon/
cd work/ni-phonon
sbatch run.sh
脚本申请一个P100任务资源,在该分配内先运行CPU双精度势,再运行GPU势。这里的CPU指力计算执行路径,不是CPU专用节点的性能测试。每次一个MPI进程;小体系结果用于数值比较,不作加速比结论。
完整输入:
units metal
atom_style atomic
atom_modify map array
boundary p p p
lattice fcc 3.52
region box block 0 2 0 2 0 2
create_box 1 box
create_atoms 1 box
mass 1 58.6934
pair_style eam
pair_coeff * * Ni_u3.eam
neighbor 0.3 bin
neigh_modify every 1 delay 0 check yes
thermo 50
thermo_style custom step atoms pe press fmax
thermo_modify norm no format float %.12g
min_style cg
min_modify dmax 0.1 line quadratic
minimize 1e-12 1e-8 500 2000
run 0
write_data nickel.data
dynamical_matrix all eskm 0.0001 file dynamical.dat
print "PHONON_SHORT_FINISHED"
atom_modify map array提供原子编号映射;minimize只优化原子位置,晶胞保持固定。dynamical_matrix all eskm 0.0001用0.0001 Å正负位移求质量归一化二阶力矩阵。
3 读取矩阵与频率#
本例的metal单位与当前构建中,eskm相对regular矩阵乘9648.5,得到ps⁻²。正特征值λ对应 sqrt(λ)/(2π) THz;负特征值保留符号作为虚频标识,不能无条件取绝对值。此换算不应直接用于其他单位体系。
module purge
module load ase/3.29.0
python ../../lammps/analyze_matrix.py dynamical-double.dat
python ../../lammps/analyze_matrix.py dynamical-gpu.dat
32原子矩阵为96×96,108原子矩阵为324×324。检查矩阵有限性、近似对称性、三个整体平移零模及非零模稳定性,再解读频率。完整脚本只对极小反对称数值误差取对称部分,不会自动修复不可信的力矩阵。
4 位移不是越小越好#
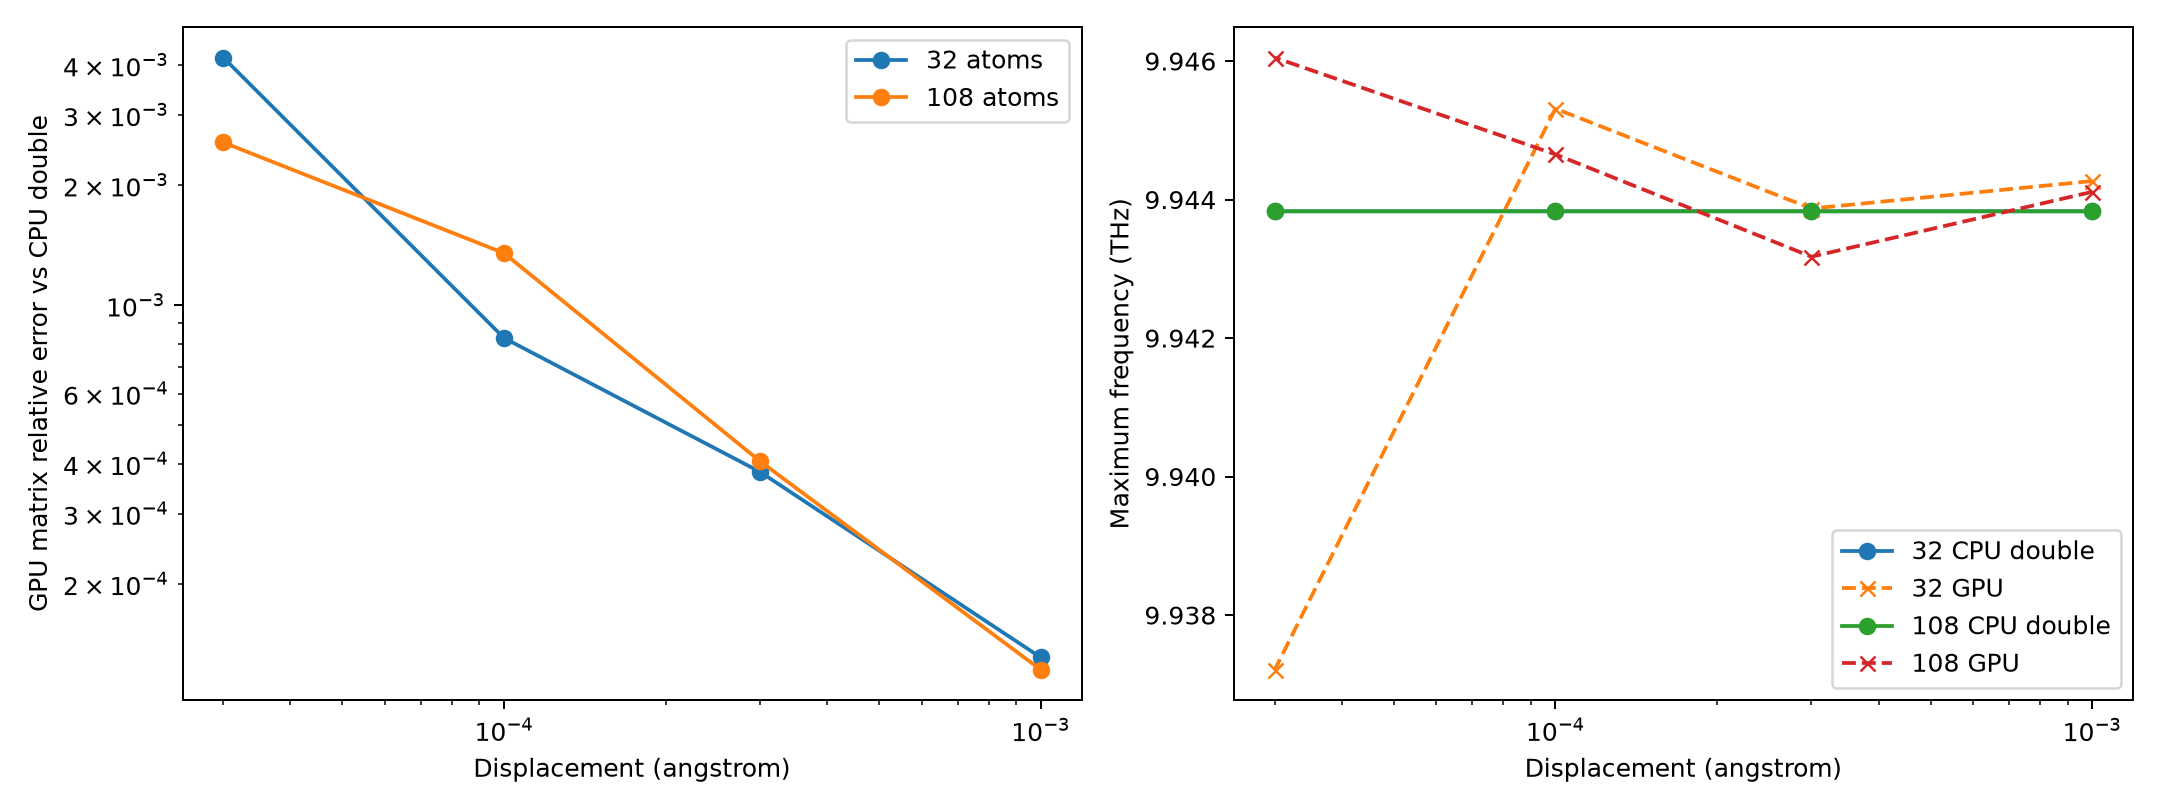
| 原子数 | 位移/Å | 双精度最大频率/THz | GPU矩阵相对双精度的误差 |
|---|---|---|---|
| 32 | 0.001 | 9.943831 | 0.000130888 |
| 32 | 0.0003 | 9.943831 | 0.000381888 |
| 32 | 0.0001 | 9.943831 | 0.000827176 |
| 32 | 3e-05 | 9.943831 | 0.00417403 |
| 108 | 0.001 | 9.943831 | 0.000121941 |
| 108 | 0.0003 | 9.943831 | 0.000406069 |
| 108 | 0.0001 | 9.943831 | 0.0013501 |
| 108 | 3e-05 | 9.943831 | 0.0025578 |
相对误差使用矩阵Frobenius范数。本次8组CPU双精度矩阵都通过对称性、平移零模和稳定性检查;GPU路径在极小位移下,两个相近力相减会放大有限精度误差,部分矩阵的平移零模和对称性不再满足本例要求。不要因GPU计算正常结束,就直接采用极小位移的导数结果。
操作上先用双精度力作参照,同时比较几种位移;如果研究对象对力差敏感,优先使用已验证的双精度计算路径。增大位移也可能引入非谐误差,不能只凭本例推荐一个通用步长。对真实研究还应检查平衡晶格、残余力、超胞和所用势的适用范围。
参考:LAMMPS动力学矩阵命令、单位换算实现。