
dpdata格式往返、帧筛选与多体系
完整读取多帧extxyz,核对五类字段,并保存可追溯的训练测试索引。
阅读本篇目录
下载本篇输入、完整脚本、数据与高清图。解压后在新目录运行,reference保存鸢算科技实际运行的参考结果。
1 从已核对的数据开始#
先按计算结果读取教程运行下载包,得到9帧Si数据dpdata-vasp/si-all。本篇使用同一套dpdata 1.1.0环境,演示格式转换、逐帧索引和多体系组织。
2 DeepMD二进制与文本格式#
import dpdata
s = dpdata.LabeledSystem('dpdata-vasp/si-all', fmt='deepmd/npy')
s.to('deepmd/npy', 'npy')
s.to('deepmd/raw', 'raw')
t = dpdata.LabeledSystem('npy', fmt='deepmd/npy')
assert len(t) == len(s)
这两种格式的坐标、晶胞、能量、力与virial在本次往返中均无数值差异。deepmd/npy适合机器学习数据读取,deepmd/raw便于直接查看,但大数据文本会占更多空间。
3 多帧extxyz要完整读入#
s.to('extxyz', 'si.xyz')
collection = dpdata.MultiSystems().from_file('si.xyz', fmt='extxyz')
assert len(collection.systems) == 1
t = next(iter(collection.systems.values()))
assert len(t) == 9
本地版本直接LabeledSystem('si.xyz', fmt='extxyz')只读第一帧。要读取全部帧,使用MultiSystems().from_file();同组成帧会归在同一体系中。先检查帧数,再比较数组,避免NumPy广播把1帧和9帧的差异掩盖掉。
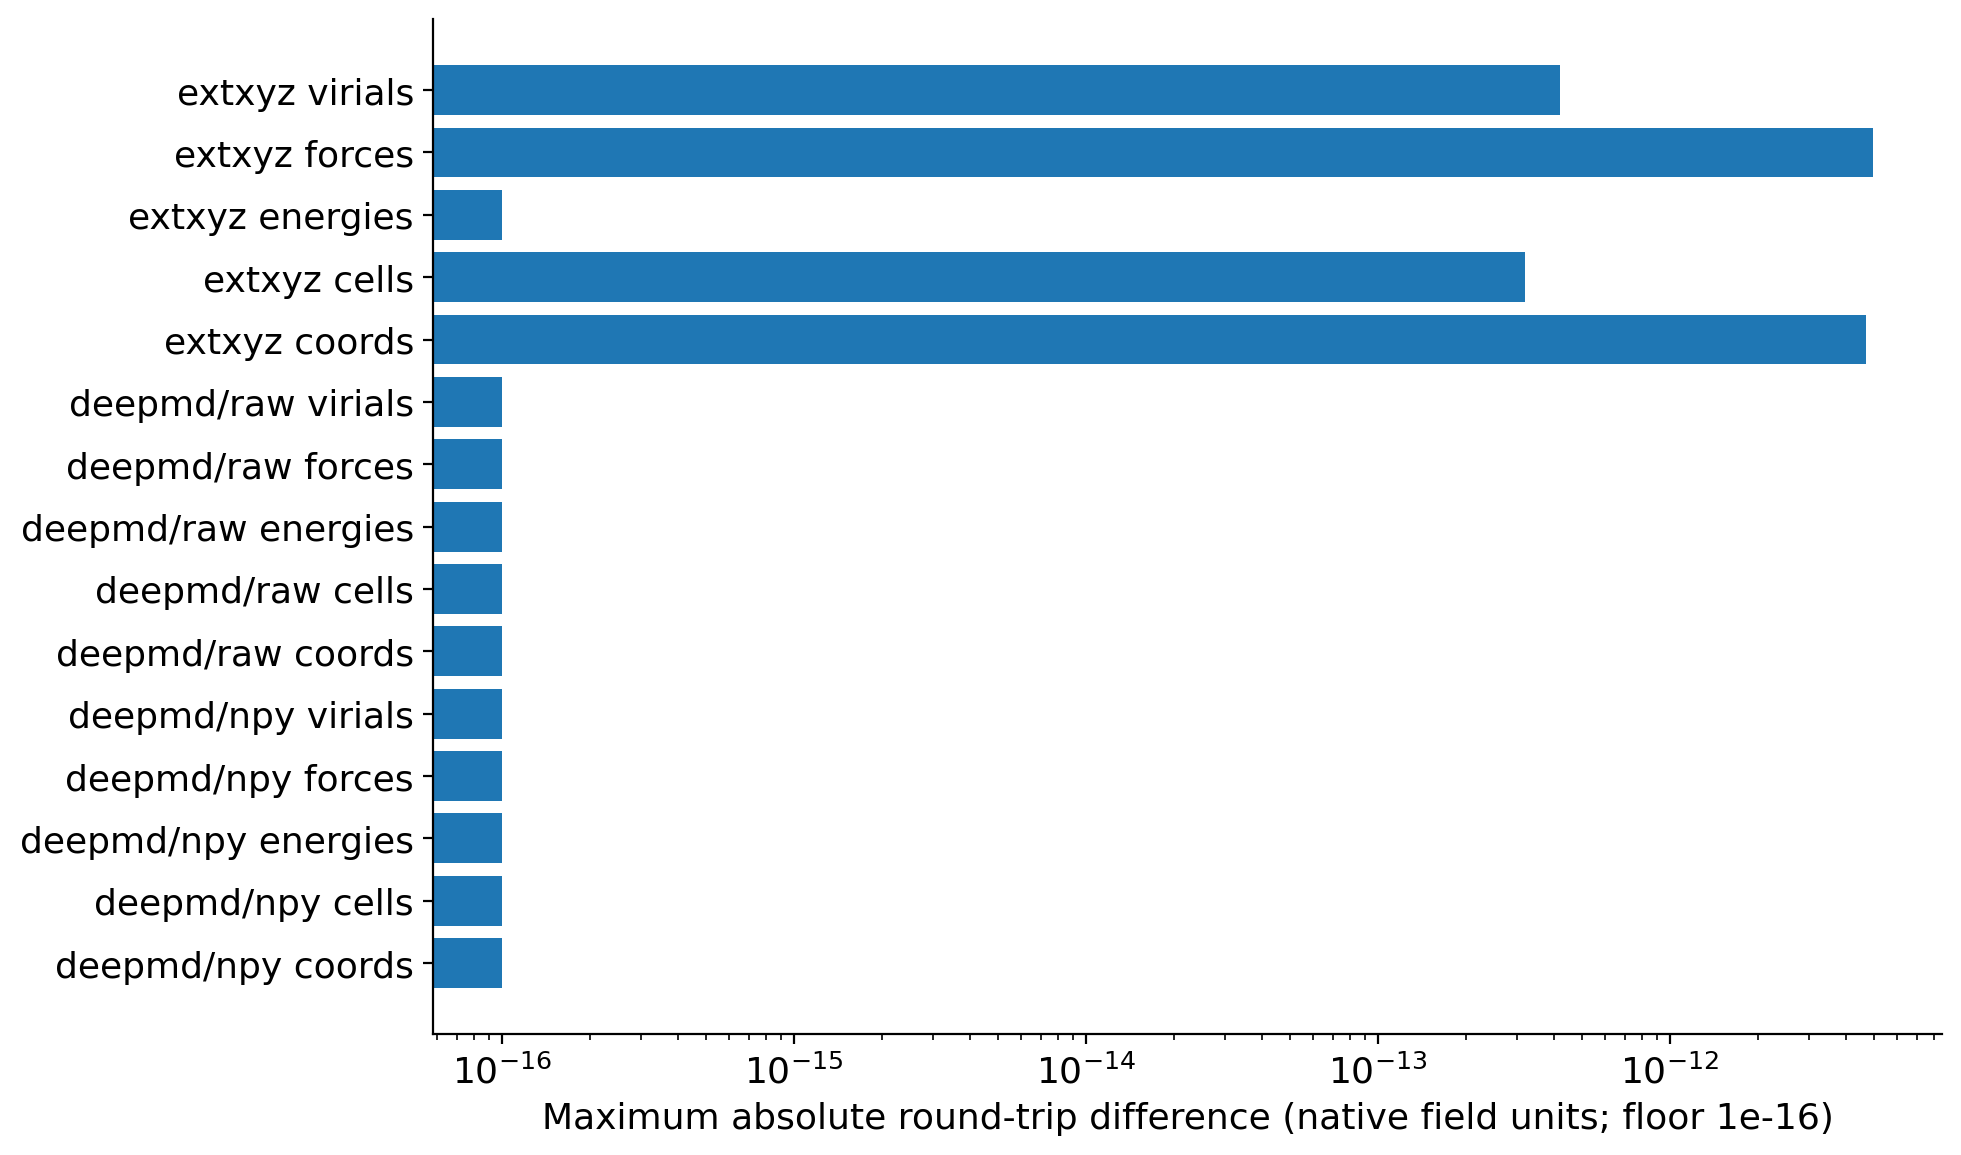
完整9帧extxyz往返后,坐标最大差 4.71×10⁻¹² Å、力分量最大差 4.96×10⁻¹² eV/Å,符合文本输出精度。virial与stress的符号、体积归一化和单位不同,不能改个字段名就替换。
4 按索引拆分帧#
train = [0,2,3,4,5,7,8]
test = [1,6]
assert not set(train) & set(test)
s.sub_system(train).to('deepmd/npy', 'train')
s.sub_system(test).to('deepmd/npy', 'test')
Python索引从0开始。本例7帧训练、2帧测试,索引不重叠,合计9帧,保存为indices.json可追溯。但相邻位移结构高度相关,这只是拆分操作示范,不能据此声称独立泛化性能。正式训练应按轨迹、工况或结构族设计验证集。
5 不同组成放入MultiSystems#
water = dpdata.LabeledSystem('dpdata-cp2k/water.xyz', fmt='extxyz')
collection = dpdata.MultiSystems(s, water)
collection.to_deepmd_npy('multi')
print(collection.systems.keys())
本例将Si双原子和H₂O分别组织,保留各自原子数、类型和标签。这演示的是文件组织,不建议把不同电子结构设置的数据直接联合训练。相同化学式的数据还可能被归并,因此来源方法、赝势、截断与能量基准要另外记录;MultiSystems不会替你判断标签是否物理兼容。
下载包保留每个输出字段的往返检查及各帧原始来源。新体系建议依次检查:帧数→元素/类型→晶胞与周期条件→坐标→能量与力→应力/virial,最后再写训练数据。
参考:dpdata系统与多体系。