
Calorine模型读写与描述符
保存模型权重、提取逐原子量、描述符与潜变量,区分信息熵和热力学熵。
阅读本篇目录
下载本专题结构、势文件、真实参考数据和全部Python脚本。以下命令在解压目录执行;CPU计算使用已分配的CPU资源,GPU通过Slurm分配。原始结果放在 reference/,复跑结果写入当前目录。
1 区分模型文件和训练参数#
from calorine.nep import read_model
model = read_model('si-nep.txt')
print(model.types, model.version, model.n_parameters)
model.write('model-copy.txt')
model.write_nepfile('training-nep.in')
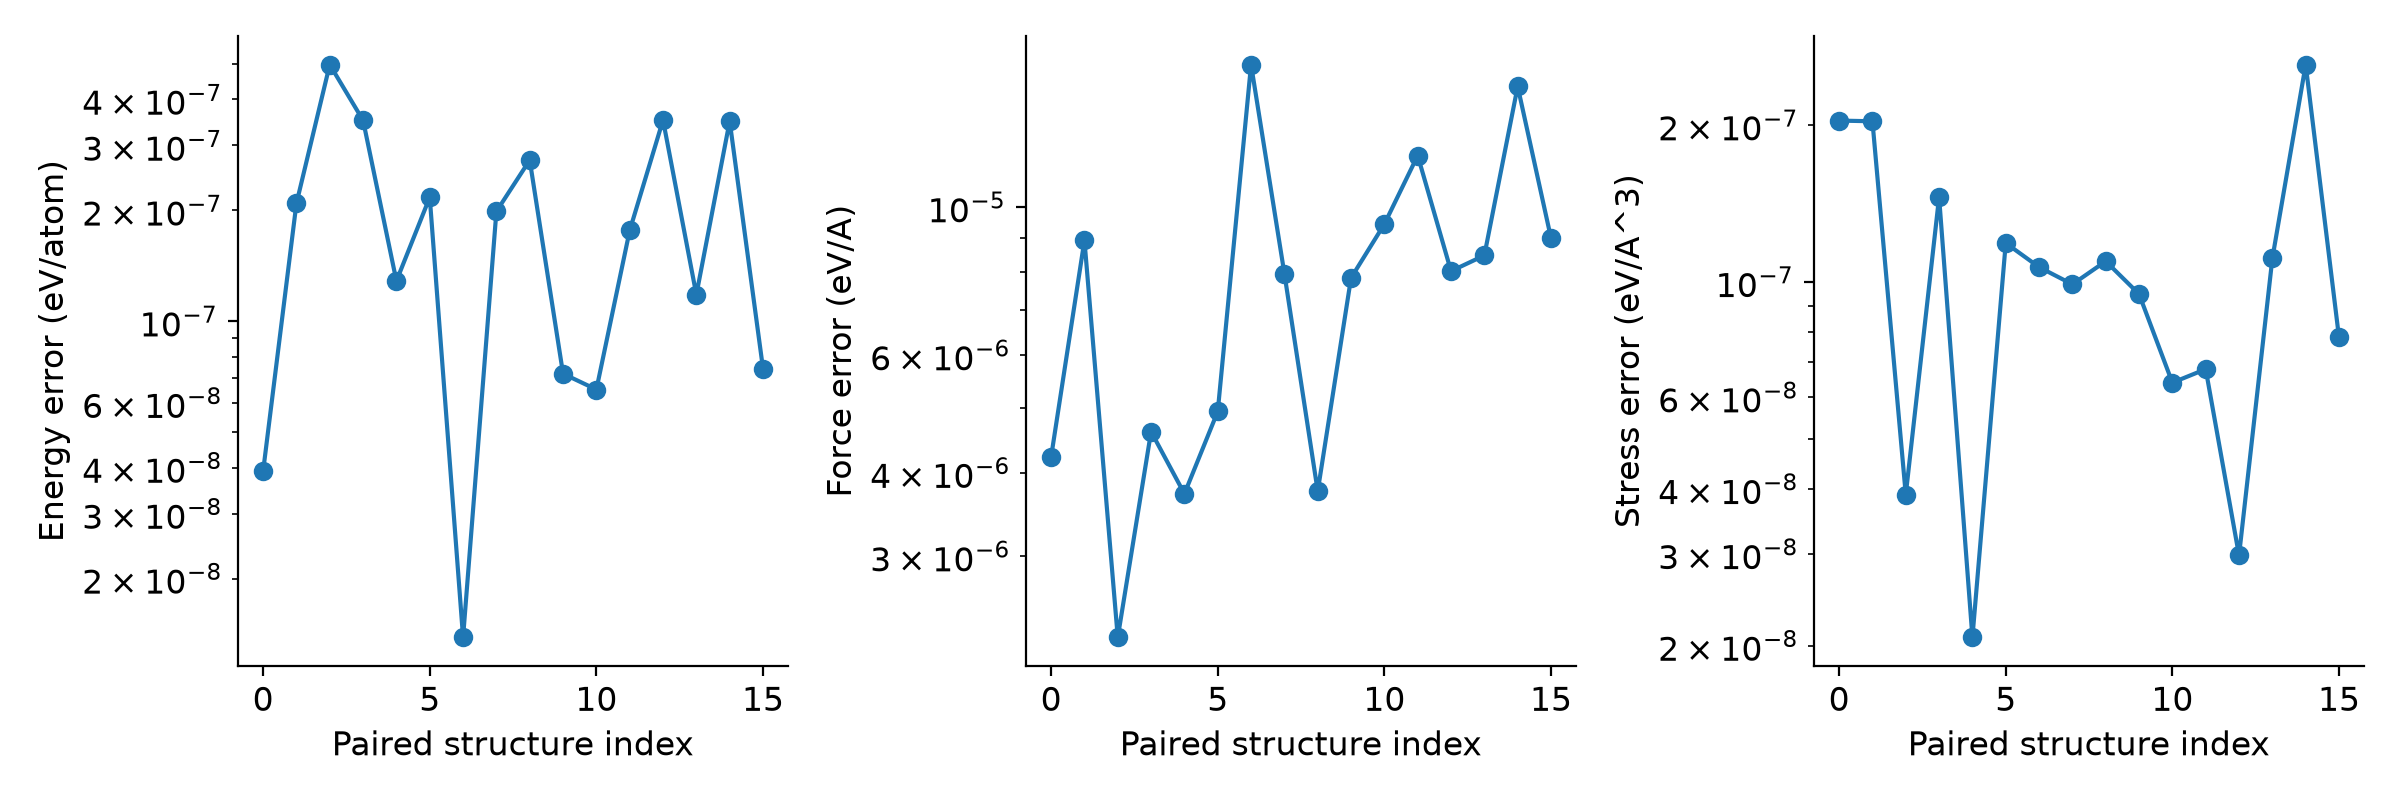
write保存带权重的势文件,可以交给CPUNEP;write_nepfile写训练超参数nep.in,不能把它当成势文件。示例对模型复制后的能量逐项核对。修改nep.in不等于重新训练出对应的新权重,不能修改角向阶数来假装兼容旧程序。
2 逐原子性质、描述符和潜变量#
from ase.io import read
from calorine.nep import (get_descriptors, get_latent_space,
                         get_potential_forces_and_virials)
a = read('case-03/model.xyz')
descriptors = get_descriptors(a, 'si-nep.txt')
latent = get_latent_space(a, 'si-nep.txt')
energy, force, virial = get_potential_forces_and_virials(a, 'si-nep.txt')
print(descriptors.shape, latent.shape)
print(energy.sum(), force.shape, virial.shape)
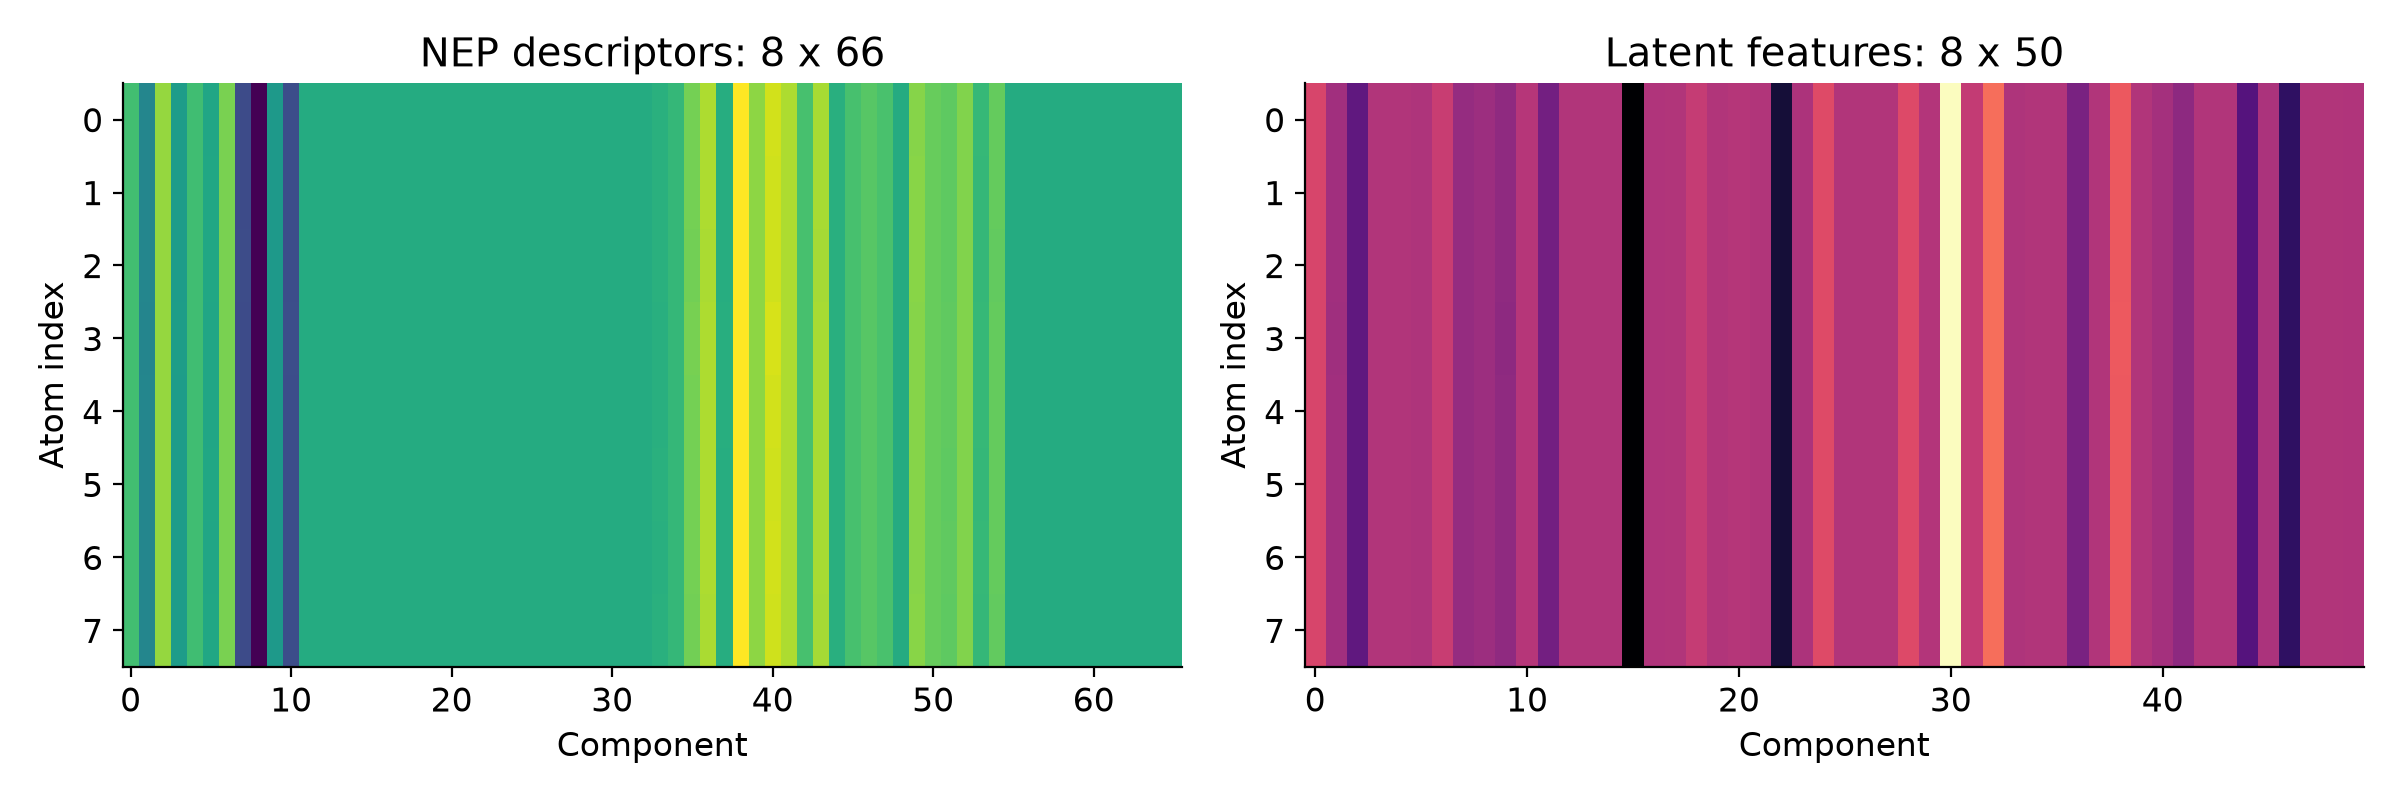
8原子Si输出描述符8×66、潜变量8×50;逐原子能量求和等于体系总能量。脚本分别检查了旋转后的描述符不变性和原子置换后的对应关系。9分量逐原子virial数组不能不看约定就直接当成ASE的6分量应力。
3 描述符的信息熵#
from calorine.tools import get_entropy
H, local = get_entropy(descriptors, width=0.05,
                       device='cpu', use_tqdm=False)
print(H, local)
本例8个环境、核宽0.05得到信息熵0.01329177。这里是描述符分布的信息量指标,不是材料热力学熵,也不是独立的模型误差条。核宽、描述符量纲、体系规模都会影响数值;比较不同样本集时保持定义和采样口径一致。
4 复现全部核对与图#
python cpu_workflows.py
python extra_workflows.py
python plot.py
ls descriptors.npz model-roundtrip.txt training-nep.in
客户做主动学习时,可先用描述符或潜变量筛选有代表性的结构,再对选定结构做真实参考计算;不能仅凭信息熵高就认为所有高能结构都适合加入训练。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。