
Calorine训练数据与预测结果读写
真实DFT能量、力和应力的完整保留,三种分组输入及能量参考处理。
阅读本篇目录
下载本专题结构、势文件、真实参考数据和全部Python脚本。以下命令在解压目录执行;CPU计算使用已分配的CPU资源,GPU通过Slurm分配。原始结果放在 reference/,复跑结果写入当前目录。
1 准备真实数据#
本包包含9个真实DFT Si2形变结构,7/2两个文件沿用历史train/test命名。它们是相关的教学分组,既不是所用官方Si模型的原始训练数据,也不构成独立精度验证。inputs-dft/保留DFT能量、力和virial,prediction-data/包含同一官方模型对这些结构的预测输出。
head -n 5 inputs-dft/train.xyz
ls prediction-data
python io_workflow.py
cat IO-VALIDATION.json
extxyz的第一行是原子数,第二行包含晶胞、Properties、energy和virial。能量单位eV、力eV/Å、virial eV。应力与virial通过σ=−W/V关联;不能把9个virial分量直接当成GPa应力。
2 读取预测目标与结果#
from calorine.nep import read_structures, get_parity_data
train, test = read_structures('prediction-data')
a = train[0]
print(a.info['energy_target'], a.info['energy_predicted'])
print(a.arrays['force_target'], a.arrays['force_predicted'])
get_parity_data(train + test, 'force').to_csv('force-parity.csv', index=False)
read_structures读取nep.in、train/test.xyz及energy、force、virial、stress输出文件。它把目标和预测放入info/arrays;energy_target与virial_target按每原子归一,力仍是每原子三分量。若要重建ASE标准计算器,能量需恢复体系总能量。GPUMD应力文件是GPa、压力为正,Calorine标准计算器则转换成ASE应力约定。
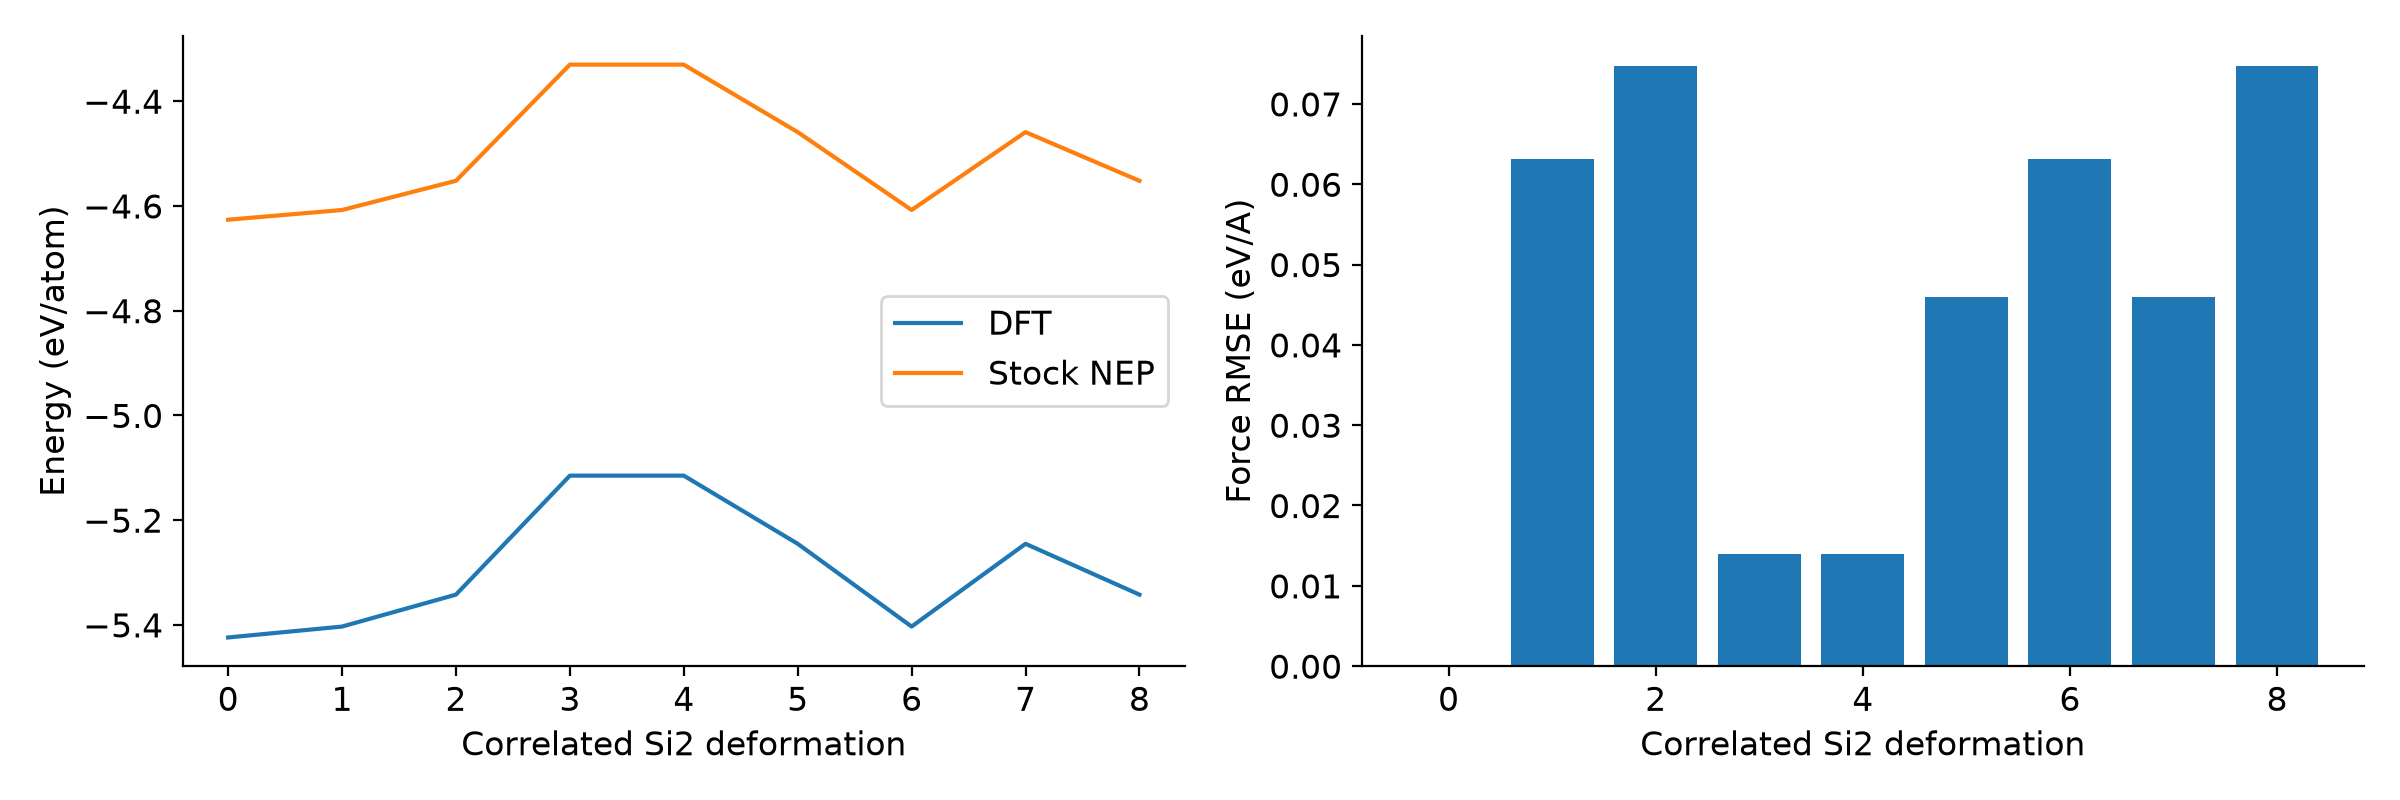
图中的绝对能量存在显著基准偏移;有限数据上的力差异也不能称为势模型的完整精度。包内保留所有原始值,不把偏移对齐后的图解释为重新训练或改善了泛化能力。
3 写回数据时保留力、应力和virial#
先从真实DFT结构取标签,再明确构建ASE计算器:
import numpy as np
from ase.io import read
from ase.calculators.singlepoint import SinglePointCalculator
from ase.stress import full_3x3_to_voigt_6_stress
from calorine.nep import write_structures
a = read('inputs-dft/train.xyz', index=0)
E, F = a.get_potential_energy(), a.get_forces()
W = np.asarray(a.info['virial']).reshape(3,3)
sigma = -full_3x3_to_voigt_6_stress(W) / a.get_volume()
a.calc = SinglePointCalculator(a, energy=E, forces=F, stress=sigma)
write_structures('one-DFT.xyz', [a])
完整io_workflow.py对9帧逐一复读,检查能量、每个力分量、应力和virial。本例四项写入/读回最大误差均为0;只核对“帧数相同”不足以确认标签没有丢失。
4 生成训练目录,不把输入生成当成训练完成#
python extra_workflows.py
ls training-inputs/kfold
ls training-inputs/bagging
ls training-inputs/fixed/nepmodel
head -n 20 training-inputs/fixed/nepmodel/nep.in
脚本真实调用setup_training的kfold、bagging和fixed分组。K折与bagging各生成全量模型目录和3个分组目录;fixed按既定7/2分组生成单个目录。随机种子28,bagging训练占比0.7。这里交付的是训练输入准备,不宣称100代训练或一个新势已经完成。正式训练应按独立母轨迹、结构族和采样来源划分,避免相关结构泄漏。
参数输入的最小形式:
from ase.io import read
from calorine.nep import setup_training
all_DFT = read('dft-roundtrip.xyz', index=':')
train_DFT, test_DFT = all_DFT[:7], all_DFT[7:]
parameters = dict(type=[1,'Si'], version=4, n_max=[4,4],
                  basis_size=[8,8], l_max=[4,2,1], neuron=20,
                  generation=100, batch=100)
setup_training(parameters, train_structures=train_DFT,
               test_structures=test_DFT, mode='fixed',
               rootdir='my-training', seed=28)
其中train_DFT/test_DFT应换成带标准ASE能量、力和可用应力的真实参考结构。不要直接把带预测目标附加字段、却缺少标准计算器标签的列表原样用于训练写入。
5 能量参考平移#
from calorine.nep import determine_energy_offsets, apply_energy_offsets
offsets = determine_energy_offsets(train_DFT, reference=None)
shifted = apply_energy_offsets(train_DFT, offsets)
print(offsets)
reference=None拟合的是这些DFT目标能量的元素参考项,不涉及NEP预测;本例检查了平移后力、应力完全不变。若使用模型reference比较DFT与模型的基准,还需要兼容该模型的nep批量预测环境。参考平移不修正力,也不消除模型结构相关误差。