
GROMACS 内核微基准与 PME 调参操作
实际运行nonbonded-benchmark与tune_pme,保留VdW截断并区分短工具测试与完整生产性能。
阅读本篇目录
下载输入、真实结果与绘图资料包,解压进入资料包目录。inputs 可修改,reference 是集群已计算的参考结果;脚本每次在 work 下建立独立目录。计算在分配好的资源内执行,可用 sbatch run.sbatch 跑整组,结果路径写入 LAST-RUN.txt。
两个工具测的不是同一件事#
nonbonded-benchmark 只测非键内核;tune_pme 会生成输入并启动实际短 mdrun。本例都使用 P100 节点上的 CPU 执行路径,不是 GPU 性能图。请在已分配资源内运行。
bash run.sh tools
1. 运行小型内核微基准#
module purge
module load gromacs/2026.4-p100-threadmpi
gmx nonbonded-benchmark -size 1 -nt 2 -simd 4xm -iter 20 -warmup 5 -time -o kernel.csv
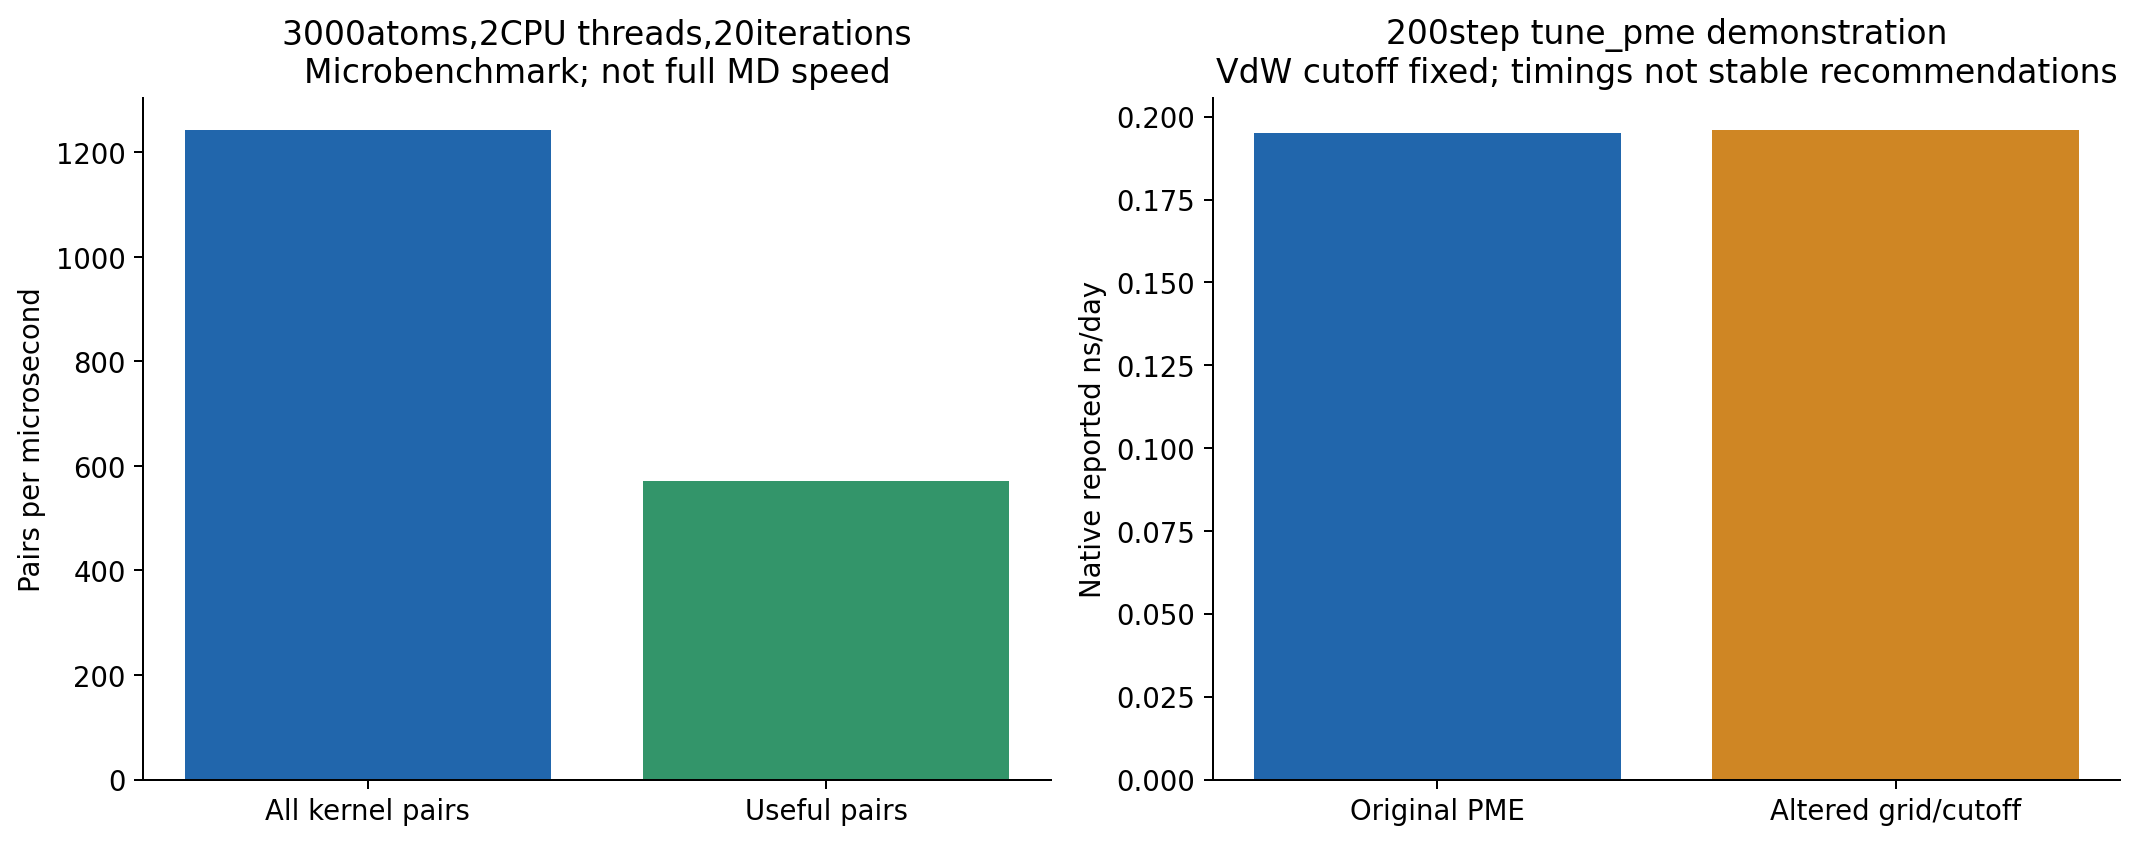
-size 1 对应 3000 个原子;-nt 2 限制两线程,-iter 20 是计时迭代数。该次实际输出总对约 1243 pairs/μs,有效截断内对约 572 pairs/μs。两者不同来自簇对表中额外执行的计算。
cat kernel.csv
重复运行会受到频率、绑核、负载与缓存影响,数据不会每次相同。这些数字不能换算成任意真实体系的 ns/day,也不能当作其他节点或 GPU 的加速比。
2. 保持 VdW 截断的 PME 工作流#
使用 inputs/tuning/water.tpr 的小水盒,复制到独立目录:
gmx tune_pme -s water.tpr -mdrun 'gmx mdrun -ntomp 2 -bonded cpu -update cpu -pin off' -ntmpi 1 -fix 0 -ntpr 2 -rmin 0.8 -rmax 0.9 -noscalevdw -r 1 -steps 200 -resetstep 0 -nolaunch -p performance.out -err benchmark-errors.log -so chosen.tpr
本例固定一个 MPI 线程、没有独立 PME rank,在两个候选布局各测 200 步;-noscalevdw 保留原 VdW 截断,避免把改变色散截断造成的物理差异误认为纯性能优化。这里的 -mdrun 不重复设置 -nb,由调参器按其流程传入。
cat performance.out
检查报告是否真的包含各布局的 OK. 和计时,不能只依据进程退出码。该次保留原 PME 设置;当原设置最佳时,不应假定总会产生一个新的 chosen.tpr。
3. 用到正式作业前#
200 步足够演示命令,不足以稳定推荐最快布局。正式调优应加长预热与计时、重复测试,并检查 Coulomb 截断/网格变化后的力和能量精度。最后仍在原来的核数与 GPU 配置下测完整 MD,区分初始化、输出与稳态耗时。
-nolaunch 不继续启动正式长作业,但基准本身仍会运行计算。见 nonbonded-benchmark、tune_pme。
在终端查找命令#
gmx help commands
gmx help nmeig
第一条显示当前安装的命令清单,第二条查看指定命令的参数;资料包已实际运行两条入口,输出在新工作目录的 help 下。帮助说明属于命令导航,不表示已经运行该物性计算。