
GPUMDkit 主动学习选帧与时间配对
真实短轨迹示范偏差日志和稀疏结构如何配对,再运行原生最大偏差筛选。
阅读本篇目录
下载本组输入、真实参考输出与绘图脚本,解压后进入资料包根目录。所有示例在自己的新目录执行,inputs和reference保留。默认bash run.sh all只做工具处理;需要重新训练时才提交compute.sbatch。
第一步:准备真实候选输出#
本例使用同一小型Si训练的两个阶段模型,在P100运行100步NVE,步长0.1fs,总长10fs;仅演示模型分歧和候选选择,不用于生产采样。两个训练阶段不是独立训练的模型集合,分歧也不等于DFT误差或已校准不确定度。
完整run.in如下:
potential nep1.txt
potential nep2.txt
velocity 300 seed 20261028
time_step 0.1
ensemble nve
active 1 0 1 1 0.05
dump_thermo 1
run 100
active后依次是每1步检查、不存速度、存力、存不确定度、输出结构阈值0.05eV/Å。第一模型驱动MD;第二模型用于委员会比较。模型元素顺序一致,本例都是Si。
运行方式与普通GPUMD相同:
module load gpumd/5.9.1-p100
gpumd > gpumd.log 2>&1
请在新的计算目录、已分配的计算资源内执行,不能在已有输出后继续混写。
第二步:先数帧,不能直接假设逐行对应#
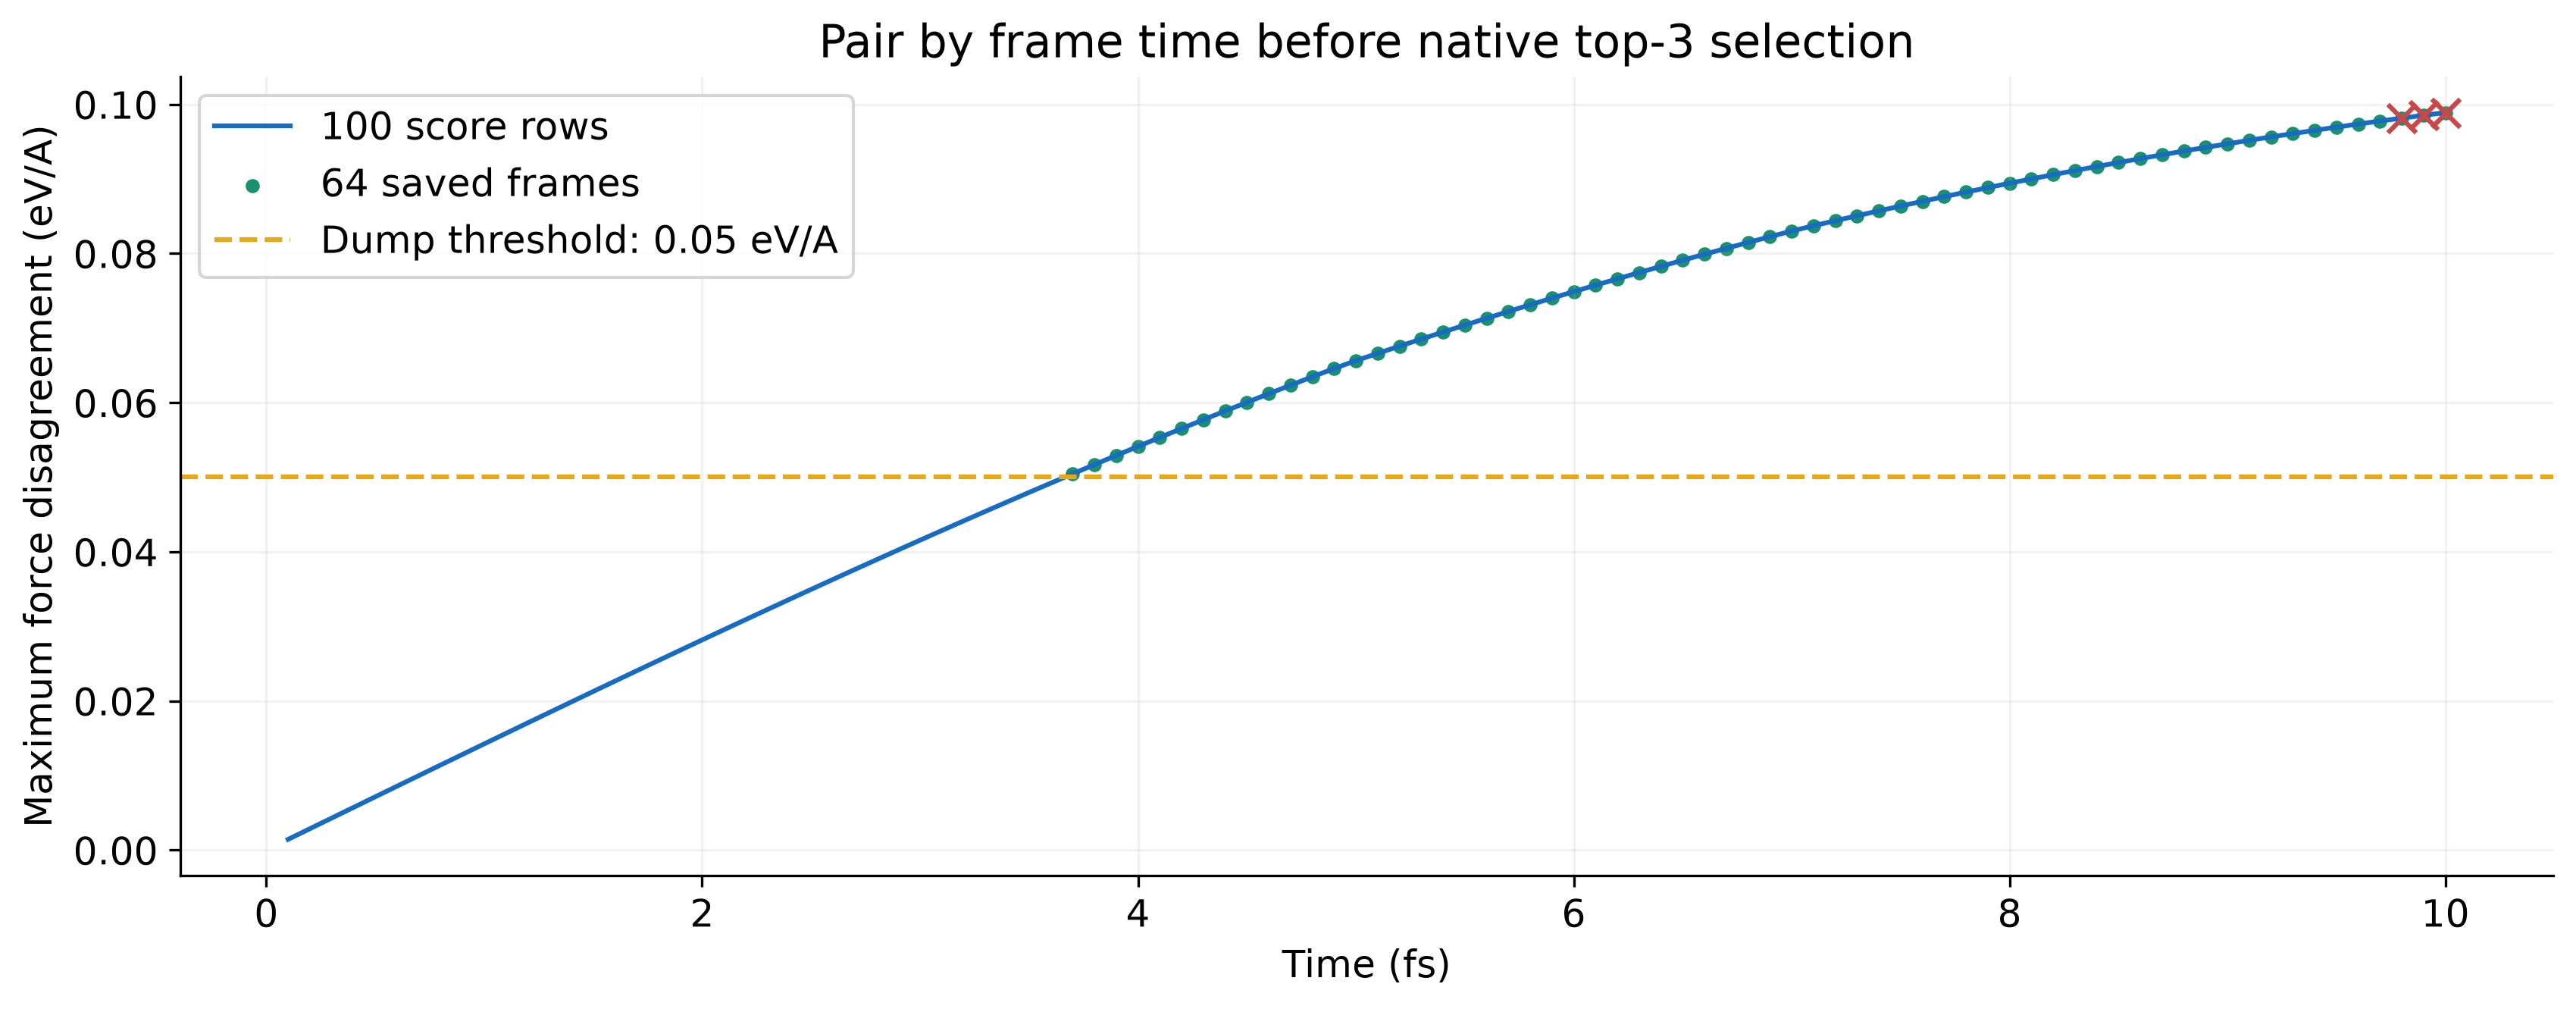
本次两种实际输出设置如下,使用同一初始速度种子、同一100步轨迹:
| 输出结构阈值 | active.out行数 | active.xyz帧数 |
|---|---|---|
| 0 | 100 | 100 |
| 0.05eV/Å | 100 | 64 |
日志记录每个检查时刻,xyz只写超过输出阈值的构型。如果直接用日志行号去索引64帧xyz,会取错位置或越界。
第三步:按Time配对#
资料包根目录执行:
module load gpumdkit/1.5.8
python prepare_pairs.py \
  reference/training/committee-threshold/active.out \
  reference/training/committee-threshold/active.xyz work/active-paired
辅助脚本读取每帧Time,在原始日志中寻找唯一对应行,输出配好的active.out、active.xyz和frame-map.json。原始100行日志仍保留。这里的时间是fs;匹配不依赖“xyz第几帧”。
若日志和结构数量不同又没有Time,就不能自动恢复对应关系。应找回完整元数据或生成完整候选输出,不凭猜测补行。重复时间、无法匹配的时间与已有输出目录都会被拒绝。
第四步:调用GPUMDkit原生筛选#
cd work/active-paired
python "$GPUMDkit_path/Scripts/sample_structures/select_max_modev.py" 3 0.05
先保留偏差严格大于0.05eV/Å的候选,再按偏差降序取3个,写出selected.xyz。本次100帧和64帧两种输入配对后都正确选到原始轨迹中相同的3帧;最大模型分歧0.09889009eV/Å。
第五步:将候选送去DFT标注#
active.xyz中的能量和力来自NEP模型,不能当作新DFT真值。先转换选中结构、执行自洽DFT单点,再将真实结果合入训练集:
gpumdkit.sh -exyz2pos selected.xyz
ls POSCAR_*.vasp
转换后的原子可能按元素分组;涉及逐原子标签时要保留映射。本例只有Si,不发生跨元素重排。DFT结果按VASP标签转换、ABACUS标签转换等教程读取,再执行数据去重与分组拆分,避免把同一轨迹邻近帧同时放进训练和测试。