
GPUMDkit NEP训练、续训与模型选择
从六个训练和三个留出Si结构开始,实际执行两轮训练并比较留出误差。
阅读本篇目录
下载本组输入、真实参考输出与绘图脚本,解压后进入资料包根目录。所有示例在自己的新目录执行,inputs和reference保留。默认bash run.sh all只做工具处理;需要重新训练时才提交compute.sbatch。
第一步:确认数据和训练目标#
本例是Si能量—力—virial势模型,使用9个真实VASP自洽位移结构。训练6帧,留出3帧;分组方法见去重与拆分。这是很小的操作例,两轮短训练后力误差仍大,不能直接用于生产MD。
程序为GPUMD/NEP5.9.1 P100版本,CUDA12.9.86、GCC13.3,目标sm60,未启用fast-math。GPUMDkit1.5.8用于准备、预测和绘图。每个训练任务单进程启动nep,不要用mpirun启动多个相同实例。
第二步:准备完整nep.in#
type 1 Si
version 4
model_type 0
cutoff 6 4
n_max 4 4
basis_size 4 4
l_max 4 1 0
neuron 10
lambda_1 0.0001
lambda_2 0.0001
lambda_e 1
lambda_f 1
lambda_v 0.1
batch 6
population 20
generation 1000
output_interval 100
save_potential 500 0 1
version 4是NEP模型格式版本,不是GPUMD程序版本。两个cutoff为径向/角向截断Å;lambda控制损失项权重,不宜凭一张误差图随意改。每100代输出一次,每500代保存模型与对应优化器状态。
第三步:在计算资源内启动#
在自己的新目录操作;也可从资料包根目录直接sbatch compute.sbatch完成两阶段小训练。
module load gpumdkit/1.5.8 gpumd/5.9.1-p100
mkdir -p compute-work/manual/stage1 compute-work/manual/stage2
cp inputs/training/train.xyz inputs/training/test.xyz \
   inputs/training/nep.in compute-work/manual/stage1/
cd compute-work/manual/stage1
nep > nep.log 2>&1
tail loss.out
ls nep.txt nep.restart energy_test.out force_test.out
nep.txt是模型,nep.restart是优化器状态;二者作用不同。首次训练使用没有旧restart的新目录,防止意外从无关模型继续。
第四步:续训#
仍在stage1目录:
cp train.xyz test.xyz nep.in nep.txt nep.restart ../stage2/
cd ../stage2
sha256sum nep.restart > RESTART-INPUT.sha256
nep > nep.log 2>&1
tail loss.out
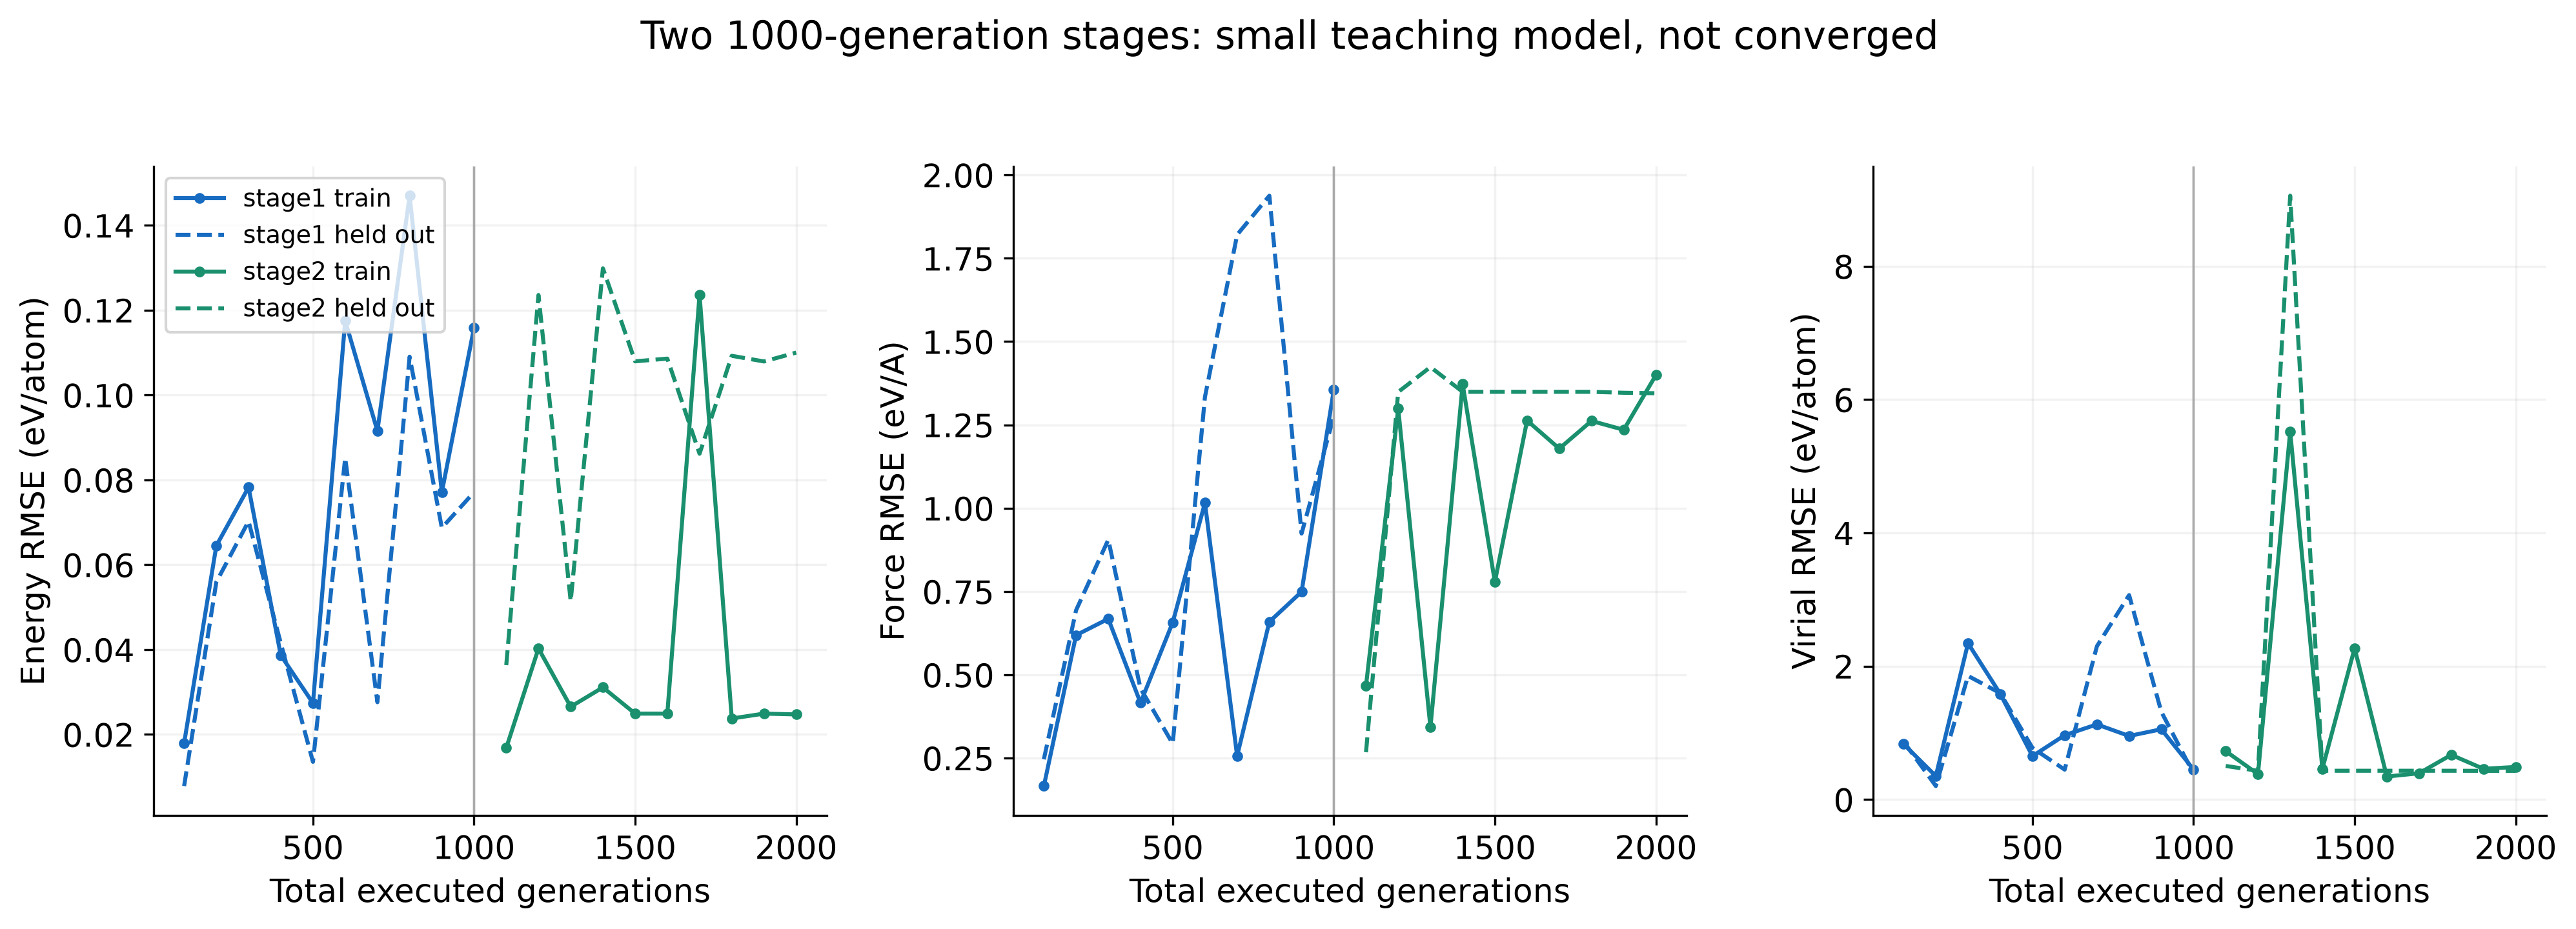
保持架构和元素顺序不变。程序读取对应restart中的均值与步长;本例第二次又执行1000代,loss.out中的代数重新从本阶段计数,图中才把第二阶段横坐标加1000。只复制模型文件不等于恢复优化器状态。
第五步:用留出集选模型#
本次两个阶段的最后模型如下,数字来自实际输出重新统计:
| 模型 | 训练能量RMSE eV/atom | 留出能量RMSE eV/atom | 留出力RMSE eV/Å |
|---|---|---|---|
| stage1末模型 | 0.115885 | 0.077091 | 1.275245 |
| stage2末模型 | 0.024725 | 0.109997 | 1.344894 |
续训降低了本次训练能量误差,但没有同时改善留出能量和力。若以留出力为本次比较指标,两者中应保留stage1,而不是只取时间最新的文件。两者都不足以作为可用材料势。
gpumdkit.sh -plt train_test save
在有loss.out及train/test配对输出的训练目录绘图。换一批数据或改变损失权重后,需要重新评估;也应比较多次独立训练及下游稳定性。本例留出只检验同一位移分支,不能支持跨温度/相态泛化结论。进一步看逐帧误差和逐元素统计。