
GPUMDkit 均匀、随机与FPS采样实操
给出真实源帧索引,比较跳过初始帧、固定数量和描述符距离阈值。
阅读本篇目录
下载本组输入、真实参考输出与绘图脚本,解压后进入资料包根目录。所有示例在自己的新目录执行,inputs和reference保留。默认bash run.sh all只做工具处理;需要重新训练时才提交compute.sbatch。
第一步:准备候选池和已有结构#
本例候选池为9个真实Si自洽光学位移;seed.xyz只有其中的零位移结构。采样只选择已有帧,不计算新能量或力。GPUMDkit1.5.8使用NepTrain2.2.0计算NEP描述符,最后保留原始标签。
module load gpumdkit/1.5.8
mkdir -p work/sampling
cp inputs/sampling/all.xyz inputs/sampling/seed.xyz \
   inputs/sampling/nep.txt work/sampling/
cd work/sampling
第二步:均匀或随机选4帧#
每次换一个新工作目录,避免固定文件名sampled_structures.xyz被覆盖。
python "$GPUMDkit_path/Scripts/sample_structures/sample_structures.py" \
  all.xyz uniform 4
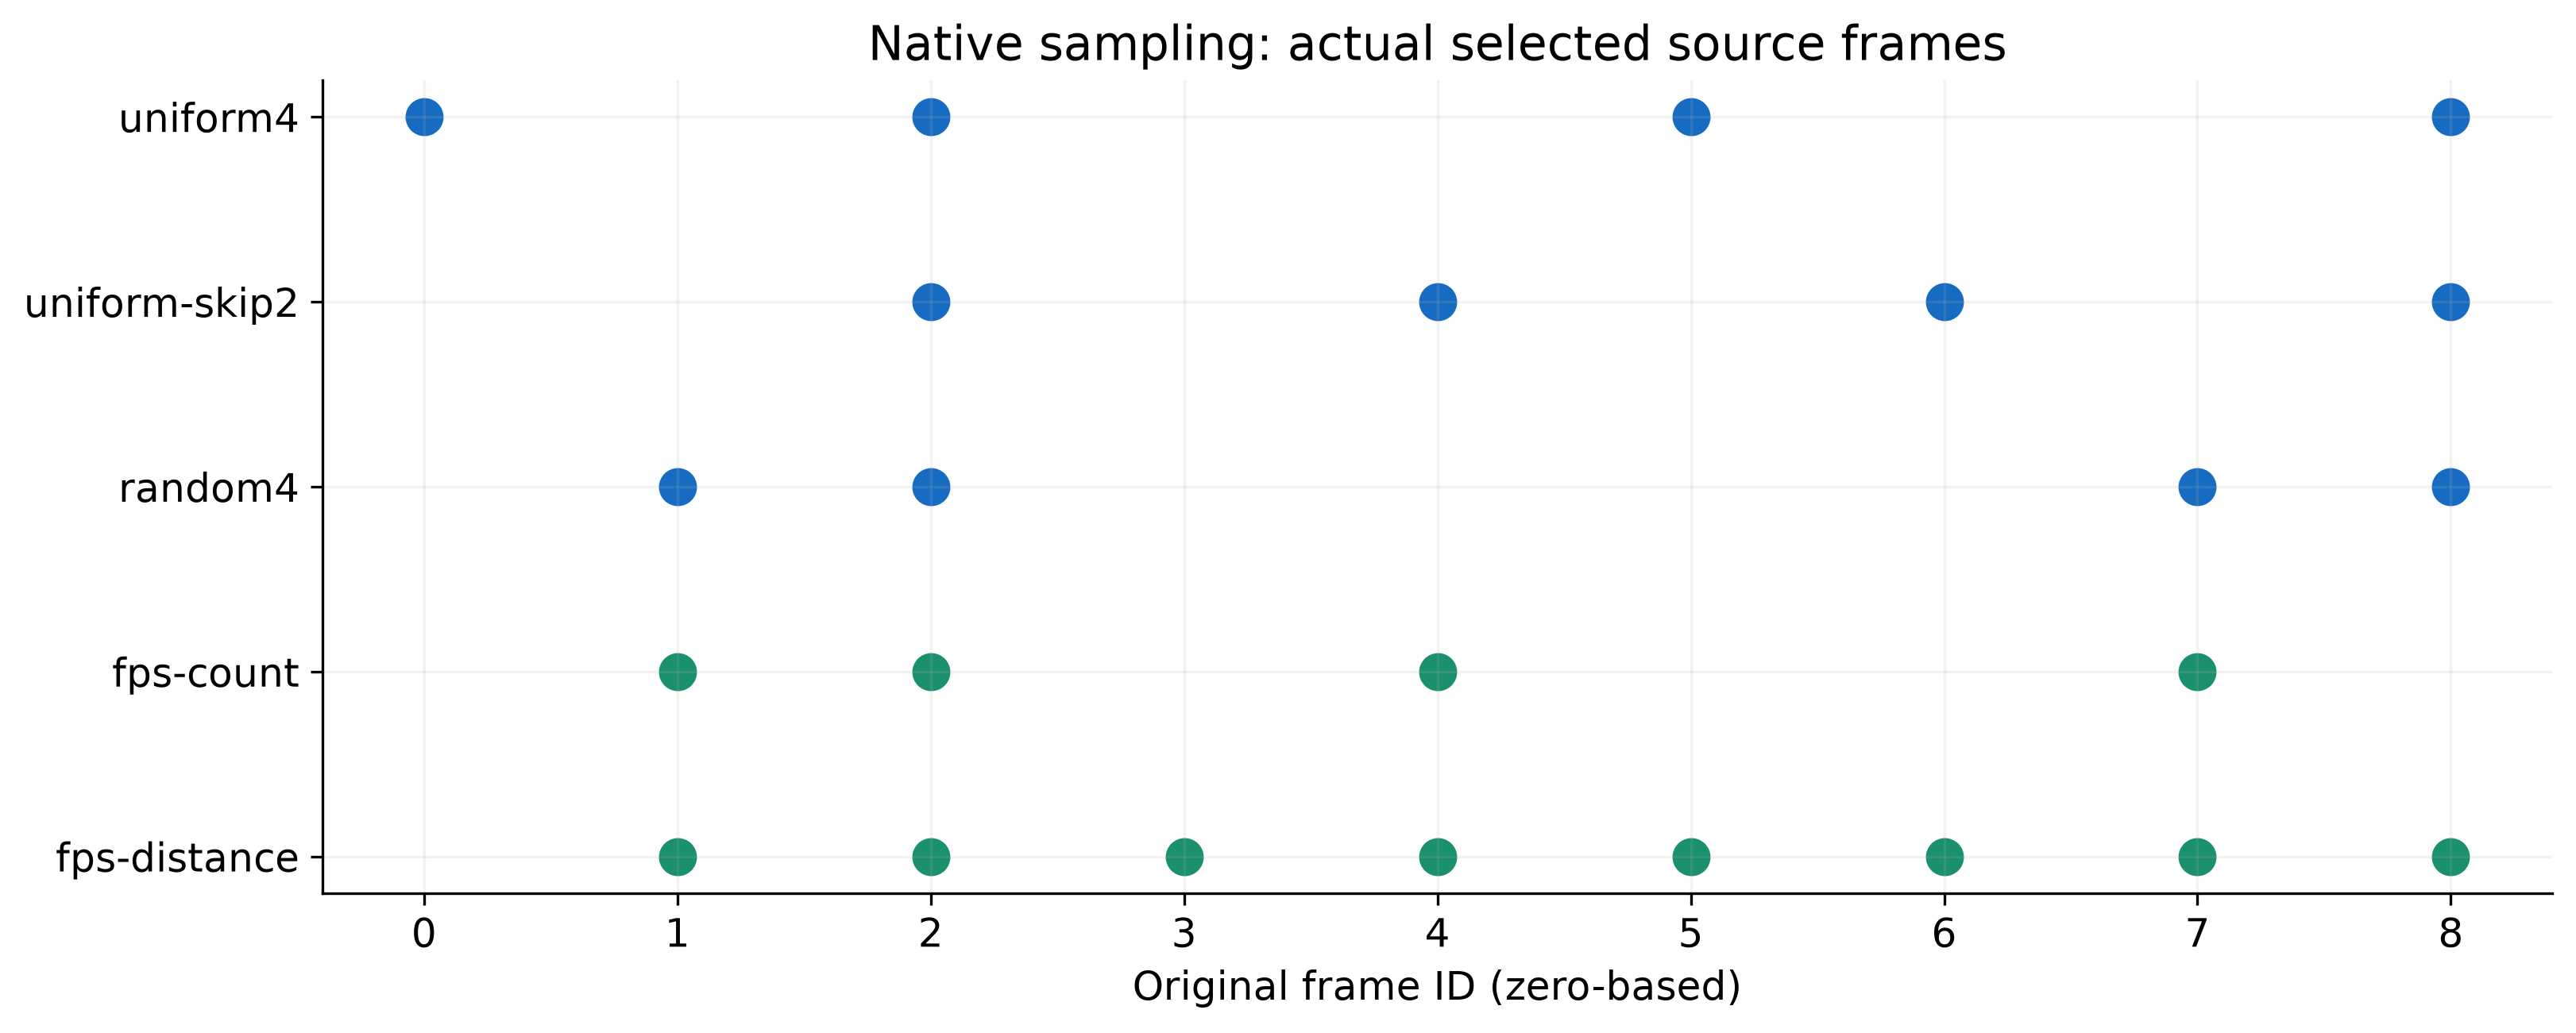
本次索引为0、2、5、8,从0计数。跳过前2帧:
python "$GPUMDkit_path/Scripts/sample_structures/sample_structures.py" \
  all.xyz uniform 4 2
得到2、4、6、8。最后一个2表示跳过前2个原始帧,不是每隔2帧取一个。
随机方法:
python "$GPUMDkit_path/Scripts/sample_structures/sample_structures.py" \
  all.xyz random 4
本次得到1、7、8、2,是不放回抽样;该入口没有固定种子参数,再运行索引可以不同。需要可复现的随机测试集时使用带种子拆分。
第三步:FPS固定数量#
python "$GPUMDkit_path/Scripts/sample_structures/parallel_neptrain_select_structs.py" \
  all.xyz seed.xyz nep.txt 2
依次输入:
2
4 4
即按数量选择,最少和最多都4个。末尾2是描述符进程数。本次顺序为4、7、2、1,依次挑离已有结构/已选结构最远的候选。
另开新目录,执行同一命令,改为:
1
0.000001
这次使用最小描述符距离阈值1e-6,选出4、7、2、1、8、3、6、5,剩余最大距离为0。已有零位移结构不会因为时间上靠前就被优先再选。
该距离依赖模型、描述符归一化和构型平均方式,不是Å,不是力误差,也没有跨材料通用的阈值。固定数量和距离阈值适合不同的采样目标。
第四步:检查输出#
工具写出selected.xyz、select.png及PCA坐标文本。本例每个被选帧的坐标、晶胞、E/F/virial均与原始帧一致;图是描述符的二维投影,不是材料相图。
python - <<'ASE'
from ase.io import read
for a in read("selected.xyz", index=":"):
    print(a.info["source_frame_id"], a.info["displacement_A"])
ASE
旧PyNEP入口保留用于既有环境;新工作流优先使用本篇NepTrain入口。若要根据运行中的模型分歧选帧,继续主动学习日志与结构配对。