
GPUMDkit 高阶描述符编辑与预测对照
实际增删四体、五体及q112等描述符,比较导出模型、重加维度与原权重的区别。
阅读本篇目录
下载模型、实际数据与操作资料包。解压进入目录,inputs / conversion-inputs 是输入,reference 保存集群参考结果。每次运行在 work 建立新目录,结果位置写入 LAST-RUN.txt。耗时预测和 GPU 对照请在分配好的计算资源内执行。
从网络规模继续到描述符#
神经元扩容与裁剪改变网络规模;本篇改变模型中启用的高阶描述符。使用同一个 NEP4 Te-Pb 模型、30 个神经元,分别操作四体项、五体项,以及菜单标记的 q_112、q_123、q_233、q_134 开关。
完整顺序是检查模型 → 准备配套优化器 → 每次从明确的源模型修改 → 成组导出 → 用同一结构重新预测。这里各分支都实际计算了同一个 250 原子 PbTe 结构;不进行新的模型训练。
1. 准备文件并打开菜单#
module purge
module load gpumdkit/1.5.8
python init_optimizer.py

gpumdkit.sh -nep_modifier model-input/nep.txt \
  model-input/nep.restart model-input/nep.in
init_optimizer.py 从包内公开模型新建 SNES 初始状态,标准差为 0.01;不是继续原来的训练优化器。若已有与自己模型匹配的真实重启,应使用自己的成组文件。详见模型导出与初始化。
原模型相关设置:
type 2 Te Pb
version 4
model_type 0
cutoff 8 4
n_max 6 6
basis_size 6 6
l_max 4 2 0
neuron 30
generation 1000
batch 1000
这段是本例模型参数,不是单靠它就能重建训练好的 nep.txt。完整权重在包内。l_max 后面的各个位置按程序的描述符约定解释,不是元素编号。
2. 去掉原有四体项#
在主菜单选择 2 裁剪 → 2 四体项 → 0 → 回车接受本次 SNES 设置 → y 确认 → 7 查看记录 → 8 导出 → without-4body → y → 0。
head -n 6 without-4body/nep_modified.txt
cat without-4body/nep_modified.in
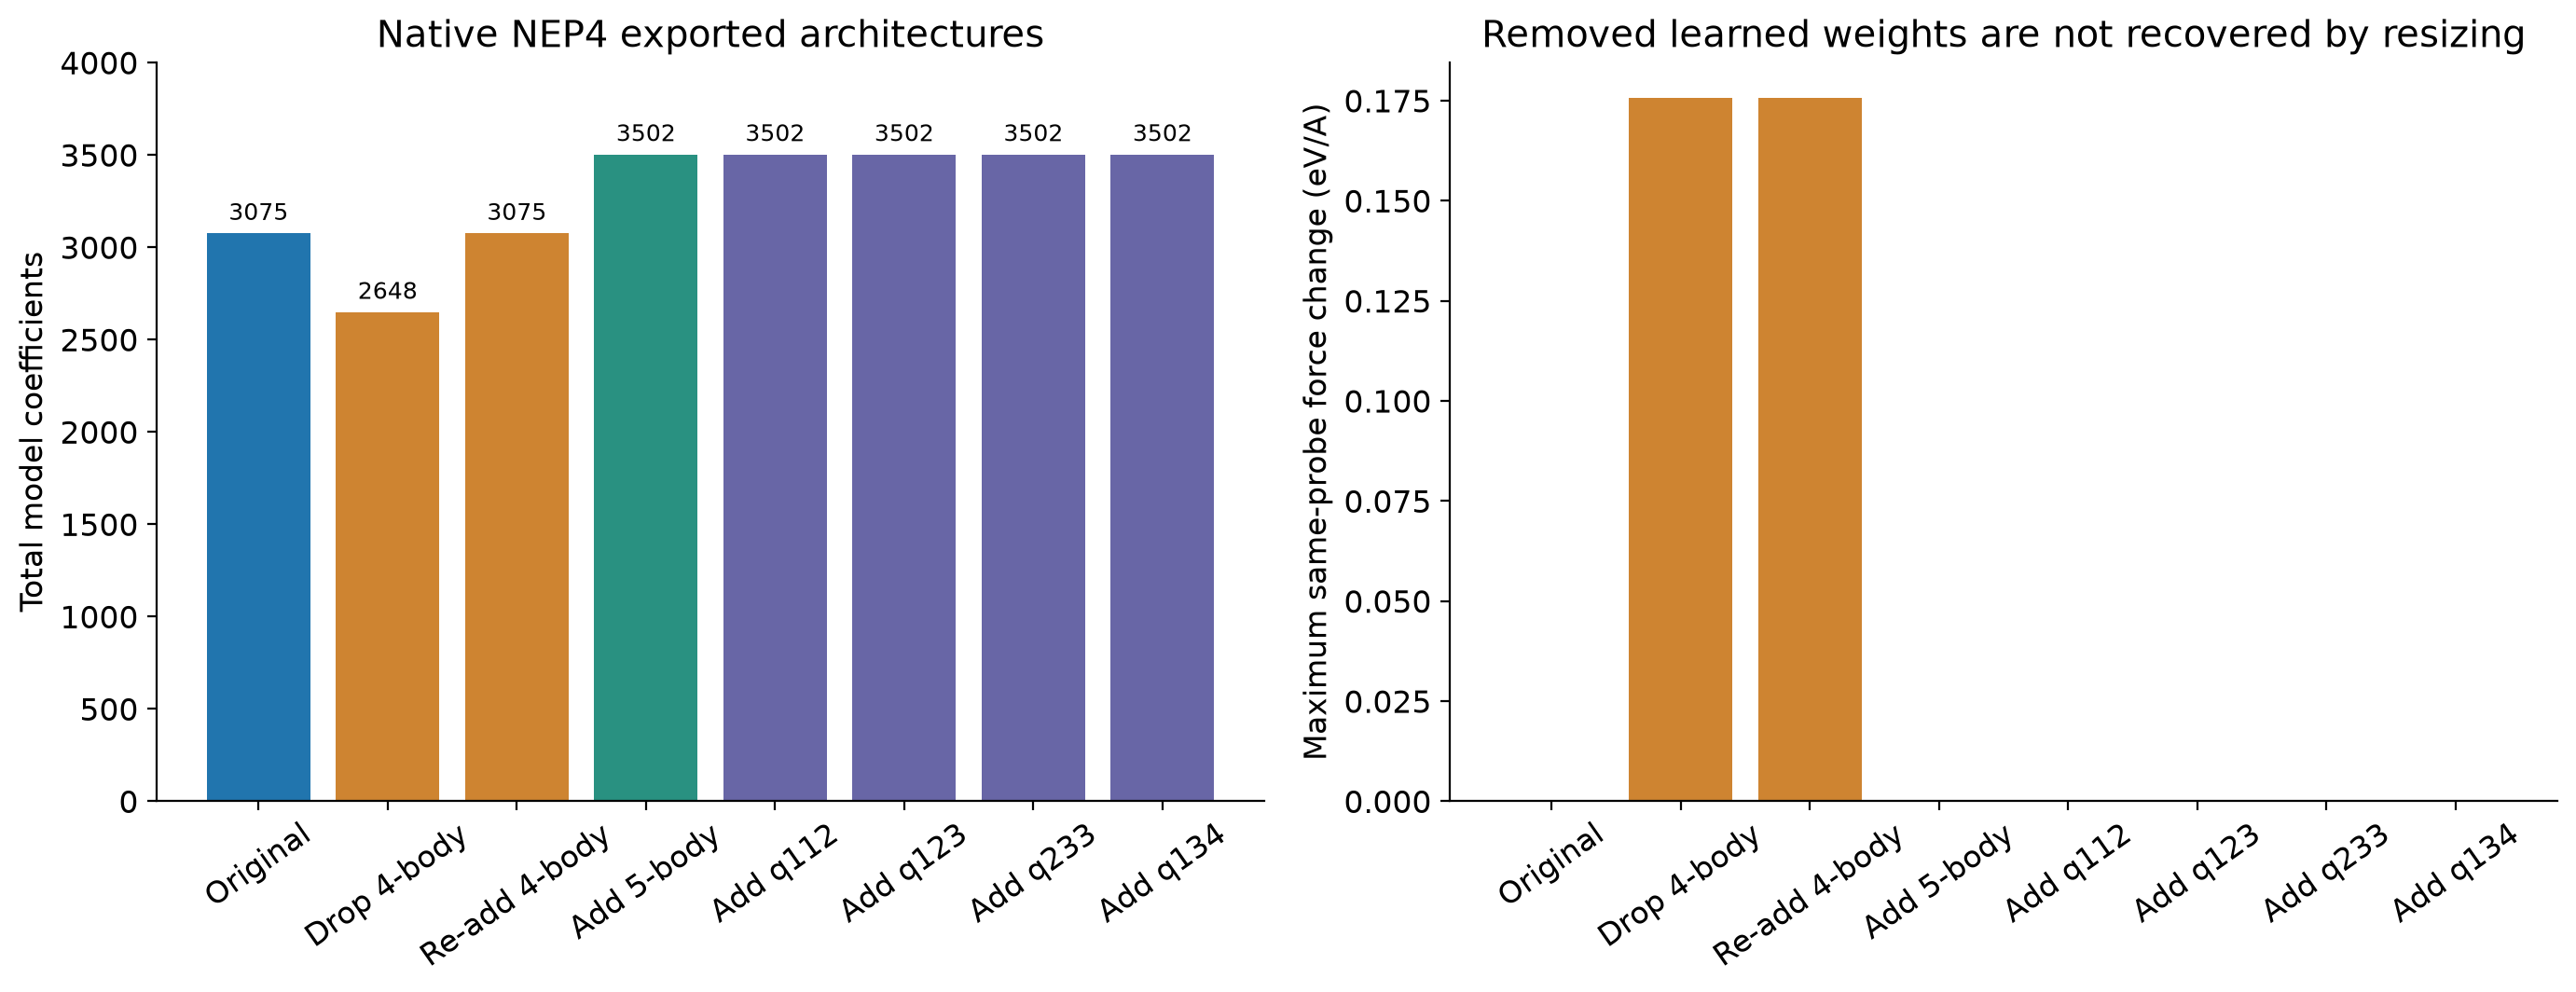
原来的 l_max 4 2 0 变为四体项关闭的配置;输入文件可能只写 l_max 4,省略项按默认零处理。总模型系数从 3075 降到 2648。
3. 从删减模型重新加回四体维度#
这一次打开刚导出的文件:
gpumdkit.sh -nep_modifier without-4body/nep_modified.txt \
  without-4body/nep_modified.restart without-4body/nep_modified.in
选择 1 扩容 → 2 四体项 → 2 → 回车 → y → 7 → 8 → readd-4body → y → 0。
系数数量重新变成 3075,但新增部分按初始化规则建立,删掉的原始权重不会自动回来。
同一个 250 原子结构上的实际对照:
| 操作 | 模型总系数 | 相对原模型最大原子力变化(eV/Å) |
|---|---|---|
| 原模型 | 3075 | 0 |
| 删除四体项 | 2648 | 0.17571579 |
| 再加回四体维度 | 3075 | 0.17571579 |
这两个修改模型的结构总能量相对原模型均变化约 0.06368067 eV。恢复维度与恢复参数内容不同;需要回到原模型时使用保留的原文件。
4. 新增五体项与其他高阶开关#
下面每个分支都重新从 原始 model-input 打开编辑器,避免把多种变化混在一起。
| 目标 | 主菜单 | 子菜单 | 接着输入 |
|---|---|---|---|
| 新增五体项 | 1 扩容 | 3 五体项 | 目标值 1 |
| 启用 q_112 | 1 扩容 | 4 | 无需输入新的维度数 |
| 启用 q_123 | 1 扩容 | 5 | 无需输入新的维度数 |
| 启用 q_233 | 1 扩容 | 6 | 无需输入新的维度数 |
| 启用 q_134 | 1 扩容 | 7 | 无需输入新的维度数 |
随后按提示 回车接受本次初始化 → y 确认 → 7 记录 → 8 导出 → 新目录名 → y → 0。
本例每个单独新增分支得到 3502 个总系数。q_112 等名称是程序中的不变量开关标签,不能当成三个元素或三个神经元编号。
要移除刚新增的项,打开该分支导出文件,选择 2 裁剪下的同一个子菜单;五体目标设为 0,其他开关直接关闭,然后按提示确认和导出。资料包共运行 12 个高阶项增删分支:四体删除/重加、五体增删和四个 q 开关增删。
5. 预测与 CPU/GPU 对照#
只运行所有模型编辑和 CPU 预测:
bash run.sh models
分配好 P100 后进行整组对照:
sbatch run.sbatch
包内 predict_one.py 用 Calorine CPUNEP 计算能量、力、应力;gpu_branches.py 使用 GPUMD 5.9.1 + Calorine GPUNEP 做 GPU 单点,并保留调度器分配的可见 GPU。
本次新增零权重高阶项后,已有探针的输出保持;关闭这些刚新增项也回到原结果。包含本例与电荷输出头的 17 组 CPU/P100 对照最大力差小于 1×10⁻⁴ eV/Å。这是同一模型跨计算路径的数值对照,不是新增描述符已经学会目标物性的证明。
正式训练还需匹配的标签数据和重新评估。若要增加电荷输出,继续看电荷模型输出头。