
GPUMDkit 数据去重与分组拆分
保留原始数据,识别重复与冲突标签,再按结构族划分训练和留出集。
阅读本篇目录
下载本组输入、真实参考输出与绘图脚本,解压后进入资料包根目录。所有示例在自己的新目录执行,inputs和reference保留。默认bash run.sh all只做工具处理;需要重新训练时才提交compute.sbatch。
先检查,再划分#
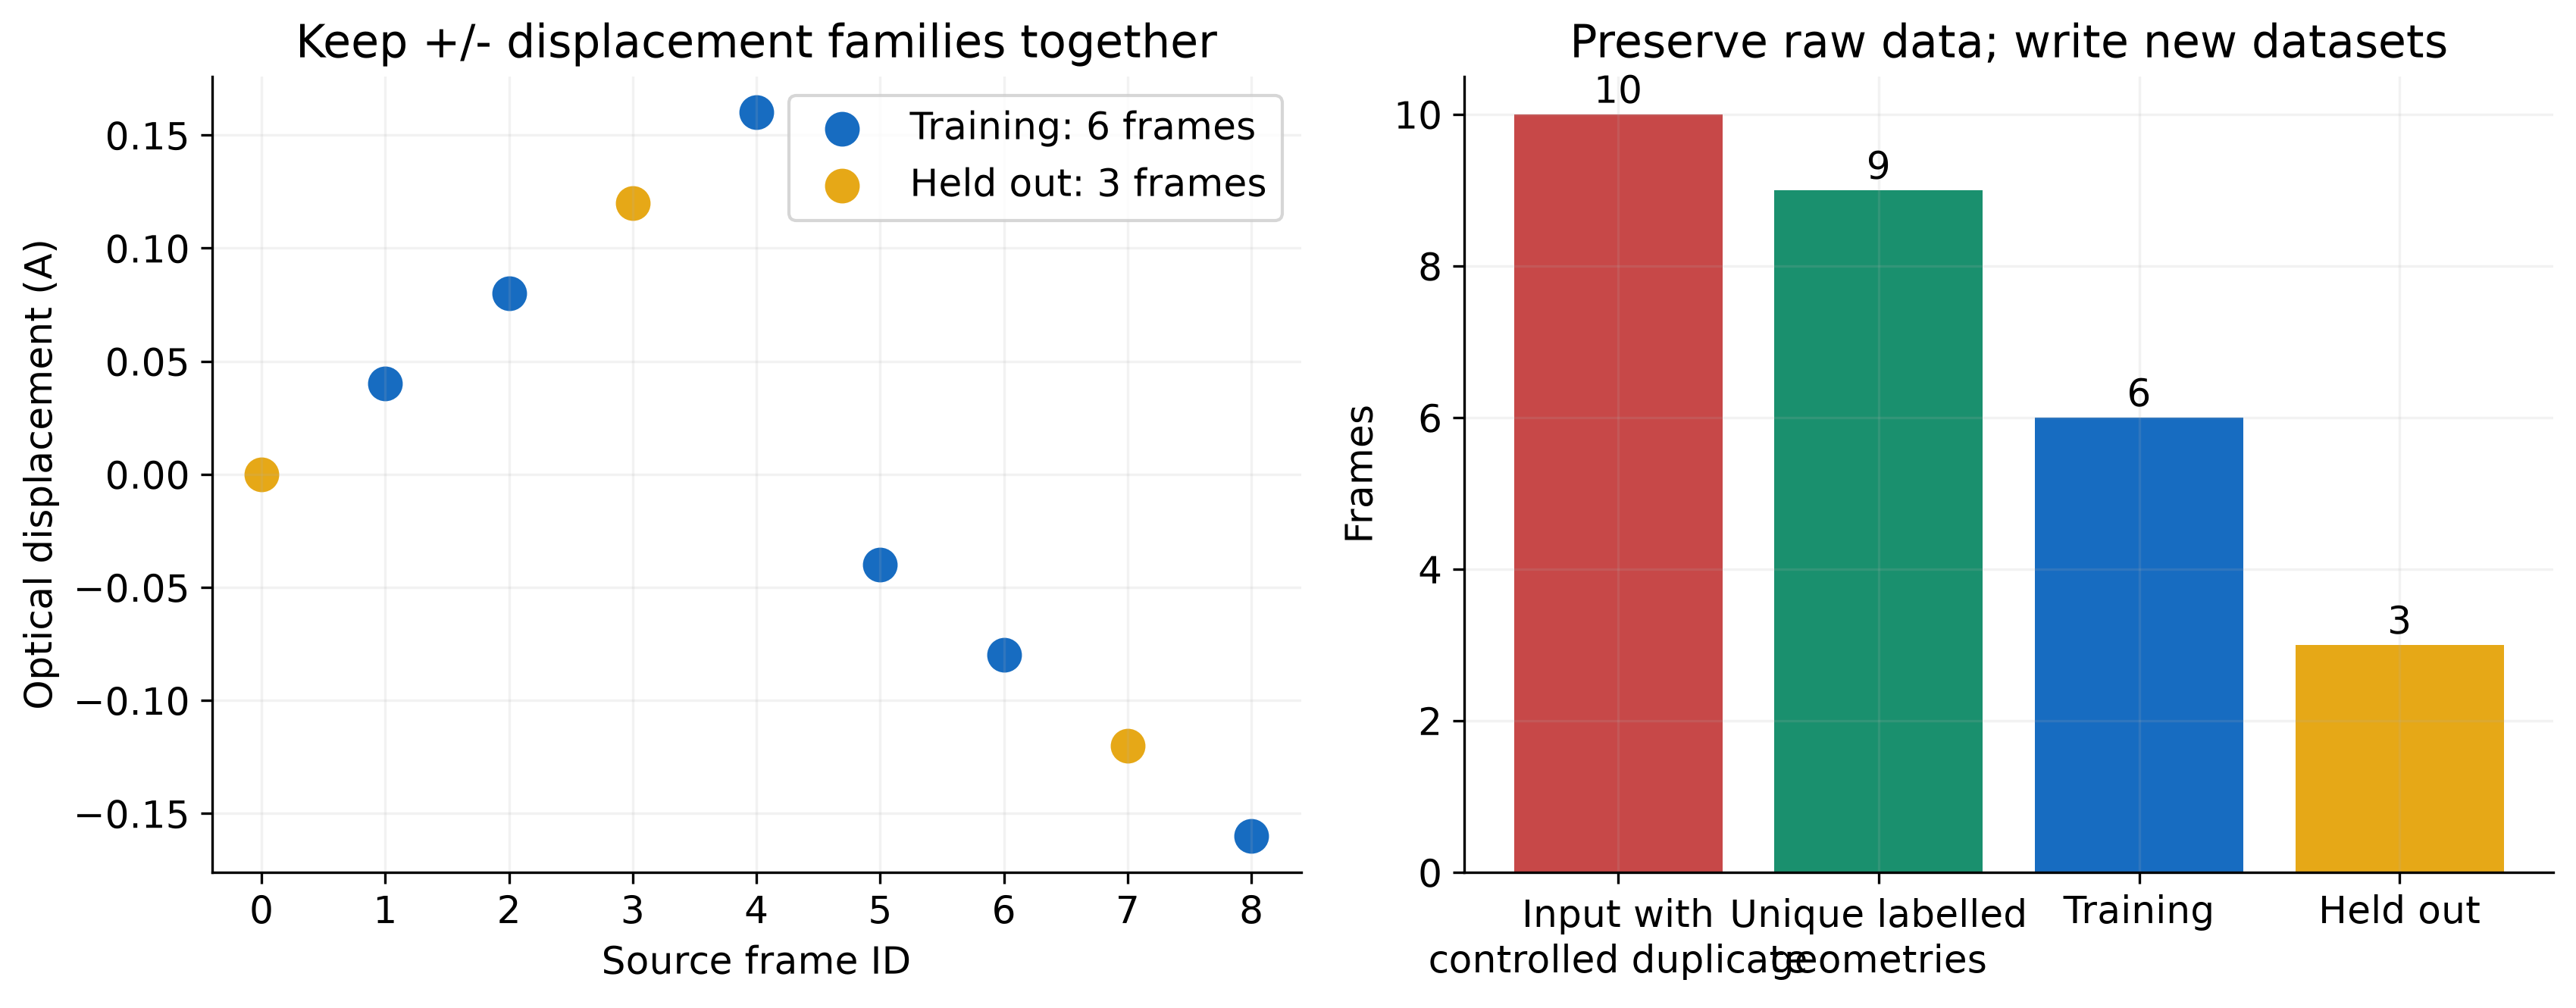
本例使用9个真实Si自洽位移结构,并额外复制第一帧,构造10帧的去重练习。第10帧是受控重复,不是新增DFT。原始文件始终保留。
module load gpumdkit/1.5.8
python dataset_audit.py \
  reference/sampling/audit-controls/with-duplicate.xyz work/clean-family
这是资料包附带的ASE辅助脚本。它核对能量、力和可用virial,按相同原子顺序的元素、晶胞、PBC和坐标识别重复;坐标/晶胞保留10位小数参与指纹。它不做原子重排、晶体对称等价或周期平移等价识别。
输出:
work/clean-family/unique.xyz
work/clean-family/train.xyz
work/clean-family/test.xyz
work/clean-family/audit.json
10帧保留9个唯一几何,最终6帧训练、3帧留出。若同一几何对应不同E/F/virial,脚本会要求先核查来源,不会默默丢掉一份标签。
为什么按结构族分组#
本组正负位移来自同一光学模分支。按位移绝对值把±0.04、±0.08、±0.16Å放入训练;0和±0.12Å放入留出。这样同一±位移族不会分到两边。
这仍是同一小晶胞、同一位移分支的插值示范,不能声称对熔体、表面、缺陷或不同材料具有独立泛化能力。实际MD数据还应按独立轨迹、温度段或结构族组织拆分。
GPUMDkit原生三种拆分方法#
在新目录放入inputs/sampling/all.xyz,调用原生脚本:
mkdir -p work/split-random
cp inputs/sampling/all.xyz work/split-random/
cd work/split-random
python "$GPUMDkit_path/Scripts/sample_structures/split_train_test.py" all.xyz
依次输入:
3
2
20261028
分别是3个测试帧、随机方法2、固定随机种子。输出all_train.xyz与all_test.xyz。本次测试索引为0、1、4,两次同种子运行一致。
| 方法 | 第一个输入 | 第二个输入 | 后续输入 | 本次测试帧ID |
|---|---|---|---|---|
| 均匀 | 0.3333333333333333 | 1 | 无 | 0、4、8 |
| 随机 | 3 | 2 | 20261028 | 0、1、4 |
| FPS | 3 | 3 | nep.txt | 0、4、7 |
FPS需要把配套inputs/sampling/nep.txt也复制进新目录。三种方法都得到6+3帧,帧ID不重叠且合起来覆盖原始9帧。随机/均匀/FPS按帧拆分不等于按轨迹或结构族分组;需要防止相邻帧泄漏时,用上面的分组方式。
距离、范围和异常点继续怎么查#
gpumdkit.sh -min_dist_pbc all.xyz
gpumdkit.sh -range all.xyz force
gpumdkit.sh -range all.xyz virial
距离和标签范围能揭示明显异常,但阈值随材料而变。预测后再用逐帧误差与逐元素统计定位误差大的结构。筛选时同时保留被排除的帧和索引,不能只留下看起来容易拟合的数据。