
ATAT簇展开的训练、交叉验证与独立留出
真实Cu–Au DFT和Cu–Au–Al EMT分别拟合,预测从未参与本次拟合的5个结构。
阅读本篇目录
下载本批输入、参考结果、数据图和运行脚本。从解压后的附件根目录操作,结果进入独立work目录;已有目录拒绝覆盖。使用申请的计算资源运行,CPU程序并不因模板选择P100分区而自动获得GPU加速。
1. 先把参考方法分清#
| 模型 | 数据来源 | 训练/留出 | 母晶格 |
|---|---|---|---|
| 二元Cu–Au | VASP6.4.2/PBE实际29个单点 | 24/5 | 固定FCC,a=3.85Å |
| 三元Cu–Au–Al | ASE EMT实际30个静态能量 | 25/5 | 固定FCC,a=3.9Å |
二元DFT参数、29个能量与精度对照见原簇展开教程。本批复用已收敛的标签重新拟合,没有把EMT当成DFT,也没有为运行工具再算一次相同的DFT。
固定在拟合前留出编号5、10、15、20、25,两个数据集各5个。纯端元留在训练中。训练目录只放训练energy;留出str.out和参考能量保存在单独数据记录中,ATAT拟合时不读取其参考值。
2. 启动新拟合#
sbatch run.sbatch ce binary
sbatch run.sbatch ce ternary
输出分别写work/ce/binary、work/ce/ternary。脚本会等待ECI生成并在输出稳定后停止本次maps/mmaps;不是启动一个永久后台任务。
二元调用的原生命令为:
python fit_ce.py maps -d -t=1 -g=4 -mv=4
clusterexpand -cv energy
上述是脚本内部步骤,fit_ce.py位于附件根目录;如果手动执行,应先在新拟合目录准备好lat.in、训练编号目录,并使用该脚本的正确路径。三元对应mmaps -d -t=1 -mv=3 -m=3。不要把仅支持二元的maps直接用于三元。
3. 预测放到独立目录#
clusterpredict会向当前结构目录写energy。因此脚本另建prediction,复制lat.in、clusters.out、energy.eci和energy.ecimult,再在每个留出目录运行:
clusterpredict energy > prediction.log
这一点很重要:不要在唯一的DFT训练目录直接执行它,否则会把真实energy替换成预测值。预测结束后,本例逐字节核对所有训练energy保持原样。
4. 看二元的真实留出结果#
| 编号 | DFT eV/atom | CE eV/atom | 预测−DFT meV/atom |
|---|---|---|---|
| 10 | -3.505696 | -3.498375 | 7.321 |
| 15 | -3.122611 | -3.121750 | 0.861 |
| 20 | -3.170282 | -3.165000 | 5.282 |
| 25 | -3.312593 | -3.320900 | -8.307 |
| 5 | -3.164289 | -3.166830 | -2.541 |
二元5个留出RMSE=5.616meV/atom,MAE=4.862meV/atom;本次训练内CV=6.42meV/atom。CV用于评估拟合选择,留出预测是另一个检查,两者不应混为同一个数字。
三元EMT的5个留出RMSE=5.480meV/atom,MAE=4.579meV/atom,准确说法是“对EMT标签的误差”,不能写成对DFT或实验的精度。
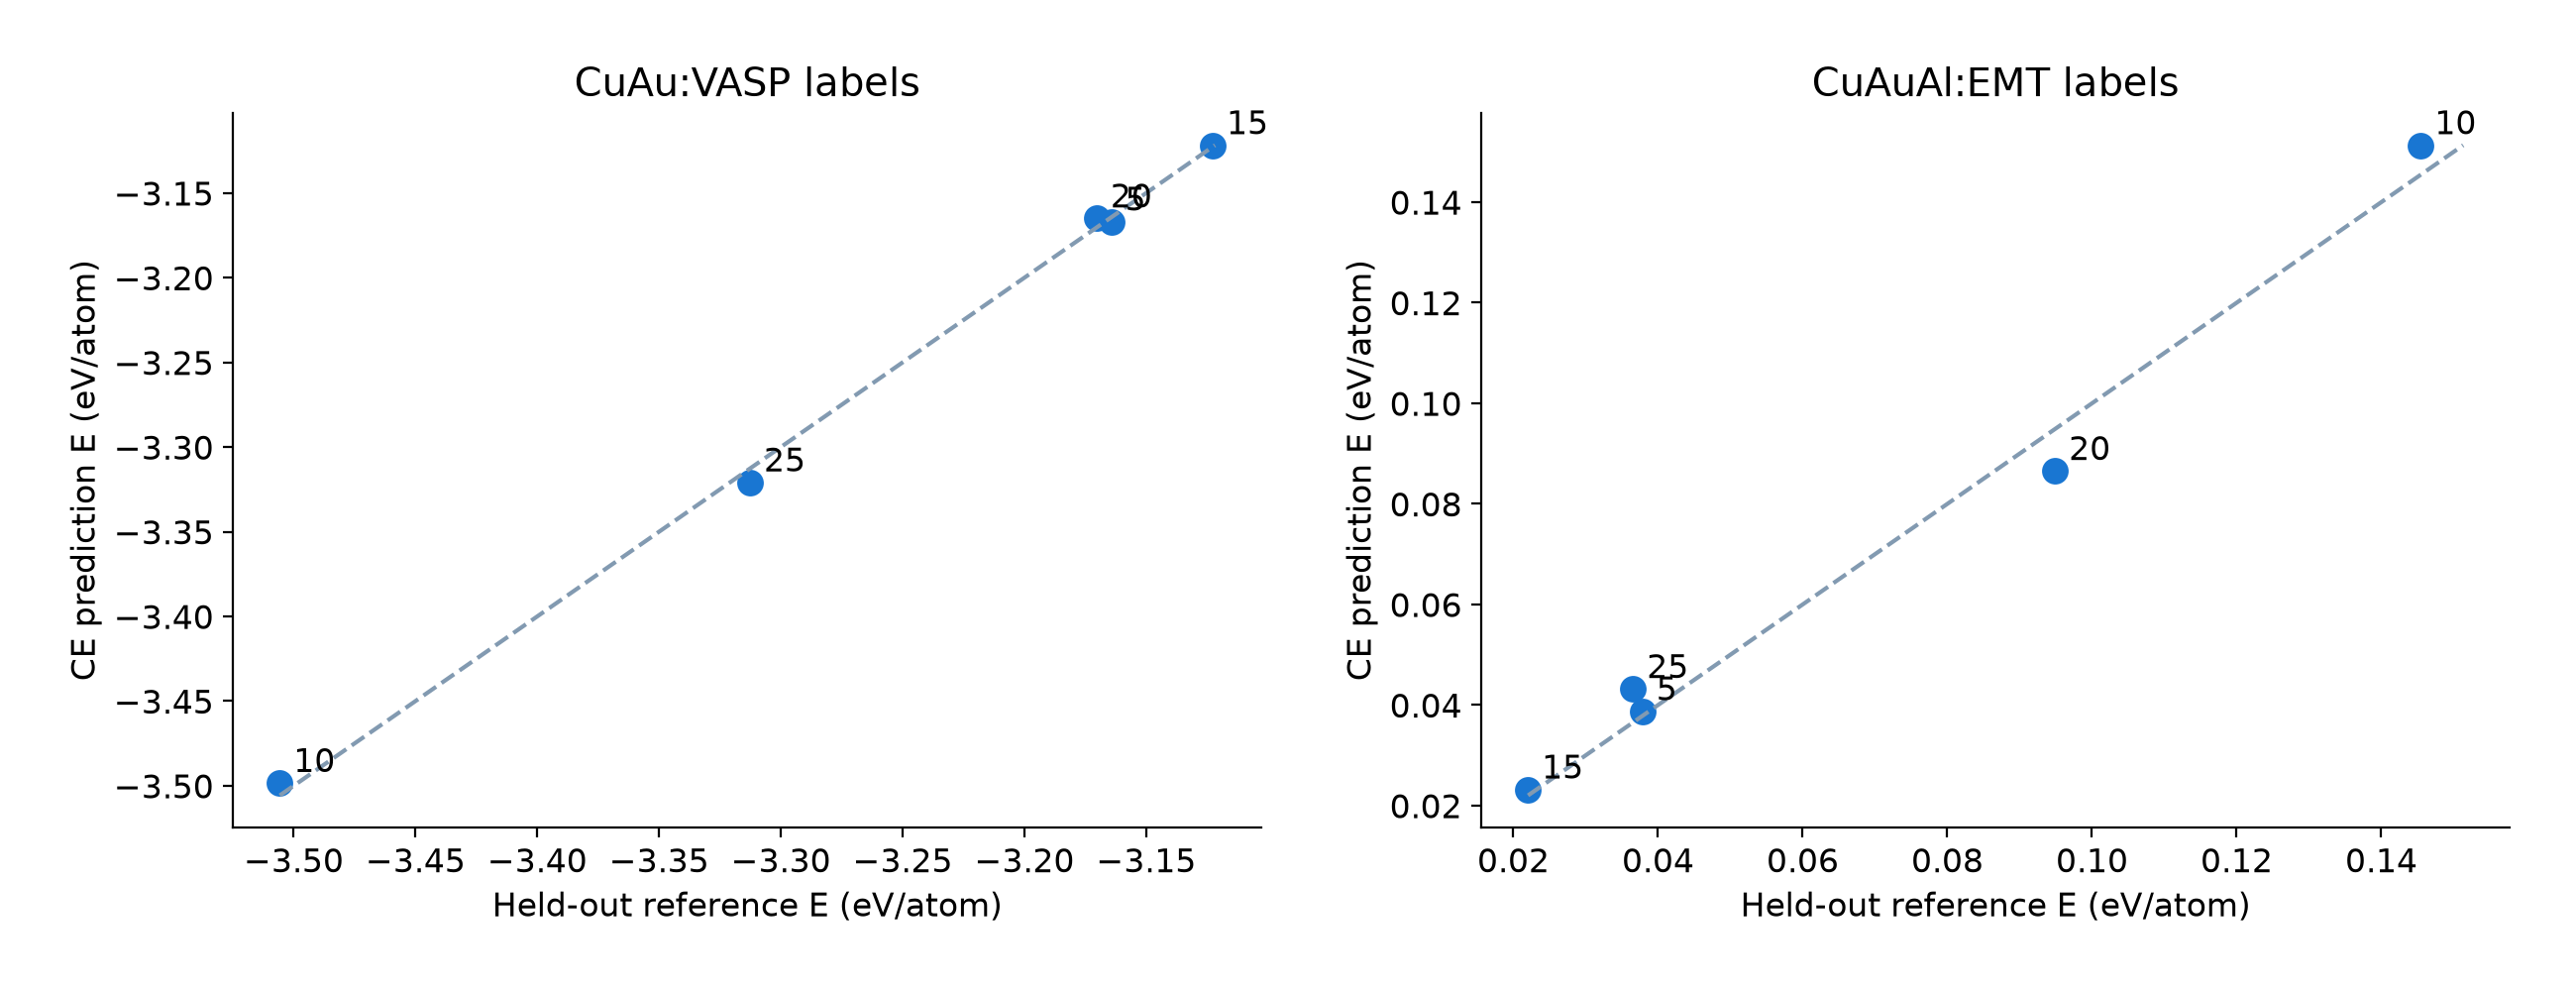
这仍是小候选集合、固定晶格的插值检查。更大超胞、缺陷、弛豫结构和新组分必须另做测试;不能用很小CV代替对遗漏竞争结构的检查。