
DeePMD描述符与DPA1、DPA2、DPA3输入实例
七族小模型和TensorFlow实例,提供实际JSON与误差。
阅读本篇目录
下载结构、标签、完整JSON、冻结模型、参考结果和脚本。解压到自己的工作目录,以下命令从附件根目录开始。预处理可交互操作;训练、批量预测和MD在申请的计算资源内运行。所有新结果进入work,不覆盖reference。
1. 单独训练各族#
sbatch train.sbatch se_e2_a
sbatch train.sbatch se_e2_r
sbatch train.sbatch se_e3
sbatch train.sbatch hybrid
sbatch train.sbatch se_atten_v2
sbatch train.sbatch dpa2
sbatch train.sbatch dpa3
sbatch train.sbatch tf-se_e2_a
每个名字对应inputs下完整JSON。不同任务用自己的目录;各200步,不能按这张表给模型架构排性能名次。DPA1使用se_atten名称,见前一篇500步输入。
2. 描述符片段#
下表述的是实际输入用途;完整descriptor代码紧随其后。se_e2_a含局域角向信息,se_e2_r为径向描述;hybrid组合两者;se_e3增加三体信息。DPA注意力/消息表示不能套用se_e2_a的sel列表格式。
se_e2_a#
{
  "rcut": 4.0,
  "rcut_smth": 3.5,
  "sel": [
    64
  ],
  "neuron": [
    8,
    16
  ],
  "resnet_dt": false,
  "seed": 20261028,
  "precision": "float64",
  "type": "se_e2_a",
  "axis_neuron": 4
}
se_e2_r#
{
  "rcut": 4.0,
  "rcut_smth": 3.5,
  "sel": [
    64
  ],
  "neuron": [
    8,
    16
  ],
  "resnet_dt": false,
  "seed": 20261028,
  "precision": "float64",
  "type": "se_e2_r"
}
se_e3#
{
  "rcut": 4.0,
  "rcut_smth": 3.5,
  "sel": [
    64
  ],
  "neuron": [
    8,
    16
  ],
  "resnet_dt": false,
  "seed": 20261028,
  "precision": "float64",
  "type": "se_e3"
}
hybrid#
{
  "type": "hybrid",
  "list": [
    {
      "rcut": 4.0,
      "rcut_smth": 3.5,
      "sel": [
        64
      ],
      "neuron": [
        8,
        16
      ],
      "resnet_dt": false,
      "seed": 20261028,
      "precision": "float64",
      "type": "se_e2_a",
      "axis_neuron": 4
    },
    {
      "rcut": 4.0,
      "rcut_smth": 3.5,
      "sel": [
        64
      ],
      "neuron": [
        8,
        16
      ],
      "resnet_dt": false,
      "seed": 20261028,
      "precision": "float64",
      "type": "se_e2_r"
    }
  ]
}
se_atten_v2#
{
  "type": "se_atten_v2",
  "rcut": 4.0,
  "rcut_smth": 3.5,
  "sel": 64,
  "neuron": [
    8,
    16
  ],
  "axis_neuron": 4,
  "resnet_dt": false,
  "attn": 16,
  "attn_layer": 1,
  "attn_dotr": true,
  "attn_mask": false,
  "seed": 20261028,
  "precision": "float64"
}
dpa2#
{
  "type": "dpa2",
  "precision": "float64",
  "seed": 20261028,
  "repinit": {
    "rcut": 4.0,
    "rcut_smth": 3.5,
    "nsel": 64,
    "neuron": [
      8,
      16
    ],
    "axis_neuron": 4,
    "tebd_dim": 8
  },
  "repformer": {
    "rcut": 3.5,
    "rcut_smth": 3.0,
    "nsel": 32,
    "nlayers": 1,
    "g1_dim": 16,
    "g2_dim": 8,
    "axis_neuron": 4
  }
}
dpa3#
{
  "type": "dpa3",
  "precision": "float64",
  "seed": 20261028,
  "repflow": {
    "n_dim": 16,
    "e_dim": 8,
    "a_dim": 8,
    "nlayers": 1,
    "e_rcut": 4.0,
    "e_rcut_smth": 3.5,
    "e_sel": 64,
    "a_rcut": 4.0,
    "a_rcut_smth": 3.5,
    "a_sel": 16,
    "axis_neuron": 4
  }
}
DPA2本例必须同时满足repinit.rcut大于repformer.rcut,以及repinit.nsel大于repformer.nsel,因此使用4/3.5Å与64/32。把两层截断或容量都写成一样,在当前3.2.0输入中不适用。
3. 读取实际留出误差#
| 模型 | E RMSE eV/atom | F RMSE eV/Å | W RMSE eV/atom |
|---|---|---|---|
| dpa2 | 0.321959 | 1.051434 | 5.449877 |
| dpa3 | 0.085944 | 1.348085 | 0.483404 |
| hybrid | 0.240139 | 1.303778 | 1.480527 |
| se_atten_v2 | 0.085938 | 1.311160 | 1.179530 |
| se_e2_a | 0.189158 | 1.310593 | 1.307788 |
| se_e2_r | 0.085739 | 1.348553 | 0.546747 |
| se_e3 | 0.070507 | 1.146952 | 1.898355 |
| tf-se_e2_a | 0.319653 | 1.243751 | 5.263328 |
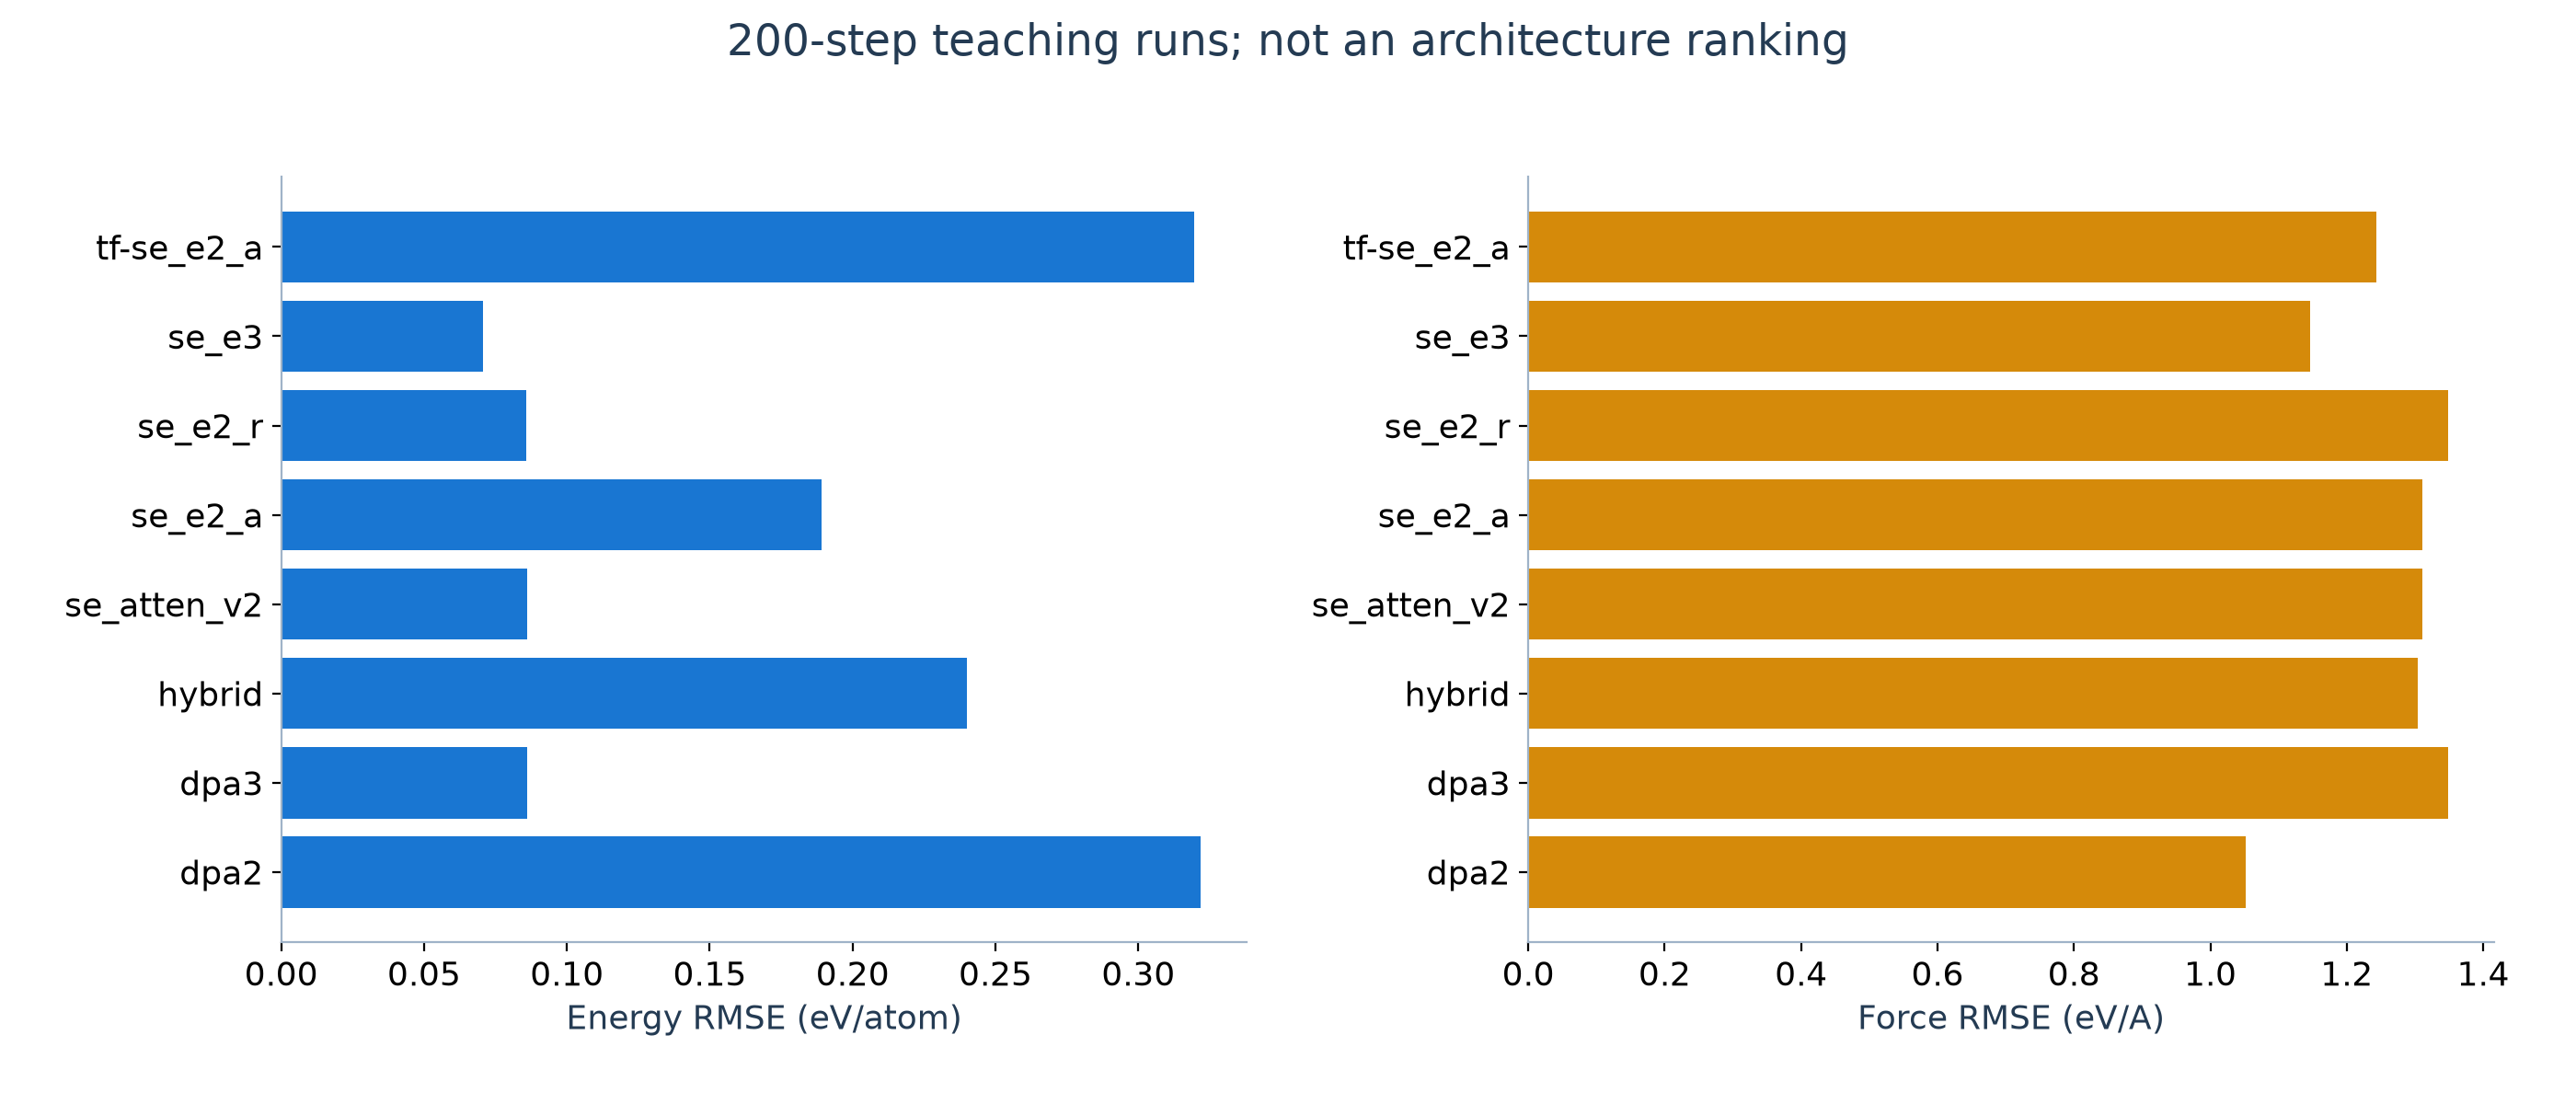
本例固定数据很少,各族参数量和训练难度也不完全相同。TensorFlow模型是独立训练,不是PyTorch原模型换一个加载器。loc_frame、元素嵌入变体、掩码/自旋及专用张量网络有自己的输入要求,不能用本页已跑通的7族代表全部注册类型。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。