
GPUMDkit PyNEP抽样与数据集对比
用PbTe实际数据演示数量、距离两种最远点抽样,保留结构与标签对应,并比较PCA和UMAP描述符。
阅读本篇目录
想从一批相似结构里选出值得补充计算的构型,可以先比较NEP描述符,再做最远点抽样(FPS)。本例有16个PbTe候选结构、4个已有结构,每帧250原子;数据来自公开NEP示例,演示的是选结构,没有产生新的DFT标签。
新项目优先使用203 NepTrain抽样。本文帮助复现已有PyNEP流程:共享GPUMDkit1.5.8已提供PyNEP0.0.1,菜单202仍显示弃用提示,兼容命令-pynep可使用。这两个行为不矛盾。
1. 准备资料和环境#
下载输入、参考结果和绘图程序,解压进入资料包目录。以下每条run.py命令创建独立work/案例名,不会覆盖已有目录。
module load gpumdkit/1.5.8
gpumdkit.sh -doctor
python run.py --list
python run.py pynep-parallel-count
打开work/pynep-parallel-count,输入为:
| 文件 | 作用 |
|---|---|
| candidates.xyz | 16个候选结构,保留原始能量和force标签 |
| existing.xyz | 4个已有训练结构,用作已覆盖区域 |
| nep.txt | 与Pb、Te元素匹配的NEP模型 |
| answers.in | 本例交互选项的文字记录 |
描述符是模型对局部原子环境的表征;本入口先对每帧原子描述符取平均,再比较帧间距离。距离不是能量差,也不是误差估计,阈值不能跨模型直接照搬。PyNEP兼容分支不用于qNEP。
2. 按数量选4帧#
也可以复制输入后逐条运行,便于换自己的数据:
cp -r inputs/pynep-parallel-count my-fps
cd my-fps
gpumdkit.sh -pynep
依次输入:
candidates.xyz existing.xyz nep.txt 2
2
4 4
第一行末尾2是并行进程数;第二行选择按数量;4 4指定数量范围的下限和上限均为4。不要把进程数理解为选择的结构数。输出selected.xyz和select.png。
本例按选择顺序得到源候选的0起始索引 11、7、10、5,对应人习惯从1数的第12、8、11、6帧。原子坐标、晶胞、能量、force标签一同保留。不能只按排序重排坐标而把标签留在原位。
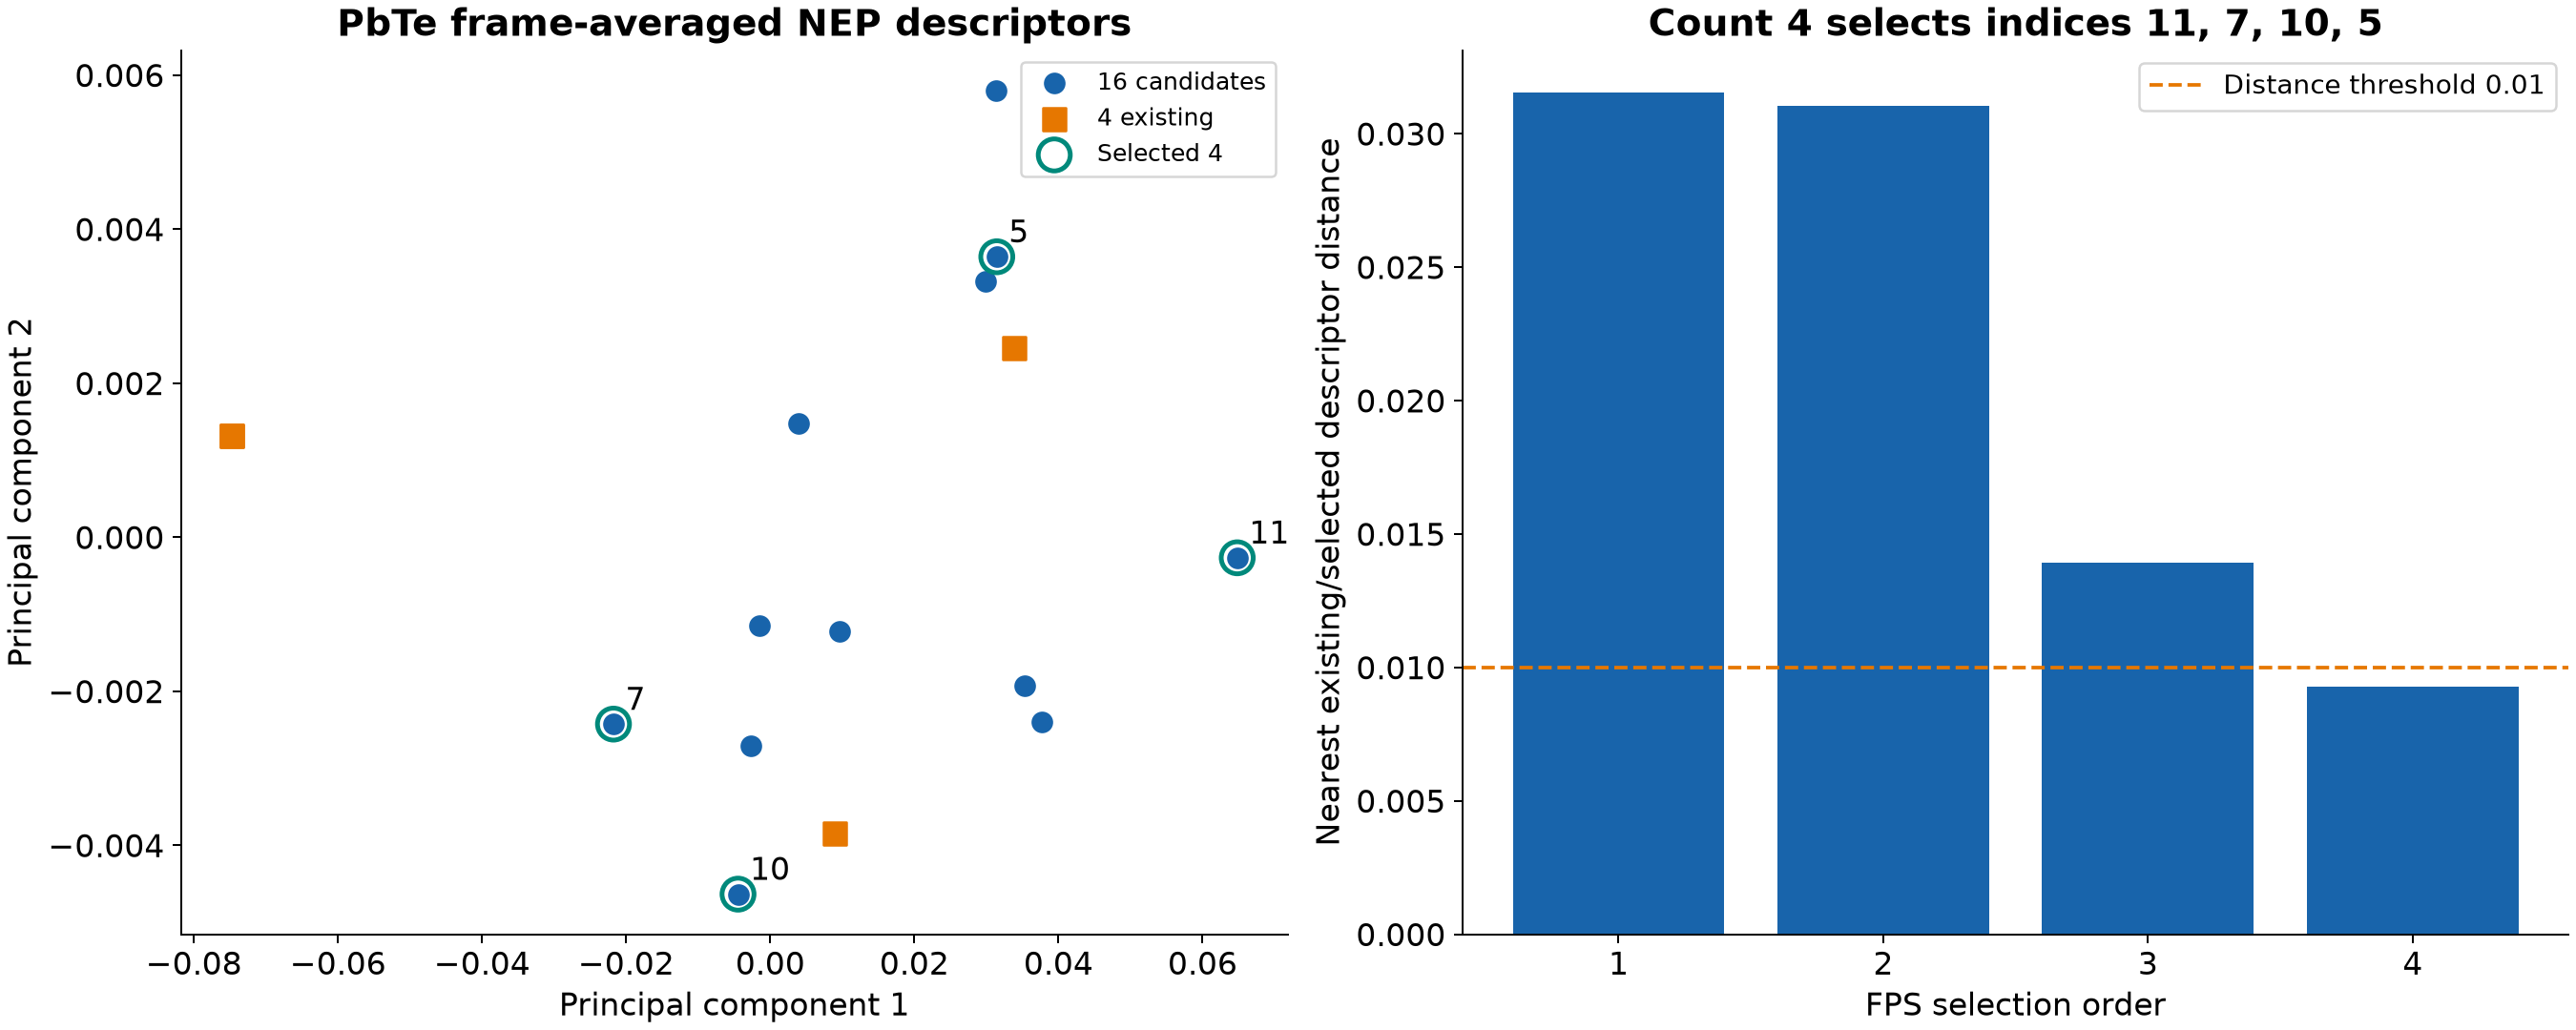
左图是平均描述符的二维PCA投影,圈出选中的4帧;FPS实际在完整描述符空间工作,不是在这张二维图上选点。右图显示逐次选中结构到已有/已选集合的最近距离。
3. 按距离选取#
回到资料包根目录:
python run.py pynep-parallel-distance
原生命令仍是gpumdkit.sh -pynep,输入改成:
candidates.xyz existing.xyz nep.txt 2
1
0.01
本例选出 11、7、10 三帧,第四帧的距离已低于0.01。得到的帧数取决于候选集、已有集、模型和阈值,不应先假定一定选出某个比例。
4. 串行旧脚本怎样运行#
兼容已有自动化脚本时,可以直接调用串行入口:
python run.py pynep-serial-count
python run.py pynep-serial-distance
对应原生命令是:
python "$GPUMDkit_path/Scripts/sample_structures/pynep_select_structs.py" \
  candidates.xyz existing.xyz nep.txt
随后输入2和4 4,或输入1和0.01。本例串行与2进程版本选择的帧及标签一致。并行任务完成顺序可能变化,但输出必须始终对应原始帧索引。
5. 比较两个数据集覆盖的环境#
补充脚本可以只看某一种元素周围的环境,本例选Pb:
python run.py des-compare-pca
python run.py des-compare-umap
逐条运行时:
python "$GPUMDkit_path/Scripts/plt_scripts/plt_descriptors_compare.py" \
  pca nep.txt Pb candidates.xyz existing.xyz
python "$GPUMDkit_path/Scripts/plt_scripts/plt_descriptors_compare.py" \
  umap nep.txt Pb candidates.xyz existing.xyz
两个命令都写descriptors.png,应放在不同目录。本脚本不要追加save,否则会把它当成另一个数据文件。脚本对合并后的描述符特征做标准化,UMAP使用固定随机种子42;它与前面的帧平均PyNEP图不是同一套投影坐标,不能把点的位置直接相减。
6. 选完结构后做什么#
- 检查
selected.xyz的元素、周期边界、近距离和晶胞。 - 为新构型准备与原训练集一致的DFT计算设置。
- 得到收敛的能量、力和所需virial标签后再追加训练数据。
- 训练新模型,并用独立测试集检查误差与目标物性。
“离已有数据远”表示模型描述符空间中的覆盖差异,不能保证构型稳定、标签正确或重新训练后一定提高精度。本例旧数据本来已有标签,仅用于把工具操作完整跑通,不构成新的独立模型测试。