
LAMMPS五种位置优化算法实操
CG、SD、HFTN、FIRE和quickmin的完整输入、停止条件及实际迭代数据。
阅读本篇目录
当你希望比较不同结构优化算法时,先用一个具有已知极小值的小模型熟悉输入、停止条件和结果读取,再把同样的操作迁移到自己的势函数和结构上。本例在鸢算科技集群实际完成5种位置优化算法,并对照GPU力计算与4种Kokkos最小化器。
1. 准备与提交#
下载完整输入、实际结果和绘图工具。在自己的工作目录解压并提交:
mkdir minimize-demo
cd minimize-demo
curl -fL https://yuansuan.top/assets/downloads/full-function/lammps-minimizers-wave87-c33bf9fded23.zip -o examples.zip
unzip examples.zip
sbatch submit.slurm
提交脚本申请1个P100和1个CPU核,顺序执行CPU、GPU和Kokkos对照,再生成CSV和图片。每次重新计算请使用新的解压目录,避免覆盖已有结果。直接调用 lmp 的命令在已分配的计算资源中执行。
使用 lammps/30Sep2026-p100-gpu 与 lammps/30Sep2026-p100-kokkos,GCC13.3、OpenMPI5.0.10、CUDA12.8;后处理使用 ase/3.29.0。这里比较数值结果,双原子小模型不适合评价GPU加速比。
2. 先看清楚优化什么#
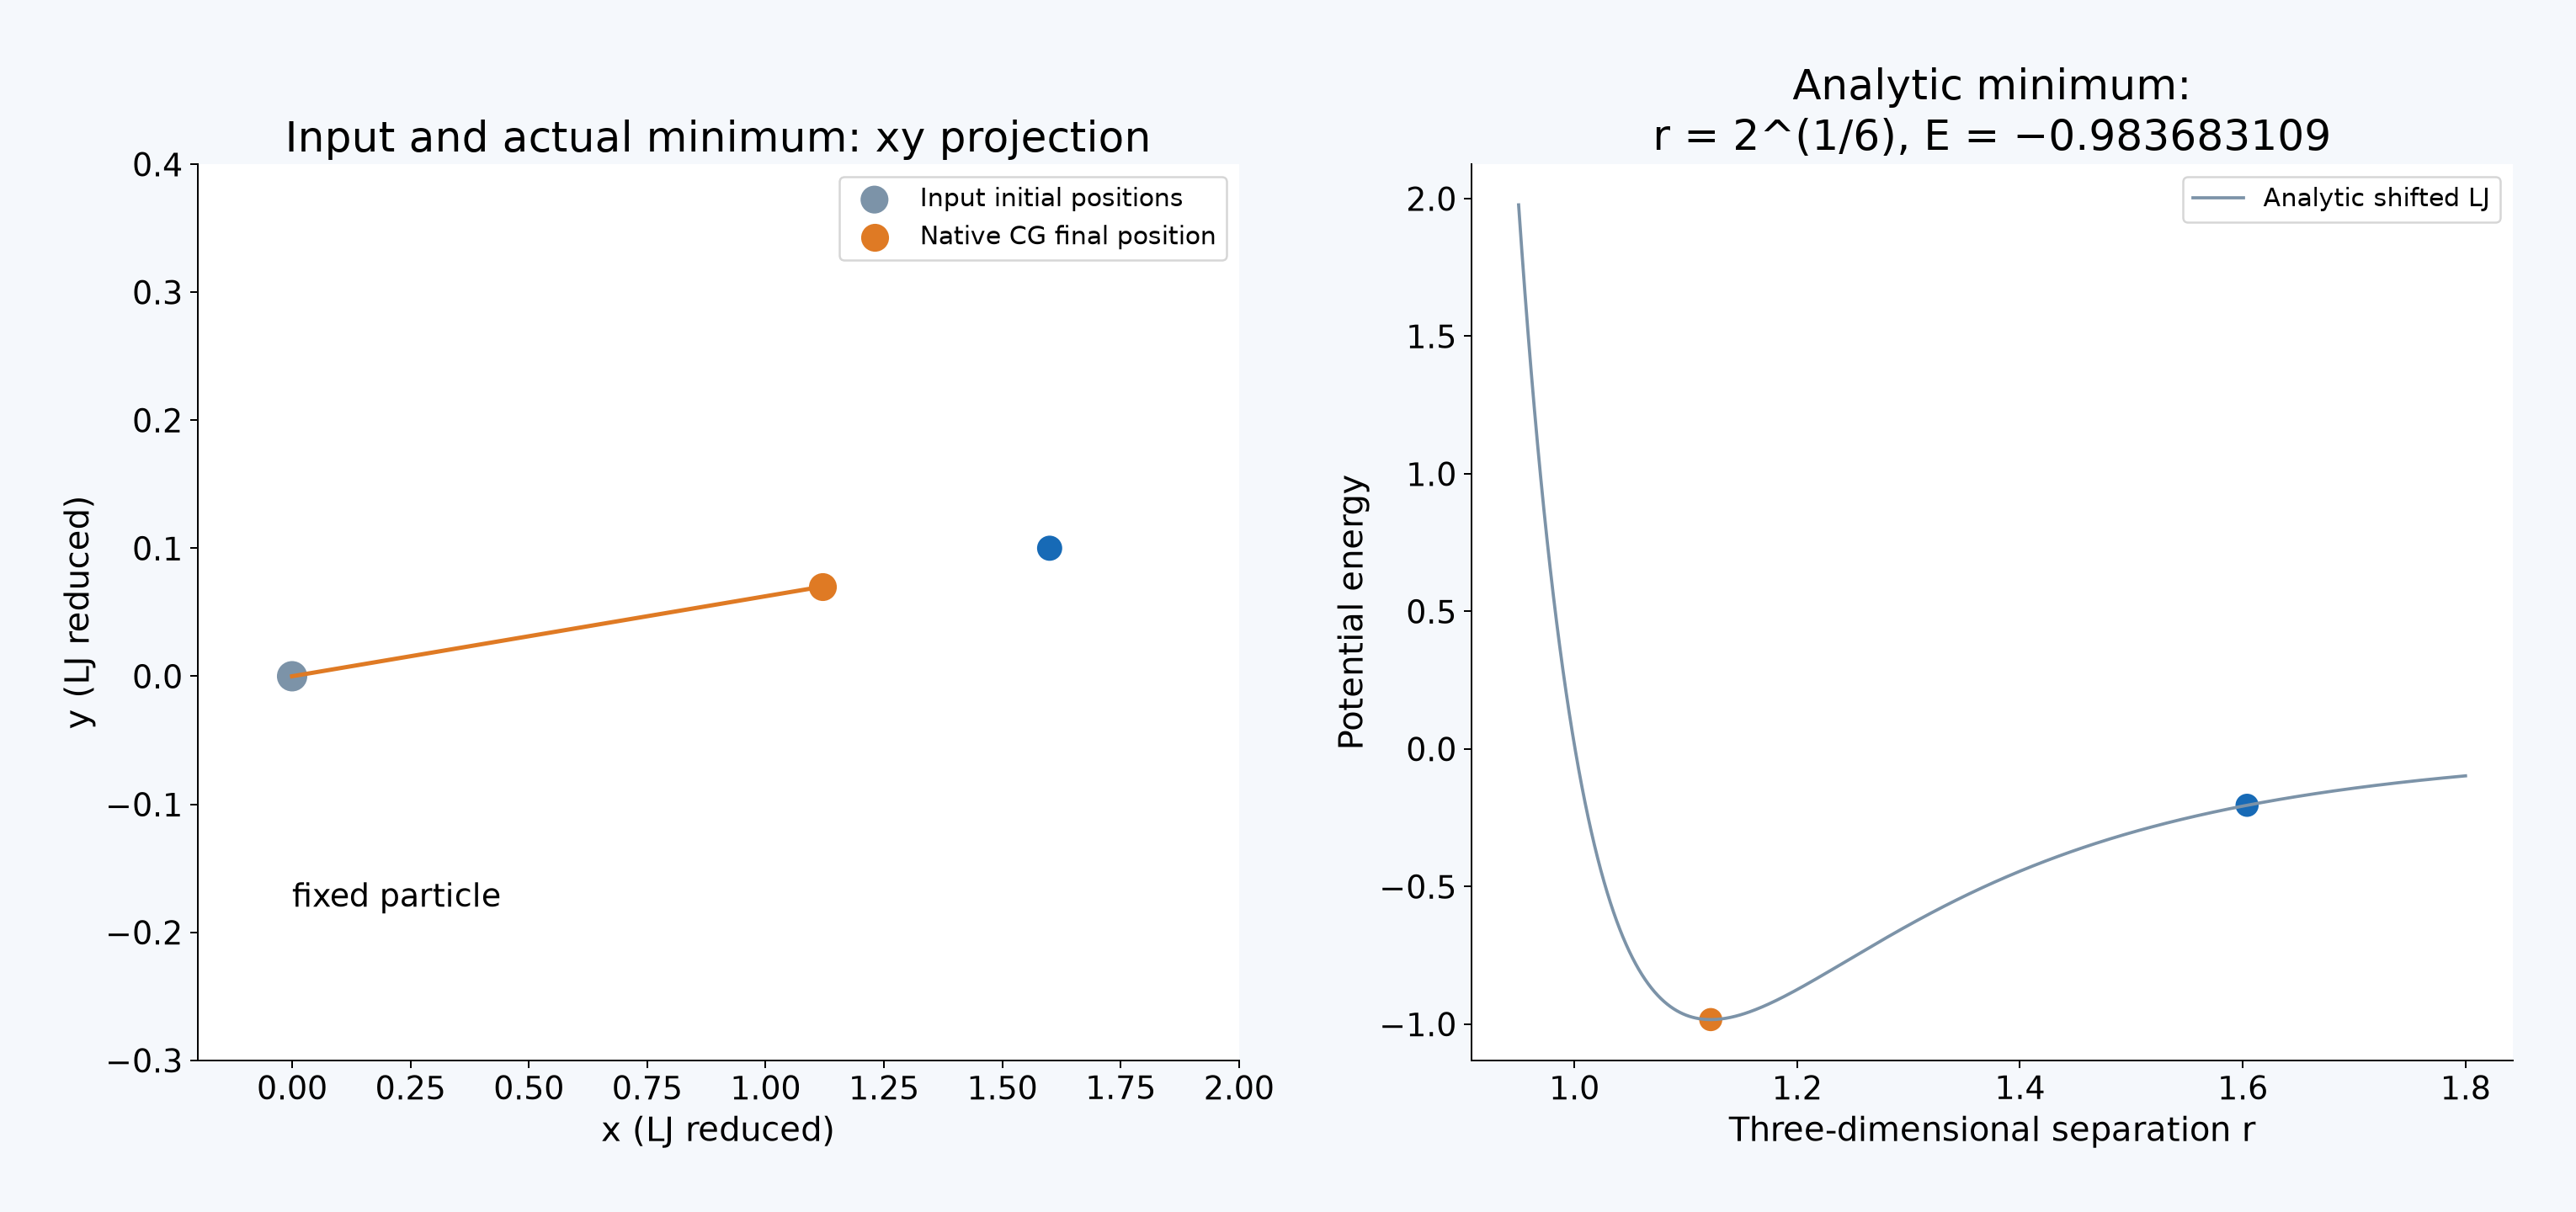
体系有两个LJ粒子:粒子1固定在原点,粒子2初始位于 (1.6, 0.1, 0.05)。只优化可动粒子的原子位置,盒子尺寸保持不变;不是晶胞优化。盒子为非周期边界,所有长度、能量、力和时间均采用LJ约化单位。
势能在截断半径2.5处平移为零。解析平衡距离为 2^(1/6)=1.122462048309373,对应能量 −0.983683108864。它是学习停止条件的参照,不代表某种真实材料的键长或结合能。
3. CG完整输入与关键参数#
文件 inputs/cg-cpu/in.lammps:
units lj
atom_style atomic
atom_modify map array sort 0 0.0
boundary f f f
region box block -5 5 -5 5 -5 5 units box
create_box 1 box
create_atoms 1 single 0 0 0 units box
create_atoms 1 single 1.6 .1 .05 units box
mass 1 1
pair_style lj/cut 2.5
pair_coeff * * 1.0 1.0
pair_modify shift yes
group anchor id 1
group mobile id 2
fix fixed anchor setforce 0 0 0
neighbor .3 bin
neigh_modify every 1 delay 0 check yes
thermo 10
thermo_style custom step pe fnorm fmax
thermo_modify norm no format float %.16g
timestep .01
min_style cg
min_modify dmax .1
minimize 0.0 1.0e-4 4000 20000
write_dump all custom constrained.dump id type x y z fx fy fz modify sort id format float %.16g
print "CONSTRAINED $(pe:%.16g) $(fnorm:%.16g) $(fmax:%.16g)" file constrained-energy.dat screen no
unfix fixed
run 0
write_dump all custom physical.dump id type x y z fx fy fz modify sort id format float %.16g
print "PHYSICAL $(pe:%.16g)" file physical-energy.dat screen no
minimize 0.0 1.0e-4 4000 20000 的四个值依次为相对能量变化阈值、力阈值、最大迭代次数和最大力/能量评估次数。这里 etol=0 禁用能量停止判据,重点观察 ftol=1e-4 的力停止条件;后两个数字只是预算,达到预算不代表已经收敛。
fix setforce 把固定粒子的力设为零,因此本例优化时的 fnorm 只剩可动粒子的贡献。不要直接把这个设置照搬到需要整体放松的晶体:先决定实际固定哪些原子,是否还需要晶胞优化。
min_modify dmax .1 限制适用算法的最大位移;HFTN不受 min_modify 参数影响。timestep .01 对FIRE/quickmin这类阻尼动力学最小化有实际意义,应根据体系势能曲率调整。
已有计算资源时,可以只跑CG:
module purge
module load lammps/30Sep2026-p100-gpu
cd inputs/cg-cpu
lmp -in in.lammps
cd ../..
4. 更换算法与实际结果#
五份CPU输入分别使用 min_style cg、sd、hftn、fire、quickmin。CG使用共轭梯度,SD使用最速下降,HFTN是无显式Hessian的截断Newton方法;FIRE和quickmin按阻尼动力学寻找极小值。
| 算法 | 实际迭代次数 | 最终粒子间距 | 可动原子力的模 |
|---|---|---|---|
| cg | 10 | 1.122462096040 | 2.72763e-06 |
| sd | 10 | 1.122462096040 | 2.72763e-06 |
| hftn | 5 | 1.122462048218 | 5.24281e-09 |
| fire | 65 | 1.122460346165 | 9.7273e-05 |
| quickmin | 139 | 1.122461320581 | 4.15874e-05 |
全部达到了本文的力目标。FIRE最后的力接近阈值,能量残差约8.28×10⁻¹¹;有限力容差允许非零能量残差。不要要求每种算法打印完全相同的最后一位,也不要把这张小模型表当成复杂体系的性能排序。
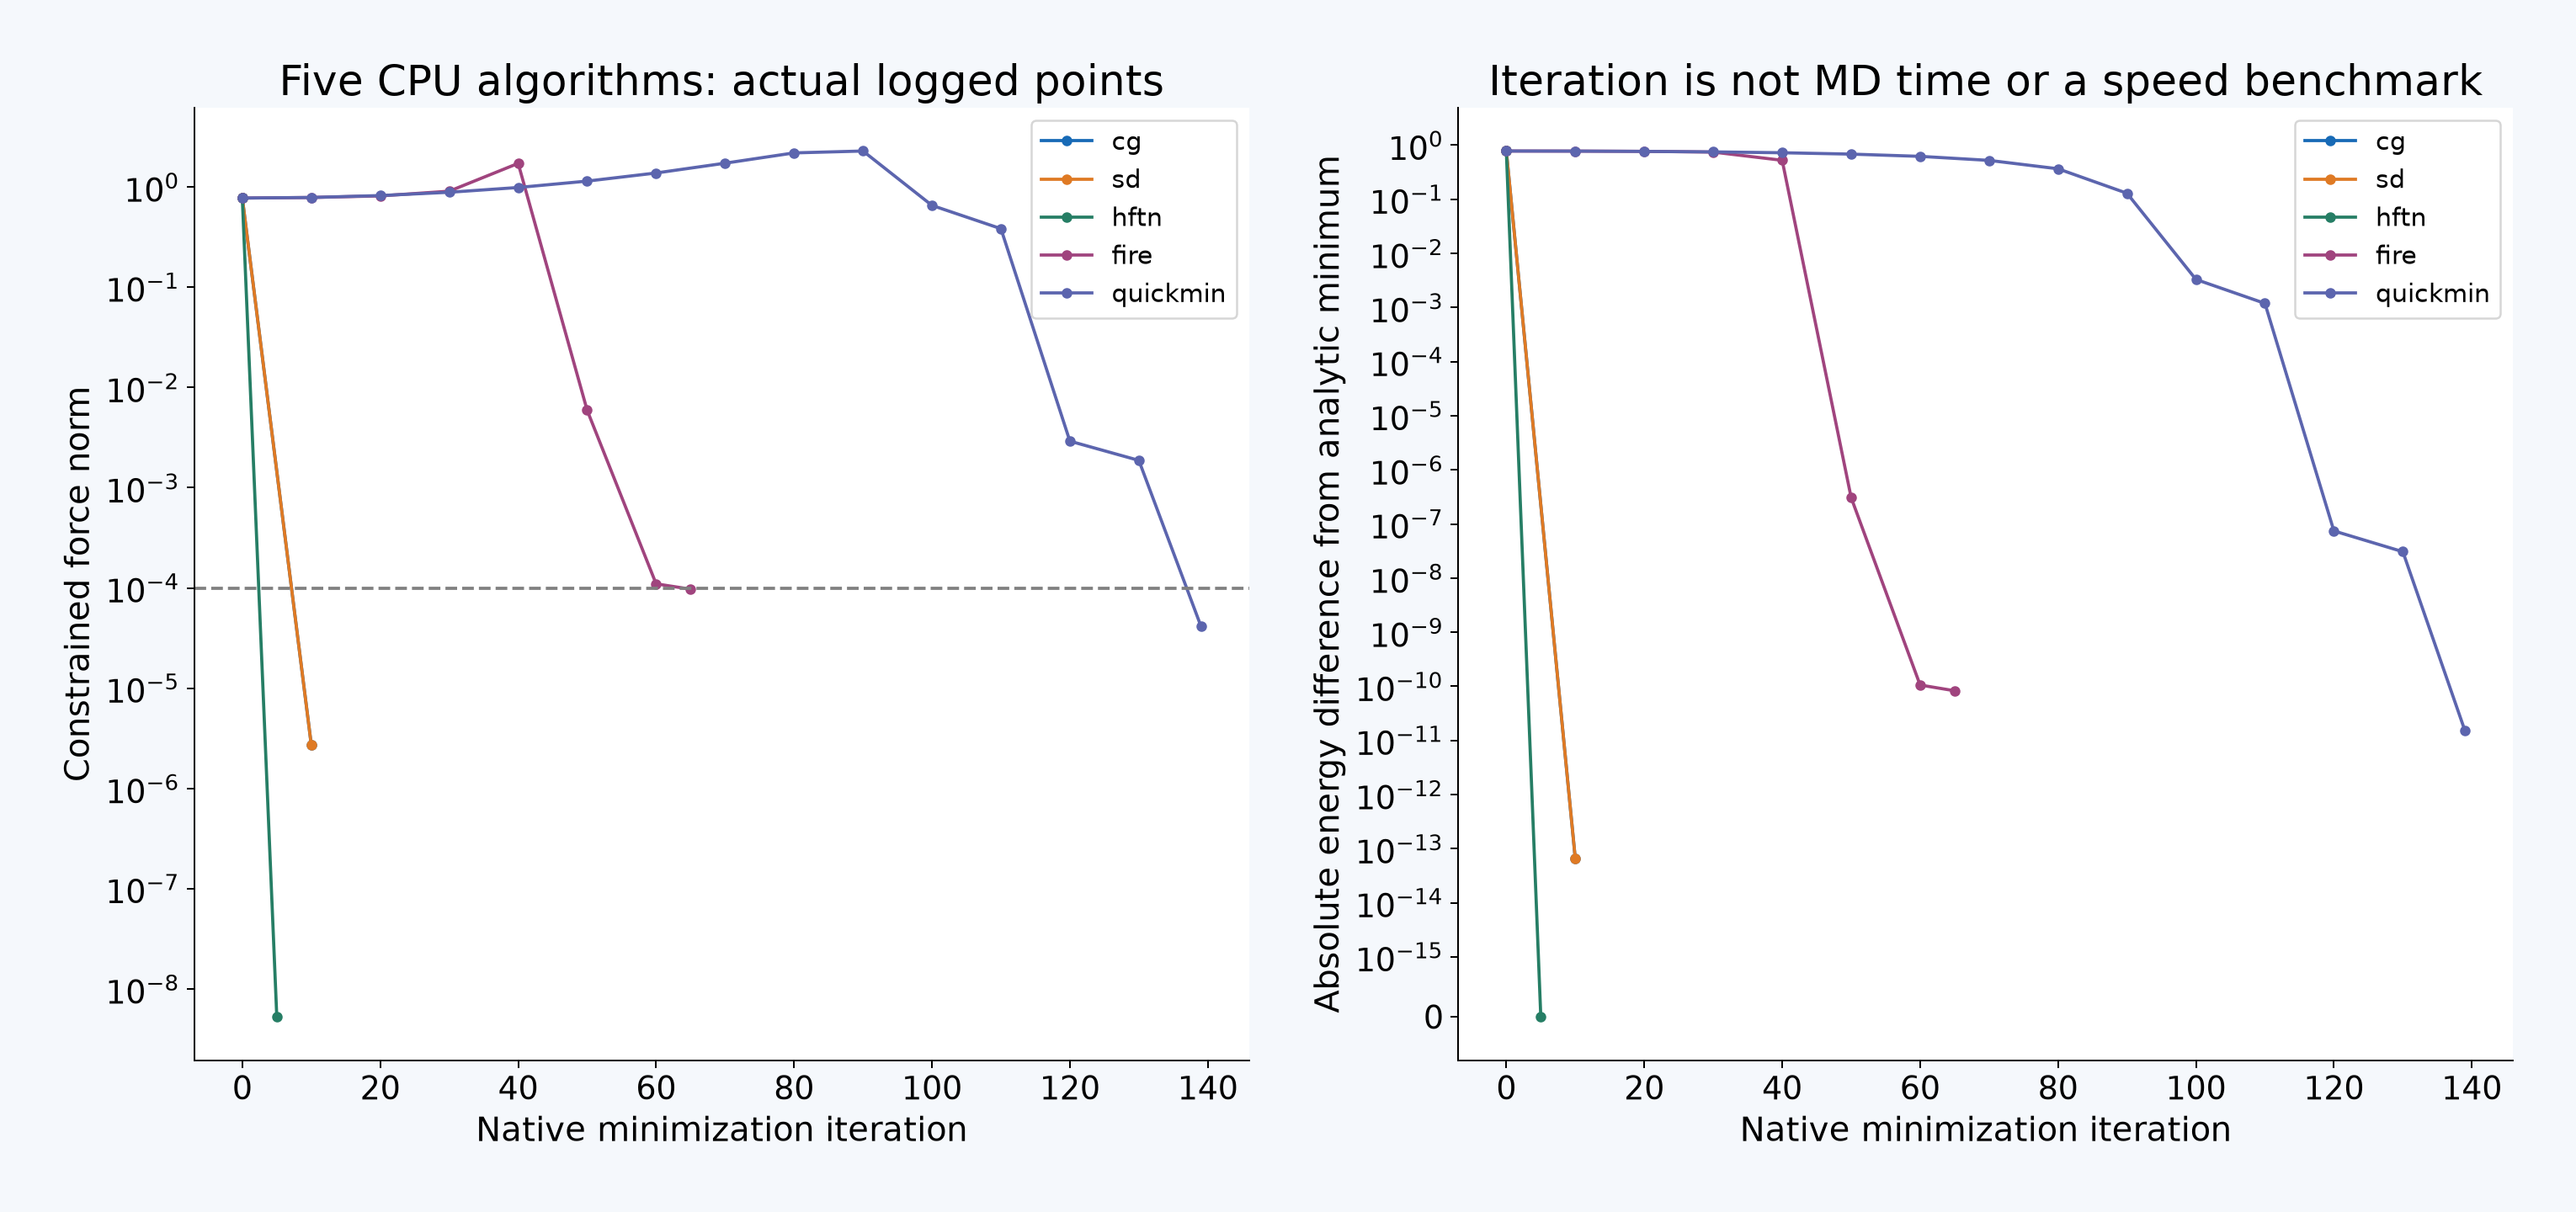
图中横轴是最小化迭代次数,不是MD时间;只连接实际打印的日志点,没有补造每一步的数据。
当前30Sep2026版本保留 fire/old 的名称提示,但该旧实现已移除,直接使用 min_style fire。spin、spin/cg、spin/lbfgs 用于自旋自由度,见自旋最小化与力矩,不与这里的位置优化混为一类。
5. 读取、转换与画图#
module purge
module load ase/3.29.0
python analyze.py work
python export_minima.py work
python plot_results.py work
python check_results.py work
work/cases/ 保存本次原始输出,work/analysis/ 保存表格,work/figures/ 保存高清图。包内 reference/ 是本文实算结果;未重算时,可以把上述命令中的 work 改为 reference 来重新分析和绘图。
python - <<'PYCODE'
import csv
with open('work/analysis/minimizers.csv') as f:
    for r in csv.DictReader(f):
        if r['backend'] == 'cpu':
            print(r['method'], r['radius'], r['constrained_mobile_force_norm'], r['stopping'])
PYCODE
export_minima.py 从实际 physical.dump 读取坐标和力,导出14个XYZ。粒子以X占位符标识,因为这是LJ约化粒子,不是真实元素;属性记录 fixed_in_minimization 与 lj_force,不能按Å和eV/Å直接解释。图形软件查看XYZ时也要注意它的默认单位。
更换真实模型时,优先核对势文件的元素顺序、初始重叠、固定区域、周期性及力单位,再比较算法。需要调整晶胞的过程见结构优化入门。GPU与Kokkos后缀见最小化的GPU/Kokkos操作。