
ABACUS 随机误差与确定性子空间
三个真实种子的能量散点与标准差,比较纯随机、混合方法及随机轨道数,不强行拟合收敛律。
阅读本篇目录
同一体系、同一输入参数,随机种子不同也可能给出不同结果。运行结束和SCF收敛,只说明这一组随机样本对应的电子问题已完成迭代,不代表随机统计误差消失。
1. 直接复现图表#
下载输入、真实结果、CSV与脚本,在附件根目录执行:
bash analyze.sh
这一步只处理参考数据,不启动DFT。重算全部条件使用sbatch submit.slurm,操作见上手流程。
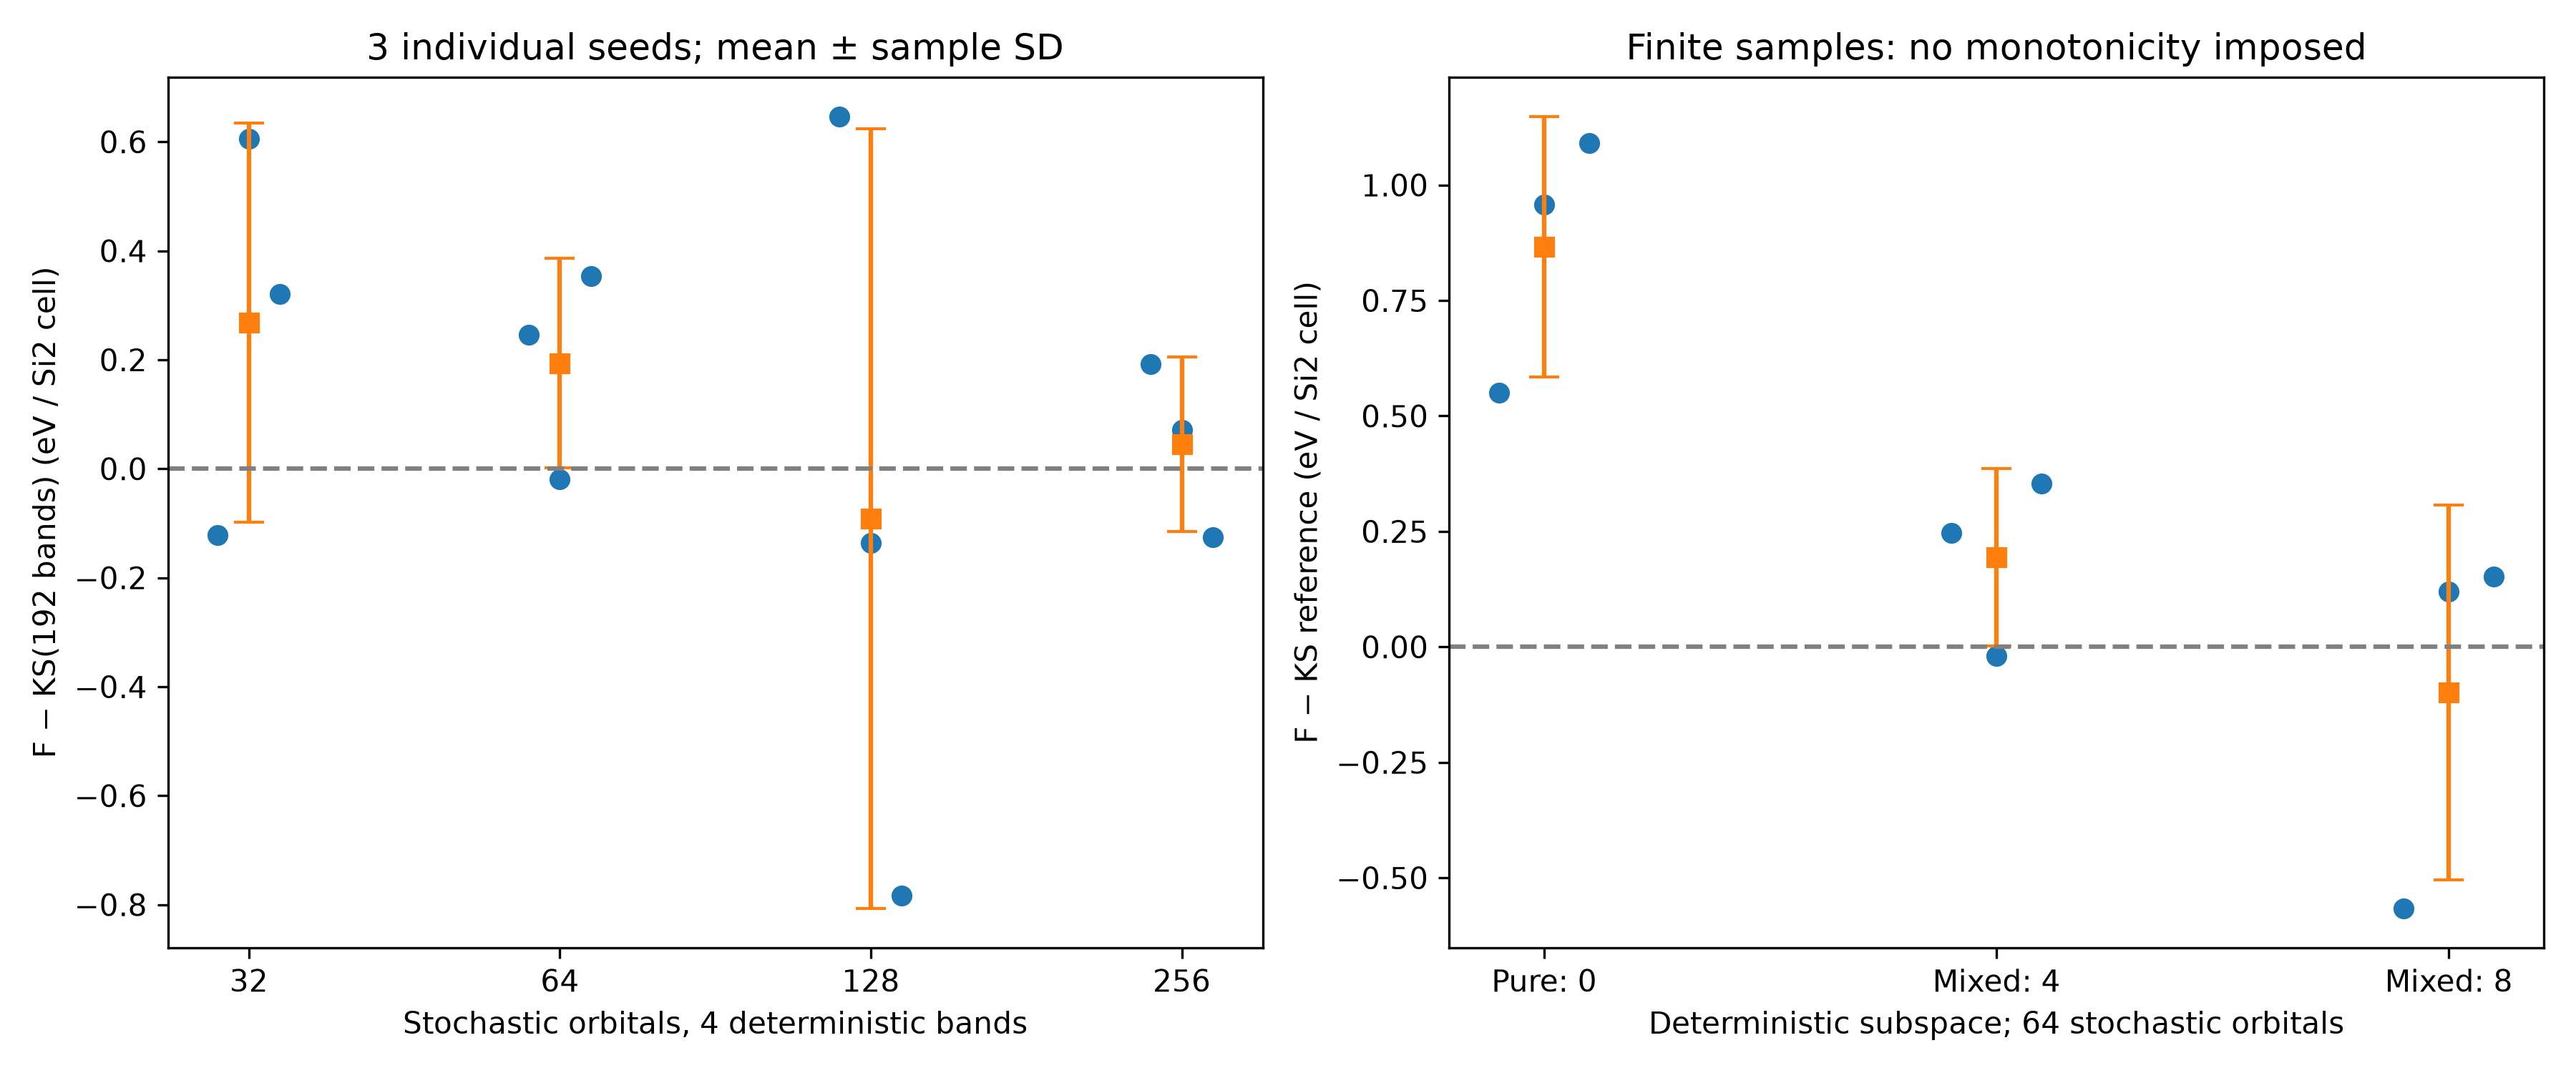
蓝点是种子11、22、33的原始值;橙色方点和误差线是三次均值与样本标准差,不是标准误,也不是经过拟合的曲线。纵轴是每个Si2晶胞相对192带KS参照的能量差。
2. 随机轨道数与确定性轨道数分别比较#
同样用100阶Chebyshev,实际结果为:
| 确定性轨道nbands | 随机轨道nbands_sto | 均值相对KS,eV/晶胞 | 样本标准差,eV/晶胞 |
|---|---|---|---|
| 0 | 64 | 0.865827 | 0.281724 |
| 4 | 32 | 0.268254 | 0.366655 |
| 4 | 64 | 0.193519 | 0.192310 |
| 4 | 128 | -0.091288 | 0.715496 |
| 4 | 256 | 0.045546 | 0.160202 |
| 8 | 64 | -0.098055 | 0.405722 |
四个确定性轨道的分支改变随机轨道数32、64、128、256;固定64个随机轨道时,另比较0、4、8个确定性轨道。所有种子结果都保留,没有为了得到平滑趋势删除某个点。
一般随机迹估计的误差会随样本规模减小,但三个种子不足以证明渐近误差律。本例128随机轨道组的三次样本标准差反而更大;8确定性轨道组也未在这三次样本中表现出单调改善。这些实际结果说明不能仅凭一个种子或很少重复就宣布“增加轨道一定更准确”。
3. 如何设置自己的对照#
在自己的完整工作副本中固定结构、电子温度、赝势、k网格、截断能和方法设置,再分别修改:
nbands 4
nbands_sto 64
nche_sto 100
seed_sto 11
另两份副本只将seed_sto改为22和33。原生种子为0时依赖时间,本例不使用这一默认方式。模型和数值精度还没控制住时,不要只靠增加随机种子掩盖系统误差。
本例所有条件使用相同固定几何与电子温度;比较不同结构的自由能差时,需要另外评估差值的统计误差和相关性,不能把本图的绝对能量标准差直接搬到任意材料反应上。
4. 取出每个种子的数字#
python - <<'PY'
import csv
with open('reference/analysis/conditions.csv') as f:
    for r in csv.DictReader(f):
        if r['kind'] == 'sdft' and r['nche_sto'] == '100':
            print(r['name'], r['F_eV'], r['error_vs_KS_eV'])
PY
sample_std_eV用ddof=1计算,脚本同时保存sem_eV=std/√3;两者含义不同,图中明确采用前者。当前只是用真实结果教会参数和统计流程,没有把三个种子当成充分采样的材料自由能研究。数值系统误差另看能带与Chebyshev控制。