
GROMACS GPU分配与MPI布局实操
同一水盒实测thread-MPI、OpenMP、真实MPI双卡/四卡和独立PME秩,理解可复现性与日志映射。
阅读本篇目录
先选择足够的任务资源,再选择 GROMACS 的并行布局。申请了四张 GPU,不代表程序自动合理使用四张;MPI 秩、PP/PME 分工和线程数都要从实际日志确认。
1. 本例实际运行了哪些布局#
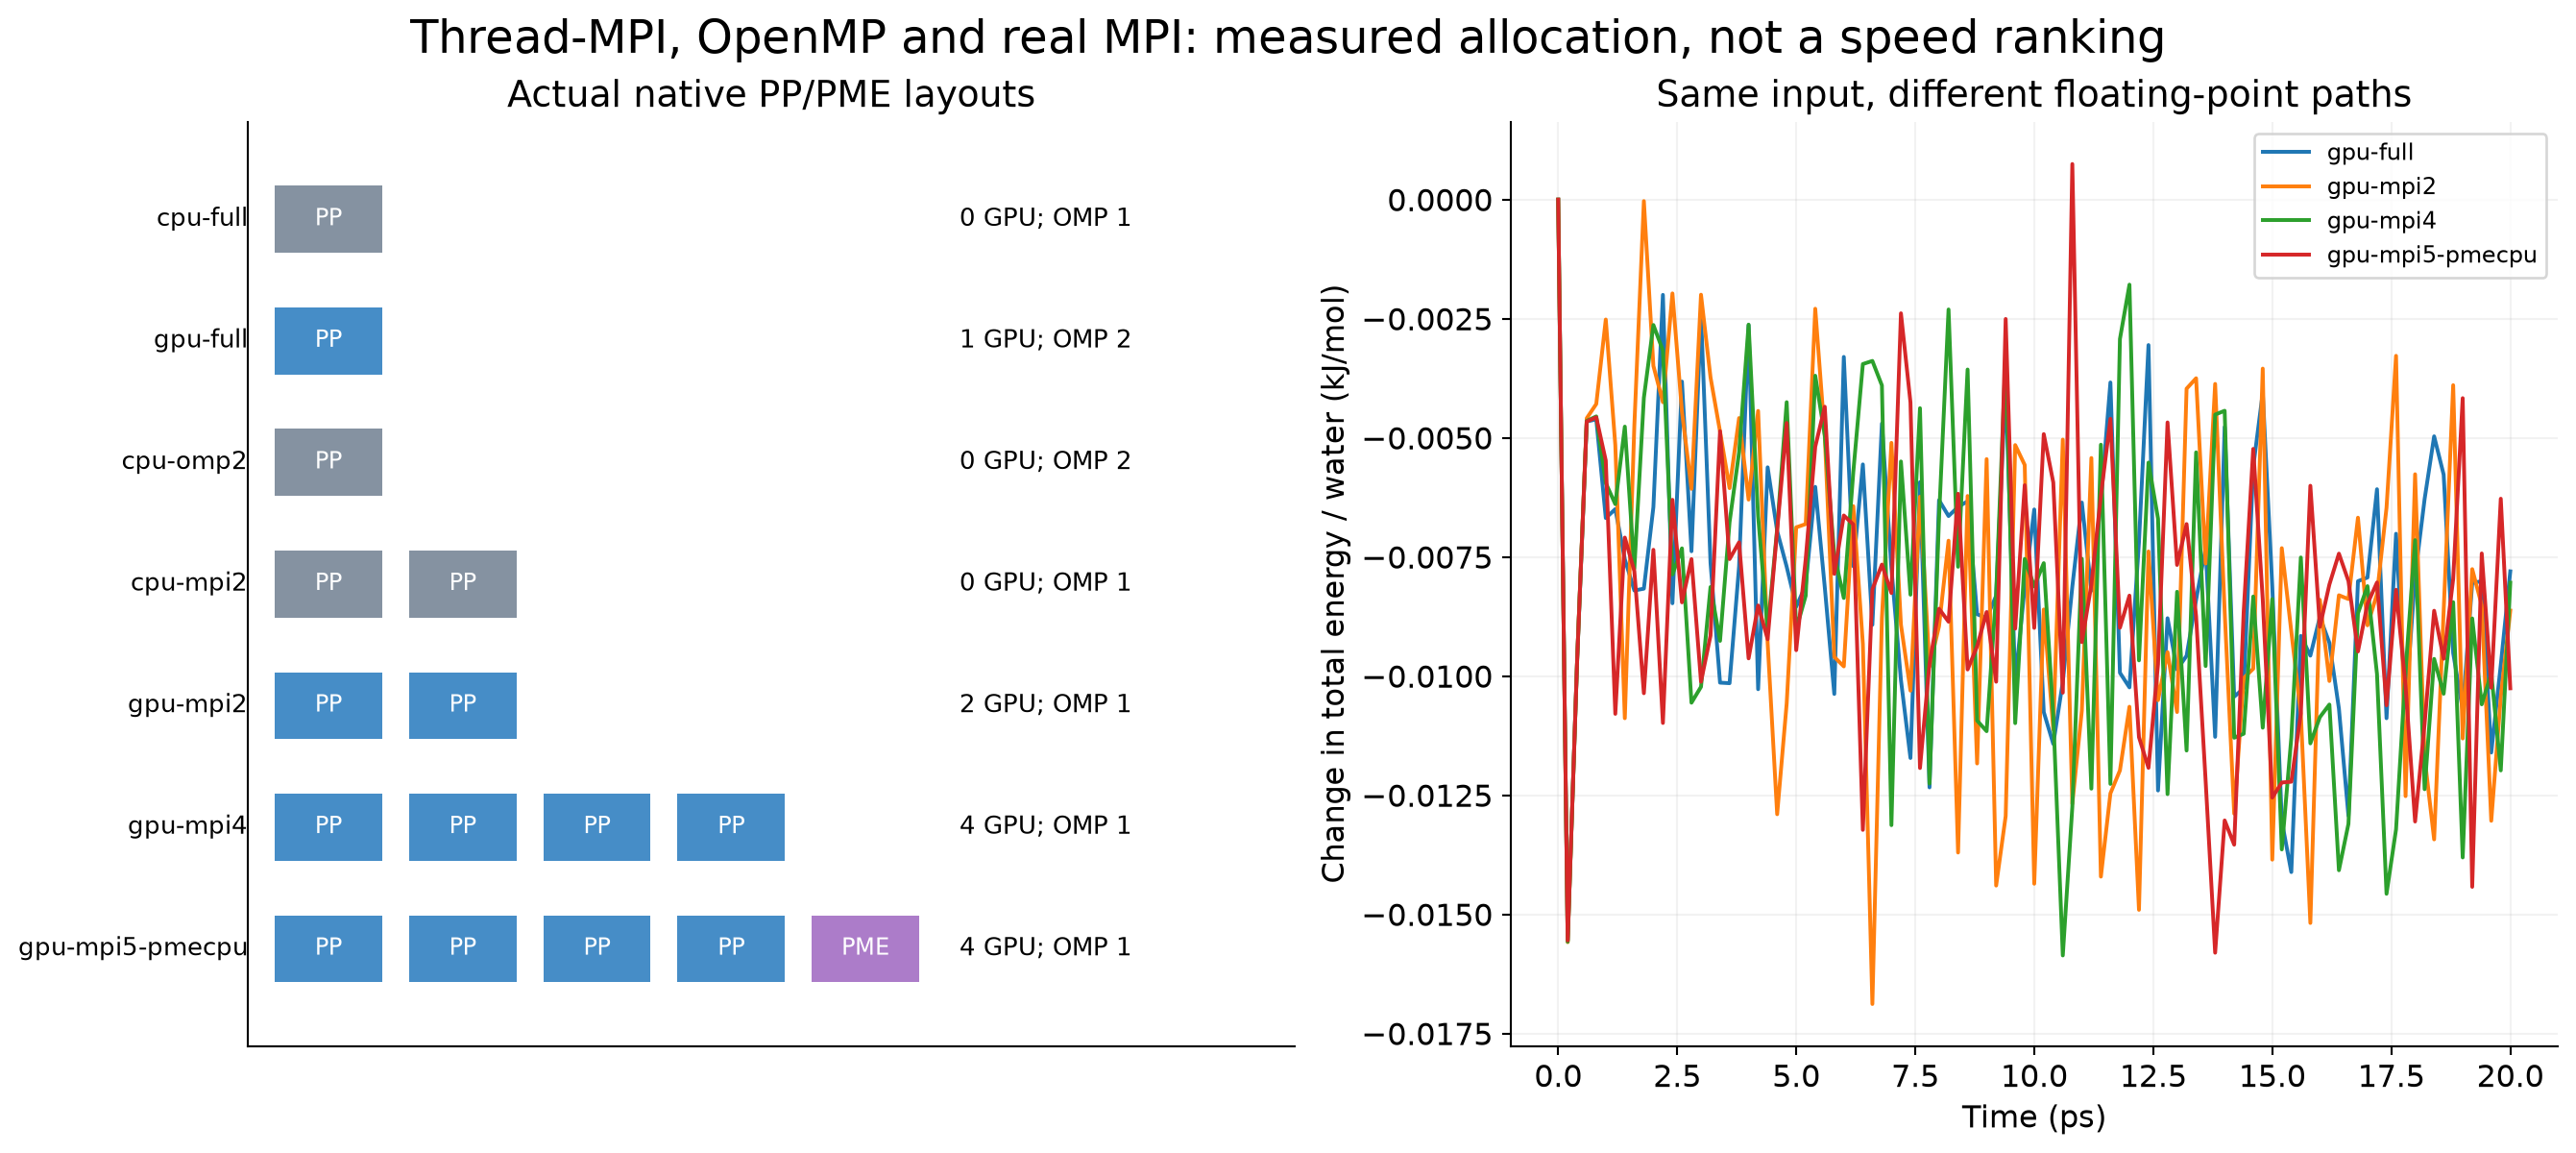
所有分支从同一个生产 TPR 开始,使用同一 510 分子 SPC/E 水盒与 20 ps NVE 设置。
| 实例 | MPI/线程MPI秩 | 每秩OMP线程 | GPU | 独立PME秩 |
|---|---|---|---|---|
cpu-full |
1 | 1 | 0 | 0 |
cpu-omp2 |
1 | 2 | 0 | 0 |
cpu-mpi2 |
2(真实MPI) | 1 | 0 | 0 |
gpu-full |
1 | 2 | 1 | 0 |
gpu-mpi2 |
2(真实MPI) | 1 | 2 | 0 |
gpu-mpi4 |
4(真实MPI) | 1 | 4 | 0 |
gpu-mpi5-pmecpu |
5(真实MPI) | 1 | 4 | 1(CPU) |
这张表表示本次实际分工,不是速度排名。小水盒通信/启动占比高,不能据此得出某种 GPU 数量最划算的通用结论。
2. 单卡:thread-MPI版本#
正常申请一张 P100 GPU、两个 CPU 核后,在任务环境里加载:
module purge
module load gromacs/2026.4-p100-threadmpi
gmx mdrun -s common/full.tpr -deffnm one-gpu \
  -ntmpi 1 -ntomp 2 -nb gpu -pme gpu \
  -bonded cpu -update cpu -pin off -notunepme
此例短程非键和 PME 在同一张 GPU,更新/约束和键合路径留在 CPU。它并非“所有部分都在 GPU 上”。下载包中已准备好的同类命令是 bash run.sh gpu-full。
不要在用户作业里照抄机器物理 GPU 编号覆盖 CUDA_VISIBLE_DEVICES;沿用调度器分配的可见 GPU。日志里的相对编号与物理卡编号不是一回事。
3. 双卡和四卡:真实MPI版本#
双卡申请两秩、每秩一个 CPU 核、两张 GPU:
module purge
module load gromacs/2026.4-p100-mpi-plumed
mpirun --bind-to none -np 2 gmx_mpi mdrun \
  -s common/full.tpr -deffnm two-gpu -ntomp 1 \
  -nb gpu -pme cpu -npme 0 -bonded cpu -update cpu \
  -pin off -notunepme
这里真实 MPI 的进程数由 mpirun -np 指定,不加 -ntmpi。-npme 0 表示没有独立 PME 秩,PME 工作由这些秩中的 CPU 路径完成,不表示不计算 PME。实际双卡映射为 PP:0, PP:1。
四卡对应申请四秩/四张 GPU,将 -np 2 改成 -np 4。下载包短命令分别为:
bash run.sh gpu-mpi2
bash run.sh gpu-mpi4
这些命令只在已经获得对应资源的任务中执行;不能仅在单卡作业里把 -np 改大。
4. 四个PP秩+一个独立CPU PME秩#
申请五秩、四张 GPU;核心布局如下:
mpirun --bind-to none -np 5 gmx_mpi mdrun \
  -s common/full.tpr -deffnm dedicated-pme -ntomp 1 \
  -nb gpu -pme cpu -npme 1 -bonded cpu -update cpu \
  -pin off -notunepme
实际日志映射:
Mapping of GPU IDs to the 4 GPU tasks in the 5 ranks on this node:
  PP:0,PP:1,PP:2,PP:3,none
四个 PP 秩各使用一张 GPU,最后一个 PME 秩在 CPU 上,因此第五个秩没有 GPU 任务。四张卡加一个独立 PME 秩是五个总秩;不要写成四个总秩再期待仍有四个 PP 秩。
grep -E 'MPI|OpenMP|Mapping|PP:|PME|selected for this run' \
  work/gpu-mpi5-pmecpu/md.log
gmx dump -cp work/gpu-mpi5-pmecpu/md.cpt | head -35
区域分解会受盒子尺寸、截断、约束和负载影响。更复杂体系不一定接受同一种分解;本篇没有测跨节点 MPI、GPU PME 多秩分解、所有直接通信分支或通用最优性能参数。
5. 可复现应该怎样比较#
cpu-full、cpu-omp2、cpu-mpi2 使用 -reprod 固定可控制的数值路径,但改变线程/秩数仍会改变浮点加法顺序。本次同样 CPU 单线程条件的连续与续算逐帧完全一致;GPU 单卡连续与续算、跨另一台 P100 的续算均保留检查点初始状态,但后面轨迹逐步分开。
检查点衔接、模型正确、几何和统计量合理,比要求两条 GPU 轨迹完全重叠更有意义。短短 20 ps 也不足以证明不同布局的热力学统计等价;本篇只展示实际状态衔接和分工。输出里的运行速度可供检查任务是否工作,不作为正式性能榜单。
6. 一键生成自己的作业文件#
bash submit.sh
jobs/*.slurm 中逐任务写有申请参数,父子任务通过 Slurm 依赖衔接。只想先看脚本、不提交,可在另一个新解压目录执行:
bash submit.sh --dry-run
jobs 已存在时脚本会停止,避免把一套作业重复提交。参考包的实际计算通过已分配的计算节点资源执行;随包 Slurm 模板提供正常使用入口。
下载完整输入、实际检查点/轨迹、CSV和绘图脚本。资料包是本专题自己的 510 分子 SPC/E 水盒;与旧篇 884 分子 TIP3P 水盒不是同一个体系,不要互相混用 TPR、CPT 或拓扑。
解压进入资料包目录,先查看已经完成的结果:
bash analyze.sh
参考图片在 reference/figures,数据表在 reference/analysis。需要重新计算整套实例时,在新解压目录执行:
bash submit.sh
squeue -u "$USER"
脚本生成独立作业文件:先建模/平衡,再运行连续段和种子段;续算依赖相应种子作业成功,最后处理 work 目录。每个任务按实际秩数、线程数和 GPU 数申请资源;CPU 路径对照也申请 P100 任务资源,只让该任务的 CPU 核计算。没有覆盖既有工作目录的选项。单独复跑某个例子前,先确保前置任务已完成,且已通过调度分配足够资源。
环境为 GROMACS 2026.4,GNU 13.3、FFTW 3.3.10、CUDA 12.8,混合精度。单进程/线程版本使用 gromacs/2026.4-p100-threadmpi;真实 MPI 版本使用 gromacs/2026.4-p100-mpi-plumed,Open MPI 5.0.10,支持 GPU-aware MPI。本专题没有施加 PLUMED 偏置。CPU 路径结果由 P100 计算节点的 CPU 核获得,不是 Intel Xeon 8173M 性能测量。