
GROMACS 蛋白约束与双精度实操
以实际1UBQ水溶液比较LINCS阶数、SHAKE容差、1/2fs和双精度,提供完整MDP和几何误差图。
阅读本篇目录
遇到约束误差时,先分清它来自哪些原子、步长和数值精度,再选择求解器或精度。本篇使用真实 1UBQ 蛋白水溶液,比较 LINCS、SHAKE、1/2 fs 与双精度;不是把水的 SETTLE 误差当作蛋白约束误差。
1. 体系与前置文件#
输入来自本专题已有的 蛋白水溶液流程,AMBER99SB-ILDN 蛋白力场和 TIP3P 水:76 残基、1231 个蛋白原子、8487 个水分子及 25 对 Na/Cl,共 26742 个原子。下载包直接提供配套的已平衡坐标、检查点、拓扑和原始蛋白 PDB。
生产比较使用定容 NVT、300 K、v-rescale,各运行 5 ps;不能用这段短轨迹报告蛋白构象稳定性或平衡热力学性质。
ls inputs/protein
head -2 inputs/protein/start.gro
bash run.sh protein-lincs4
若从 PDB 重新运行 pdb2gmx、重加氢或重新溶剂化,原子数和顺序可能改变。此时不能沿用本包的旧 CPT,而应按建模流程重新最小化和平衡。
2. LINCS 与 SETTLE 各自处理什么#
本例 constraints=h-bonds 将蛋白的 X–H 键约束,实际共有 629 对;水模型本身的刚性几何由 SETTLE 处理。把 constraint-algorithm=lincs 换成 shake,不表示所有水也改由 SHAKE 求解。
完整混合精度 LINCS、2 fs 输入
integrator = md
dt = .002
nsteps = 2500
continuation = yes
tcoupl = v-rescale
pcoupl = no
gen-vel = no
comm-mode = Linear
nstcomm = 100
nstenergy = 100
nstcalcenergy = 100
nstlog = 1000
nstxout = 100
nstvout = 100
nstfout = 0
nstxout-compressed = 100
compressed-x-precision = 1000
cutoff-scheme = Verlet
nstlist = 20
verlet-buffer-tolerance = -1
rlist = 1.2
coulombtype = PME
rcoulomb = 1.0
vdwtype = Cut-off
vdw-modifier = Potential-shift
rvdw = 1.0
DispCorr = no
fourierspacing = .12
pme-order = 4
pbc = xyz
constraints = h-bonds
constraint-algorithm = lincs
lincs-order = 4
lincs-iter = 1
tc-grps = System
tau-t = .5
ref-t = 300
ld-seed = 2612205
shake-tol = 1e-4
在已分配的任务中运行三个对照:
bash run.sh protein-lincs4
bash run.sh protein-lincs6
bash run.sh protein-lincs4-1fs
前两组只改变 lincs-order;第三组将步长改为 1 fs,并相应增加步数以保持 5 ps。脚本固定一个 MPI 线程、两个 OMP 线程,非键与 PME 在 GPU,更新/约束在 CPU。
3. SHAKE:标准容差与更严格精度#
bash run.sh protein-shake4
bash run.sh protein-shake6-double
第一组采用混合精度、shake-tol=1e-4。第二组用 CPU 双精度 gmx_d 和 shake-tol=1e-6;run.sh 根据名称选择模块。它不是 GPU 加速分支,也不是把同一个二进制程序多开几位输出小数。
完整双精度紧容差输入
integrator = md
dt = .002
nsteps = 2500
continuation = yes
tcoupl = v-rescale
pcoupl = no
gen-vel = no
comm-mode = Linear
nstcomm = 100
nstenergy = 100
nstcalcenergy = 100
nstlog = 1000
nstxout = 100
nstvout = 100
nstfout = 0
nstxout-compressed = 100
compressed-x-precision = 1000
cutoff-scheme = Verlet
nstlist = 20
verlet-buffer-tolerance = -1
rlist = 1.2
coulombtype = PME
rcoulomb = 1.0
vdwtype = Cut-off
vdw-modifier = Potential-shift
rvdw = 1.0
DispCorr = no
fourierspacing = .12
pme-order = 4
pbc = xyz
constraints = h-bonds
constraint-algorithm = shake
lincs-order = 4
lincs-iter = 1
tc-grps = System
tau-t = .5
ref-t = 300
ld-seed = 2612205
shake-tol = 1e-6
手动运行双精度分支时,相应命令为:
module purge
module load gromacs/2026.4-cpu-double
gmx_d grompp -f md.mdp -c start.gro -t start.cpt \
  -p topol.top -o md.tpr
gmx_d mdrun -deffnm md -ntmpi 1 -ntomp 2 \
  -nb cpu -pme cpu -bonded cpu -update cpu -pin off -notunepme
极紧容差不适合盲目用于混合精度:坐标可表示精度会限制约束迭代。本例 1e-6 的严格对照采用双精度,不把“容差越小越好”当作统一建议。
4. 用真实键长检查,别只看程序结束#
脚本读取原生 TPR 中的 629 个蛋白约束对及目标键长,按周期边界计算 TRR 中的实际距离,再计算 |d−d0|/d0;SETTLE 的水约束另行记录。表中排除起点帧,比较推进后的结果:
| 分支 | 步长fs | 计算路径 | 后续帧最大蛋白约束相对误差 |
|---|---|---|---|
protein-lincs4 |
2 | GPU非键/PME+CPU约束,混合精度 | 3.214e-05 |
protein-lincs6 |
2 | GPU非键/PME+CPU约束,混合精度 | 3.293e-05 |
protein-lincs4-1fs |
1 | GPU非键/PME+CPU约束,混合精度 | 6.753e-06 |
protein-shake4 |
2 | GPU非键/PME+CPU约束,混合精度 | 9.997e-05 |
protein-shake6-double |
2 | CPU双精度 | 9.984e-07 |
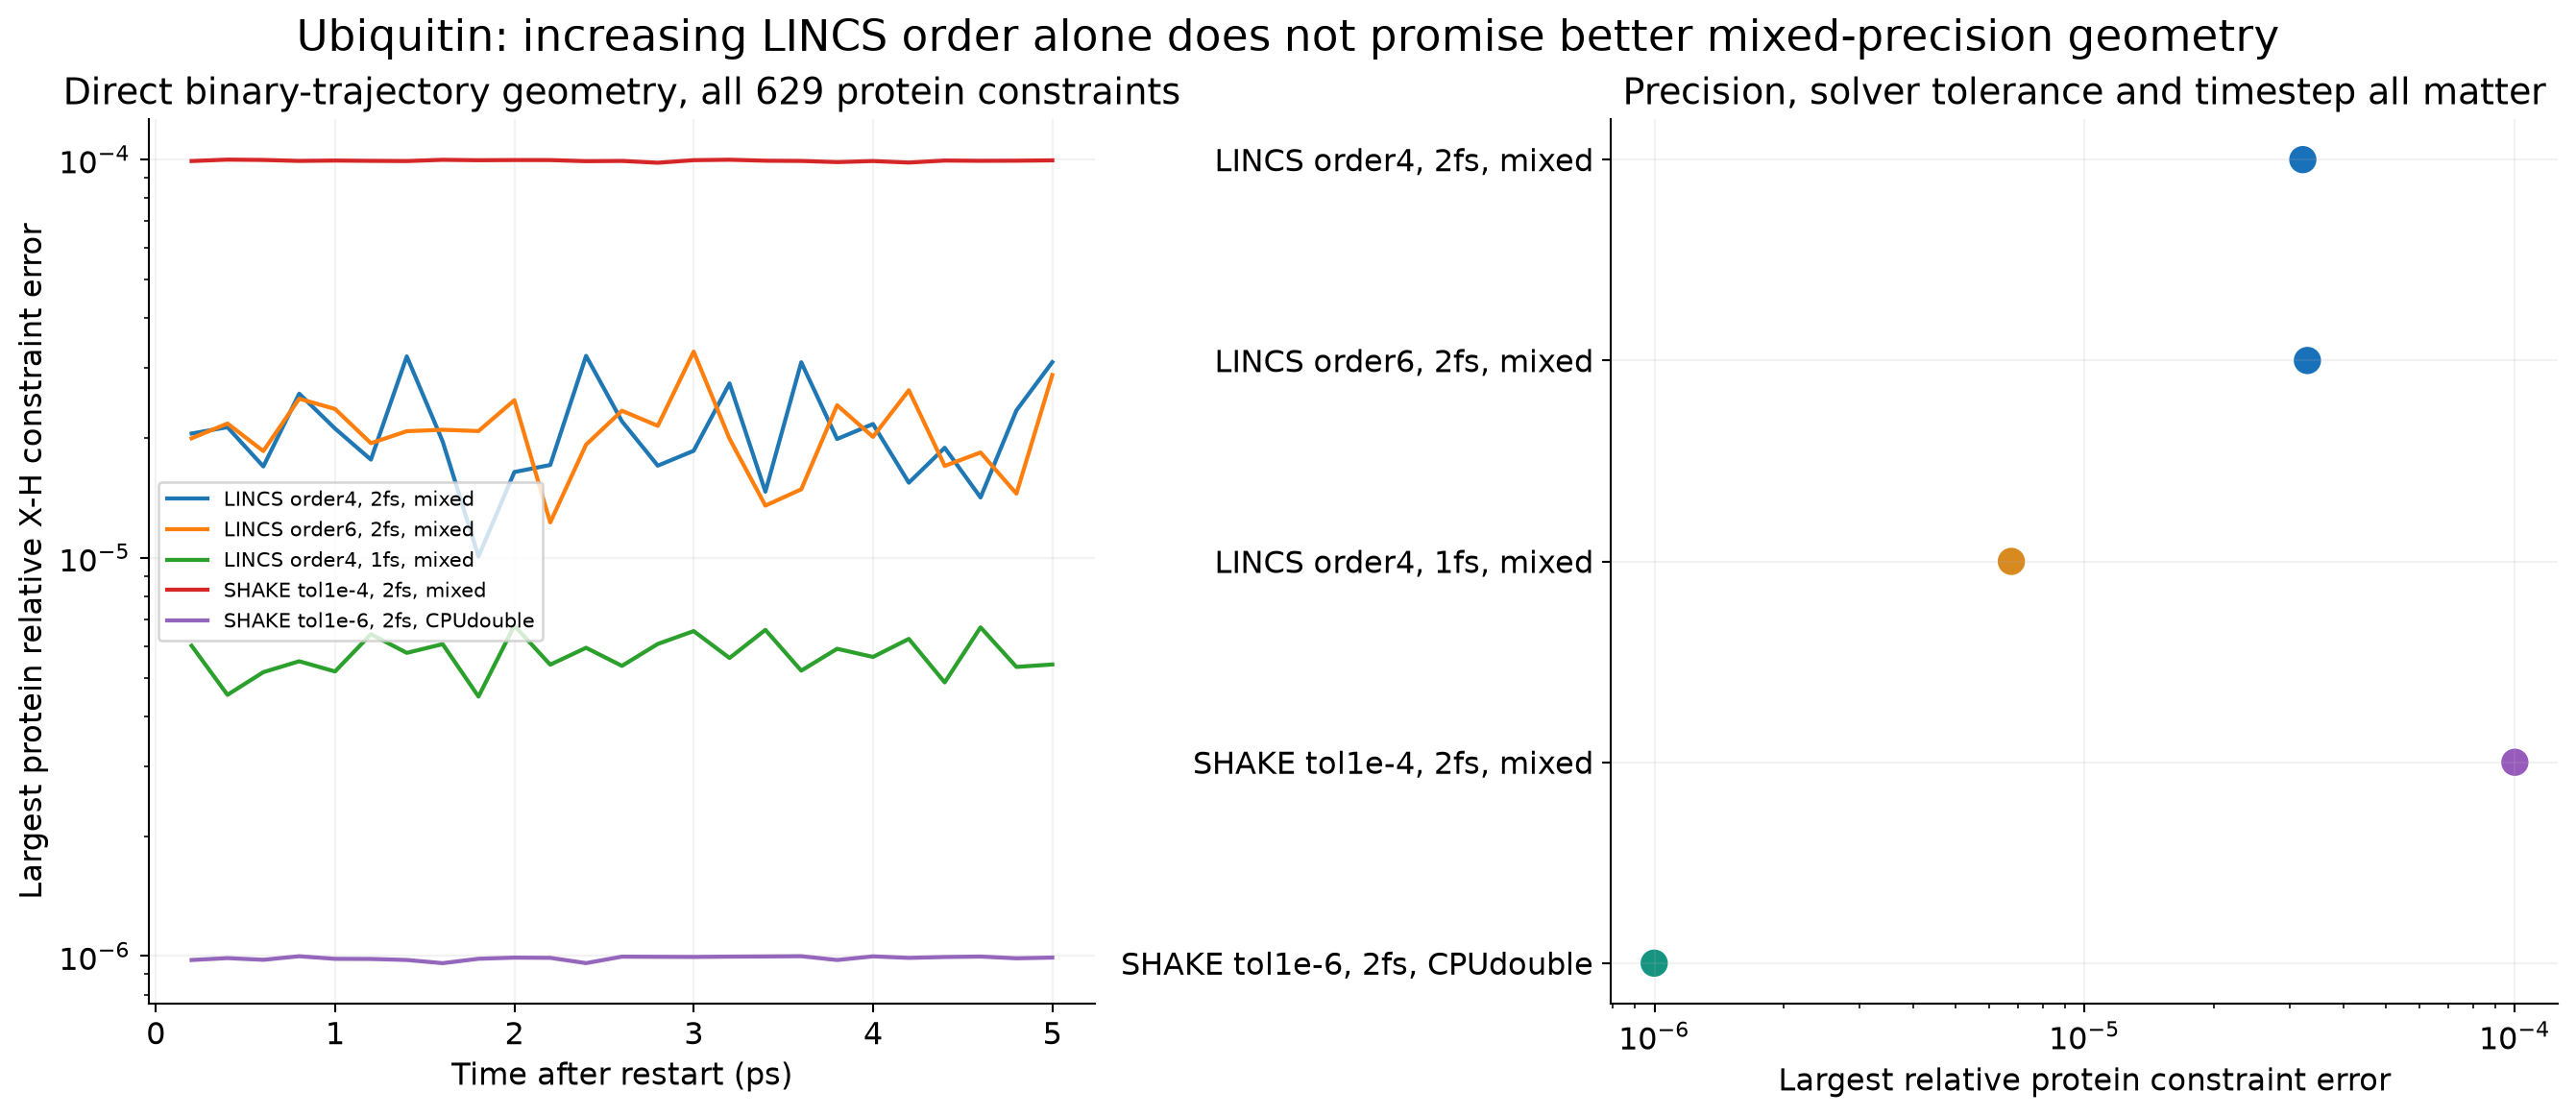
这次把 LINCS 阶数从 4 提至 6,并没有改善混合精度的最大几何误差;将步长减到 1 fs 则得到更小误差。双精度 SHAKE 严格分支的相对误差接近所设 1e-6 容差。不同分支的积分、求解器、容差或精度有所变化,这些数据不用于单独给某一项参数或硬件作通用性能排名。
5. 日常查看哪些输出#
grep -E 'constraint-algorithm|lincs-order|shake-tol' \
  reference/protein-lincs4/md.mdp
grep -Ei 'LINCS WARNING|Shake did not converge|settled|Finished mdrun' \
  reference/protein-lincs4/md.log
bash analyze.sh
同时关注能量、温度、异常接触和几何,不要只看退出码。若出现约束异常,先检查结构、参数、步长及求解器适用范围,处理后从合适状态重新开始;不要仅靠忽略提示继续积累轨迹。
官方入口:LINCS、SHAKE 与约束输入。
下载与重新运行#
下载完整输入、实际结果、MDP、CSV和五张图的绘图脚本。本包直接提供已经平衡的 510 分子 SPC/E 水盒和 1UBQ 蛋白水溶液输入;柔性水分支另有 10 ps 准备阶段。先查看现成数据:
bash analyze.sh
结果在 reference/analysis,图片在 reference/figures。在新解压目录提交整套新计算:
bash submit.sh
squeue -u "$USER"
作业使用实际分区 gpu-8p100-hs,每组申请一张 P100 和两个 CPU 核;双精度对照使用该任务的 CPU 核计算,不使用 GPU 力计算。22 个任务脚本包括一个柔性水准备任务、20 个生产条件和一个后处理任务,依赖关系已写好。需要先看脚本而不提交时,在另一个新解压目录用 bash submit.sh --dry-run。jobs、work 已存在时不重复提交整套任务。
正文中的单条 bash run.sh ... 只在已经分配到对应资源的任务中执行,不在登录/管理节点运行 MD。输入、拓扑、检查点和力场要配套;不要拿重新建模后的拓扑继续读取旧检查点。
混合精度 GPU 路径使用 gromacs/2026.4-p100-threadmpi:GROMACS 2026.4、GNU13.3、CUDA12.8、FFTW3.3.10、thread-MPI/OpenMP。双精度路径使用 gromacs/2026.4-cpu-double,命令 gmx_d,固定 v2026.4 源码构建,程序标记 2026.4-dev,CPU-only、GNU13.3、AVX2、FFTPACK。不是 Intel Xeon 8173M 的性能数据。
提取使用 gmx_d,绘图用 NumPy/Matplotlib;结构与轨迹也通过 MDAnalysis 核对。脚本保留双精度 TRR 的实际精度,避免把双精度坐标先缩成 float32 再判断极紧约束误差。参考数据均为真实计算,但 20 ps 水与 5 ps 蛋白仅用于学会操作,不作为收敛热力学、扩散或性能结论。