
GPUMD 系综与控温实操
Cu与Ar真实准备、六种常规NVT、耦合参数、温度涨落和升温流程。
阅读本篇目录
用GPUMD时,先区分准备结构、控制温度、控制压力和生产采样。并不是给 ensemble 换个名字,所得轨迹就能用于同一种统计分析。本篇用256原子Cu和256原子Ar流体实例,给出完整运行顺序。
1. 先准备共同起点#
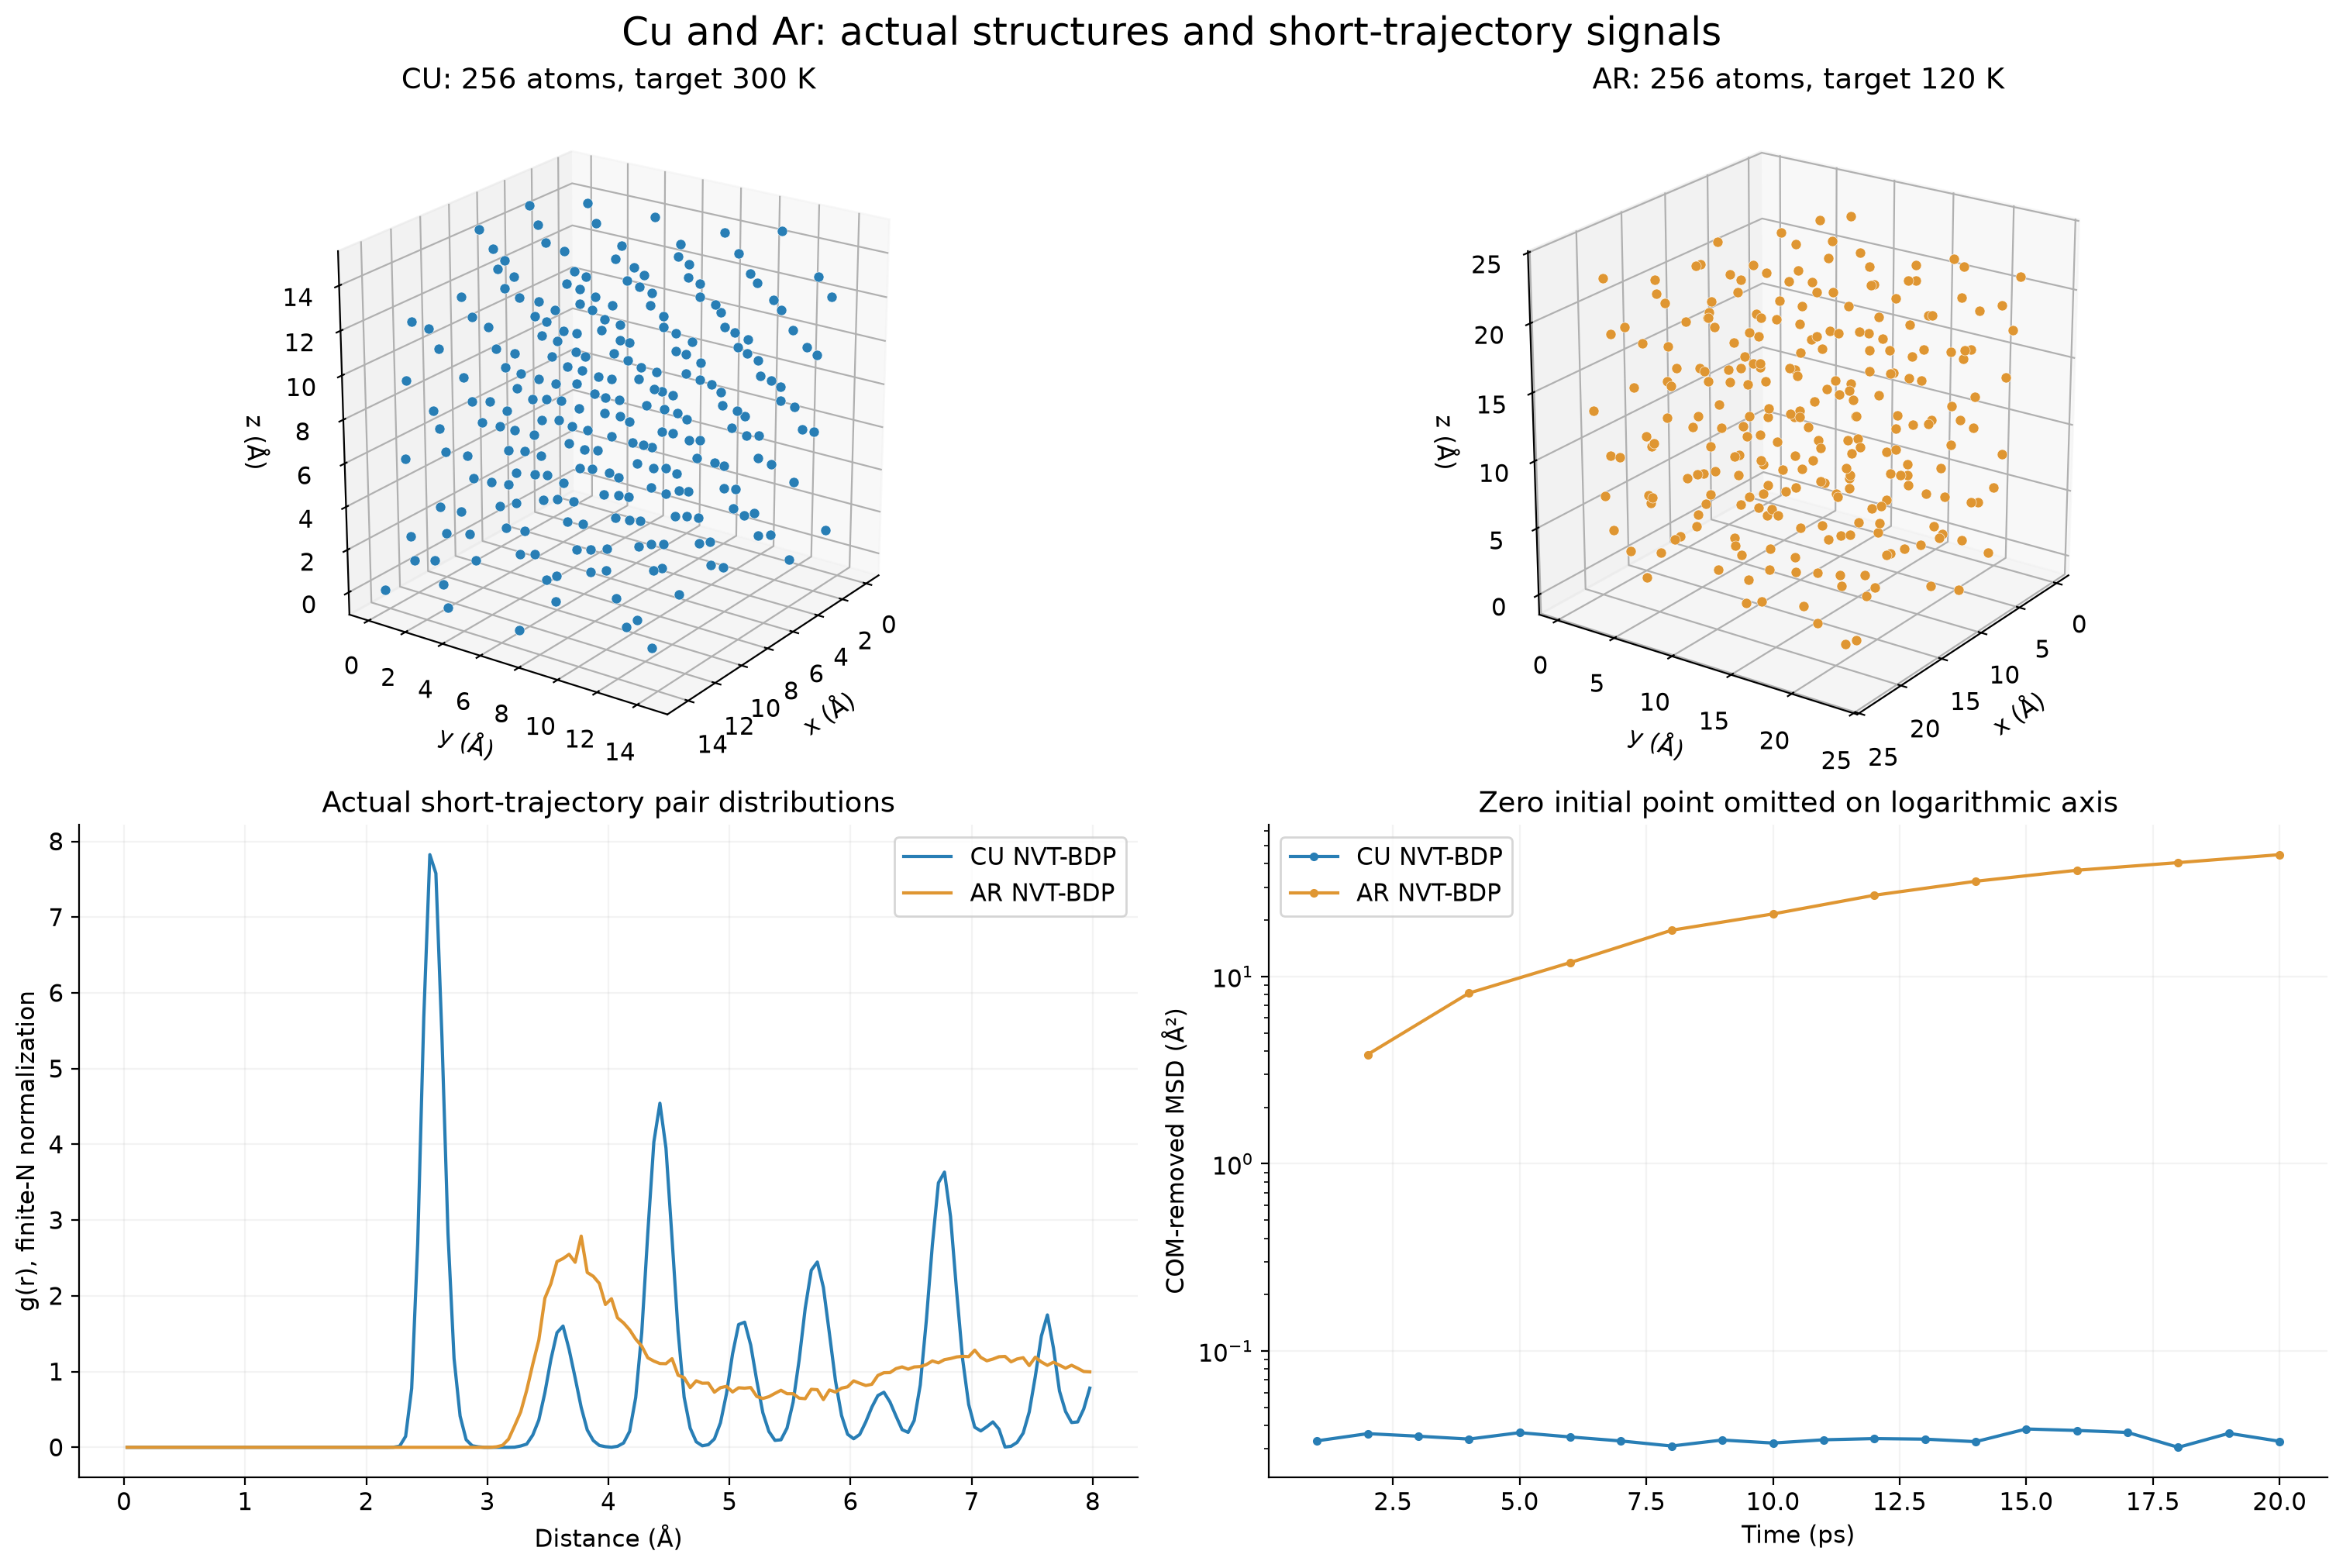
Cu采用Zhou EAM势,固定晶胞FIRE优化至0.02eV/Å,再做5ps、300K NVT-BDP准备;本次最终最大力为0.019774eV/Å。Ar采用截断10Å的LJ势,先在250K运行20ps,再降到120K运行10ps,最后120K保持10ps。两者随后分别做20ps生产。
在已有计算资源中:
bash prepare.sh
head -n 3 common/cu/restart.xyz
head -n 3 common/ar/restart.xyz
restart.xyz 包含坐标、晶胞、质量和速度。不同算法从同一份材料起点开始,但随机控温算法的后续轨迹不会因此逐位相同。Cu短准备还没有代替正式的热平衡;Ar的实际MSD和RDF用于观察这条短轨迹的流体运动,不据此确定相界。
Cu准备 / run.in
potential potential.txt
minimize fire 0.02 3000
velocity 300 seed 2612501
time_step 1
ensemble nvt_bdp 300 300 100
dump_thermo 100
dump_restart 5000
dump_xyz 1000 prepare.xyz precision double mass velocity
run 5000
展开Ar熔化、降温与保持的完整输入
potential potential.txt
velocity 250 seed 2612502
time_step 2
ensemble nvt_bdp 250 250 100
dump_thermo 100
run 10000
ensemble nvt_bdp 250 120 100
dump_thermo 100
run 5000
ensemble nvt_bdp 120 120 100
dump_thermo 100
dump_restart 5000
dump_xyz 1000 prepare.xyz precision double mass velocity
run 5000
2. 选定算法,先跑一个Cu NVT#
bash run.sh cu-nvt-bdp
tail -n 12 work/cu-nvt-bdp/run.log
tail -n 1 work/cu-nvt-bdp/thermo.out
cu-nvt-bdp / run.in
potential potential.txt
time_step 1
ensemble nvt_bdp 300 300 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
dump_thermo 100 每100步写一条热力学量;dump_xyz 1000 每1000步保存真实结构、速度、力、能量、virial和展开坐标。这里时间步1fs,因此分别是0.1ps与1ps,不是100ps与1000ps。dump_restart 20000 保存最终可用状态。
3. 六种常规NVT怎样写#
| 目录后缀 | Cu命令 | 用途与选择 |
|---|---|---|
nvt-ber |
ensemble nvt_ber 300 300 100 |
Berendsen,常用于快速准备;不能把它的温度涨落直接当严格正则统计 |
nvt-nhc |
ensemble nvt_nhc 300 300 100 |
Nosé–Hoover链 |
nvt-bdp |
ensemble nvt_bdp 300 300 100 |
随机速度重标度 |
nvt-lan |
ensemble nvt_lan 300 300 100 |
Langevin型控温 |
nvt-bao |
ensemble nvt_bao 300 300 100 |
BAOAB分裂的Langevin积分 |
nvt-mttk |
ensemble nvt_mttk temp 300 300 tperiod 100 |
MTTK的NVT写法,语法不同 |
Ar对应目录前缀为 ar-,常温目标改为120K,时间步2fs。QTB属于另一种近似核量子热浴,单独见QTB与末态数据,不能按普通经典NVT理解动能温度。
展开其余Cu常规NVT完整控制输入
cu-nvt-ber / run.in
potential potential.txt
time_step 1
ensemble nvt_ber 300 300 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
cu-nvt-nhc / run.in
potential potential.txt
time_step 1
ensemble nvt_nhc 300 300 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
cu-nvt-lan / run.in
potential potential.txt
time_step 1
ensemble nvt_lan 300 300 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
cu-nvt-bao / run.in
potential potential.txt
time_step 1
ensemble nvt_bao 300 300 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
cu-nvt-mttk / run.in
potential potential.txt
time_step 1
ensemble nvt_mttk temp 300 300 tperiod 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
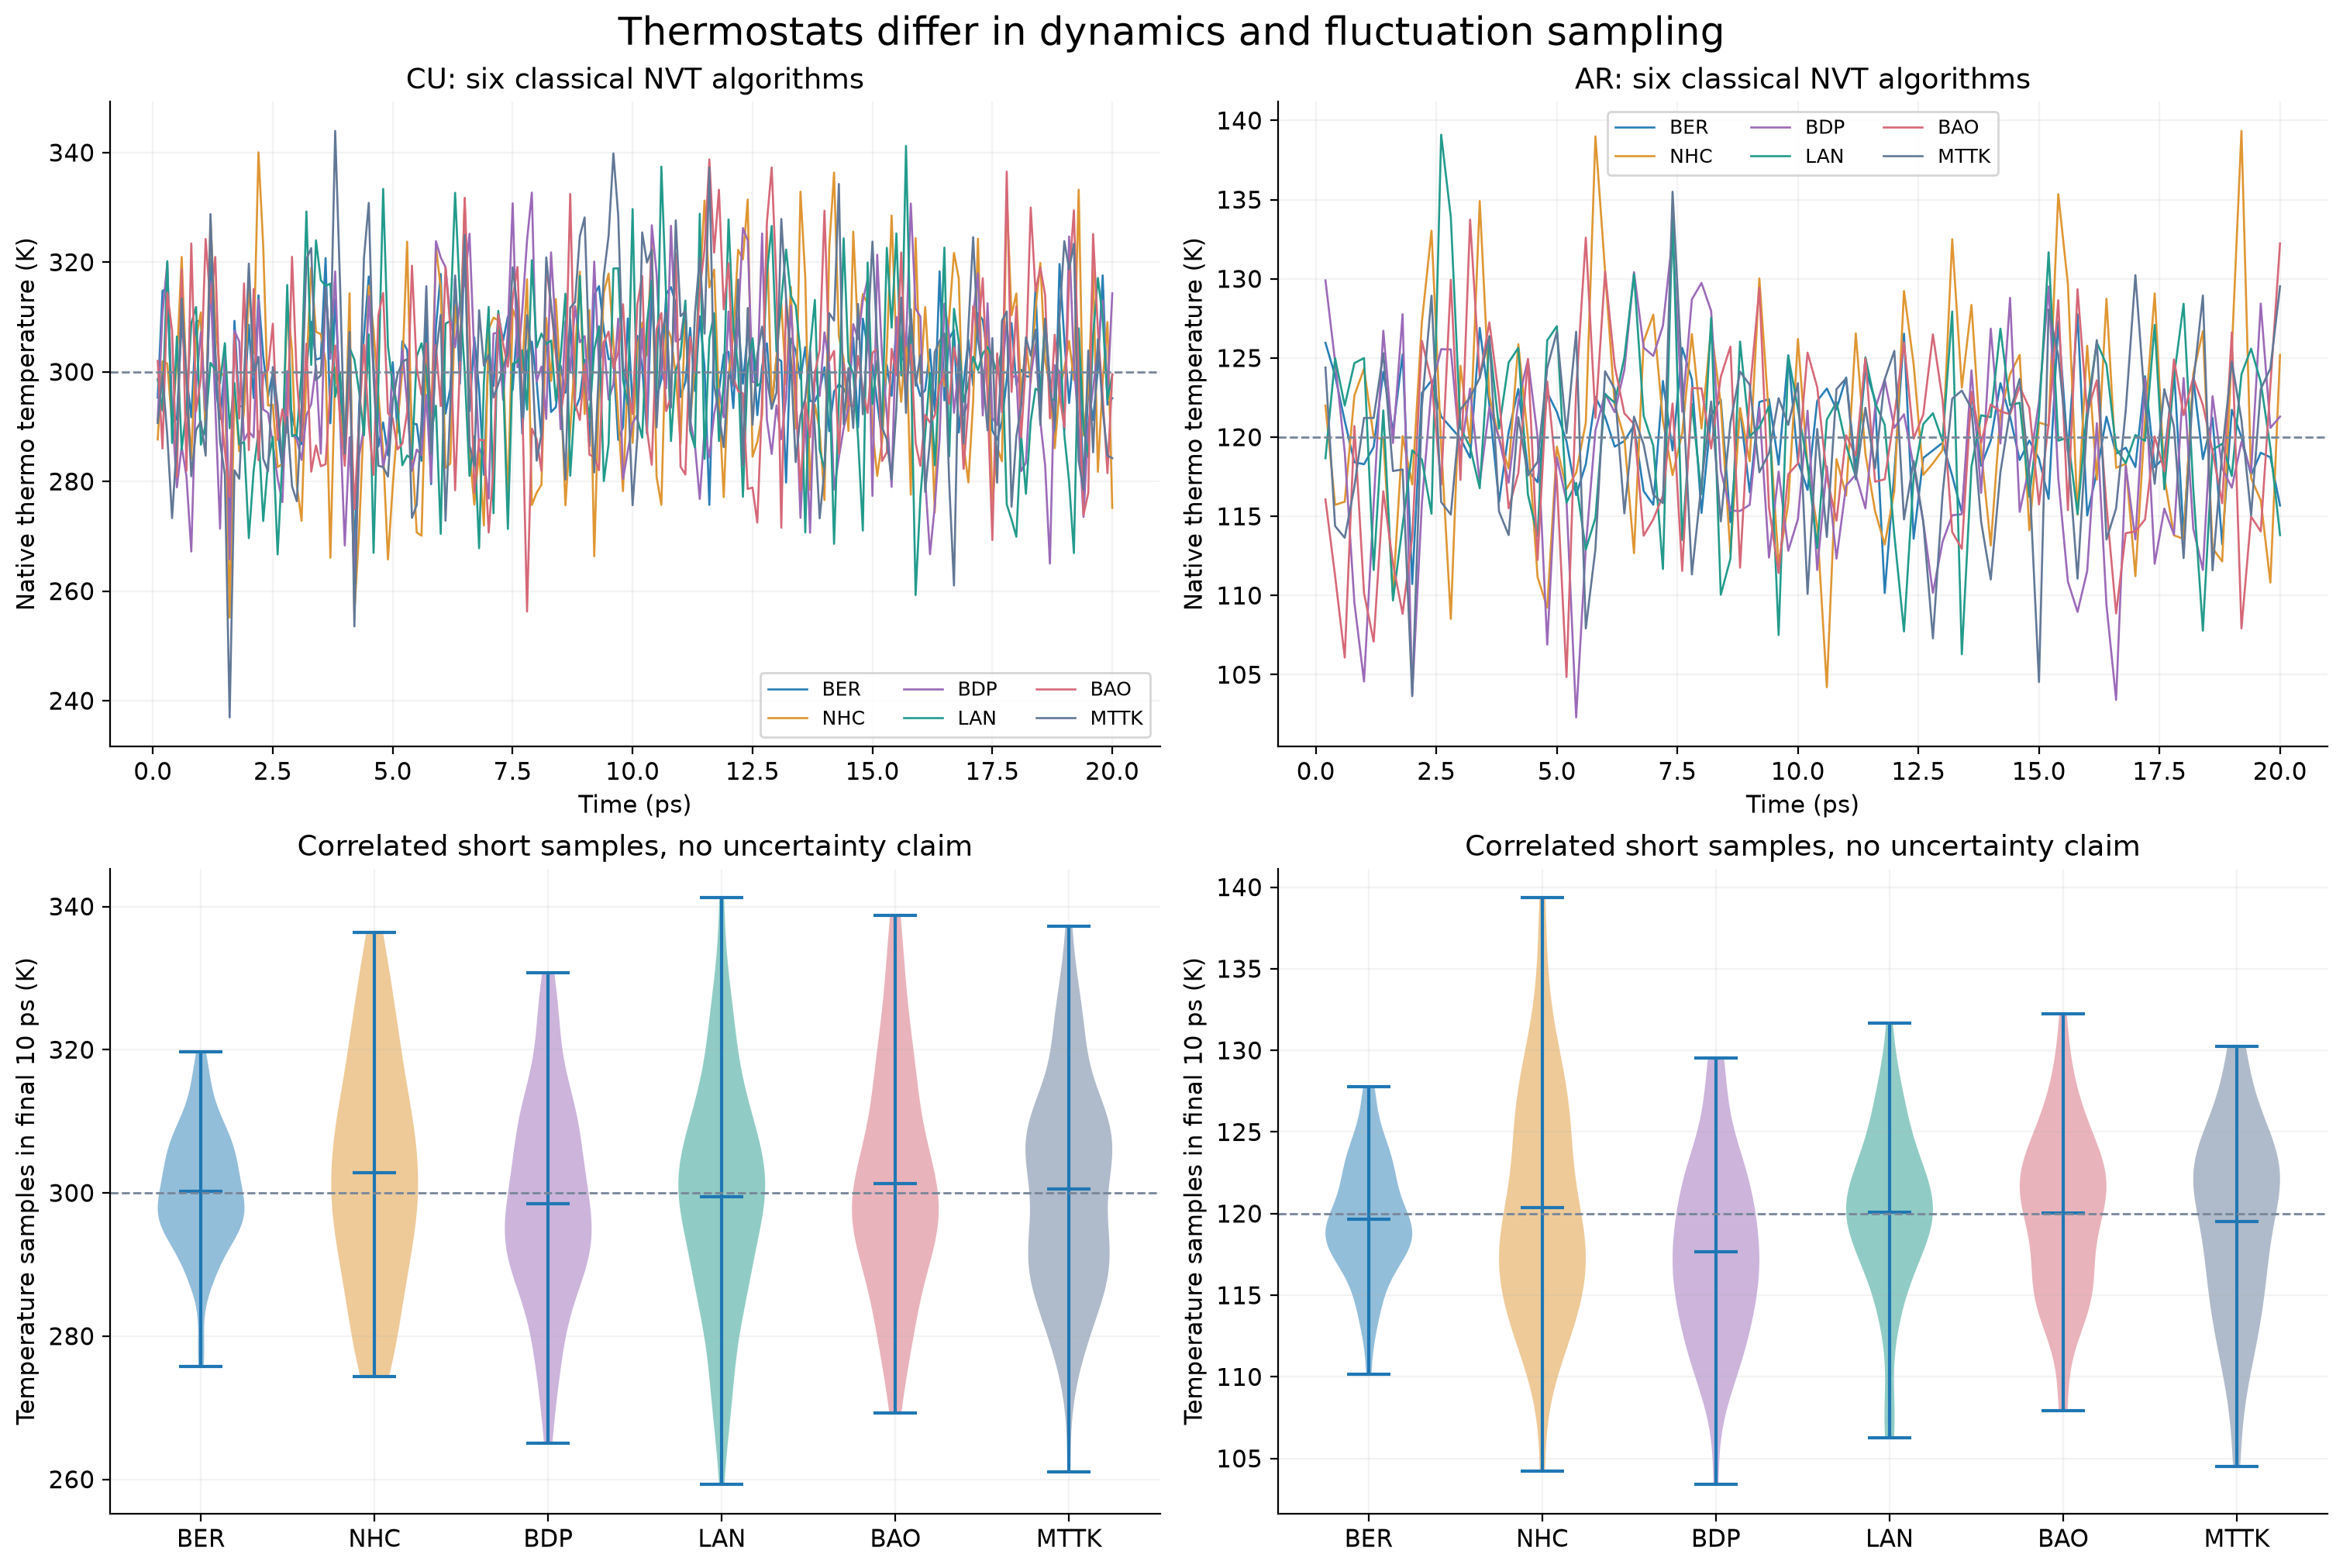
不同曲线的涨落、随机性和动力学含义不同。图中只有20ps,后半段温度分布的点也相互相关,不能把样本散布当作均值的不确定度。
4. 耦合常数不是直接填ps#
普通写法最后的100按“步数”计:Cu的1fs步长对应约0.1ps,Ar的2fs步长对应约0.2ps。更换时间步后,相同数字不一定保持相同物理耦合时间。MTTK使用 tperiod/pperiod,同样以时间步为单位,但不同算法的参数定义和响应不完全相同,不能只看数值相等。
5. 升温不是每步重置速度#
velocity 300 seed ... 用于没有速度的初始模型。已有重启速度时,程序会读入原速度,不能指望再写一行velocity就覆盖它。线性升温应改变当前算法的初、末目标温度:
cu-nvt-ramp / run.in
potential potential.txt
time_step 1
ensemble nvt_bdp 300 600 100
dump_thermo 100
dump_xyz 1000 trajectory.xyz precision double mass velocity force potential virial unwrapped_position
dump_restart 20000
run 20000
本例20ps内将目标从300K升到600K;Ar的对应例子是120K到150K。真实体系还应根据温度响应、结构变化和科学目标选择升温速率。
接着可读NVE时间步及控压与晶胞形状;固定版本语法来自官方标准系综和MTTK说明。
资料包与完整运行#
下载完整输入、真实参考数据、末态重算与绘图脚本,解压后进入目录。先重画随包结果:
bash analyze.sh
输出为 reference/analysis/ 下的CSV、数值摘要和 reference/figures/ 中的图片。原生末态重算结果已经随包,分析会先核对其输入,再处理数据。
新解压目录提交准备加一个Cu NVT-BDP实例:
sbatch run.slurm
提交完整46条件、两个材料准备流程和依赖分析:
bash submit.sh
只生成脚本检查,用 bash submit.sh --dry-run。整套完成后:
bash analyze.sh work common
这一步对每个重启末态做零步静态导出,再独立分析和画图,应在已分配的计算资源内执行;生成的分析作业已包含这些命令。只运行单例时,先直接查看其 thermo.out、trajectory.xyz、restart.xyz,统一分析需要46条件齐全。
run.slurm 默认一张P100、一个CPU核、gpu-8p100-hs;套餐用户按权限改为例如 gpu-8p100-tc。整套提交还需修改 submit.py 中的partition。bash prepare.sh 和 bash run.sh 条件名 是已有任务资源内的入口,不在登录或管理节点直接运行。prepare.sh 只在新目录建立 common/cu、common/ar,已有common/work/jobs保留;重跑整套请重新解压。单进程启动,不使用mpirun。
固定环境:GPUMD5.9.1、GCC13.3、CUDA12.9,模块 gpumd/5.9.1-p100;该构建含PLUMED2.10.1和NetCDF-C4.10.1,本批没有施加偏置。分析使用ASE3.29.0环境中的NumPy/Matplotlib。20ps结果用于操作与数值关系参考,正式材料研究仍需检查准备时长、模型、尺寸、时间步和采样;不据此给出收敛热力学量、相界或性能排名。