
hiPhive 真实力数据拟合
用实际ABACUS Si力数据演示原子映射、正负位移分组、拟合和留出误差。
阅读本篇目录
本篇把真实Si位移与DFT力变成可保存的hiPhive模型。核心顺序是:读取数据、统一原子映射、按构型分训练与留出、拟合、输出误差。不要把同一构型的不同力分量随机分到两边,那样不能检验模型对新构型的预测。
1. 准备参考结构和力#
Si-reference.xyz 完整内容:
16
Lattice="0.0 5.43 5.43 5.43 0.0 5.43 5.43 5.43 0.0" Properties=species:S:1:pos:R:3:masses:R:1 pbc="T T T"
Si       0.00000000       0.00000000       0.00000000      28.08550000
Si       0.00000000       2.71500000       2.71500000      28.08550000
Si       2.71500000       0.00000000       2.71500000      28.08550000
Si       2.71500000       2.71500000       5.43000000      28.08550000
Si       2.71500000       2.71500000       0.00000000      28.08550000
Si       2.71500000       5.43000000       2.71500000      28.08550000
Si       5.43000000       2.71500000       2.71500000      28.08550000
Si       5.43000000       5.43000000       5.43000000      28.08550000
Si       1.35750000       1.35750000       1.35750000      28.08550000
Si       1.35750000       4.07250000       4.07250000      28.08550000
Si       4.07250000       1.35750000       4.07250000      28.08550000
Si       4.07250000       4.07250000       6.78750000      28.08550000
Si       4.07250000       4.07250000       1.35750000      28.08550000
Si       4.07250000       6.78750000       4.07250000      28.08550000
Si       6.78750000       4.07250000       4.07250000      28.08550000
Si       6.78750000       6.78750000       6.78750000      28.08550000
Si-forces.xyz 是38帧同晶胞结构,每行在位置和质量后增加三个力分量。例如第一帧的第一行原子为:
Si 0.00000000 0.02121320 0.02121320 28.08550000 -0.01489751 -0.31923274 -0.31923274
头部必须含 forces:R:3,让ASE能通过 get_forces() 取得数据。完整38帧已在资料包中,不需要手工复制数百行。
2. 整理原子对应与位移#
脚本实际调用:
from ase.io import read
from hiphive.utilities import prepare_structure
ref = read('Si-reference.xyz')
frames = read('Si-forces.xyz', index=':')
prepared = [prepare_structure(a, ref) for a in frames]
print(prepared[0].get_array('displacements'))
prepare_structure 负责相对于参考结构的周期位移与原子对应。仍要先保证晶胞、元素、力和坐标匹配。原始帧5和22是相同的零位移观测,随包保留,但拟合过滤掉;非零构型共36个。正负成对位移一起划分,得到28训练/8留出,避免正负近重复泄漏。
3. 运行CPU拟合#
在已分配CPU资源中:
module load hiphive/1.5
export OMP_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1
python fit_labels.py my-fit
cat my-fit/FIT.json
my-fit 必须不存在。程序依次执行ClusterSpace、StructureContainer、最小二乘、ForceConstantPotential,再生成指定16原子超胞的ForceConstants。二阶与三阶的对照由完整入口 bash fit.sh 生成;XYZ入口固定为二加三阶、3Å截断。
核心拟合步骤在脚本中是:
cs = ClusterSpace(ref, [3.0, 3.0])
sc = StructureContainer(cs)
for a in prepared:
    sc.add_structure(a)
A, y = sc.get_fit_data()
# trainrows/testrows由完整构型对应的3N行构成
opt = Optimizer((A, y), fit_method='least-squares',
                standardize=False, train_set=trainrows, test_set=testrows)
opt.train()
fcp = ForceConstantPotential(cs, opt.parameters)
fcs = fcp.get_force_constants(ref)
这里省略的数据过滤和分组索引可直接查看随包 fit_labels.py,不要把未过滤的prepared列表代入后照抄28/8索引。
4. 读懂实际误差#
| 模型 | 自由参数 | 训练力RMSE/eV·Å⁻¹ | 留出力RMSE/eV·Å⁻¹ |
|---|---|---|---|
| 二阶、3Å | 2 | 0.014040 | 0.014715 |
| 二加三阶、各3Å | 5 | 0.012880 | 0.013166 |
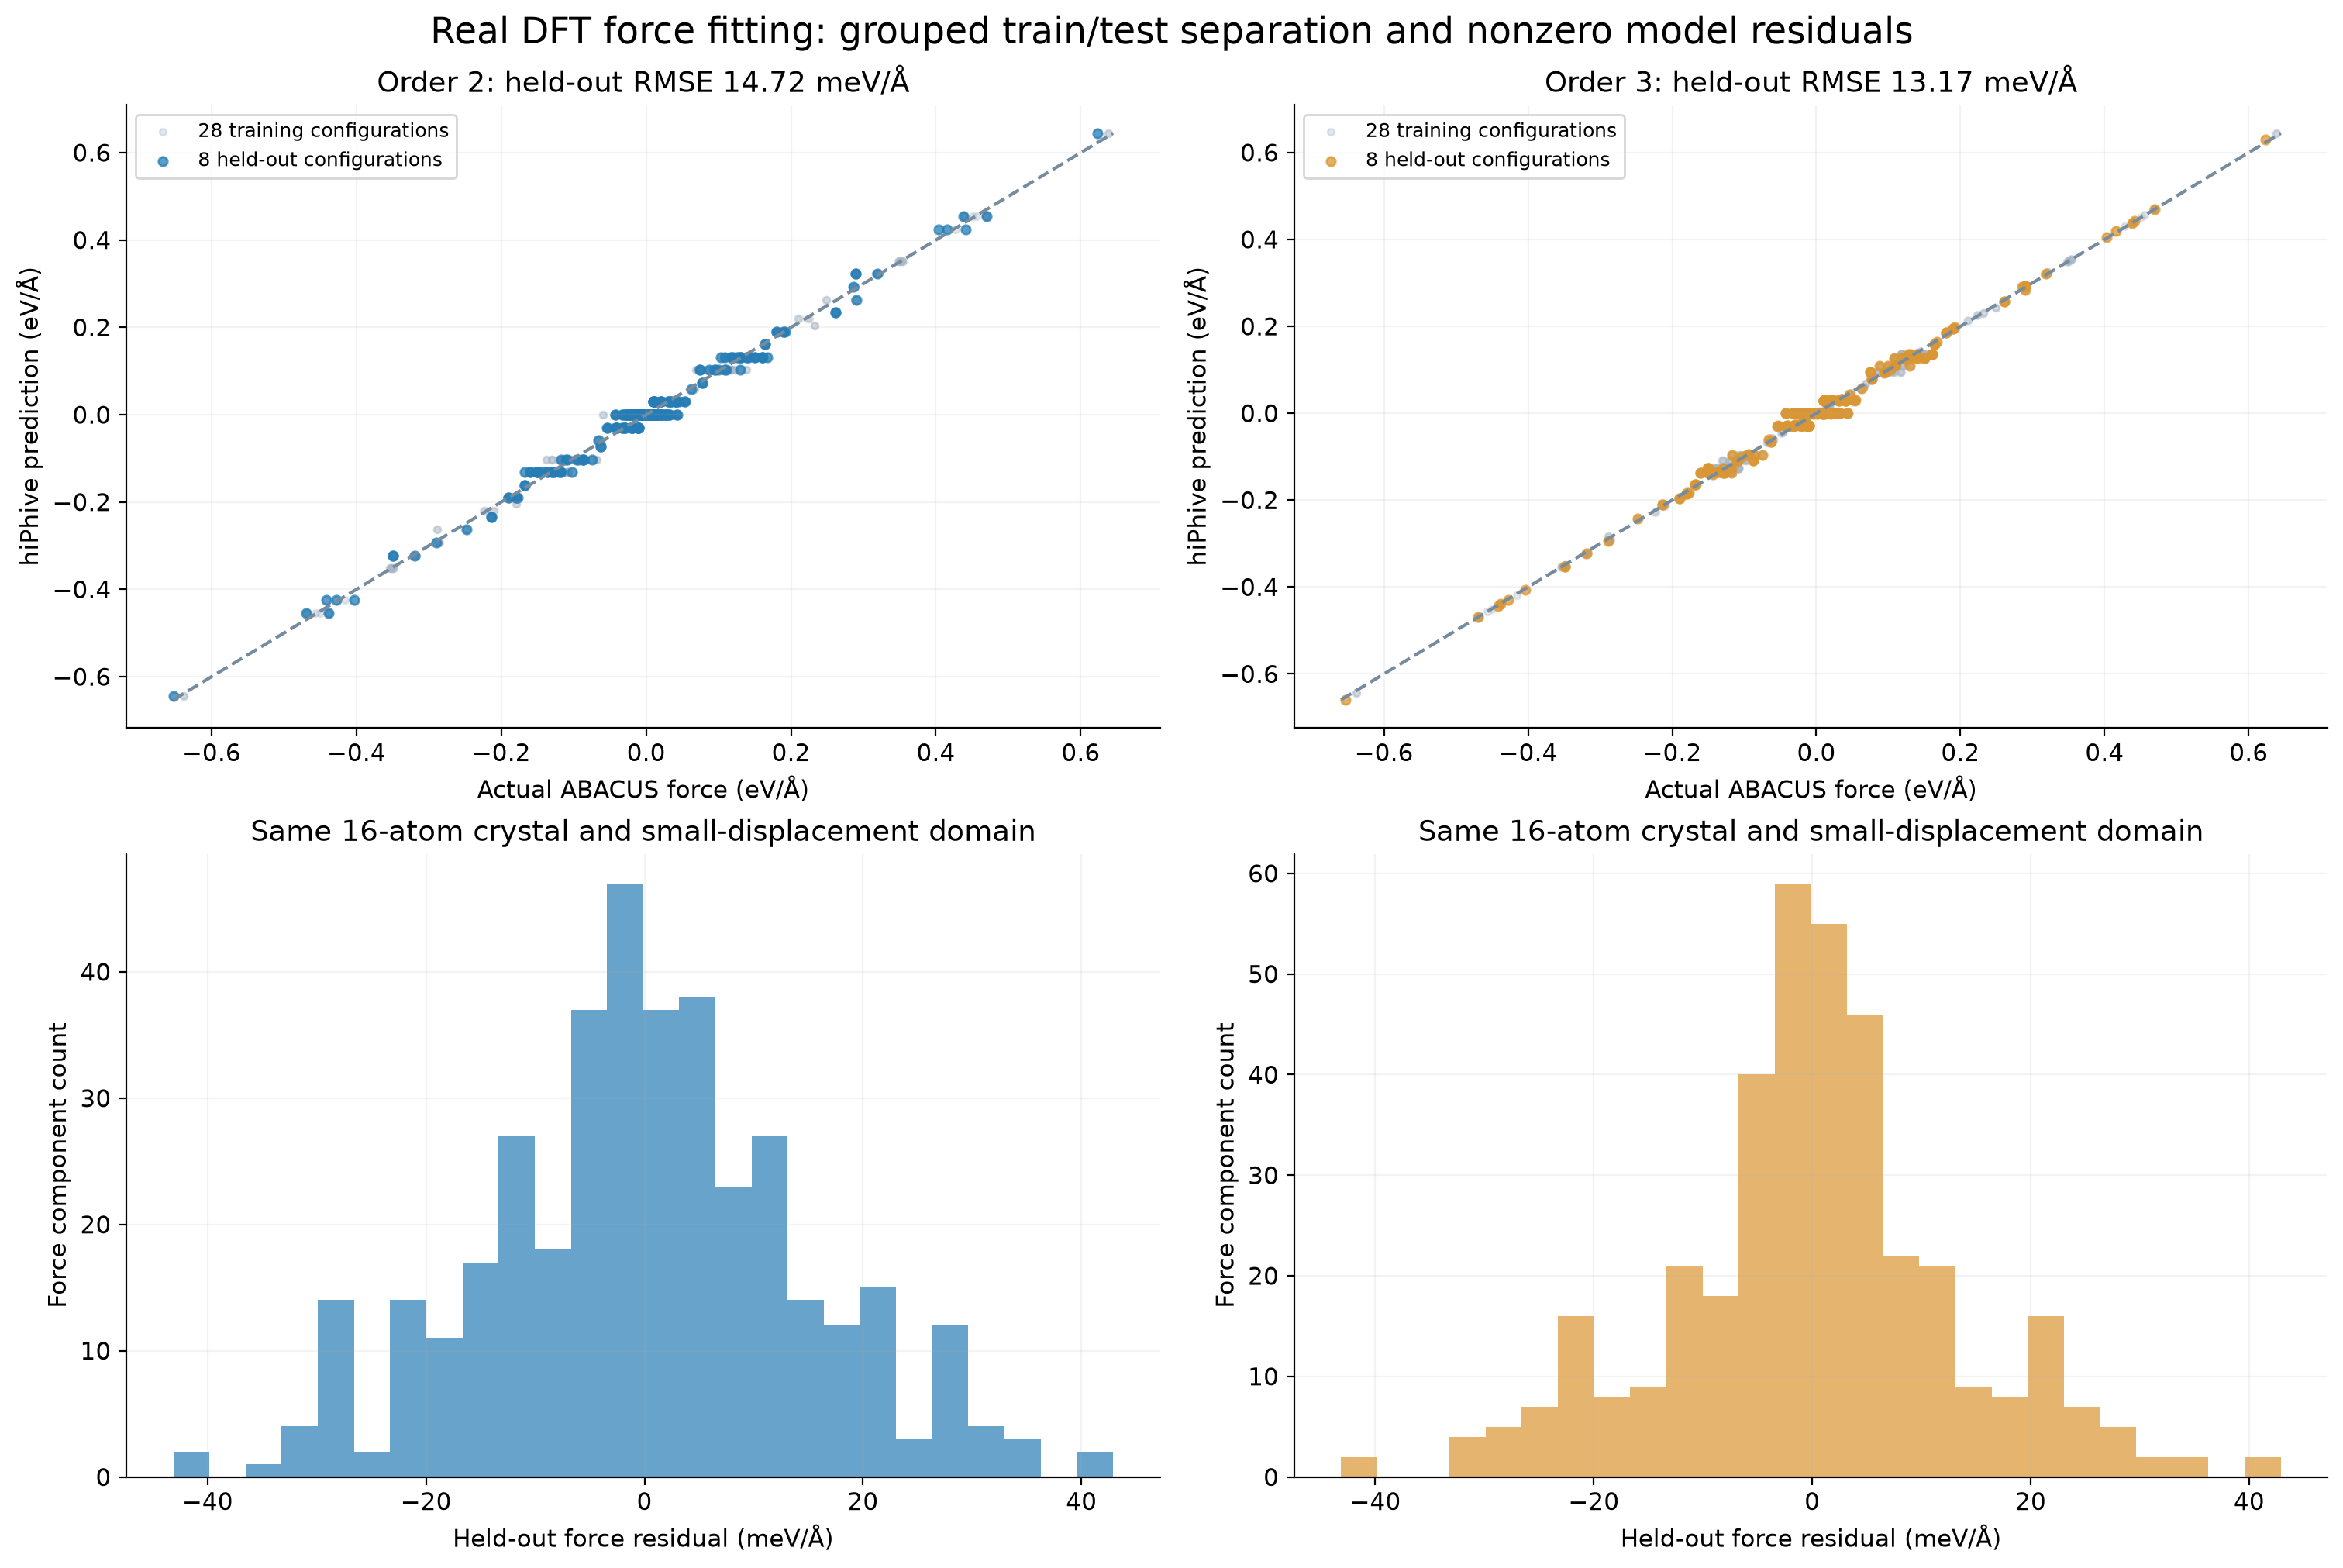
表中RMSE按三个笛卡尔方向和所有原子力分量共同统计。三阶模型对这组留出数据的误差略小,但最大局部误差仍约0.04314eV/Å。仅用16原子、3Å截断和这一类位移,不能推出更大振幅、高温或不同化学环境下同样准确。
5. 保存模型再交给下游#
cluster-space.cs 保存基组,structures.sc 保存拟合容器,potential.fcp 保存参数化模型,force-constants.fcs 保存指定超胞的力常数。后两者不是同一种文件,也不能当GPUMD驱动文件直接读。下一步见导出与读取;独立的完整XYZ入口为 sbatch labels.slurm,包含一次GPUMD静态计算和各格式读取。
下载与完整运行#
下载输入、真实力数据、参考输出和全部绘图脚本,解压到自己的工作目录。先重画随包结果,不重新计算:
bash analyze.sh
输出在 reference/analysis/ 和 reference/figures/。在新解压目录提交完整的两种hiPhive拟合、7组层状结构和44组FCP条件:
sbatch run.slurm
默认一张P100、一个CPU核、30分钟,分区为 gpu-8p100-hs;GPU套餐用户按自己的权限改为例如 gpu-8p100-tc。需要按条件并行提交时:
bash submit.sh
这会生成带依赖的拟合、51个条件和分析作业。只生成脚本用 bash submit.sh --dry-run。全部结束后查看 work/analysis/ 和 work/figures/,或重新分析:
bash analyze.sh work work-fcp fit
bash fit.sh 是CPU拟合入口,bash run.sh 条件名 是已经分配计算资源后的单例入口;不要在登录节点直接启动GPUMD。拟合脚本不覆盖已有 fit/,计算也不覆盖已有结果;重新计算整套请重新解压。单例完成后可以直接查看输出,统一分析需要整套条件齐全。
本例使用GPUMD5.9.1 P100构建(GCC13.3、CUDA12.9)、hiPhive1.5及ASE环境,读取导出文件使用Phonopy4.8.3、phono3py4.8.2。入口脚本会加载对应模块或已安装的工具环境。当前示例是短小的操作参考,不代替势函数、超胞、截断、位移幅度与采样的收敛检查。
截断、温度与晶格热输运实例#
hiPhive截断与阶数、正则化与独立验证、有限温度力常数提供Si64 NEP标签的完整短轨迹和拟合;ShengBTE专题则用已有真实ABACUS力常数演示RTA/迭代、数值参数、同位素、纳米线、寿命/MFP及Wigner输出。两类数据来源分开说明,终端输入、真实图和下载包配套,有限模型与短采样不作收敛材料性质或性能排名。