
ShengBTE 寿命与平均自由程
用完整q网格速度和散射率独立重建RTA,实际提取寿命、MFP和累积热导。
阅读本篇目录
热导张量之外,ShengBTE还输出频率、速度、散射率和累积贡献。读这些文件时,先统一单位、模的排列和RTA/迭代含义,再画寿命与平均自由程。
1. 常用输出对应什么#
| 文件 | 内容与单位 |
|---|---|
| BTE.omega | 不可约q点的角频率,rad/ps |
| BTE.v_full | 完整q网格群速度,km/s,数值上等于nm/ps |
| BTE.w_isotopic | 同位素散射率,ps⁻¹ |
| T300K/BTE.w_anharmonic | 三声子散射率,ps⁻¹ |
| T300K/BTE.w | RTA总散射率,ps⁻¹ |
| T300K/BTE.w_final | 迭代求解后的有效量,不能直接替代所有RTA定义 |
| BTE.cumulative_kappa_scalar | 按平均自由程截断的累积热导 |
角频率除以2π才是THz;不能把BTE.omega中的数值直接当THz。
2. 看散射率组成#
head -n 5 reference/si-q6-300K-rta/BTE.w_isotopic
head -n 5 reference/si-q6-300K-rta/T300K/BTE.w_anharmonic
head -n 5 reference/si-q6-300K-rta/T300K/BTE.w
本例原生总率满足三声子加同位素的关系,三声子率又由程序输出的plus/minus两部分相加。不要在已经包含相应系数的输出上再把minus除以二。关闭同位素或纯单一同位素时,对应同位素散射率为零。
3. 计算RTA寿命和平均自由程#
对正散射率w,RTA寿命τ=1/w,单位ps;平均自由程Λ=|v|τ,单位nm。热导由每模热容、速度张量和寿命积分得到。
随包分析使用完整q网格速度,并正确映射不可约散射率;直接拿不可约速度模长乘权重,在简并模下不一定等价。按本版原生规则,热导积分排除Γ点,热容积分则保留它。分析从这些原始量独立重建RTA迹/3,与原生结果一致。
bash analyze.sh
module load ase/3.29.0
python - <<'PY'
import numpy as np
with np.load('reference/analysis/mode-data.npz') as a:
    mfp = a['si-q6-300K-rta__MFP_nm']
    cumulative = a['si-q6-300K-rta__cumulative_RTA_WmK']
    print(mfp[:5], cumulative[:5])
    print('累计热导终值:', cumulative[-1])
PY
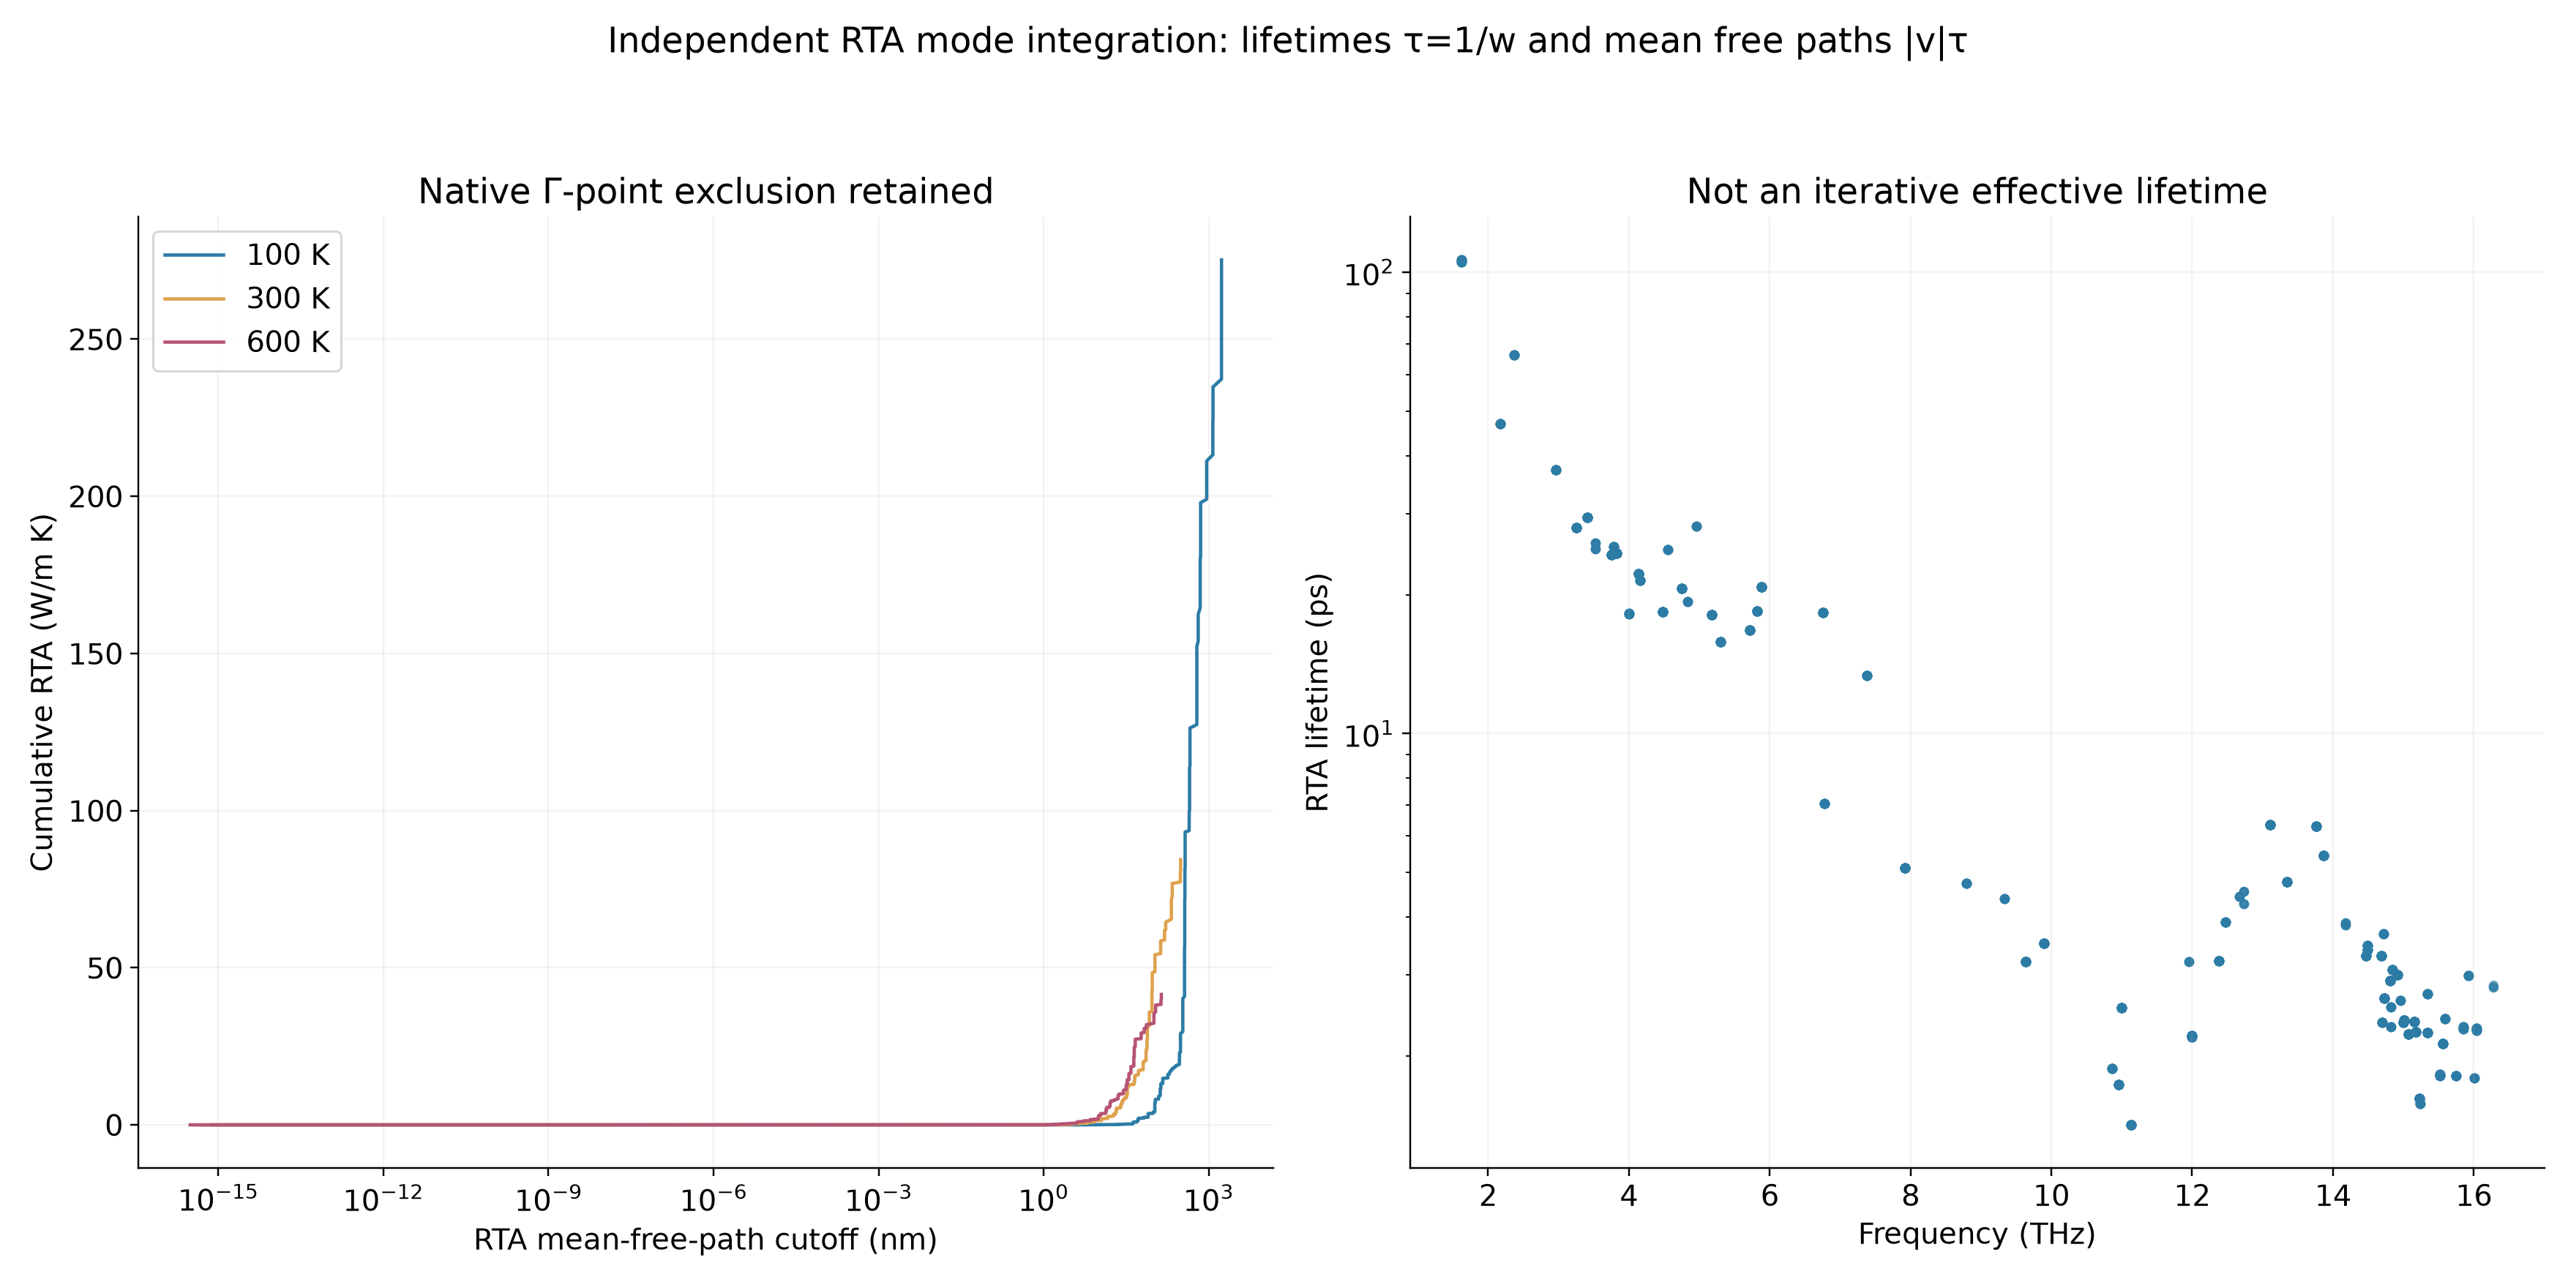
4. 怎样解释累积图#
曲线说明当前模型中,某个RTA平均自由程阈值以下的模式贡献了多少热导。它不能直接给出某个真实样品长度的热导,也不等于纳米线边界计算。迭代BTE中的有效寿命和模贡献还可能有不同解释,本篇独立累积使用RTA定义,不混用w_final。
原生文件提供有限数量的MFP或角频率阈值;独立分析按相同阈值重新积分,核对累积值和总值,再画图。网格、力常数范围和简并处理仍会影响模式分解,不能据粗网格曲线精确指定实验器件尺寸。
资料包与运行入口#
下载力常数、25组完整输入、实际输出及全部分析画图脚本。解压后先检查输入、重画随包参考:
bash check-inputs.sh
bash analyze.sh
完整重新计算25组BTE后处理,在新解压目录提交:
sbatch run.slurm
只算一个q=6、300K RTA条件用 sbatch single.slurm,可编辑其中的条件名。模板遵守CPU分区整节点56核申请规则;这些小例实际使用1个MPI进程、1个计算线程,旨在学习输入和物理结果。大体系需要另按规模调整并行设置,不能用这些小例作性能推荐。
已经获得CPU计算资源时,可以直接调用 bash run.sh 条件名;不要把普通登录节点当计算节点。整套完成后:
bash analyze.sh work
图片在 work/figures/,数值摘要在 work/analysis/RESULTS.json。单例可直接看其 BTE.* 文件,统一分析需要25组完整结果。脚本不会覆盖已有work目录,重新计算请重新解压。
环境:ShengBTE2.1.0,GCC/GFortran13.3、Open MPI5.0.10、MKL2024.2 GF_LP64 sequential,模块 shengbte/2.1.0-8173m;此构建需要AVX-512 CPU,不能直接放到P100主机的旧CPU上运行。输入检查使用hiPhive1.5和Phonopy4.8.3,脚本分别加载对应环境,无需把所有依赖混装进同一Python。
力常数来自本集群已有的真实ABACUS Si16位移计算,本批只重新求解和分析BTE,没有新做DFT。三阶模型范围3Å,电子参数、超胞和q网格仍有有限性;本专题是操作与数值检查参考,不将结果当作收敛的硅材料热导率或CPU性能数据。