
ALAMODE验证:训练、三折分组与独立留出
通过真实Si64力数据比较谐波、三阶与四阶模型,说明成组划分、误差提取、XML力预测和独立检查。
阅读本篇目录
力常数能拟合训练数据,还不够说明它适合预测新的位移。高阶拟合教程的Si64 SW实例额外保留了未用于拟合的位移方向,本页展示如何查看这些结果。
1. 先按位移方向分组#
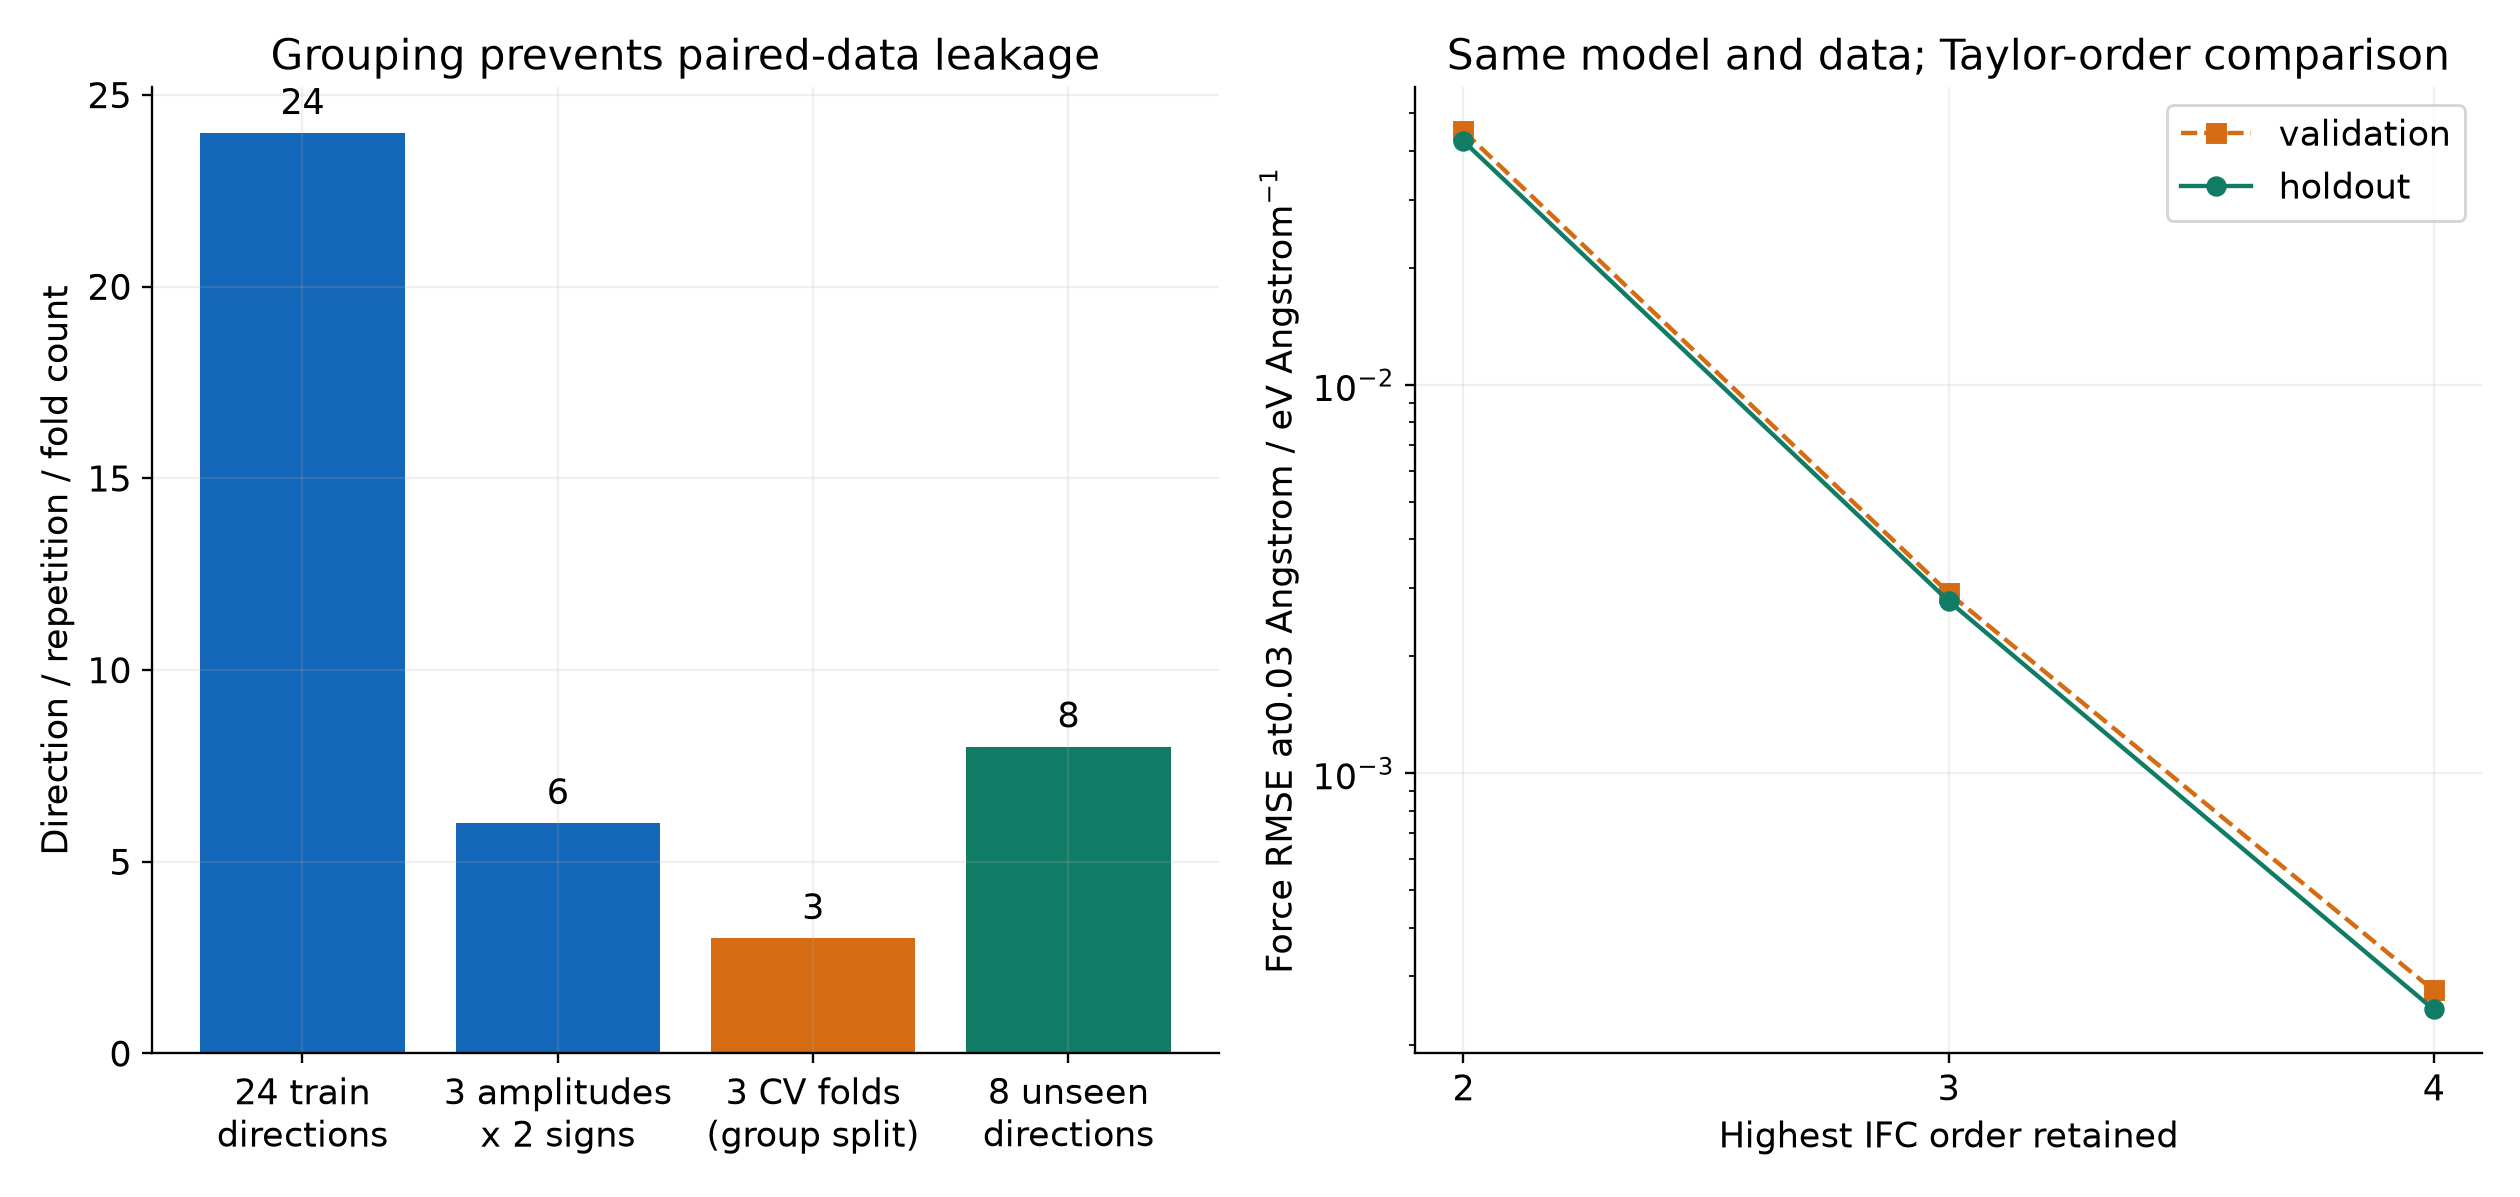
本例32个随机方向,每个方向都有三个幅度和正负位移。它们彼此相关,不能把同一方向的正位移放进训练、负位移放进测试。
| 用途 | 方向编号 | 每个方向快照数 | 总快照数 |
|---|---|---|---|
| 全训练 | 0–23 | 3幅度×2符号=6 | 144 |
| 独立留出 | 24–31 | 6 | 48 |
| 每一折验证 | 训练方向中的8个 | 6 | 48 |
| 每一折拟合 | 其余16个训练方向 | 6 | 96 |
三折按照训练方向编号对3取余划分。同一方向的所有幅度和符号始终在同一折;独立留出的8个方向不参与任何一折拟合。
2. 在终端跑完整流程#
新解压目录、已分配CPU环境中执行:
module load alamode/1.5.0
bash run.sh
如果按步骤分别运行,依次为:
python make-displacements.py
python extract-forces.py
python fit_models.py
python analyze_ifcs.py
python plot.py
不要在已执行过 run.sh 的目录再重复整套命令;脚本保留已有数据并要求换新目录。目录里的 fit/order1-*、order2-*、order3-*分别对应最高保留FC2、FC3、FC4。
本例用分组脚本组织三折,每折调用原生 alm 做OLS,再独立计算验证力误差。没有把ALAMODE的 CV=3 当作OLS选项。 软件内部的 CV 关键字用于enet或adaptive-lasso等正则化流程,参数与本例不同。官方CV参数说明
3. 查看实际独立留出误差#
以下是48个留出快照按位移幅度分组后、对所有原子和笛卡尔力分量计算的均方根误差,单位eV/Å。每种幅度有8个方向×2符号=16个快照。
| 分量RMS位移 / Å | 仅FC2 | FC2+FC3 | FC2+FC3+FC4 |
|---|---|---|---|
| 0.005 | 0.00119312 | 0.000238495 | 8.46385e-06 |
| 0.015 | 0.0105532 | 0.000627667 | 6.14014e-05 |
| 0.03 | 0.0424069 | 0.00277516 | 0.000246344 |
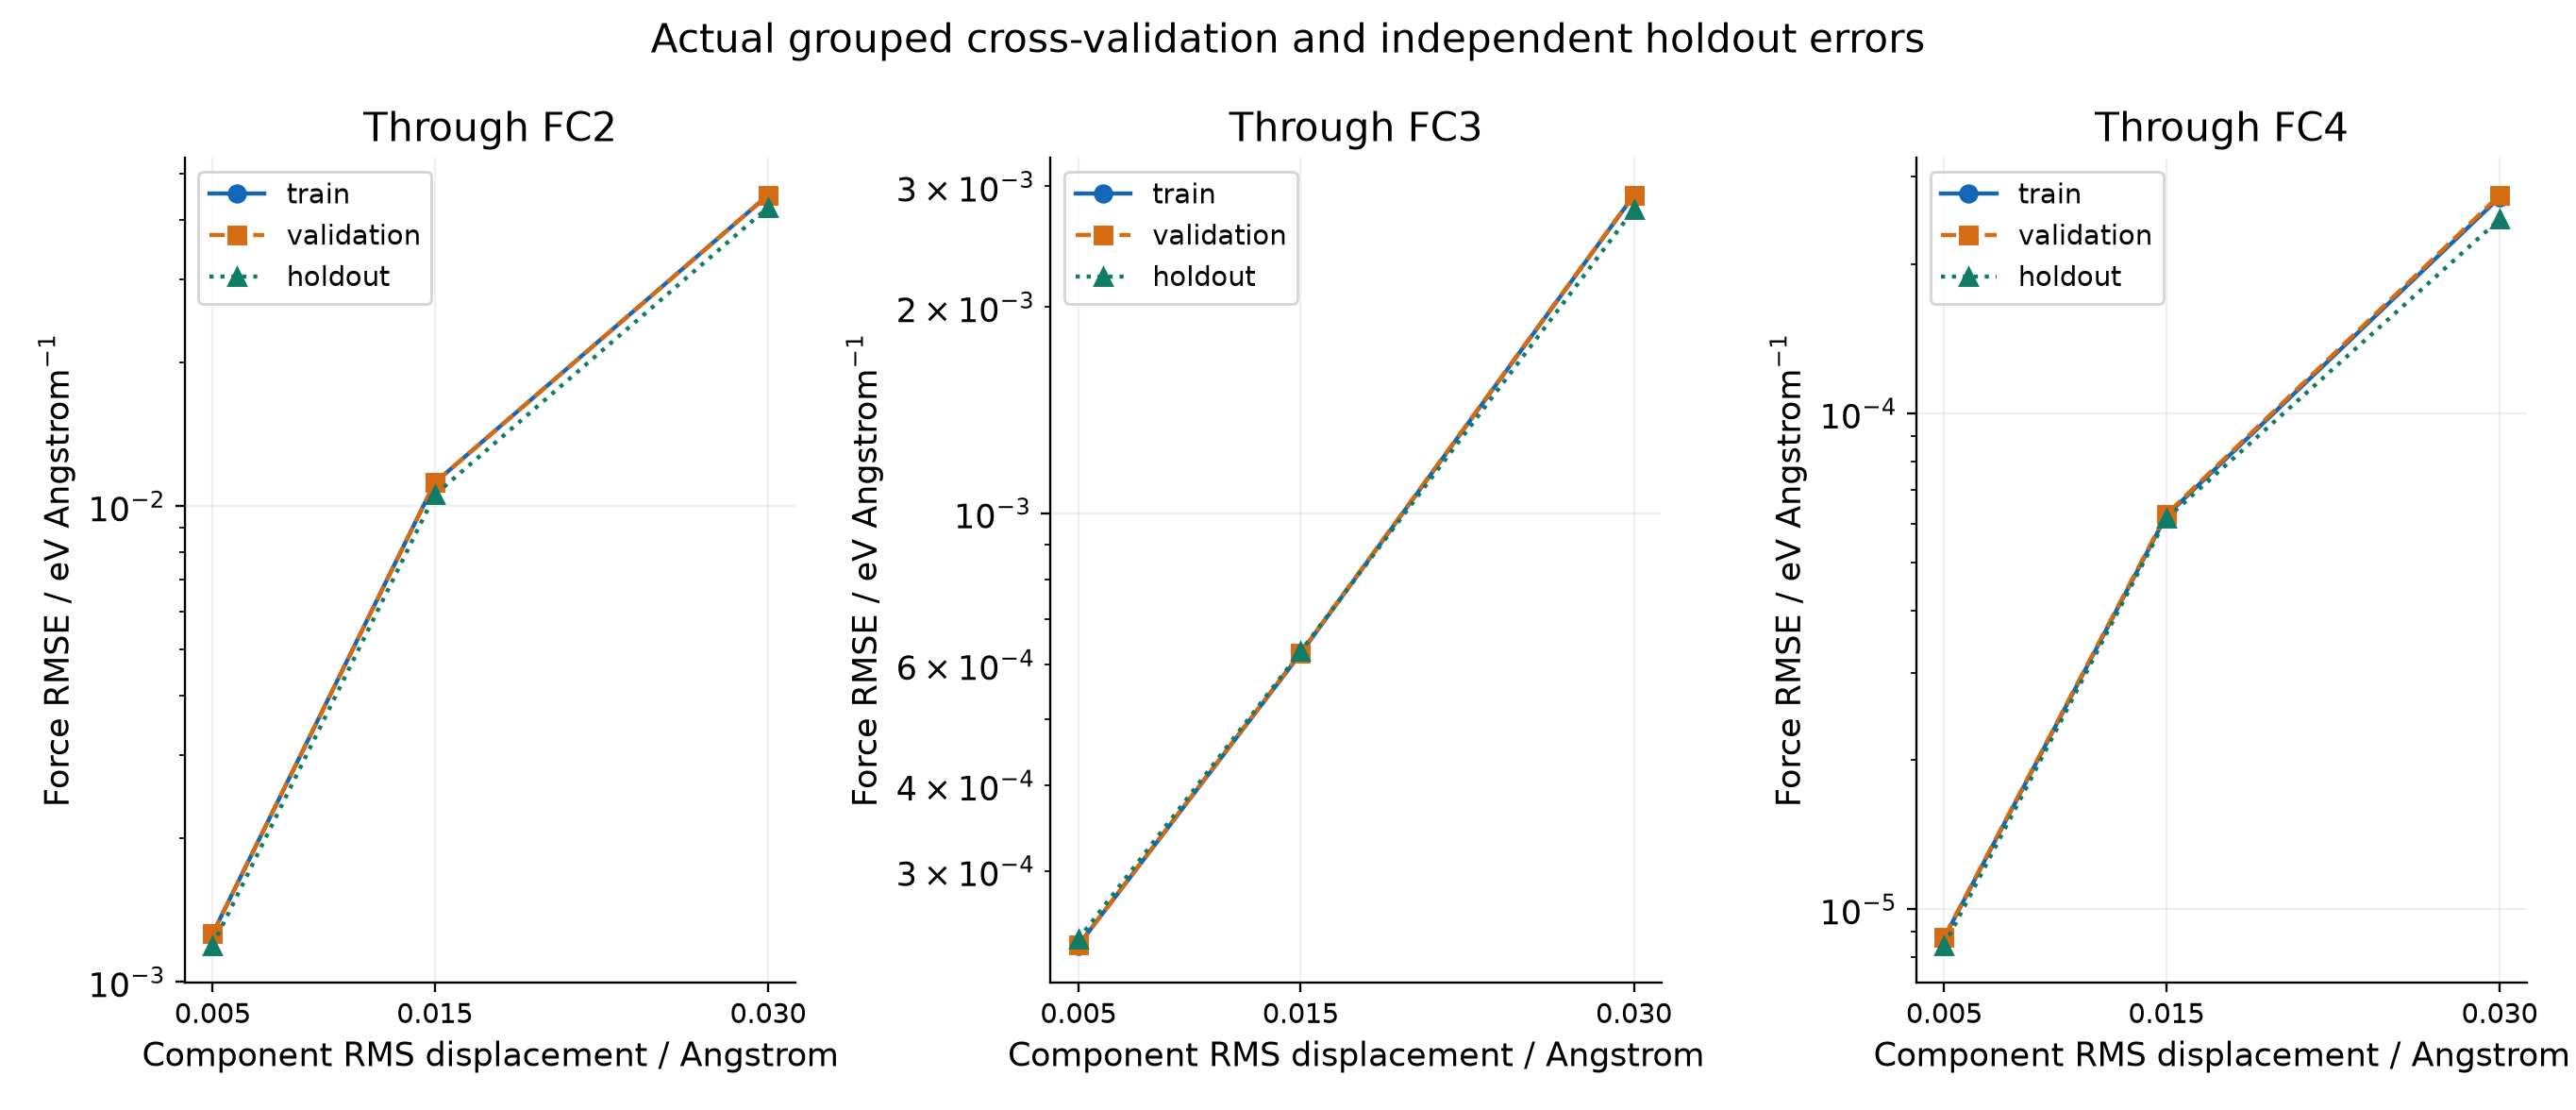
最高幅度0.03Å下,仅谐波的误差约0.0424eV/Å,加入三阶项后约0.00278eV/Å,再加入四阶项后约0.000246eV/Å。这说明在本例位移范围与SW模型内,高阶项改善了力的重建;不能据此推断任意温度、结构变化或化学环境下都保持相同精度。
4. 用CSV与NPZ看清哪些是留出点#
head analysis/force-errors.csv
cat analysis/SUMMARY.json
force-errors.csv逐快照记录模型阶数、折号、用途、方向、幅度及力误差。SUMMARY.json给出分组后的汇总。要仅查看全训练模型在独立留出数据上的结果:
python - <<'PY'
import csv
with open('analysis/force-errors.csv') as f:
    rows = list(csv.DictReader(f))
for row in rows:
    if row['fit'] == 'order3-full' and row['split'] == 'holdout':
        print(row['direction'], row['amplitude_A'], row['sign'], row['RMSE_eV_A'])
PY
NPZ中同时保留了不同用途的数据,画独立留出图时必须使用 split筛选:
python - <<'PY'
import numpy as np
a = np.load('analysis/force-predictions.npz')
mask = a['split'] == 'holdout'
error = a['predicted_F_eV_A'][mask] - a['native_F_eV_A'][mask]
print('留出快照数:', mask.sum())
print('全体留出力分量RMSE eV/Angstrom:', np.sqrt(np.mean(error**2)))
PY
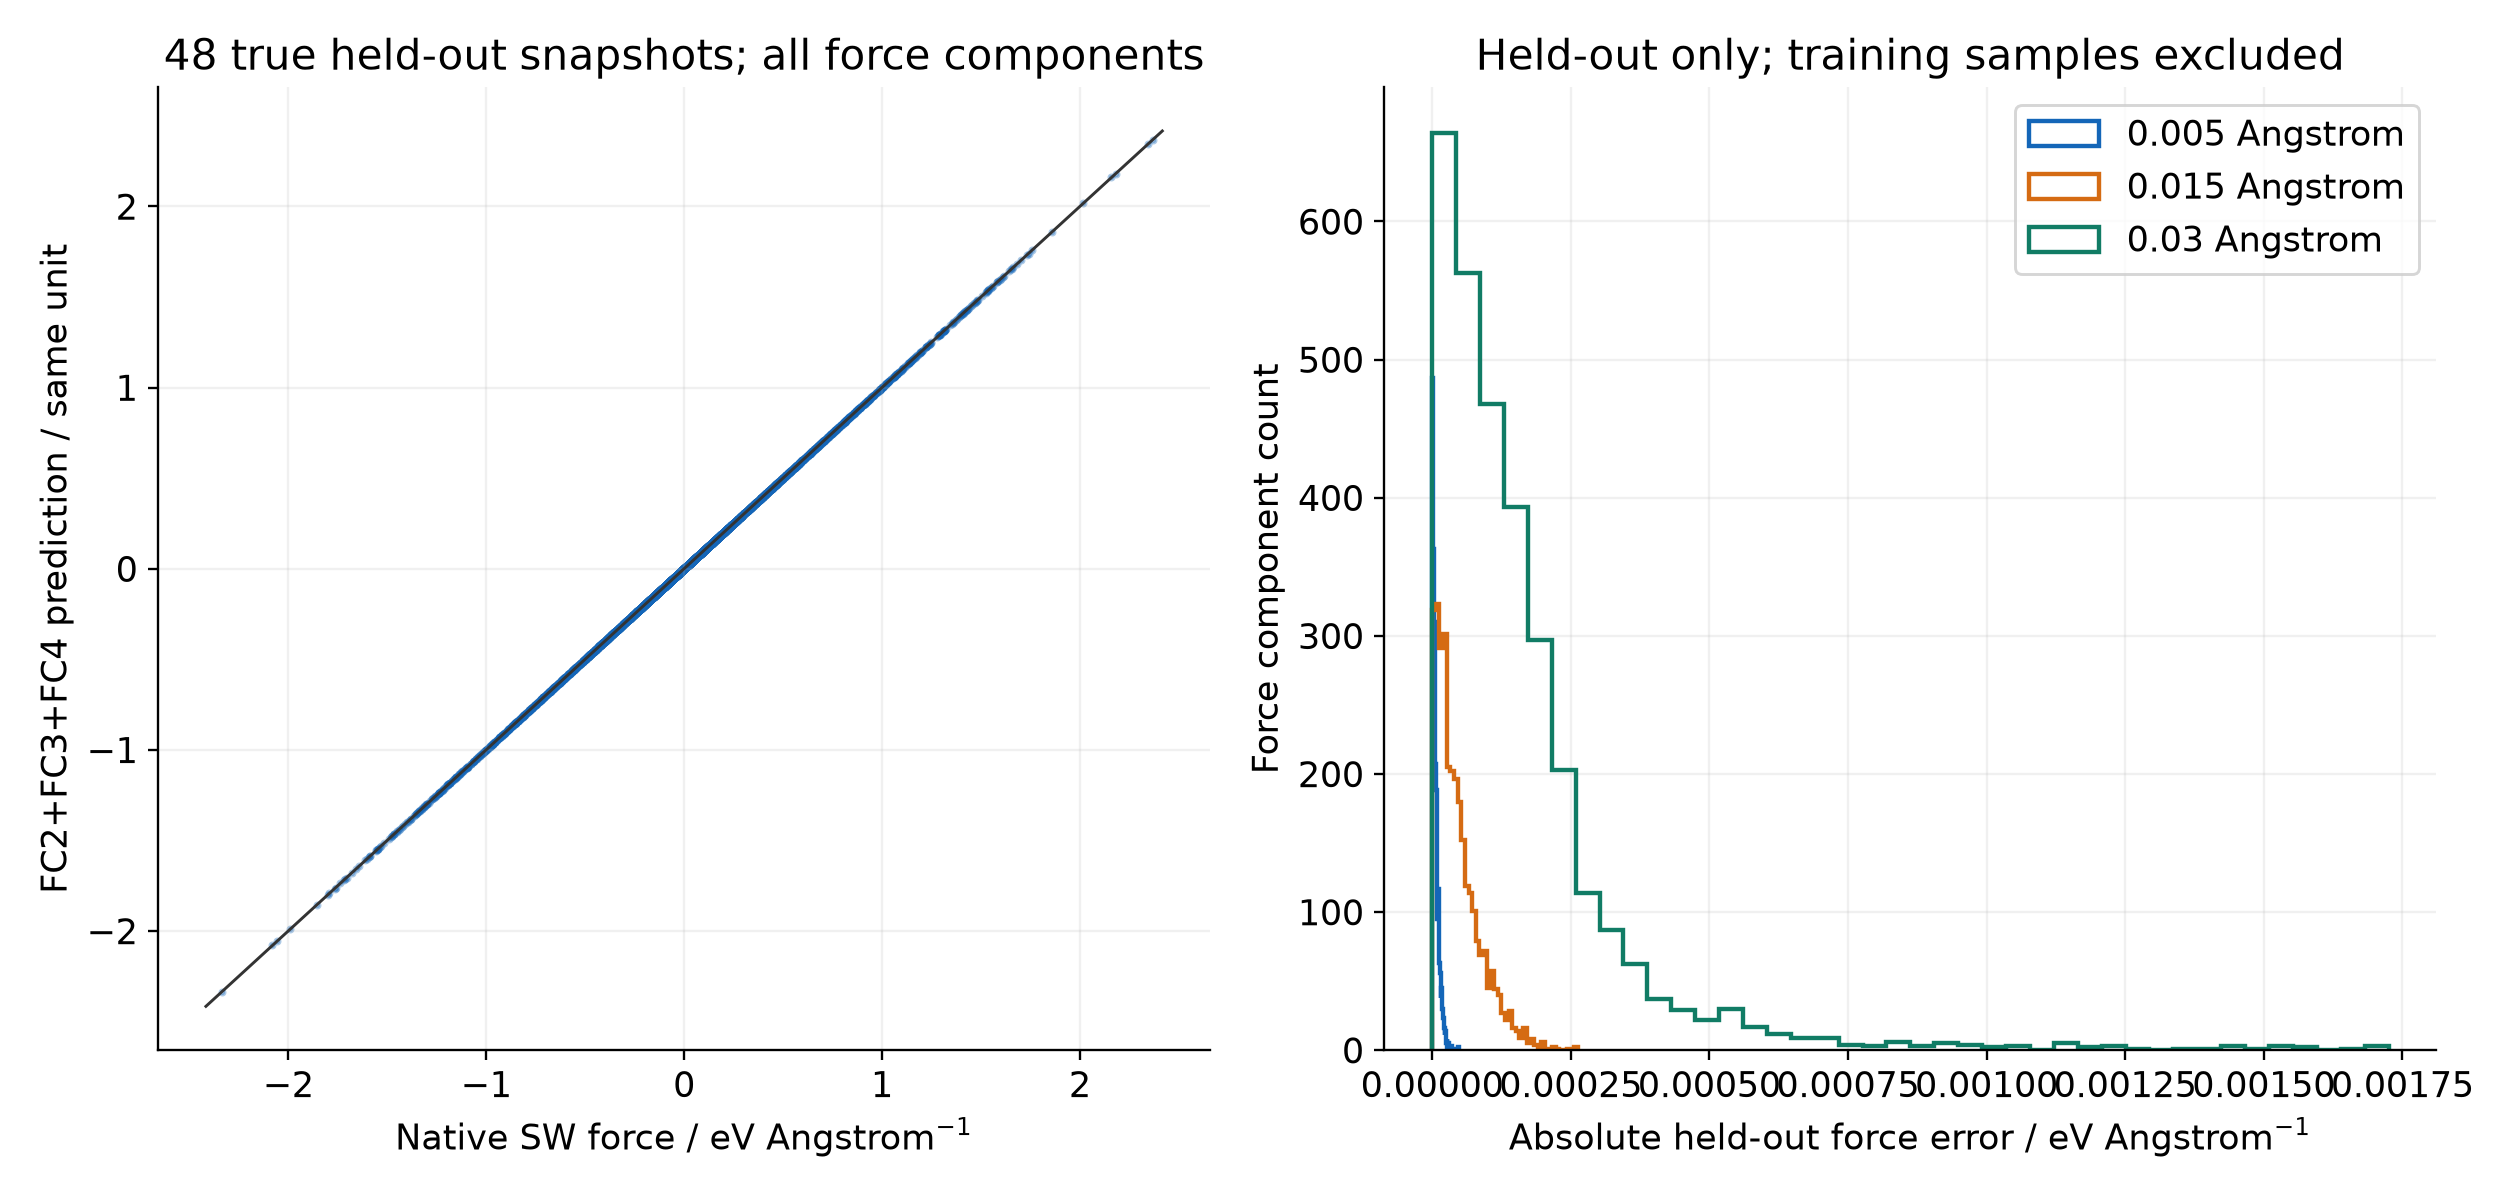
图中只包含48个独立留出快照,训练点未混入散点或误差分布。
5. 为什么还要核对XML、Hessian与能量导数#
analyze_ifcs.py直接读取原生Cartesian XML力常数,按周期超胞和后缀重复指标的阶乘权重计算Taylor力。它还将XML重建的FC2与原生完整Hessian对比,并检查平移约束;对四阶Taylor能量做独立有限差分后,所选分量的力误差最大约1.7×10⁻¹¹eV/Å。
这一步检查的是文件解释、单位和能量/力的一致性,不等于额外算了一次DFT,也不等于对完整SW势做了新的能量有限差分。原子力的物理对照仍来自真实LAMMPS留出数据。
cat analysis/VALIDATION.json
python plot.py
ls figures
本例保留位移范围内的教学对照。继续做RTA热导率、声子线宽或SCPH时,还需检查相应q网格、统计模型、截断范围与稳定性,不能只凭力拟合误差给出这些性质。ALAMODE专题