
ALAMODE 正则化拟合:参数选择与独立测试
用真实 Si64 原子力运行 OLS、Elastic net、Adaptive LASSO,展示完整终端操作、成组数据划分、原生 CV 与外部验证。
阅读本篇目录
当高阶力常数多、训练数据有限时,可以尝试 Elastic net 或 Adaptive LASSO。本例复用Si64 三阶力常数教程的真实经典 SW 原子力,比较正则化与 OLS,并把选参数和最终测试分开。
1. 下载、准备、运行#
资料:ALM 正则化拟合与绘图包。
unzip alamode-regularization-wave192.zip -d alm-regularization
cd alm-regularization
module load alamode/1.5.0
python prepare.py
ls cases
程序建立一个 OLS 对照、两个原生手动 CV 扫描和十二个固定参数模型。完整流程在申请到的 CPU 资源中运行:
bash run.sh
采用 ALAMODE 1.5.0,oneAPI 2024.2、Intel MPI 与 MKL 顺序库;本例限制单线程。正式使用请放入 ALAMODE CPU 作业模板经 Slurm 提交。资料包不自动提交新作业,也不重新运行 GPU 原子力计算。
2. 先把数据分好#
| 数据 | 位移方向 | 快照数 | 用途 |
|---|---|---|---|
| 训练集 | 16 | 96 | 拟合每个模型 |
| 外部验证集 | 8 | 48 | 选择 alpha |
| 独立测试集 | 8 | 48 | 参数选好以后评估预测误差 |
同一方向有正负位移和三个幅度,六个快照始终留在同一组。不能把几乎相同的一对正负位移分别放进训练和测试,造成过于乐观的结果。DFSET 每个原子一行,前三列位移为 Bohr,后三列力为 Ry/Bohr;每个快照 64 行。
head -5 data/DFSET_train
cat SOURCE-DATA.json
此处是实际经典 SW 力数据,没有添加人为噪声,也没有重新做 DFT。它适合学流程,不能据此断言某种拟合方法对所有第一性原理数据都更好。
3. Elastic net 的输入怎么写#
cat cases/enet-a-9/fit.in
完整结构、晶胞、截断和 64 原子位置都在该文件中。与已有高阶拟合相比,主要修改 &optimize:
&optimize
DFSET = DFSET_train
 ICONST = 11
 NDATA = 96
 LMODEL = enet
 MAXITER = 100000
 CONV_TOL = 1e-9
 STANDARDIZE = 1
 DEBIAS_OLS = 0
 L1_RATIO = 0.8
 CV = 0
 L1_ALPHA = 1e-9
/
LMODEL = enet 选择 Elastic net。L1_ALPHA 控制正则化强度,越大越容易压小或置零系数,但也可能损失预测精度。L1_RATIO = 0.8 是 L1 与 L2 项的混合比例,不是验证集占比。改变 STANDARDIZE、基底或位移归一化之后,应重新选 alpha,不能沿用别的设置下的最佳值。
VERBOSITY = 2 位于 &general,让日志写出坐标下降的收敛信息。运行一个模型:
cd cases/enet-a-9
alm fit.in > alm.log
grep 'Convergence achieved' alm.log
ls model.xml model.fcs model.hessian
cd ../..
4. Adaptive LASSO 怎样运行#
cat cases/adaptive-lasso-a-9/fit.in
cd cases/adaptive-lasso-a-9
alm fit.in > alm.log
cd ../..
对应优化输入:
&optimize
DFSET = DFSET_train
 ICONST = 11
 NDATA = 96
 LMODEL = adaptive-lasso
 MAXITER = 100000
 CONV_TOL = 1e-9
 STANDARDIZE = 1
 DEBIAS_OLS = 0
 CV = 0
 L1_ALPHA = 1e-9
/
它会先从训练数据求 OLS 权重,再做加权稀疏拟合;固定 alpha 的流程仅使用训练集生成权重。STANDARDIZE 这一选项在 Elastic net 与 Adaptive LASSO 中的作用不同,不要假定两者的 alpha 数值可以直接代表相同的正则化强度。
5. 原生 CV 的操作与结果怎样看#
cat cases/enet-cv/fit.in
cd cases/enet-cv
alm fit.in > alm.log
cat model.cvset
cd ../..
原生手动验证用 CV = -1,本例关键部分如下:
&optimize
DFSET = DFSET_train
 ICONST = 11
 NDATA = 96
 LMODEL = enet
 MAXITER = 100000
 CONV_TOL = 1e-9
 STANDARDIZE = 1
 DEBIAS_OLS = 0
 L1_RATIO = 0.8
 CV = -1
 DFSET_CV = DFSET_validation
 NDATA_CV = 48
 NSTART_CV = 1
 NEND_CV = 48
 CV_MINALPHA = 1e-9
 CV_MAXALPHA = 1e-4
 CV_NALPHA = 6
 STOP_CRITERION = 100
 SOLUTION_PATH = 1
/
NDATA_CV、NSTART_CV、NEND_CV 必须与验证文件一致。本例明确设为 48、1、48,避免默认行数继承训练集导致输入不一致。
对当前 1.5.0,要注意两个影响读数的细节。第一,原生扫描的 alpha 表不包含指定的最大边界,应以实际 .cvset 第一列为准;它与本例另外准备的六个固定 alpha 不是同一个网格。第二,Adaptive LASSO 内部 CV 会把训练、验证数据合并做初始 OLS 权重,不能把这个内部得分直接当成完全隔离的外部验证。
因此,本例最终按 十二个固定 alpha 模型各自的外部验证误差 选参数,独立测试集始终不参与选择;原生 CV 的输出单独保留,供了解命令用法。
6. 提取预测误差并画图#
完成全部模型后,在包根目录运行:
/public/toolkit/miniconda3/envs/ase-3.29.0/bin/python analyze.py
head -5 analysis/regularization.csv
ls figures
脚本从原生 XML 收缩计算预测力,并与真实原子力比较。不是把训练日志中的残差直接当作测试误差。
| 方法 | alpha | 外部验证 RMSE / eV·Å⁻¹ | 独立测试 RMSE / eV·Å⁻¹ |
|---|---|---|---|
| ols | — | 0.00170893 | 0.00164751 |
| enet | 1e-09 | 0.00170893 | 0.00164751 |
| adaptive-lasso | 1e-09 | 0.00220121 | 0.00218524 |
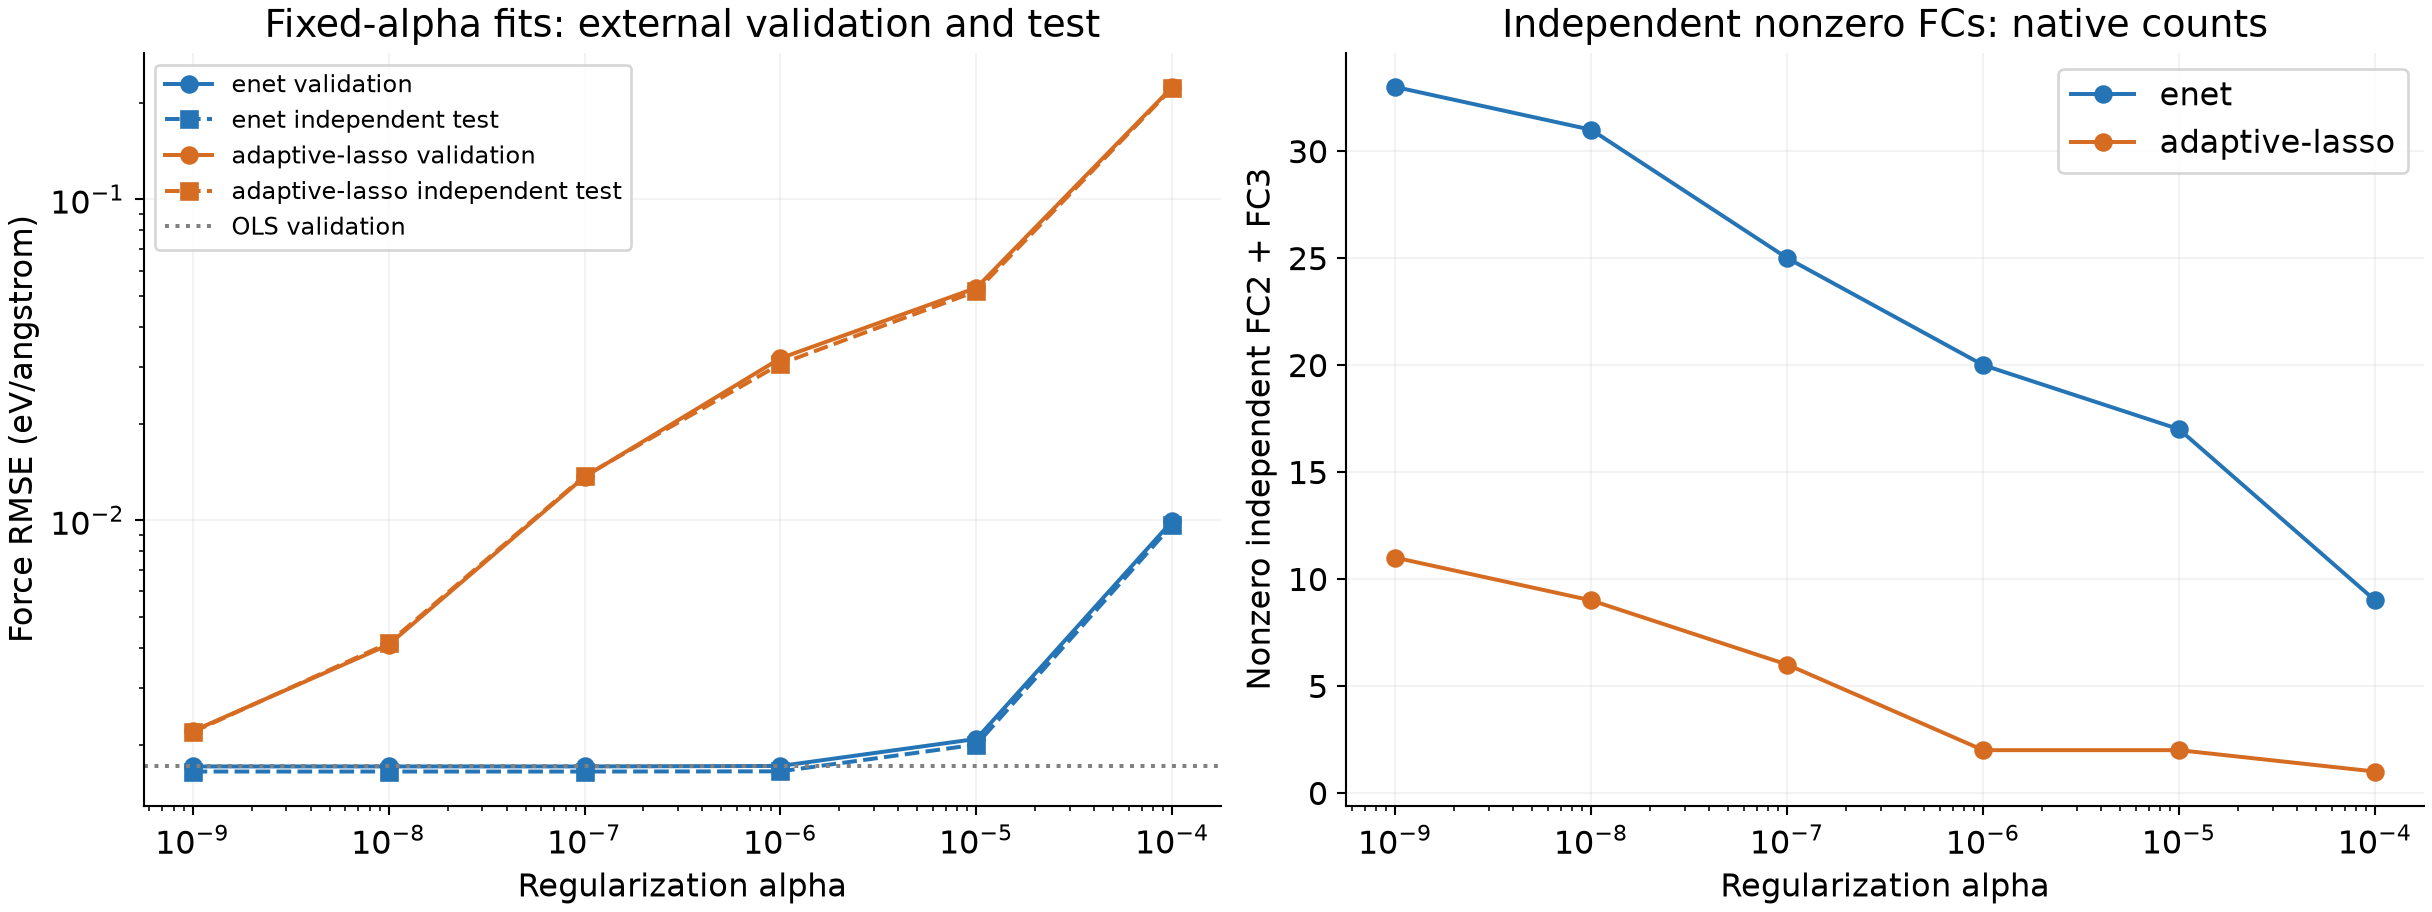
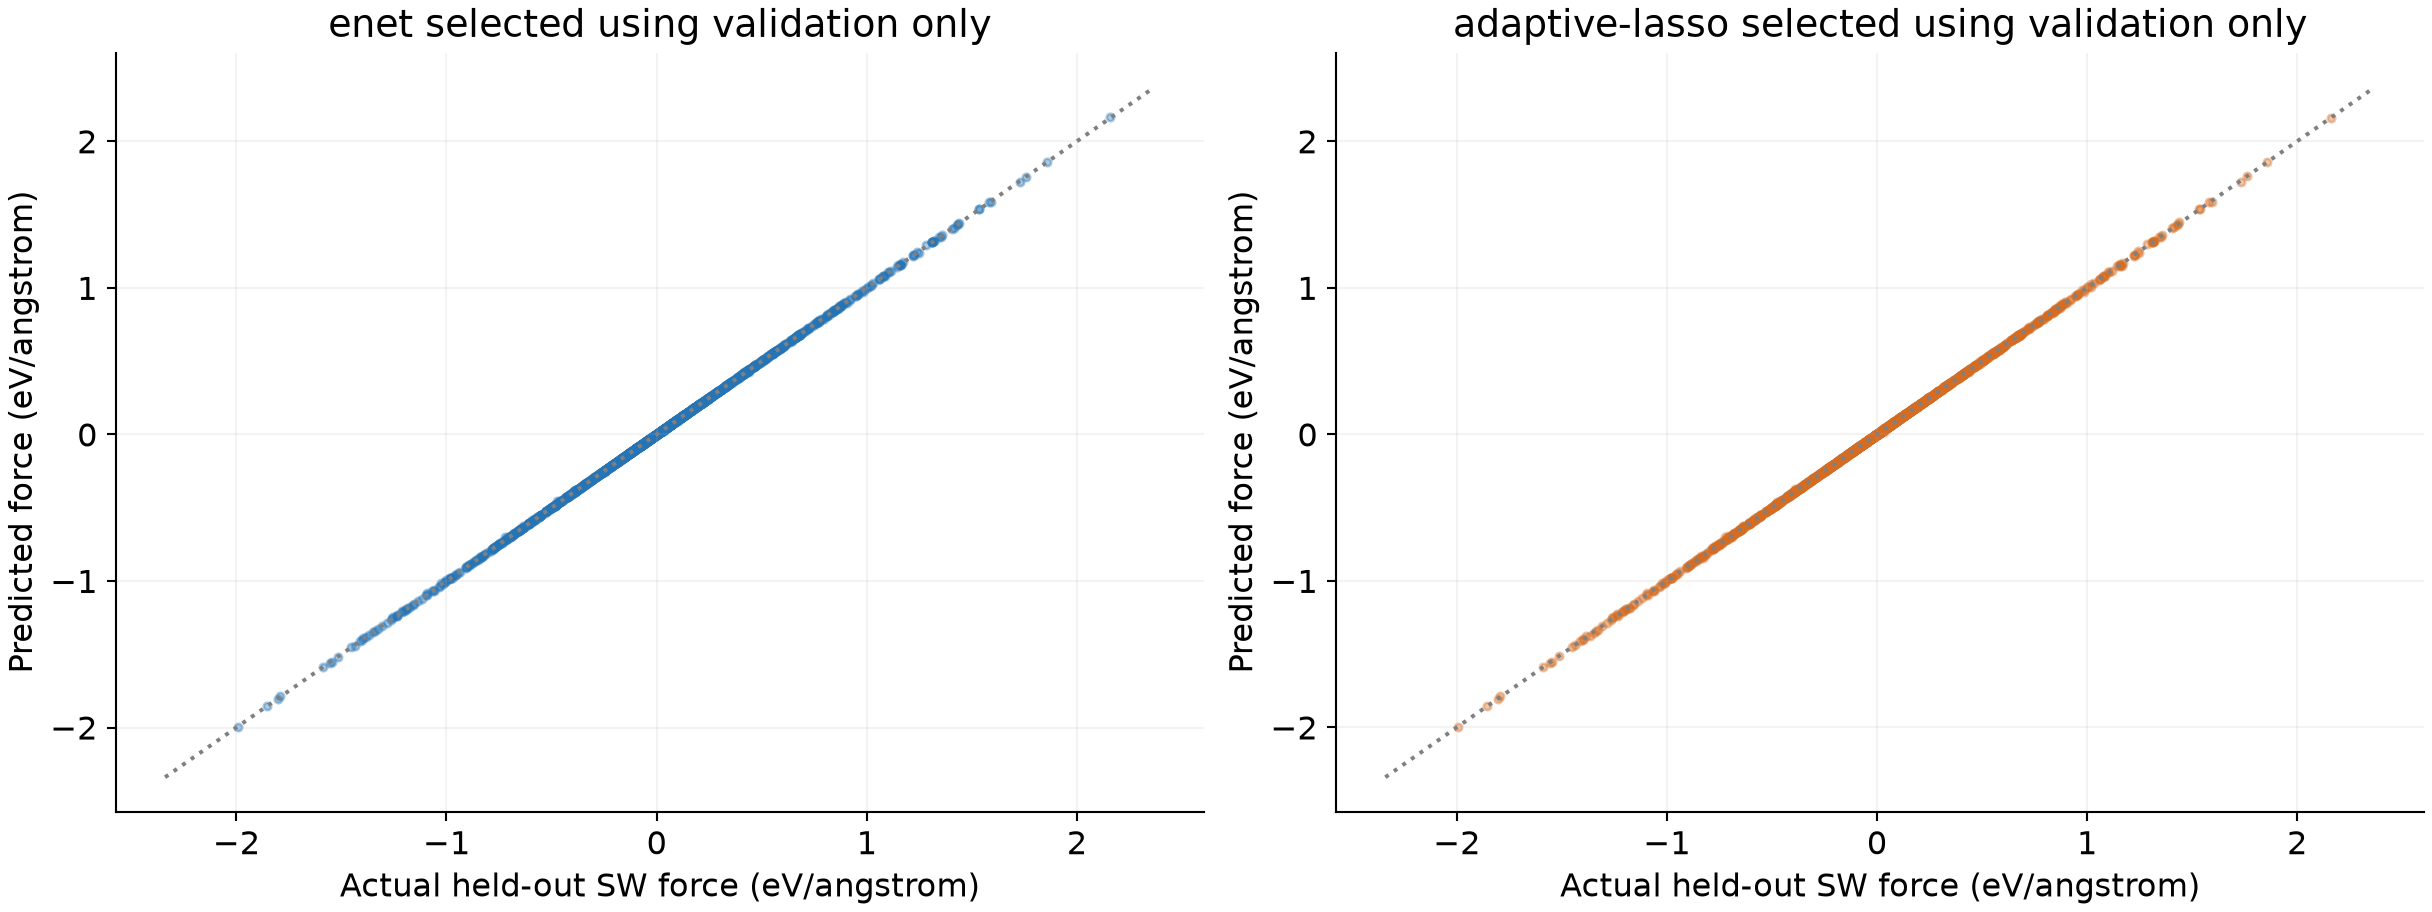
在这套干净 SW 数据中,较弱正则化更合适,OLS 也是重要对照。两个正则化模型的最佳点都落在扫描范围最小端,这说明还没有找到一个位于范围内部、已充分确定的最优 alpha。增大正则化能减少系数,但不能只追求更稀疏而忽略预测误差。
进一步做自己的材料时,先保证训练结构覆盖目标温度和形变,再安排合理的分组与独立测试;不要靠反复查看测试集来调参。完整模式入口见ALAMODE 命令与流程索引。原生参数来源:ALAMODE 输入说明。