
Libxc完整编号实操:能力查询、各阶导数与差分步长
三个已部署版本的完整名称与编号表,两个自旋模式、各阶导数调用条件,以及PBE/BEEF步长实例。
阅读本篇目录
如果你要在自己的程序里调用Libxc,先查对应版本的编号和能力标志,再分配正确的输入/输出数组。本篇提供三个已部署版本的完整编号扫描、原生返回数据汇总和可运行程序。普通VASP用户可先看Si与水分子的VASP输入;宿主输入另见跨软件Libxc调用。
1. 下载、提交、找到结果#
将程序包保存为libxc-api.zip:
unzip libxc-api.zip -d libxc-api
cd libxc-api
sinfo
sbatch job.slurm
模板申请CPU分区整节点,实际最多同时执行8个单线程探针;提交前确认分区可用。编译器为Intel oneAPI2024.2的icx。三个版本前缀写在libraries.json:ABACUS依赖目录的6.2.2、CP2K依赖目录的7.0.0、VASP依赖目录的7.1.2。程序按版本分别编译链接,不替换宿主软件的共享库。绘图用sisl0.16.4环境内的NumPy2.3.5与Matplotlib3.10.8。
cat libraries.json
head analysis/functional-capabilities.csv
cat analysis/SUMMARY.json
ls figures
流程依次是:读取本版xc.h → 编译C调用器 → 枚举可接受名称与唯一编号 → 执行两个自旋模式 → 做独立差分 → 输出CSV和图片。重新运行请解压到新目录,避免混入上一次结果。
2. 先分清名称、编号和库版本#
python3 - <<'PYCODE'
import json
rows = json.load(open('results/7.1.2/catalog.json'))
for row in rows:
    if row['id'] in (18, 101, 130, 497, 498):
        print(row['id'], row['label'], row['canonical_label'])
PYCODE
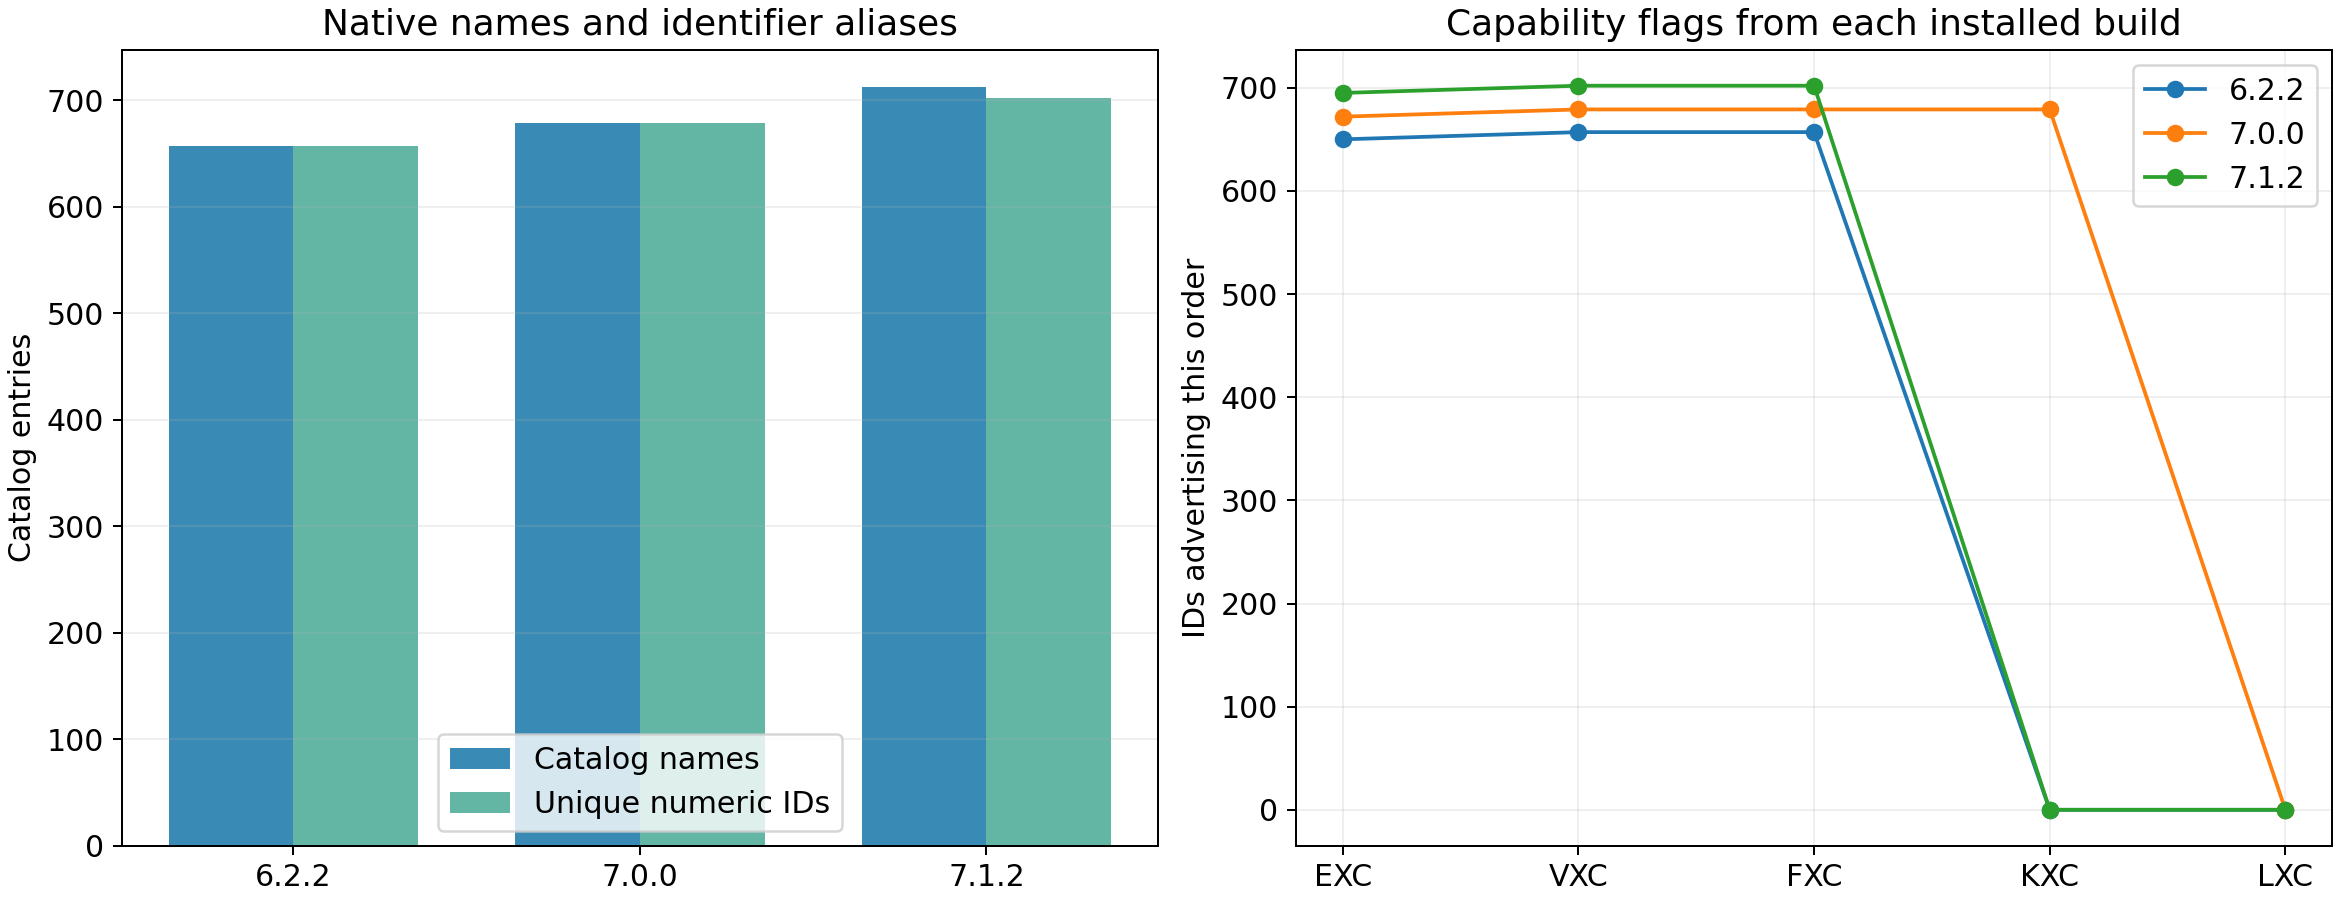
7.1.2目录有712个名称,但只有702个唯一编号;其中一部分名称是同一编号的别名。6.2.2为657个编号,7.0.0为679个。下表按唯一编号统计能力标志,两个自旋模式不重复计数。
| 已链接版本 | 名称数 | 唯一编号数 | EXC | VXC | FXC | KXC | LXC | |---|---:|---:|---:|---:|---:|---:|---:|---:| | 6.2.2 | 657 | 657 | 650 | 657 | 657 | 0 | 0 | | 7.0.0 | 679 | 679 | 672 | 679 | 679 | 679 | 0 | | 7.1.2 | 712 | 702 | 695 | 702 | 702 | 0 | 0 |
EXC是每电子交换关联能,VXC/FXC/KXC/LXC分别对应能量密度的一至四阶导数。表中的0表示本次已链接构建没有声明该阶能力,不是让程序补0返回。泛函文献中存在高阶导数,也不等于当前安装构建一定提供对应接口。
3. 查一个泛函的原生结果#
python3 -m json.tool results/7.1.2/calls/101-spin2.json
这里101是PBE交换,130是PBE关联,497/498是r²SCAN交换/关联;spin1为非自旋,spin2为自旋极化。每个原生JSON保留family、flags、外部参数个数,以及各返回块的shape、values、requested和active_inputs。没有请求的阶数记为null;不能把null当作计算出的0。
实际一阶调用的核心形式如下,完整可编译版本由make_probe.py根据安装头文件生成:
#include <xc.h>
xc_func_type f;
xc_func_init(&f, 101, XC_POLARIZED);
double rho[2] = {0.07, 0.03};
double sigma[3] = {0.0006, 0.0001, 0.0003};
double exc, vrho[2], vsigma[3];
xc_gga_exc_vxc(&f, 1, rho, sigma, &exc, vrho, vsigma);
xc_func_end(&f);
rho按up/down排列,sigma按up-up/up-down/down-down排列,交叉项是梯度点积,不额外乘2。多个点的数组按“第一个点的所有分量、第二个点的所有分量……”排列。高阶对称块的长度还随自旋和求导变量改变;不要把非自旋数组尺寸原样用于自旋计算。
4. 为什么对rho乘exc求导#
Libxc的exc或zk为每电子能量ε。与vrho比较时,应对能量密度求偏导:
非自旋:F = rho × epsilon
自旋:  F = (rho_up + rho_down) × epsilon
本例用三个正密度基准点0.05、0.1、0.2,其他输入按给定比例生成;每次差分只改变一个变量,其他变量固定。所有值采用对应泛函维度的原子单位;1D、2D、3D泛函的密度量纲和物理适用范围不同,不能拿它们的返回能量直接排名。
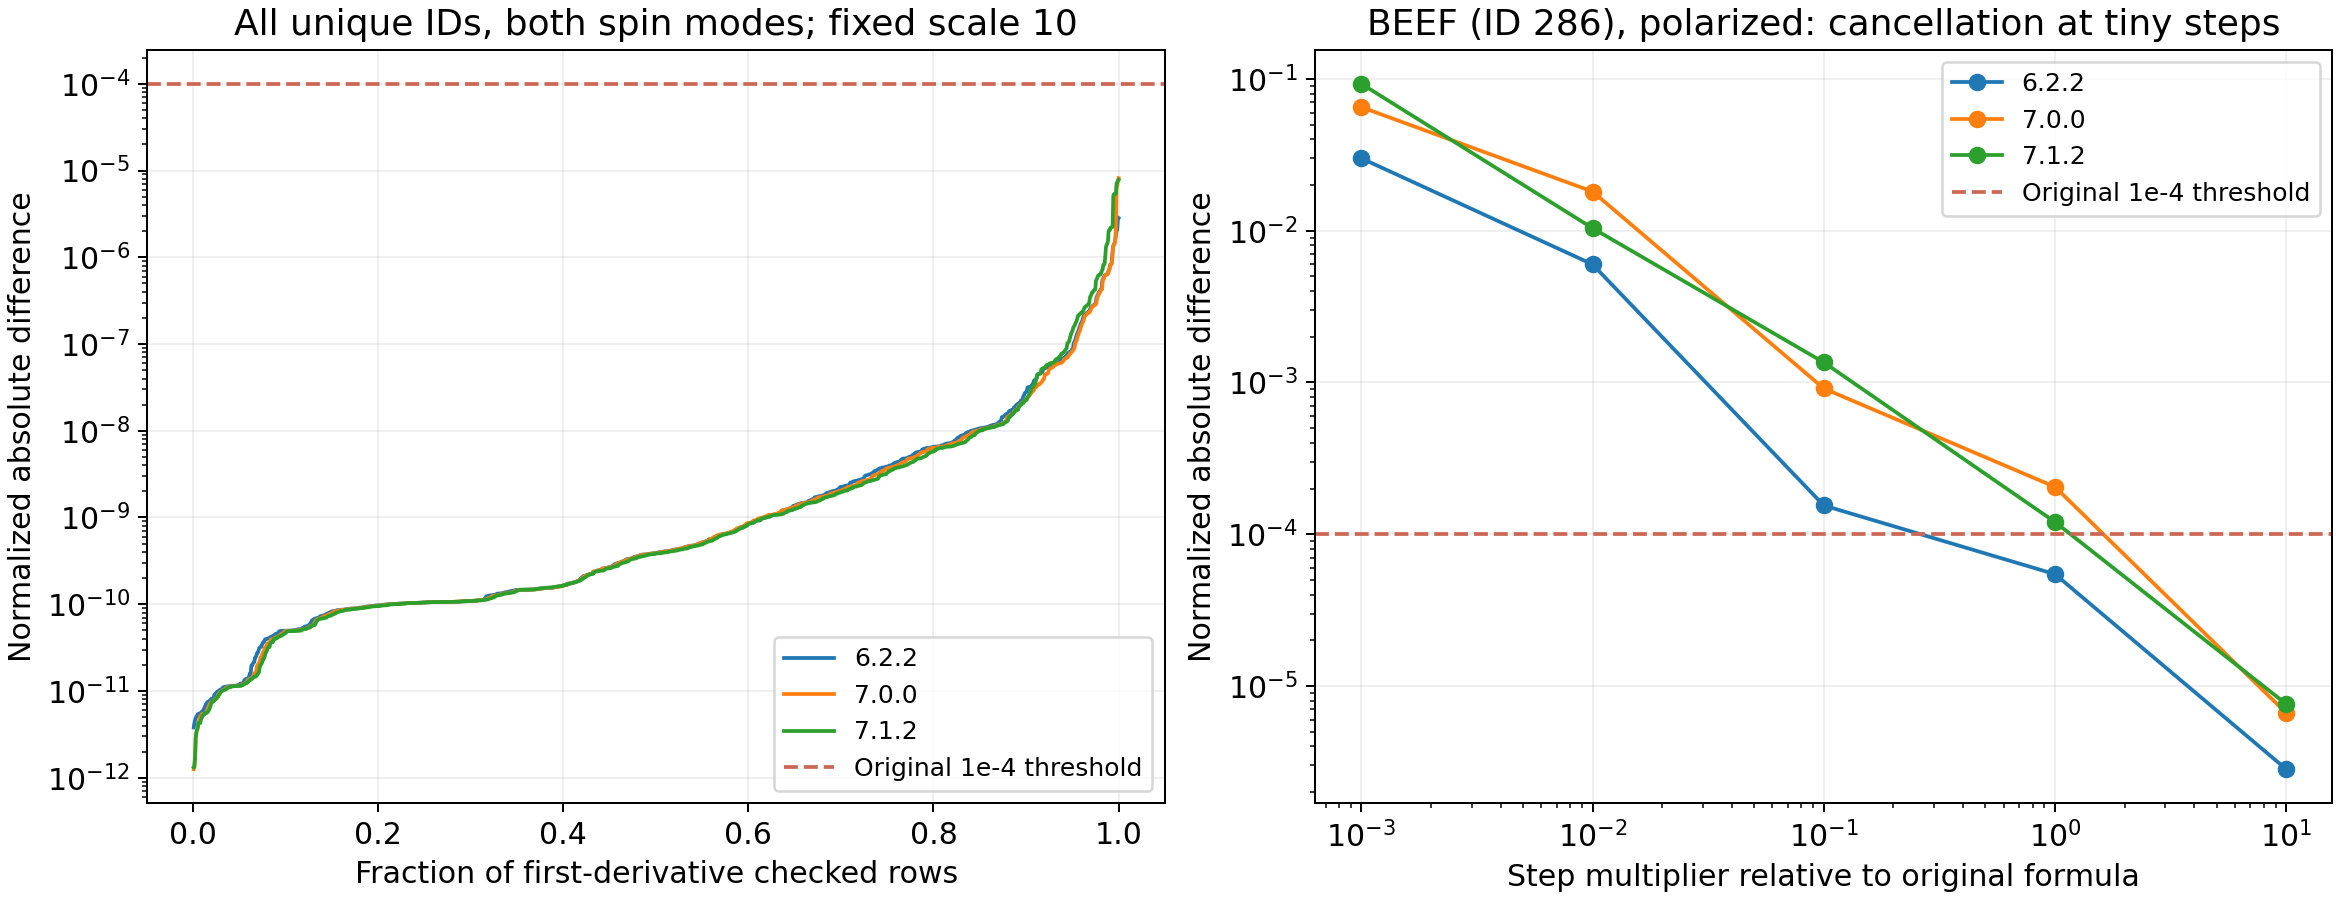
总计4076组“版本×唯一编号×自旋模式”调用。可做能量差分的行数分别为1300、1344、1390;每版另有14行只有势、没有EXC,不能从不存在的能量做差分。统一步长下最大归一化差分别约2.83e-6、8.18e-6、7.81e-6。
h = 10 × (abs(x) × 1e-5 + 1e-8)
归一化差 = abs(FD - analytic) / (1 + abs(FD) + abs(analytic))
上述值小于本例采用的1e-4比较尺度。这个尺度用于接口数值核对,不是材料能量、力或实验精度。
5. BEEF示例:差分步长不能一味缩小#
python3 - <<'PYCODE'
import json
a = json.load(open('diagnostics/STEP-SCAN.json'))
for r in a['rows']:
    if r['id'] == 286 and r['spin'] == 2:
        print(r['version'], r['step_scale'], r['normalized_error'])
PYCODE
辅助扫描对PBE和两个BEEF分量固定比较五种步长倍数,共90次调用;倍数是10、1、0.1、0.01、0.001。实际倍数以STEP-SCAN.json中的step_scale、命令第三参数及文件名为准;辅助原生stdout中的FD_default_step_scale仍记录主扫描默认值10。
以自旋BEEF编号286为例,7.1.2在倍数10时差约7.60e-6,倍数1时约1.20e-4,缩小到0.001时反而约9.30e-2。相近能量相减会放大消减误差,因此应对照一段步长范围,而不是只尝试越来越小的h。本例主扫描对全部编号统一使用倍数10,没有逐泛函挑选各自最小误差。
6. 各阶接口与宿主支持要分别判断#
本例按能力标志请求对应阶数,检查返回值有限性、数组形状和尾部保护区;一阶导数另有独立能量差分。高阶返回值没有逐泛函完成独立高阶差分。需要一/二阶完整矩阵的具体操作,可接着看自旋PBE与非自旋r²SCAN以及自旋meta-GGA。
杂化泛函的精确交换、非局域相关积分、真实材料的自洽响应,还要由宿主程序完成;局域接口返回有限值不能替代这些计算。外部参数在本例保持默认,三个人工密度点也不覆盖所有极端密度、极化和参数组合。选择实际计算路径时请使用宿主调用与支持范围表,不要直接替换已安装软件的Libxc库。
函数签名和能力标志解释见Libxc官方手册;具体可调用阶数以所选安装目录的xc.h和本版原生查询结果为准。