
NEP续训与多卡运行
PbTe八组实际对照:检查点续训、单卡与双卡提交、网络规模和批大小的操作。
阅读本篇目录
本篇接训练与独立测试,使用同一实算下载包。环境为GPUMD5.9.1-NEP4(GCC13.3/CUDA12.9),P10016G和V10016G;分析环境为sisl0.16.4。
1. 从上次结果继续训练#
包内两条基线分别训练500代,再从nep.restart续训500代。自动脚本已完成以下步骤;手动操作时,在分配到GPU的作业中执行:
mkdir phase2
cp phase1/train.xyz phase1/test.xyz phase1/nep.in phase1/nep.restart phase1/nep.txt phase2/
cd phase2
nep > native.out
必须复制nep.restart;nep.txt用于保留模型和核对结构。元素顺序、截断半径、描述符维数、隐层等应保持一致。不要拿修改了neuron或basis_size的新模型直接接旧检查点。
这里的续训恢复优化分布均值/方差,不恢复完整随机状态及全局代数。第二段generation 500是再运行500代;第二段loss.out仍从50、100等局部代数开始。把曲线横轴加500只是便于展示,不能声称等同于无中断1000代。
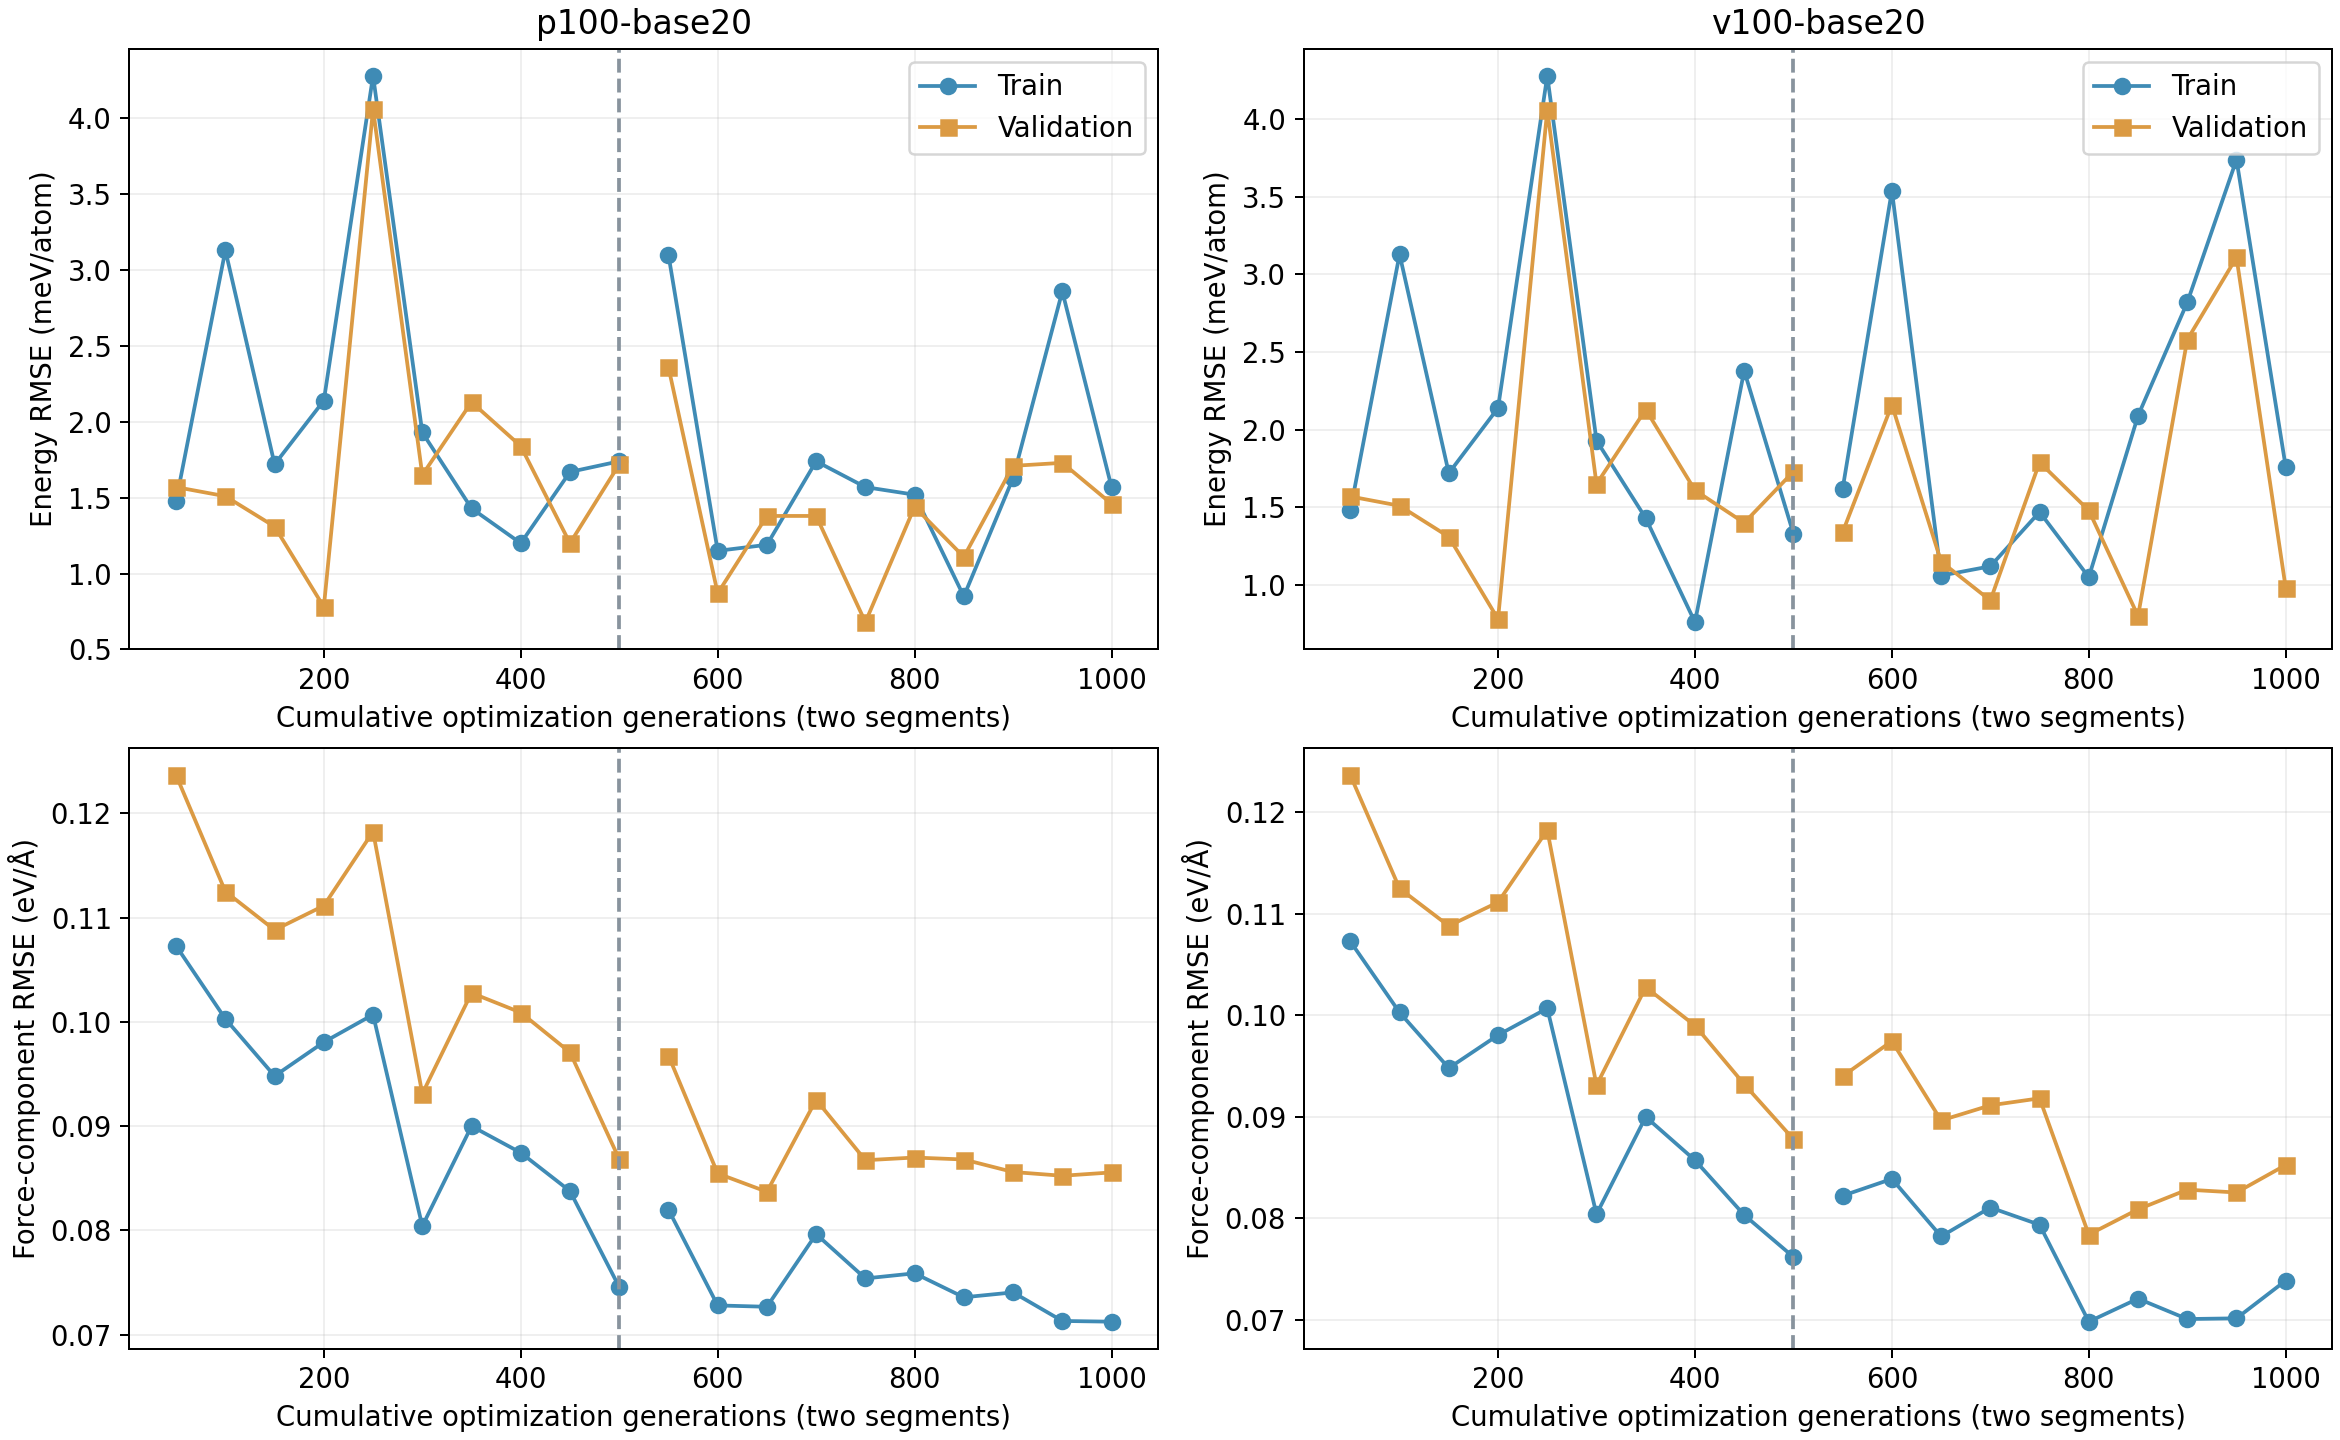
cat cases/p100-base20/RESTART-TRANSFER.json
head cases/p100-base20/phase2/loss.out
这两个文件在自己任务完成后可查看。重新从头训练应新建工作目录,避免旧检查点触发续训;保留已有结果更便于比较。
2. 一卡一个任务,还是一个任务两卡#
本例多数为每卡独立一个任务,另设两条双卡对照。NEP双卡运行是单个程序读取两张分配到的GPU,不是启动两个训练进程。
python3 prepare.py
python3 make_jobs.py
cd cases/p100-two-gpu
cat job.slurm
sbatch job.slurm
完整双卡模板:
#!/bin/bash
#SBATCH --job-name=nep-example
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=2
#SBATCH --gres=gpu:p100-16g:2
#SBATCH --time=00:30:00
#SBATCH --output=nep-%j.out
set -eo pipefail
source /etc/profile
module purge
module load gpumd/5.9.1-p100
export OMP_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1 MKL_NUM_THREADS=1
cd "$SLURM_SUBMIT_DIR"
python3 -B ../../run_case.py
若已经生成cases/,不要再次运行prepare.py;直接进入对应目录提交。V100双卡在cases/v100-two-gpu,脚本加载gpumd/5.9.1-v100。查看程序实际使用卡数:
rg 'Number of devices' phase1/native.out
没有rg时可用grep 'Number of devices' phase1/native.out。不需要手动设置CUDA_VISIBLE_DEVICES覆盖调度系统分配,也不使用mpirun -np 2 nep。
3. 怎样比较batch、网络和损失权重#
本次8组对照的实际验证集结果:
| 对照目录 | GPU | 神经元 | batch | λE | 验证E(meV/atom) | 验证F(eV/Å) |
|---|---|---|---|---|---|---|
| p100-base20 | 1 | 20 | 15 | 1.0 | 1.46140 | 0.08556 |
| p100-neuron10 | 1 | 10 | 15 | 1.0 | 1.53892 | 0.08373 |
| p100-minibatch5 | 1 | 20 | 5 | 1.0 | 0.92307 | 0.09593 |
| p100-two-gpu | 2 | 20 | 15 | 1.0 | 1.72226 | 0.08684 |
| v100-base20 | 1 | 20 | 15 | 1.0 | 0.97302 | 0.08526 |
| v100-neuron30 | 1 | 30 | 15 | 1.0 | 0.95461 | 0.09859 |
| v100-energyweight | 1 | 20 | 15 | 0.5 | 1.17647 | 0.09468 |
| v100-two-gpu | 2 | 20 | 15 | 1.0 | 1.73276 | 0.08780 |
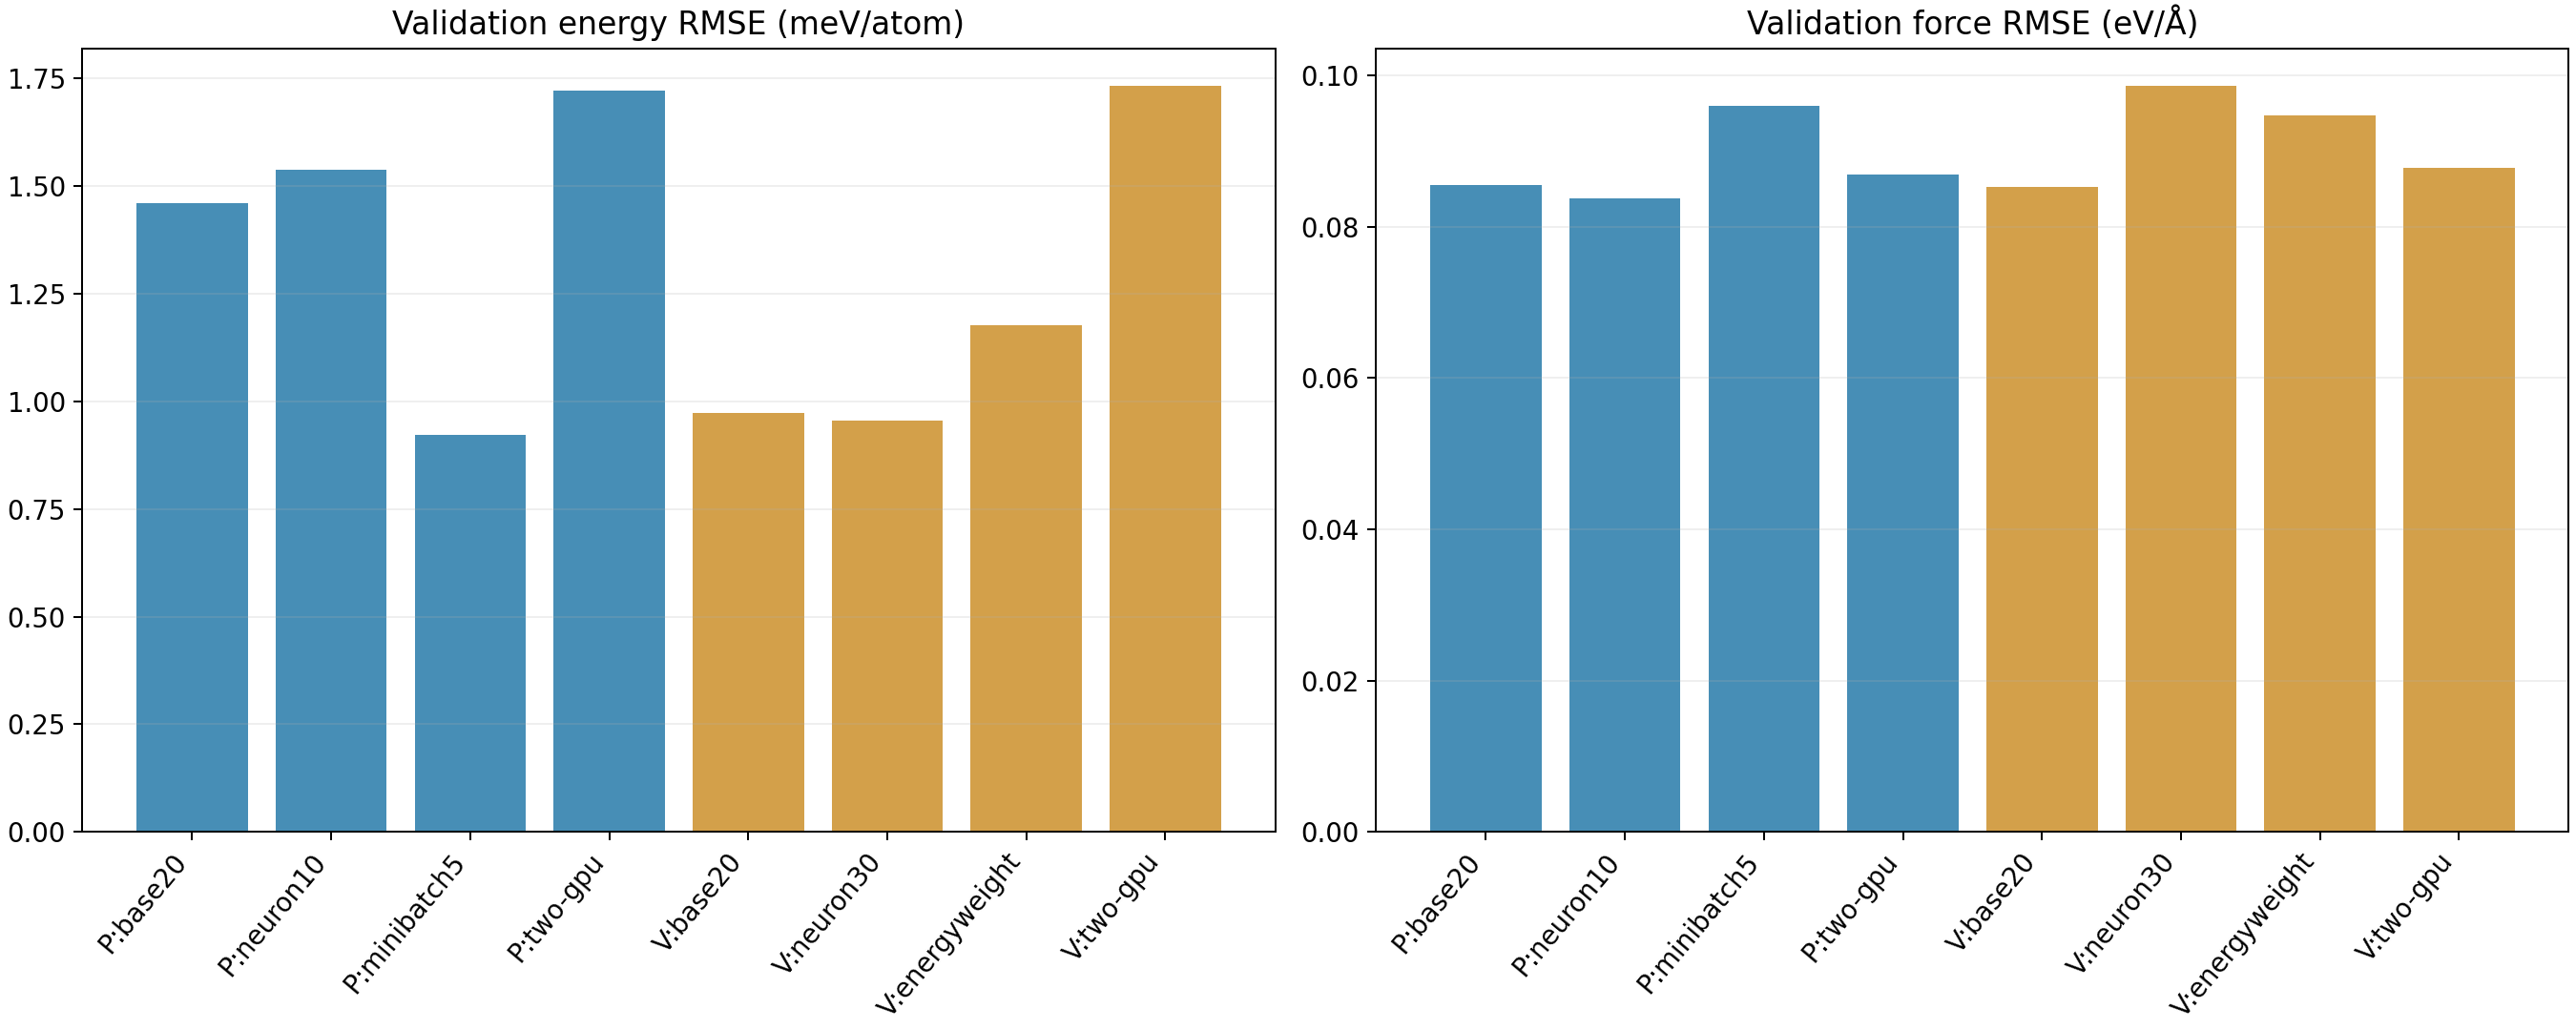
neuron、batch、lambda_e各只改变一个因素的对照,以目录设置为准。基线是500+500代,其他对照500代,因此不能把表中差异都归因于硬件或某一个参数。尤其不能据单次训练说P100比V100更准确;即使种子相同,GPU浮点计算和优化轨迹仍可能不同。
4. 分析自己的任务#
# 在解压根目录,全部8组任务完成后
bash analysis.sh --new
ls analysis-new figures-new
小样本下双卡未必更快,本例用于展示资源申请和原生多GPU运行,不能外推为生产加速比。选择最终超参数应看验证集,再对预留独立测试集做一次冻结后的评价。
续训文件规则见GPUMD官方nep.restart说明,结构参数含义见nep.in说明。