
NEP训练与独立测试
用PbTe实际训练说明数据划分、完整NEP4输入、Slurm提交、独立预测、RMSE与画图。
阅读本篇目录
本文在鸢算科技集群实际训练了8组PbTe模型。先固定训练/验证/独立测试数据,再训练,最后冻结模型预测。软件为GPUMD5.9.1的NEP4,GCC13.3、CUDA12.9编译;实算覆盖P10016G与V10016G。分析用sisl0.16.4模块内的Python、NumPy和Matplotlib。
1. 下载、查看结构和已有结果#
下载数据、实际模型与完整脚本。将下载的ZIP保存为gpumd-nep-heldout-wave209.zip后:
unzip gpumd-nep-heldout-wave209.zip -d nep-PbTe
cd nep-PbTe
head -n 5 source-data/PbTe25.xyz
bash analysis.sh
ls analysis figures
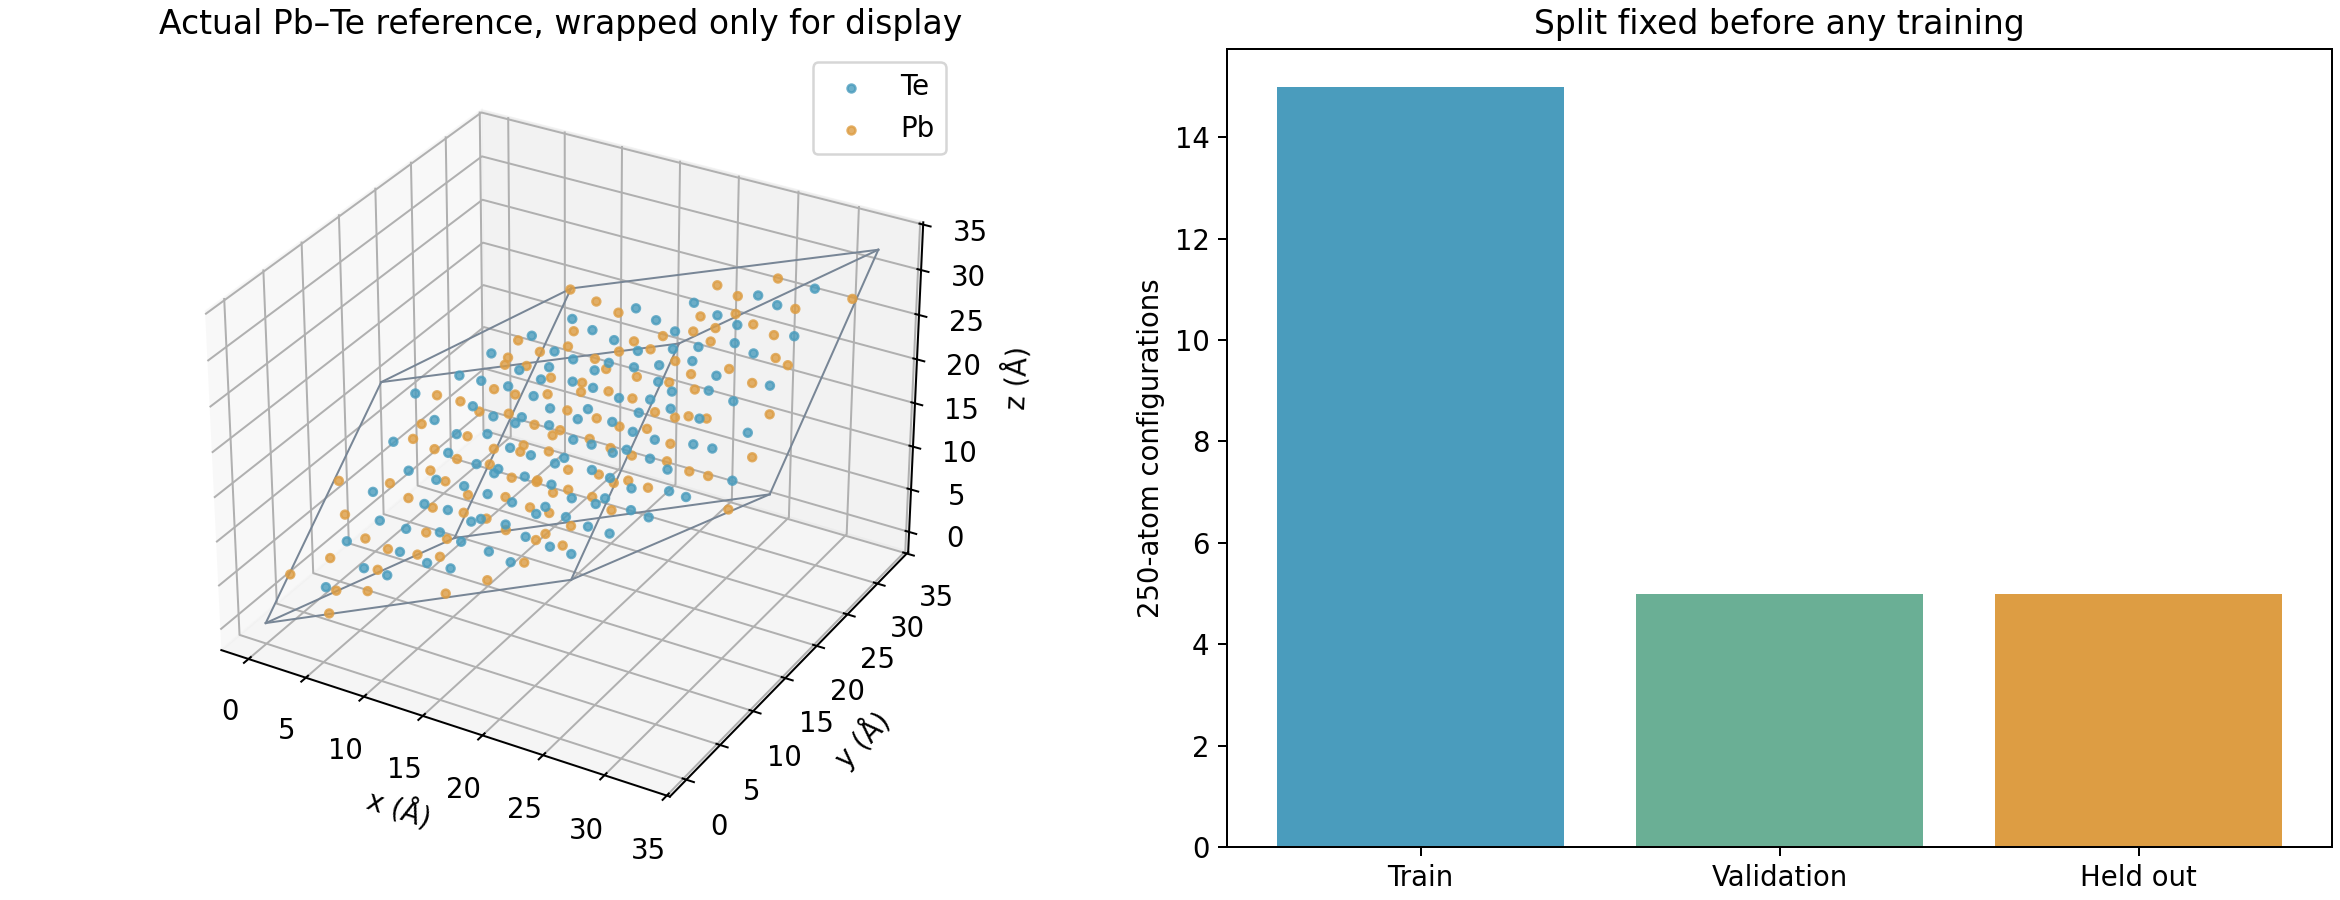
程序会明确打印正在读取包内实际参考模型,生成analysis/model-metrics.csv和四张PNG;这一步不训练、不占GPU。数据共有25帧,每帧250原子,来自GPUMD官方PbTe示例。完整坐标在XYZ,图片只为便于观察将坐标折回晶胞,不改训练文件。
2. 先分数据,再训练#
python3 prepare.py
cat SPLIT.json
python3 make_jobs.py
cat cases/p100-base20/base-nep.in
prepare.py先检查25帧结构不重复,用固定种子20261105生成15帧训练、5帧验证、5帧独立测试。完整帧号、结构哈希均在SPLIT.json。
| 名称 | 用途 | 是否进入训练目录 |
|---|---|---|
| training.xyz | 优化模型参数 | 复制成train.xyz |
| validation.xyz | 训练过程监控和参数选择 | 复制成test.xyz |
| heldout.xyz | 冻结模型后独立评价 | 不在训练阶段提供 |
**原生文件名test.xyz在本流程中表示验证集。**如果据它选神经元数、训练代数等,它就不能再充当最终独立测试集。本例是同一小数据源的随机快照拆分,不代表独立轨迹或不同材料的泛化;正式项目应按轨迹、温度区间、结构类别等分组。
3. 完整nep.in与提交#
P100基线的首段输入:
version 4
type 2 Te Pb
cutoff 6.0 4.0
n_max 4 4
basis_size 4 4
l_max 4 2 1
neuron 20
population 30
batch 15
lambda_e 1.0
lambda_f 1.0
lambda_v 0.0
seed 13579
generation 500
output_interval 50
type 2 Te Pb的元素顺序必须与模型一致;cutoff两值分别为径向/角向截断半径,单位Å。n_max、basis_size、l_max控制描述符,neuron控制隐层规模。batch 15使用15个训练构型;population是每代优化种群数,不能与batch混淆。此数据仅有能量和力标签,没有virial,因此lambda_v 0.0。
cd cases/p100-base20
sbatch job.slurm
squeue -u "$USER"
脚本每个任务运行一个nep进程,P100基线使用一张GPU。程序先训练500代,再由检查点续训500代,最后单独预测三份数据。不要把nep直接放在登录终端运行。其他对照目录同样在其目录内sbatch job.slurm;V100目录已使用对应分区和模块,按账号资源权限选择。
4. 冻结模型后怎样预测#
下载包的run_case.py自动建立独立预测目录。其核心操作如下,放在已申请GPU的作业脚本中执行:
mkdir prediction-heldout
cp heldout.xyz prediction-heldout/train.xyz
cp phase2/nep.txt prediction-heldout/nep.txt
awk '$1 ~ /^(version|type|cutoff|n_max|basis_size|l_max|neuron|lambda_v)$/' base-nep.in > prediction-heldout/nep.in
printf 'prediction 1\n' >> prediction-heldout/nep.in
cd prediction-heldout
nep > native.out
预测模式虽然读取的文件名是train.xyz,这里的内容是独立heldout数据。它不会再次训练。不能只写prediction 1:元素和描述符结构参数也要与nep.txt匹配。
5. 提取数据、画图、看误差#
完整8组任务完成后,回到解压根目录:
bash analysis.sh --new
head -n 6 analysis-new/model-metrics.csv
ls figures-new
--new明确读取自己新训练的cases/,结果单独写入analysis-new/与figures-new/。自带参考仍可用不带参数的bash analysis.sh查看。
| 实际基线 | heldout能量RMSE(meV/atom) | 力分量RMSE(eV/Å) |
|---|---|---|
| P100单卡,20神经元,500+500代 | 1.161291 | 0.063564 |
| V10016G单卡,同一设置 | 1.432286 | 0.064950 |
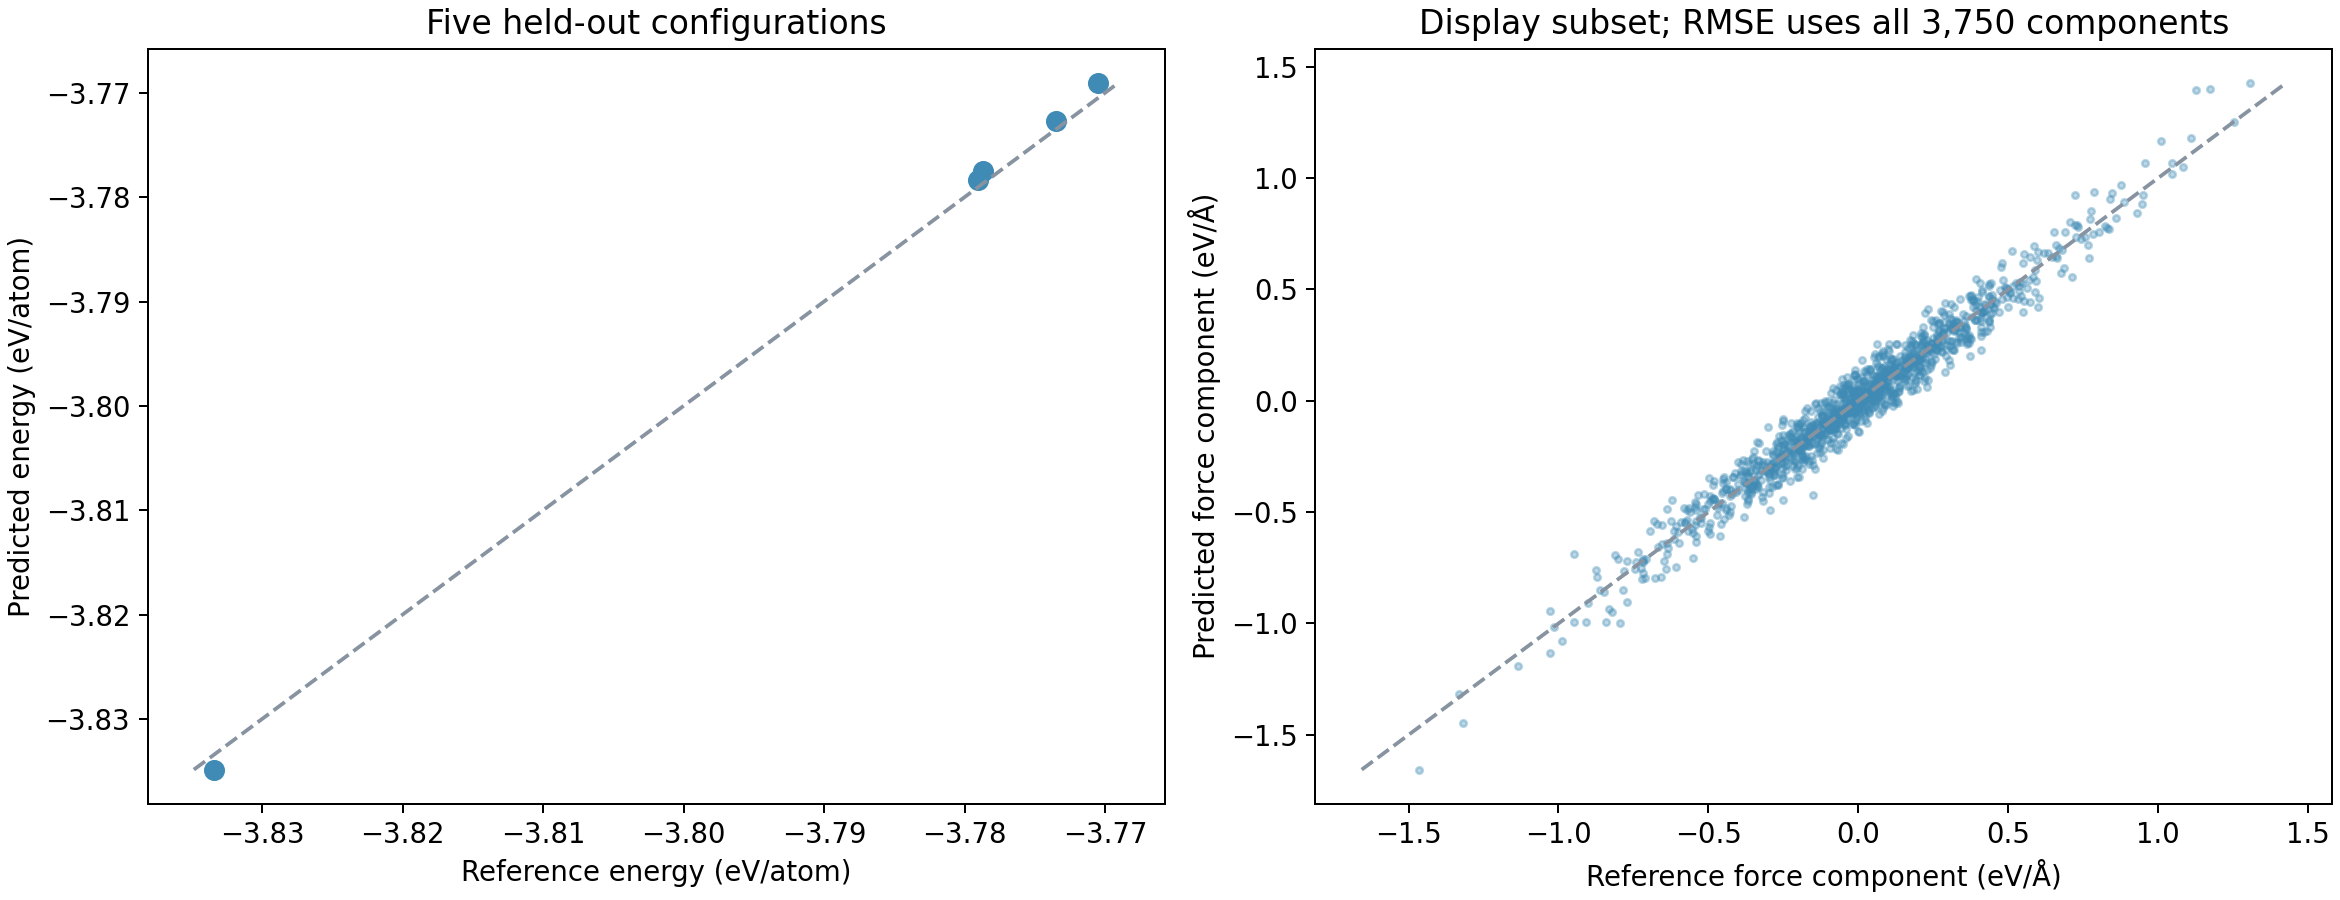
能量使用每原子值,力误差由全部原子三个分量计算;图中力点为显示抽样,RMSE使用全部3750个分量。原生energy_train.out两列为预测/参考,force_train.out前3列预测、后3列参考。输出文本有舍入,脚本以原XYZ完整精度标签计算指标。
小数据、短训练用于理解操作,不能只根据低能量误差就判断势函数可用于动力学。至少还要检查力、目标结构范围、MD稳定性及需要的物性。
6. virial为零不等于预测正确#
head reference-data/p100-base20/prediction-heldout/virial_train.out
本数据没有virial真值,原生参考列-1000000是缺失标记。loss.out中的virial项为零也不能解读为零误差。需要应力/virial联合训练时,继续看VASP标签转换与联合训练。
参数、续训和多卡见下一篇。原生参数定义可对照GPUMD官方nep.in说明。