
NEP能量、力与virial联合训练
Si16十四组实算:联合训练完整输入、λV和网络对照、独立方向测试、GPUMDkit绘图。
阅读本篇目录
本篇接VASP标签转换,用实际Si16能量、力和virial训练NEP4,共14个参数/硬件对照。环境为GPUMD5.9.1(GCC13.3/CUDA12.9),P10016G和V10016G;分析用sisl0.16.4,辅助绘图用GPUMDkit1.5.8。下载实际数据、模型与脚本。
1. 先看参考,再提交自己的训练#
unzip gpumd-nep-virial-wave210.zip -d nep-Si
cd nep-Si
bash analysis.sh
python3 prepare_cases.py
python3 make_jobs.py
cd cases/p100-n20-v0p1
sbatch job.slurm
第一条分析命令查看包内真实模型,输出到analysis/与figures/;后续在cases/建立新工作区。每个作业单卡运行一个NEP进程,两个two-gpu目录是双卡对照。不要直接在登录节点运行nep。
2. 这次使用的完整nep.in#
version 4
type 1 Si
cutoff 5.5 4.0
n_max 4 4
basis_size 4 4
l_max 4 2 1
neuron 20
population 30
batch 13
lambda_e 1.0
lambda_f 1.0
lambda_v 0.1
seed 13579
generation 1000
output_interval 50
lambda_e、lambda_f、lambda_v控制三类误差在训练中的权重,不能理解为三种数据单位相同。训练数据有真实virial,才有讨论lambda_v的基础。batch 13对应13个训练构型,验证集6帧在原生test.xyz中。
同一平台单卡使用10/20神经元与λV=0/0.1/1交叉对照,共6组,再加一组20神经元、λV=0.1的双卡对照;两个GPU平台合计14组。每组1000代、固定种子13579、每50代输出。两条单卡20神经元、λV=0.1基线在训练前已指定用于最终独立测试;其他对照只比较训练/验证结果。
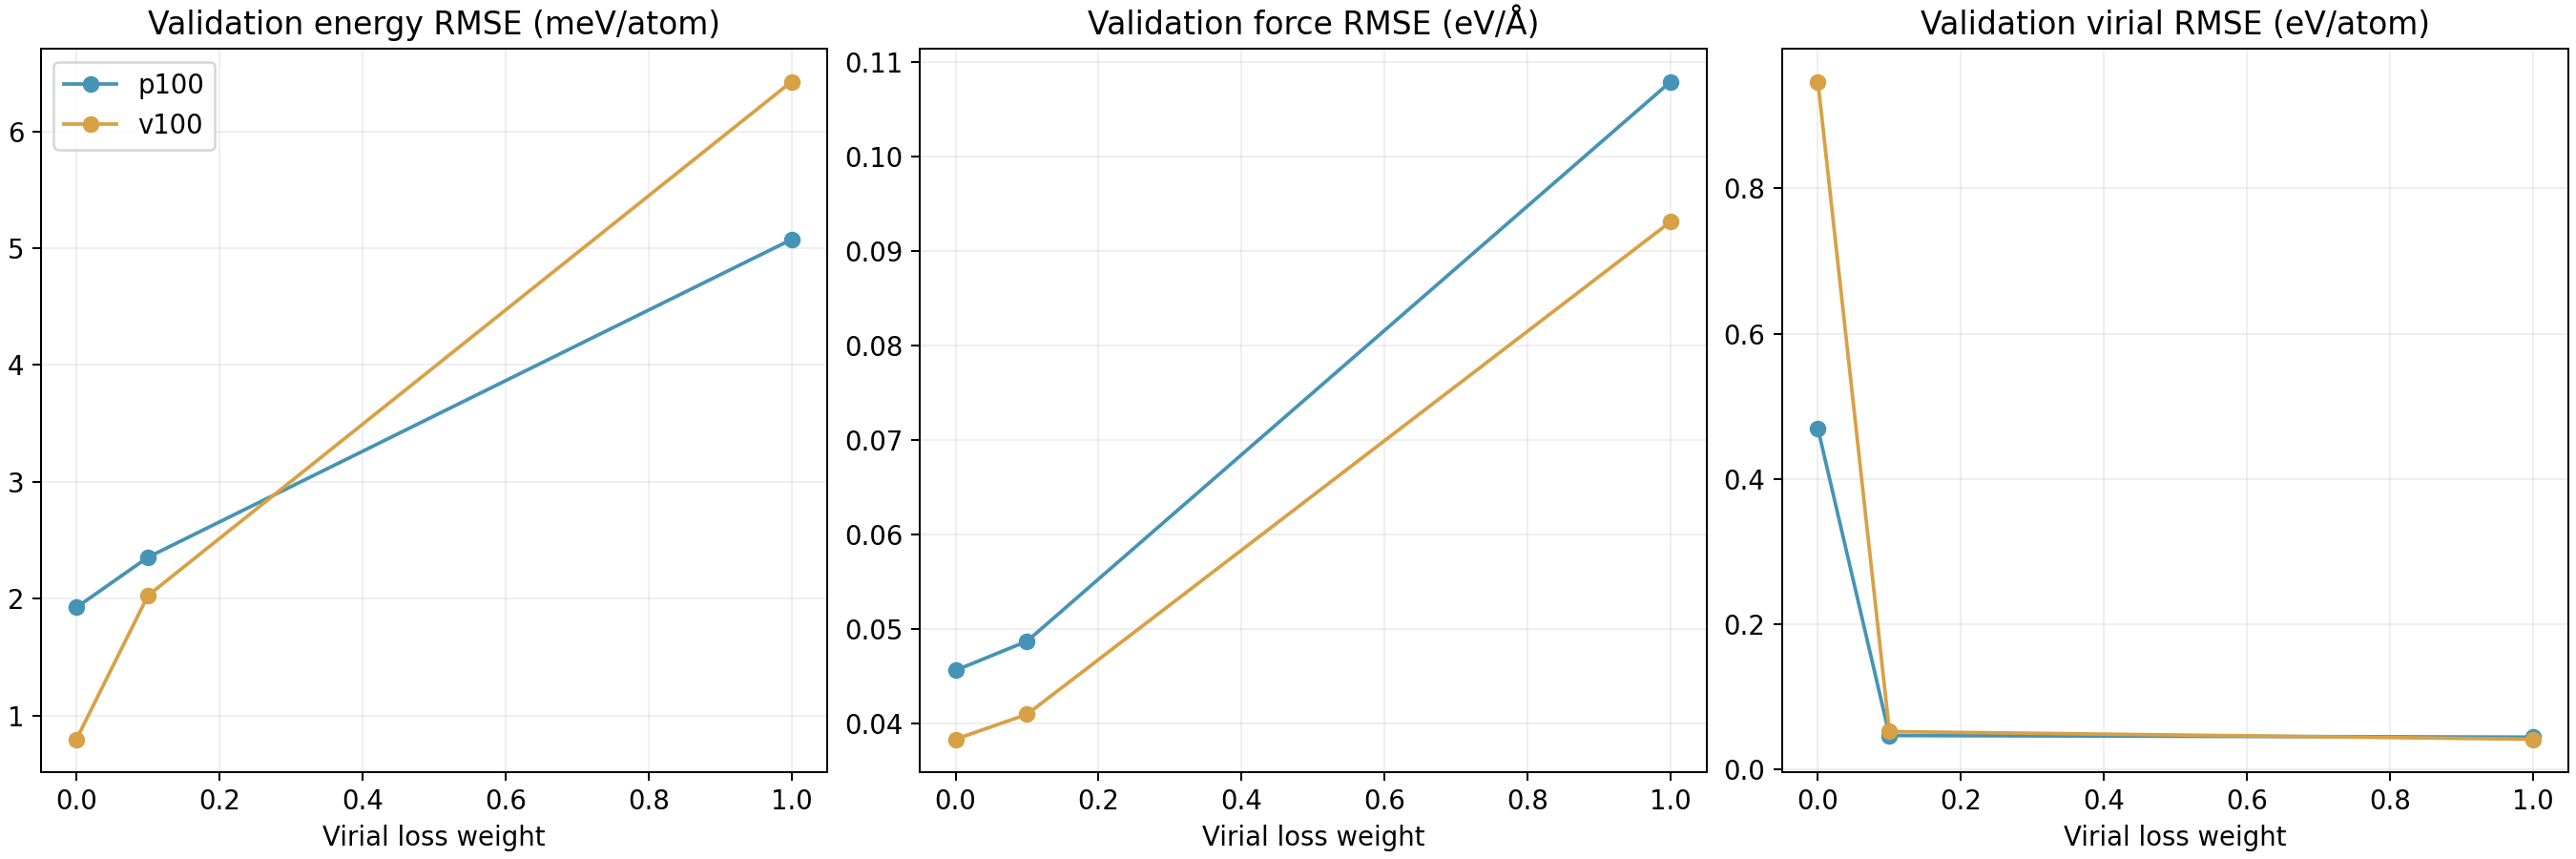
增加λV不保证所有指标同时改善,应按目标用途在验证集权衡。最终heldout不能反复用于挑选权重。
3. 查看三类输出,先分清单位#
在任务完成的目录中:
head training/energy_train.out
head training/force_train.out
head training/virial_train.out
head training/stress_train.out
| 原生文件 | 预测与参考 | 单位 |
|---|---|---|
| energy_train.out | 第一列预测、第二列参考 | eV/atom |
| force_train.out | 前三列预测、后三列参考 | eV/Å |
| virial_train.out | 前六列预测、后六列参考 | eV/atom |
| stress_train.out | 前六列预测、后六列参考,压缩正 | GPa |
六分量顺序为xx yy zz xy yz zx。输入virial是整胞eV,输出virial是eV/atom,比较时要乘除正确原子数。本例16原子,分析脚本将原始整胞标签除16后与原生输出比较,再由原晶胞体积换算应力。
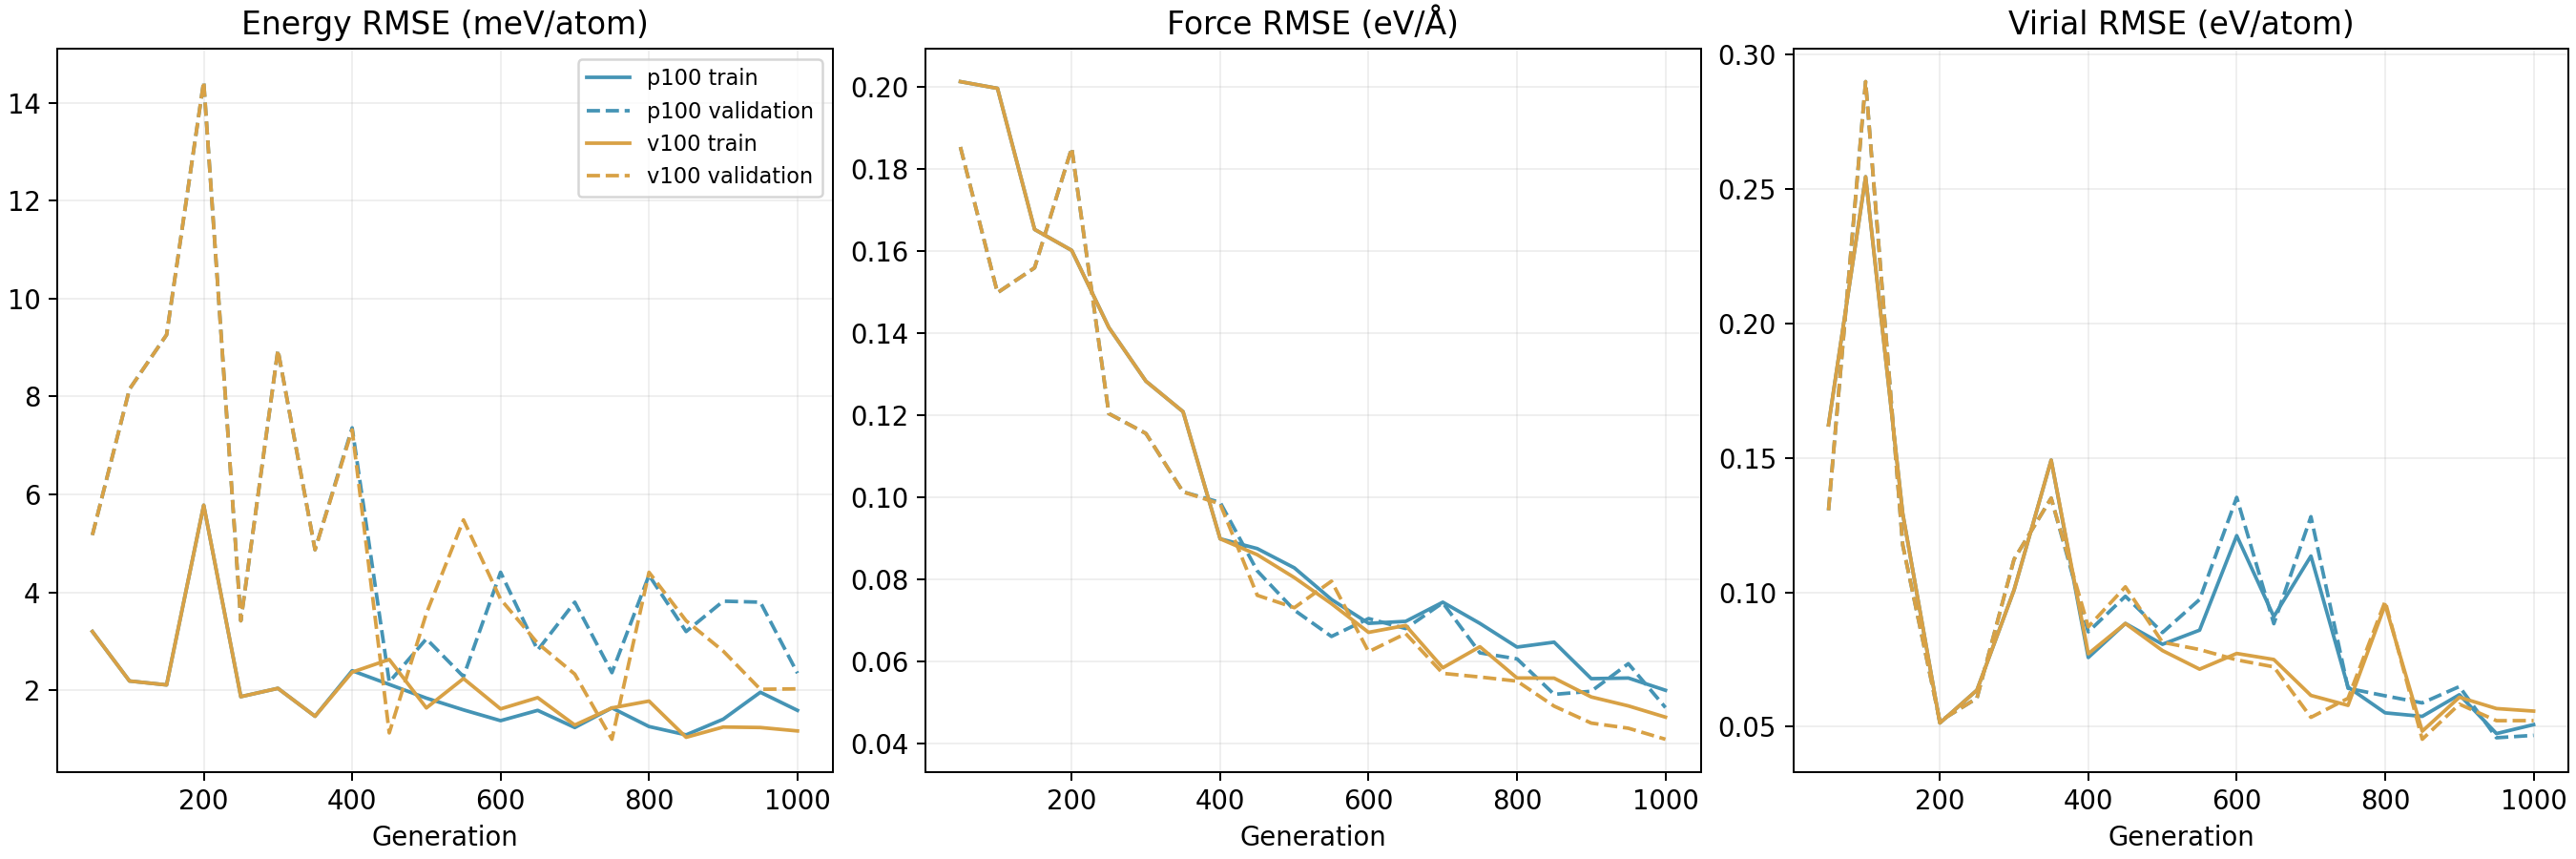
图中的Train/Validation是训练时可见的两组,不能称为最终独立测试。
4. 用GPUMDkit直接画训练/验证图#
在解压根目录查看包内实际模型的原生输出:
module load gpumdkit/1.5.8
cd reference-data/p100-n20-v0p1/training
gpumdkit.sh -plt train_test save
ls train_test.png
分析自己新训练结果时,进入cases/p100-n20-v0p1/training执行相同命令。
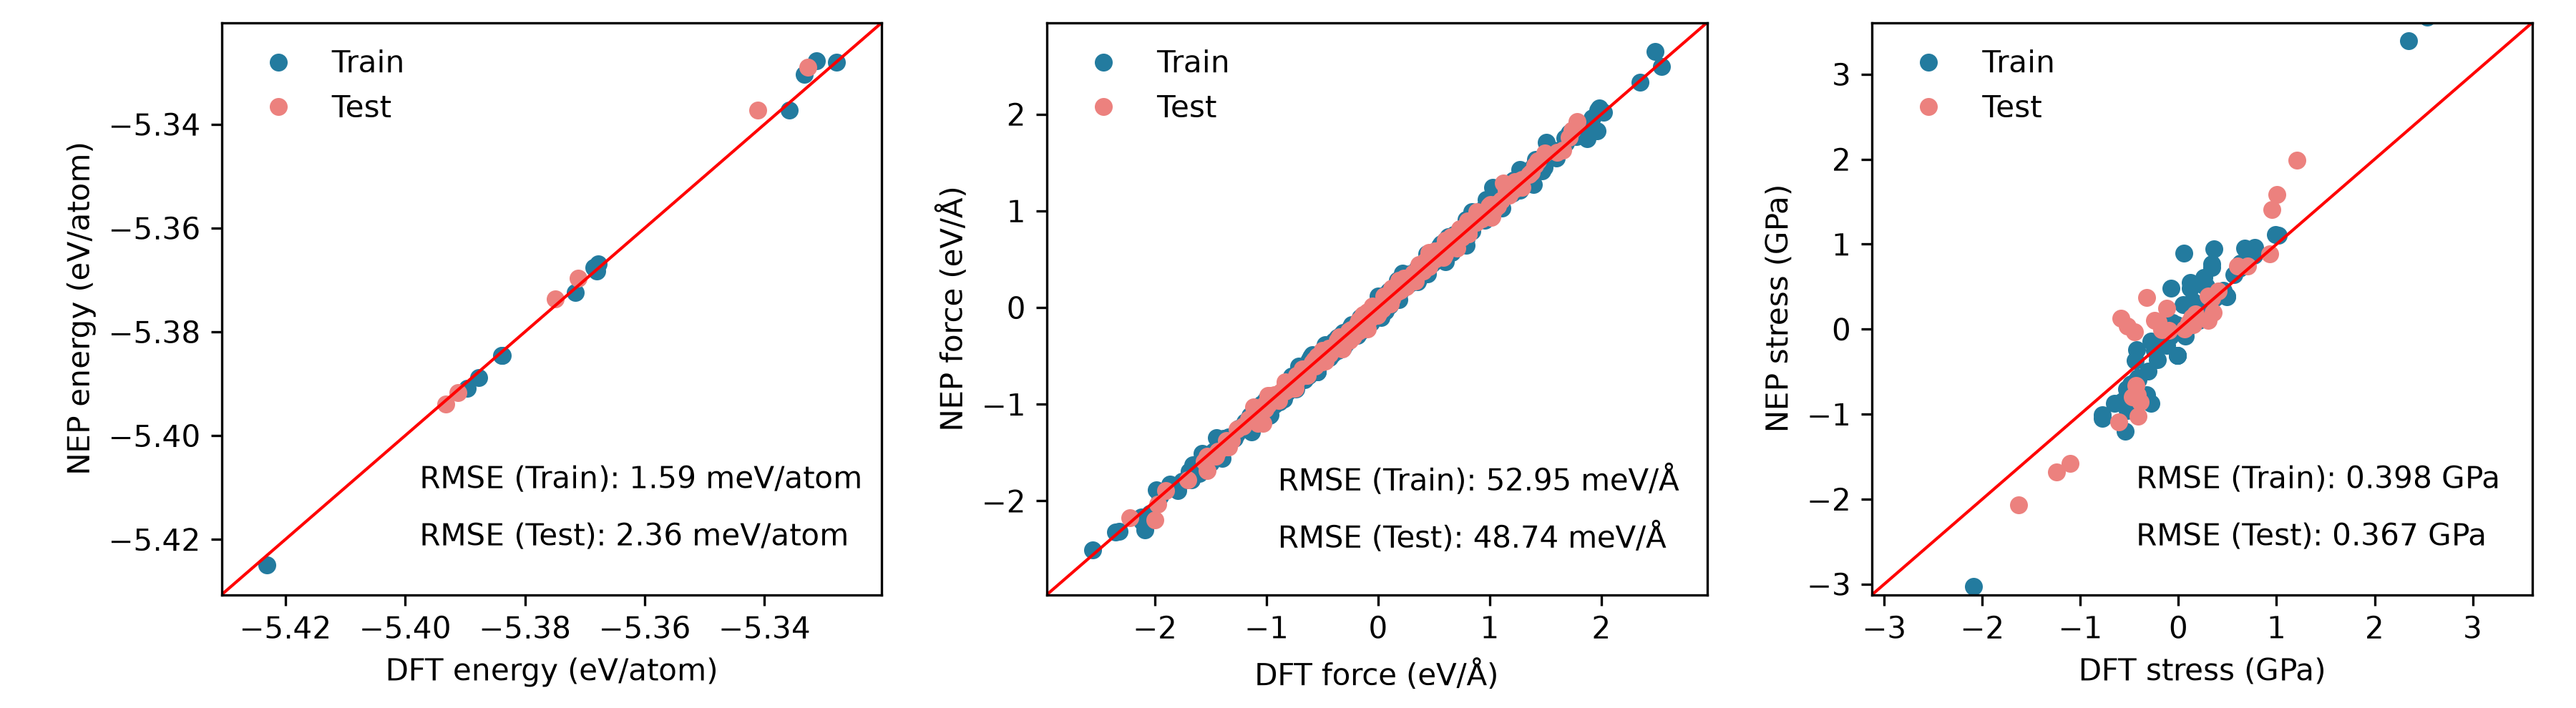
这张图实际由GPUMDkit生成,图例里的Test对应原生test.xyz,在本流程中是验证集。它包含能量、力和应力散点;应力轴是GPa。不要把这张图作为独立heldout结果,后者见下一节。
5. 独立方向测试及完整汇总#
全部14组结束后,在解压根目录执行:
bash analysis.sh --new
head -n 5 analysis-new/model-metrics.csv
ls figures-new
自己的新结果写入analysis-new/、figures-new/。包内参考可随时用不带--new的命令查看;两种入口分开。
| 预先指定的单卡基线 | E RMSE(meV/atom) | F RMSE(eV/Å) | V RMSE(eV/atom) | 应力RMSE(GPa) |
|---|---|---|---|---|
| P100,20神经元,λV=0.1 | 0.980447 | 0.045401 | 0.035656 | 0.279400 |
| V10016G,相同设置 | 0.466648 | 0.038703 | 0.040757 | 0.319372 |
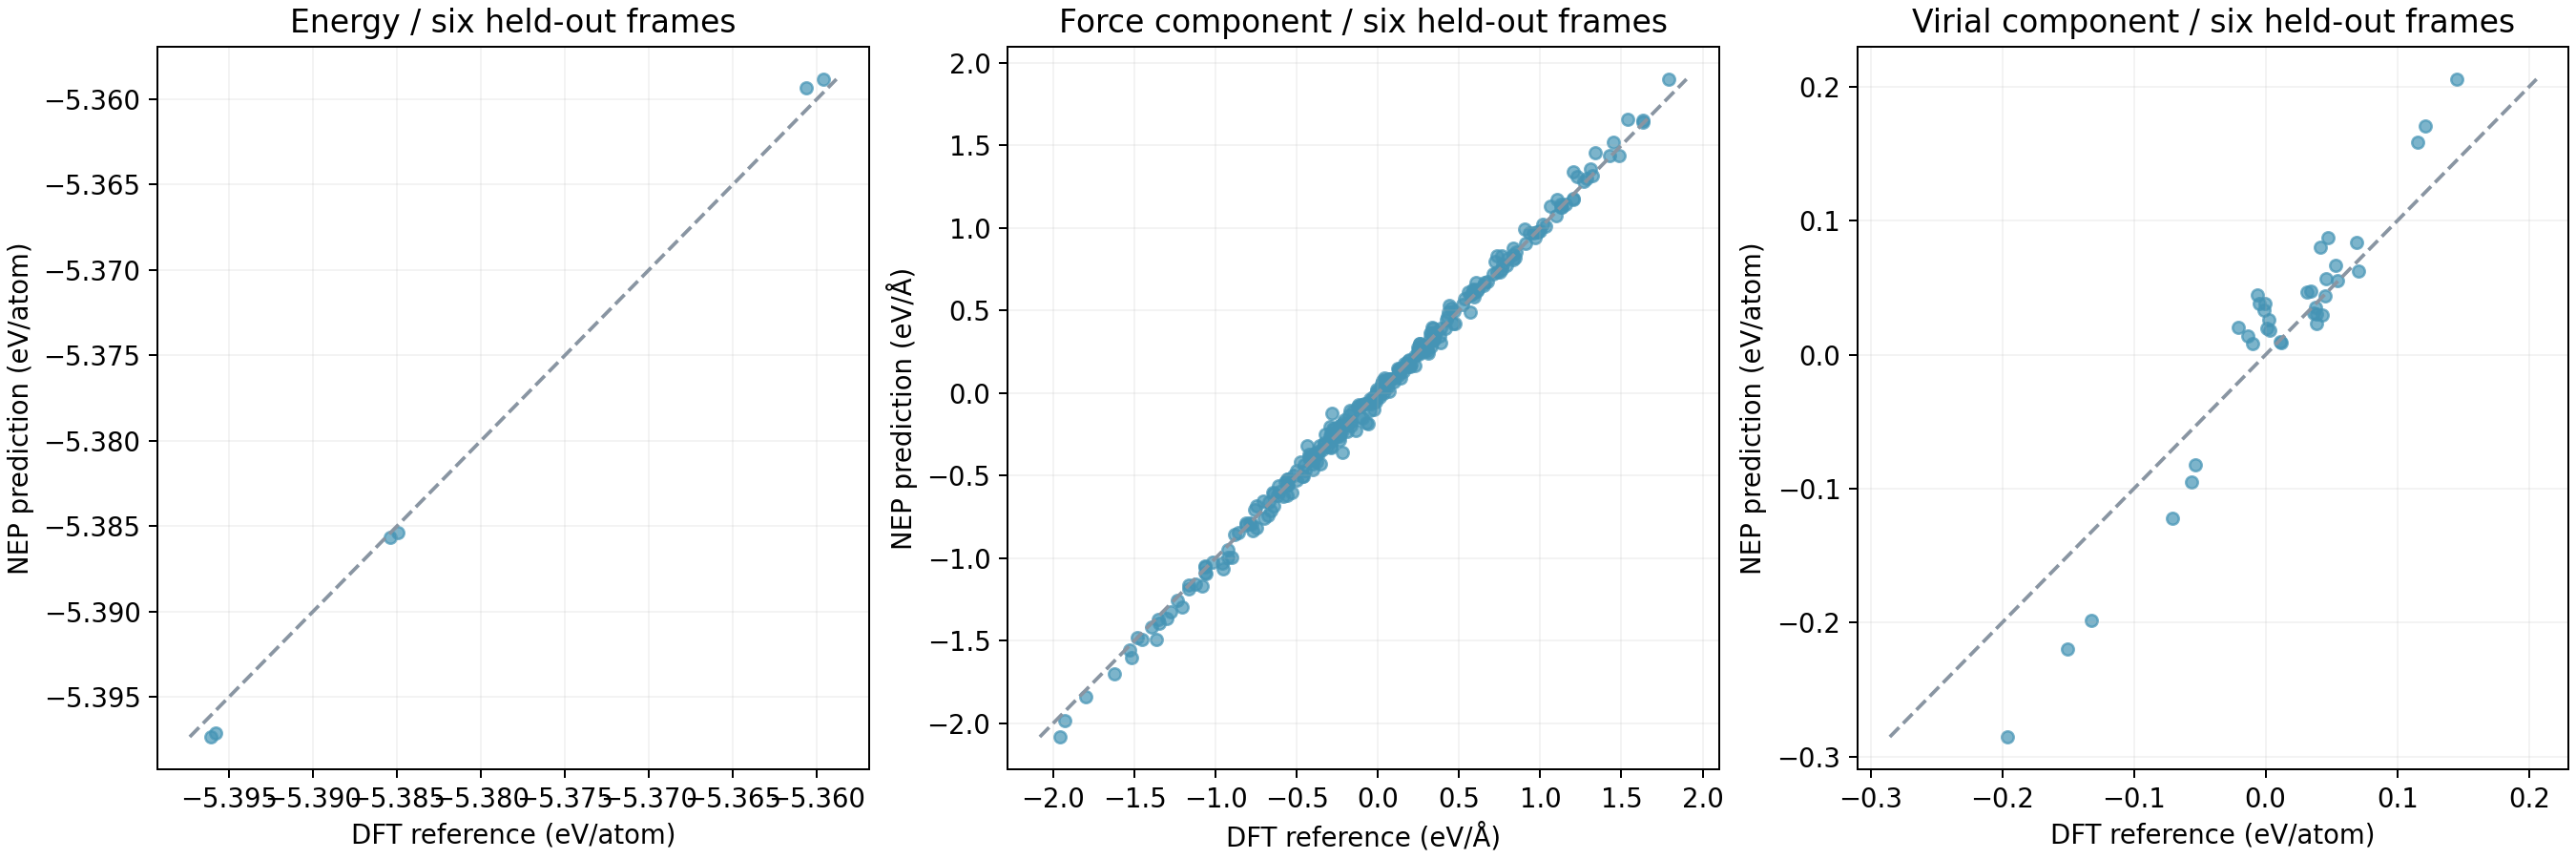
两条基线读的是相同6帧预留方向,力与virial的RMSE均按全部分量计算。GPU会影响浮点累积与优化轨迹;表中单次差异不用于判断硬件本身的模型精度。
本例只有25帧且固定体积,训练短,主要供操作参考。用于真实MD前,应补充所需体积、温度、形变、缺陷数据,并检查稳定性、目标物性和误差分布。
原生文件含义可对照GPUMD官方输出文件目录。更多数据处理见GPUMDkit专题。