
GPUMD:双副本交换与检查点续算
用真实NaCl短算例学习replica交换、温度标签、完整检查点和两条续算分支的逐值对照。
阅读本篇目录
本篇使用独立程序 gpumd_replica,以NaCl长程教程中真实训练的同一个charge1模型,演示双副本温度交换与断点续算。一个作业只申请1GPU、1CPU,两个replica在同一张GPU上运行;这不是双GPU加速测试。
1. 下载后先查看结果#
下载模型、实际轨迹、完整检查点与绘图脚本,保存为 gpumd-replica-checkpoint-wave219.zip。
unzip gpumd-replica-checkpoint-wave219.zip -d replica-checkpoint
cd replica-checkpoint
bash view.sh
cat analysis/metrics.csv
生成两张图片及CSV,不重新计算。重复画图使用新解压目录,避免覆盖已有输出。
体系为实际8原子NaCl小晶胞,两个目标温度100/200 K,时间步0.1 fs,总计120步、12 fs,只有六次交换尝试。它用于学习程序和文件流转,不提供收敛温度分布、相变、交换效率或通用NaCl动力学精度结论。
2. 输入与普通GPUMD有哪些不同#
初始40步的完整 run.in:
potential nep.txt
kspace ewald
time_step 0.1
multi_replica remd replicas 2 2 exchange 20 temp 100 200
ensemble nvt_bdp 100 200 100
dump_xyz -1 0 20 trajectory.xyz velocity
run 40
replicas 2 2表示两个副本、每GPU容纳两个副本;exchange 20每20步尝试交换。nvt_bdp与温度梯度对应,显式Ewald用于这个周期性charge1模型。
本版replica的 dump_xyz要求先写 -1 0分组参数,再写间隔和文件名;这里只支持坐标和可选 velocity。不要复制普通 gpumd 的force/charge/precision参数,也不要把两个程序的全部输入关键字视为通用。
GPUMD5.9.1采用GCC13.3/CUDA12.9.86构建。此独立程序需要CUDA共享库,提交脚本显式加载 cuda/12.9及对应 gpumd/5.9.1-p100或V100模块;无需改个人配置或重新安装软件。后处理使用ASE3.29.0。
3. 提交可自动续算的实例#
module load ase/3.29.0
python3 prepare.py
cd cases/p100
sbatch job.slurm
V10016G在 cases/v100执行同样的 sbatch job.slurm。脚本顺序为:
- 先运行40步,生成
checkpoint40/。 - 完整复制检查点到
direct/,一次追加80步。 - 复制同一个检查点到
fork/,先追加40步,再追加40步。 - 两条分支均到累计120步,比较结果。
两条分支起点的坐标、速度、温度标签、恒温器与交换随机数状态相同。生产构建默认按时间初始化随机数,两次全新启动的轨迹不能直接逐点比较。这里不为追求相同结果修改软件的DEBUG编译选项。
作业中实际运行的命令是 gpumd_replica,不套 mpirun,不启动两个相同的Slurm任务充当两个副本。
4. 手动续算时保留哪些文件#
ls checkpoint40/remd*restart*
head checkpoint40/remd_restart.meta
需要一起保留:
remd_restart.meta
remd_replica_0_restart.xyz
remd_replica_1_restart.xyz
元数据包括累计步数、温度映射、交换统计及随机数状态;XYZ含坐标、质量、速度和副本标签。只拿坐标不能恢复同一条续算路径。
在原 multi_replica行末加 resume remd,run填写本次追加步数。例如从40步追加80步:
multi_replica remd replicas 2 2 exchange 20 temp 100 200 resume remd
run 80
其余势函数、时间步、温度、恒温器和Ewald设置保持一致。包内脚本完整复制检查点和已有输出,分别写到独立分支,避免把不相干的轨迹追加到一起。
5. 交换了什么,怎么读文件#
cat direct/remd_exchange.out
cat direct/remd_temperature_status.out
head direct/remd_thermo.out
remd_exchange.out记录交换前的副本身份、温度标签、势能、对数接受率、概率与是否接受;remd_temperature_status.out是交换后的标签。固定的副本编号不等同于固定温度。
脚本按原生能量与当前程序使用的kB=8.617343E-5 eV/K,逐行重建:log_ratio=(Ei−Ej)×(1/kBTi−1/kBTj),p=min(1,exp(log_ratio))。没有把输出概率原样当作独立验证。
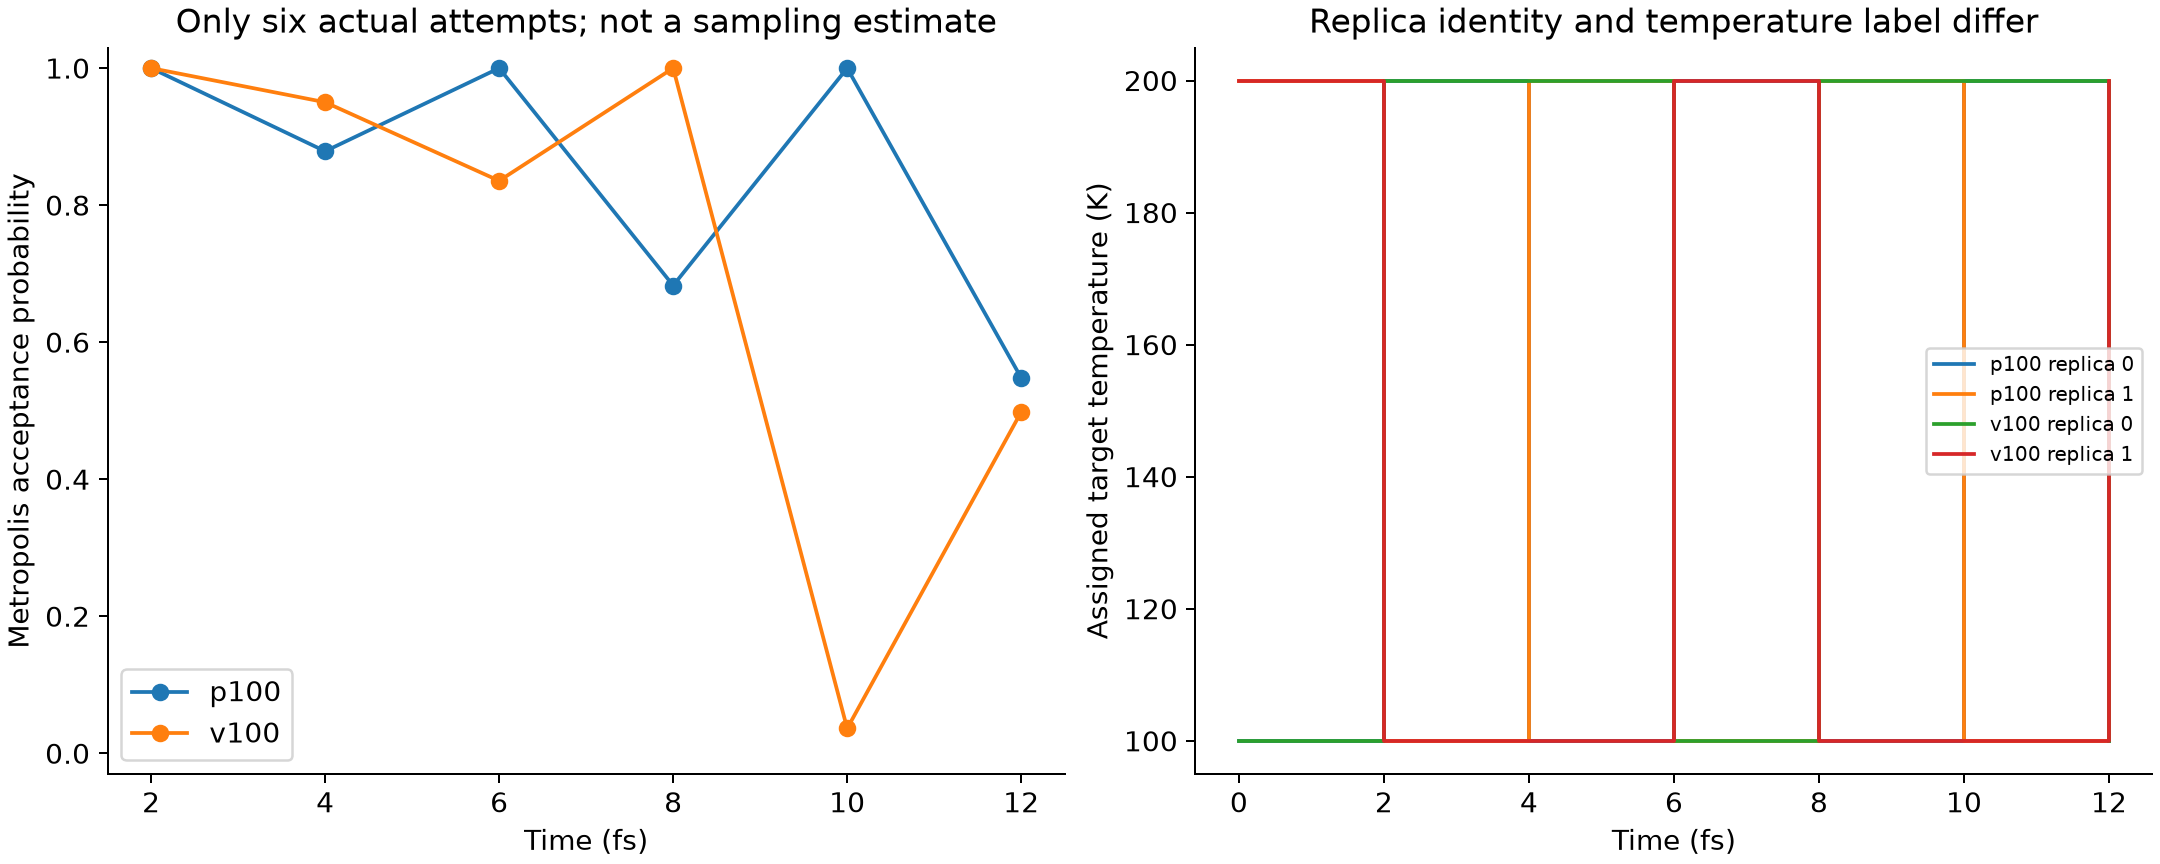
源P100接受6次,V10016G接受4次。它们从不同随机初速度起步,只有六次尝试,不能把差异解释为GPU性能差或统计上收敛的接受率。
6. 检查两条续算分支#
P100、V100任务都结束后回到包根目录:
module load ase/3.29.0
python3 analyze.py --new
cat analysis-new/metrics.csv
| 源算例 | 分支末态最大位置差,Å | 最大速度差,Å/fs | 公共时刻最大能量差,eV/原子 |
|---|---|---|---|
| P100 | 4.44E-16 | 8.67E-19 | 0,实际输出精度下 |
| V10016G | 1.33E-15 | 4.45E-18 | 0,实际输出精度下 |
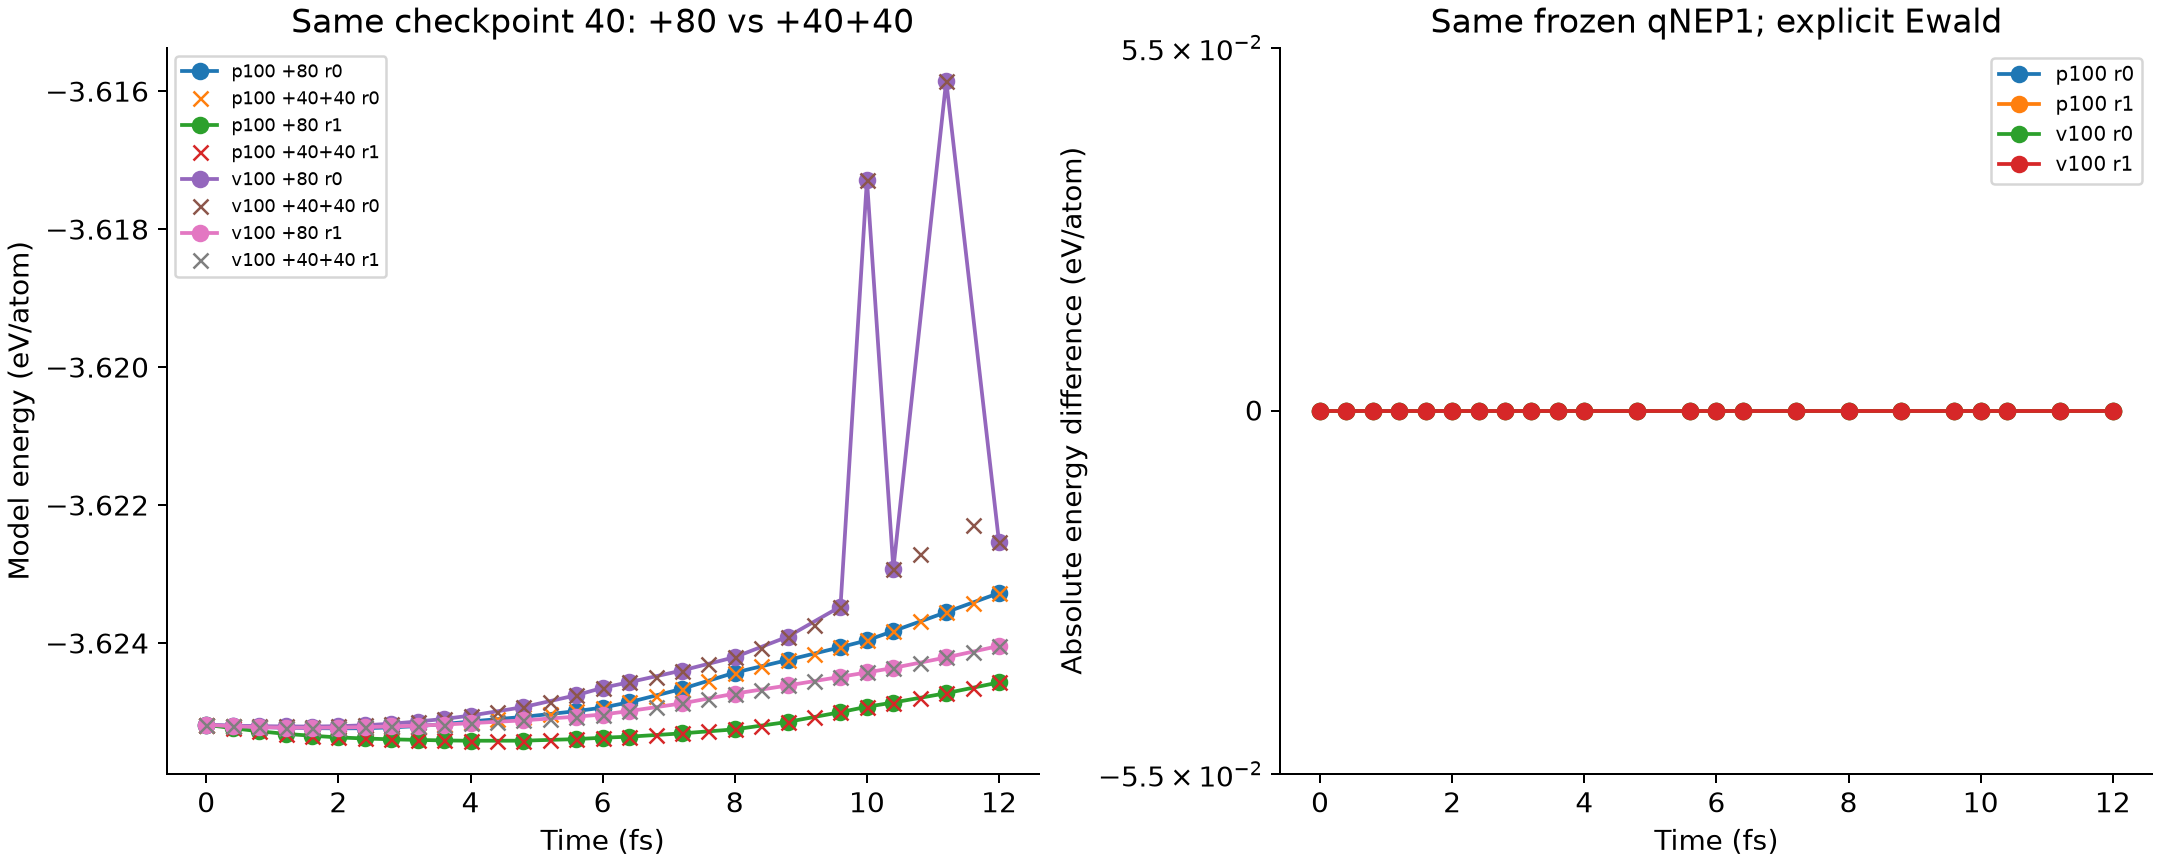
REMD热力学输出还受每段运行的进度间隔影响,不同分段可能给出不同采样时刻。脚本保留全部原始记录,在真实公共时刻比较,不插值或补造数据。轨迹中的 vel按原生Å/fs读取,不能直接当成ASE动量。
自己的新运行会产生新的随机初态,应检查本次两条分支的一致性,不要求其整条轨迹与随包参考逐位相同。正式使用REMD还应另外检查势函数适用范围、各温度平衡、温度梯度、往返交换和充分采样;12 fs教学例不代替这些工作。普通XYZ/NetCDF与常规续算另见轨迹导出教程,版本接口依据当前固定源码。