
GNEP:用真实铝标签训练与独立测试
准备真实VASP铝标签,按9/3/3构型划分,用GNEP训练并检查所有随机种子的独立能量和力误差。
阅读本篇目录
本篇使用鸢算科技集群 GPUMD 5.9.1 的 gnep,从真实 VASP 标签完成“检查数据→生成输入→单卡训练→独立测试→画图”。GNEP 通过梯度优化训练势模型,输入是 gnep.in,与读取 nep.in 的普通 nep 入口不同。
当前版本的 GNEP 输出 nep5 模型。用 GNEP 自身做预测;现有普通 nep 和 gpumd 入口不能加载此模型。 本篇展示训练与预测,后续操作见预测、力梯度与接口说明。
1. 下载并先看结果#
下载完整实例包,保存为 gpumd-GNEP-Al-wave221.zip:
unzip gpumd-GNEP-Al-wave221.zip -d al-gnep
cd al-gnep
bash view.sh
ls analysis figures
analysis/metrics.csv 是逐模型、逐数据集的误差,parity.csv 是每个构型、原子和分量的实际预测值与参考值。reference-results 保留32个训练条件的最终原生输出;view.sh 只读取这些结果,不启动训练。
2. 标签是什么,先分哪几组#
数据来自15个四原子周期铝构型,包含小幅晶胞应变和原子位移。另有2个真实 VASP 位移构型用于差分,不参加拟合。VASP 6.5.1 / PBE PAW Al,ENCUT 350 eV,EDIFF 1E-6,Gamma 6×6×6;电子温度固定1000 K,ISMEAR=-1、SIGMA=0.086173332621 eV。
拟合目标为原生 Mermin TOTEN 和原生受力;不能将 energy without entropy、零展宽外推能量和 TOTEN 混用。这里的1000 K是标签的电子温度,模型没有温度输入,不是温度依赖势;没有拟合 virial,也没有应力精度结论。电子温度模型教程介绍另一条路线。
| 分组 | 父构型编号 | 用途 |
|---|---|---|
| 训练9个 | 00、01、02、05、07、08、10、11、13 | 更新模型参数 |
| 验证3个 | 03、04、14 | 观察优化过程与拟合设置 |
| 独立测试3个 | 06、09、12 | 完成训练后单独评估,不挑选最佳种子 |
| 真正DFT差分2个 | 00的x方向±0.01 Å | 核对参考能量与力,不加入训练 |
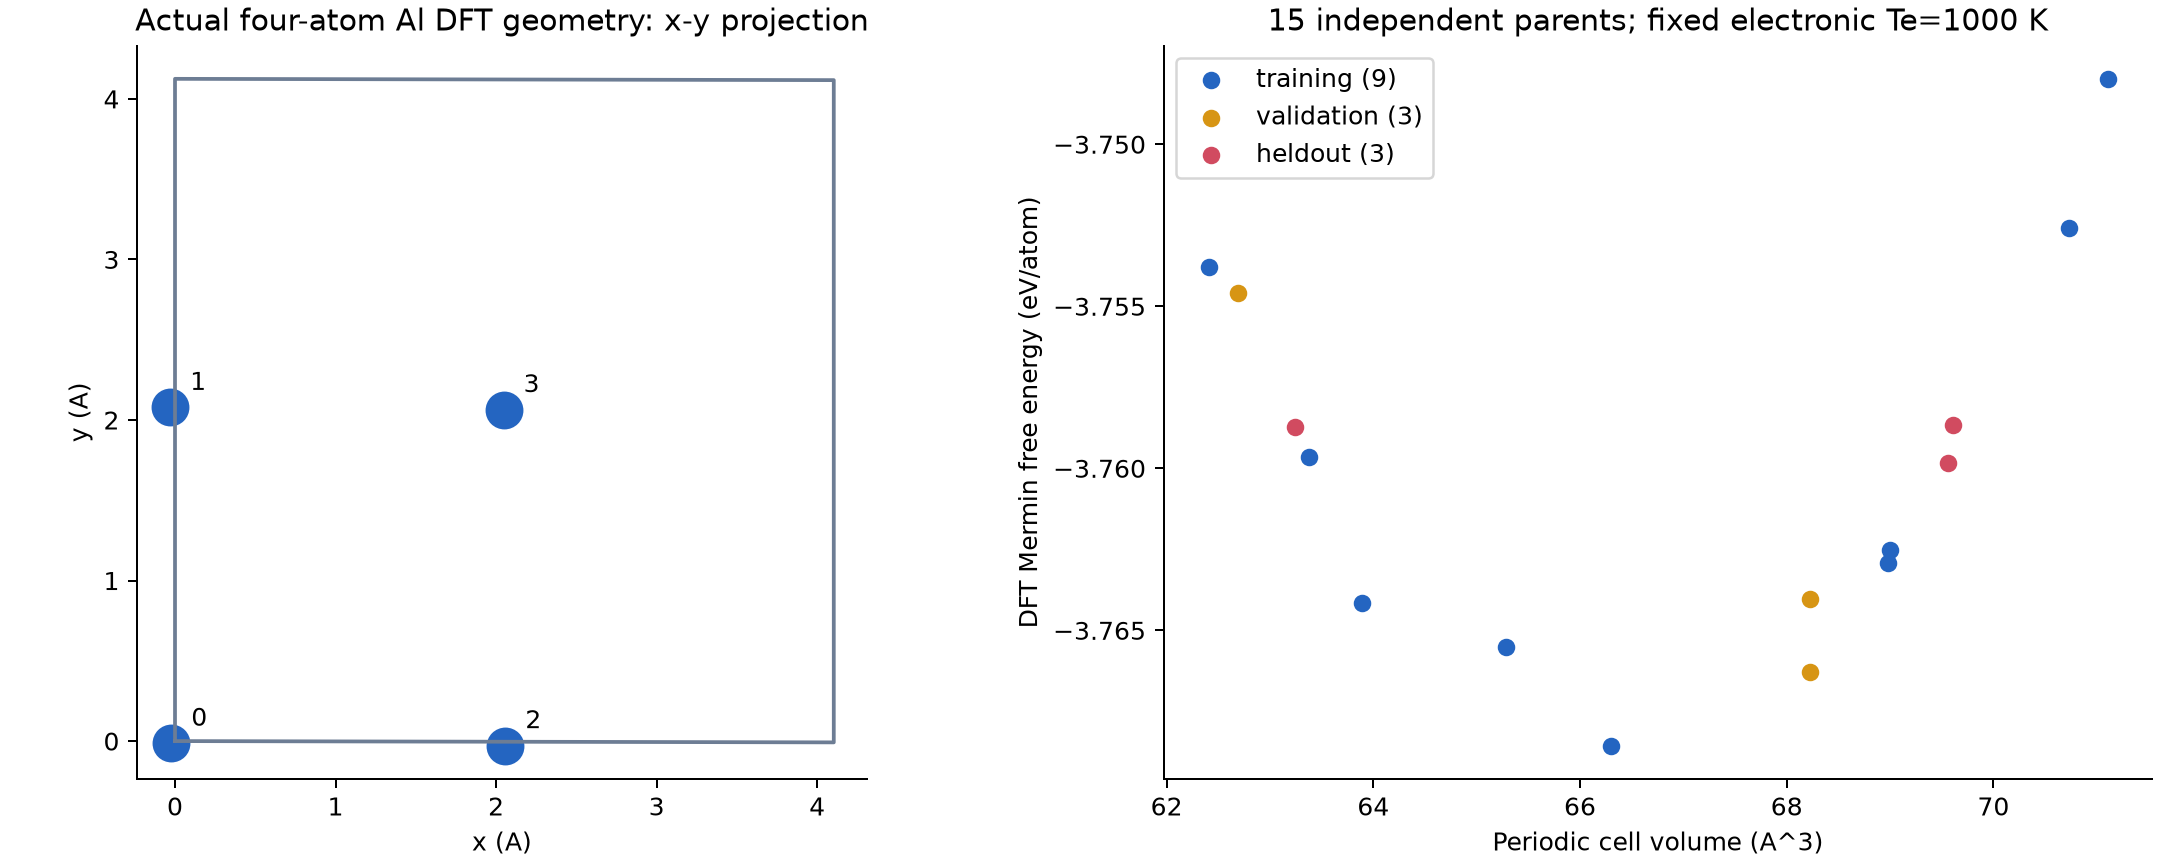
可直接检查原始输入和标签:
cat DFT-inputs/g00-T1000/INCAR
cat DFT-inputs/g00-T1000/POSCAR
cat DFT-inputs/g00-T1000/KPOINTS
head -n 30 data/DFT-LABELS.json
展开一套真实VASP输入
INCAR:
SYSTEM = Al electronic temperature free energy
PREC = Accurate
ENCUT = 350
EDIFF = 1E-6
ISMEAR = -1
SIGMA = 0.086173332621
ISPIN = 1
NBANDS = 32
ALGO = Normal
NELM = 100
NELMIN = 4
ISTART = 0
ICHARG = 2
NSW = 0
IBRION = -1
ISIF = 2
ISYM = 0
LREAL = .FALSE.
LASPH = .TRUE.
ADDGRID = .TRUE.
LWAVE = .FALSE.
LCHARG = .FALSE.
NCORE = 1
KPAR = 1
POSCAR:
Al fixed geometry electronic temperature tutorial
1.0
4.10906367548885 -0.00319994099333 0.00000000000000
0.00000000000000 4.09025705356554 0.00075041108036
0.00858109929597 0.00000000000000 4.10435817199494
Al
4
Cartesian
-0.01728020178735 -0.01013409169504 -0.01423715351441
-0.01775996601110 2.07386677357382 2.05963558787312
2.04292460823806 -0.02450212420225 2.08015148199355
2.03575036608170 2.02768868594910 0.01998648407883
KPOINTS:
Gamma grid for finite-electronic-temperature tutorial
0
Gamma
6 6 6
0 0 0
本篇复用已经计算好的标签,不需要再提交 VASP。包中没有 POTCAR、WAVECAR 或 VASP 程序;相同数据的来源与定义见 DATA-SOURCE.md。
3. 生成目录,理解训练帧#
source /etc/profile
module load ase/3.29.0
python3 prepare.py
cd cases/E10-p100-base-s13579
head -n 6 training.xyz
首个训练帧原样如下,energy 是整胞 eV,坐标为 Å,force 是 eV/Å:
4
Lattice="4.1090636754889 -0.0031999409933271 0 0 4.0902570535655 0.00075041108036015 0.008581099295974 0 4.1043581719949" Properties=species:S:1:pos:R:3:force:R:3 pbc="T T T" energy=-15.05164487
Al -0.017280201787355 -0.010134091695042 -0.014237153514414 0.00299387 0.09157012 0.12078781
Al -0.017759966011104 2.0738667735738 2.0596355878731 0.01726296 -0.17773126 -0.04154391
Al 2.0429246082381 -0.024502124202248 2.0801514819935 -0.01376735 0.12946723 -0.10117455
Al 2.0357503660817 2.0276886859491 0.019986484078835 -0.00648947 -0.04330609 0.02193065
同目录还有 validation.xyz、heldout.xyz、finite_difference.xyz。带未知参考值标记的 gradient-probes.xyz 只用于模型内部梯度检查,其中零值占位不能作为DFT标签,详见下一篇。
4. 完整GNEP输入#
base-gnep.in:
type 1 Al
cutoff 4.5 3.5
n_max 4 4
basis_size 4 4
l_max 4
neuron 16
batch 9
epoch 10000
lambda_e 10.0
lambda_f 1.0
lambda_v 0.0
weight_decay 0.0
energy_shift 1
start_lr 0.001
stop_lr 0.000001
lr_cos_restart 0
seed 13579
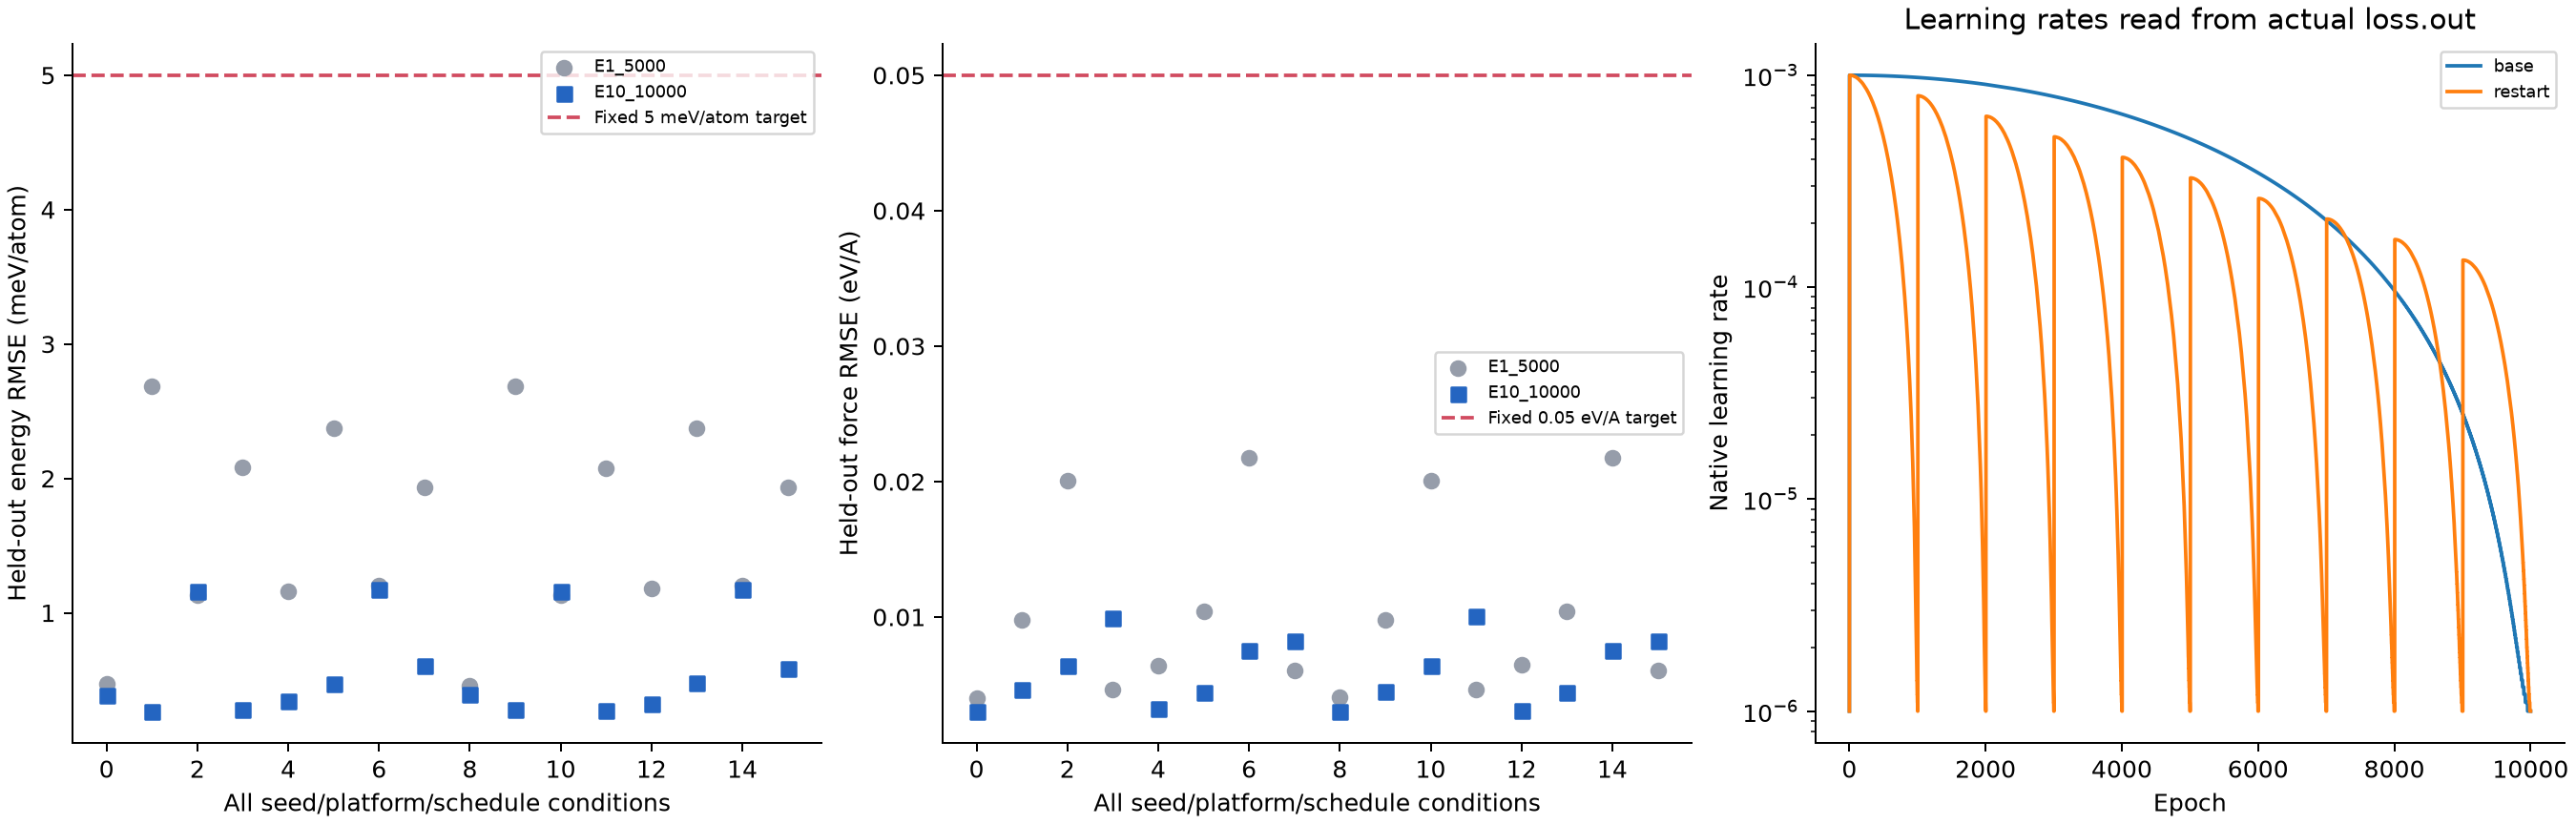
epoch 10000是训练轮数;本安装版本的上限也是10000。它与普通 NEP 的generation不同。batch 9对应本例9个训练帧。l_max 4在 GNEP 中只写一个整数,不能照搬普通 NEP 的三项写法;本例为二体/三体描述符。lambda_e 10、lambda_f 1调整能量与力的训练权重,不是对标签乘10。lambda_v 0表示不拟合 virial。energy_shift 1用训练数据初始化能量偏置,输出仍是模型的物理能量,不需要用户手动加减标签均值。lr_cos_restart 0使用普通余弦学习率。带重启的对照为lr_cos_restart 1 5 1000 1.0 0.8,其余数据、种子和模型结构相同。
5. 单卡提交,等待输出#
cat job.slurm
sbatch job.slurm
squeue -u "$USER"
完整P100核时模板:
#!/bin/bash
#SBATCH --job-name=Al-GNEP
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --time=00:20:00
#SBATCH --output=gnep-%j.out
set -eo pipefail
source /etc/profile
module purge
module load cuda/12.9 gpumd/5.9.1-p100
export OMP_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1 MKL_NUM_THREADS=1
cd "$SLURM_SUBMIT_DIR"
python3 -B ../../run_model.py
这是一个GPU作业,只申请1张GPU和1个CPU核心。脚本依次训练,随后固定模型,对训练、验证、独立测试、真实差分和无标签梯度探针进行预测。不要在登录节点直接启动 gnep,也不要再套 mpirun。
V100 16G用户改进 cases/E10-v100-base-s13579,提交其 job.slurm;套餐用户先用 yskit 选择自己可用的分区及匹配GPU的软件环境。prepare.py 生成全部对照目录供选择,不要求一次全部提交。
tail -n 12 training/native.out
head -n 1 training/nep.txt
ls prediction-heldout
训练正常结束时包含 Finished running gnep.,模型首行是 nep5 1 Al。prediction-heldout 的数据来自未训练的3个父构型。
6. 计算误差并画图#
回到包根目录,只分析自己已经跑完的条件:
cd ../..
module load ase/3.29.0
python3 analyze.py --new --case E10-p100-base-s13579
cat analysis-new/metrics.csv
ls figures-new
重新运行时用新解压目录,避免混入上次输出。V100任务对应修改最后的目录名。
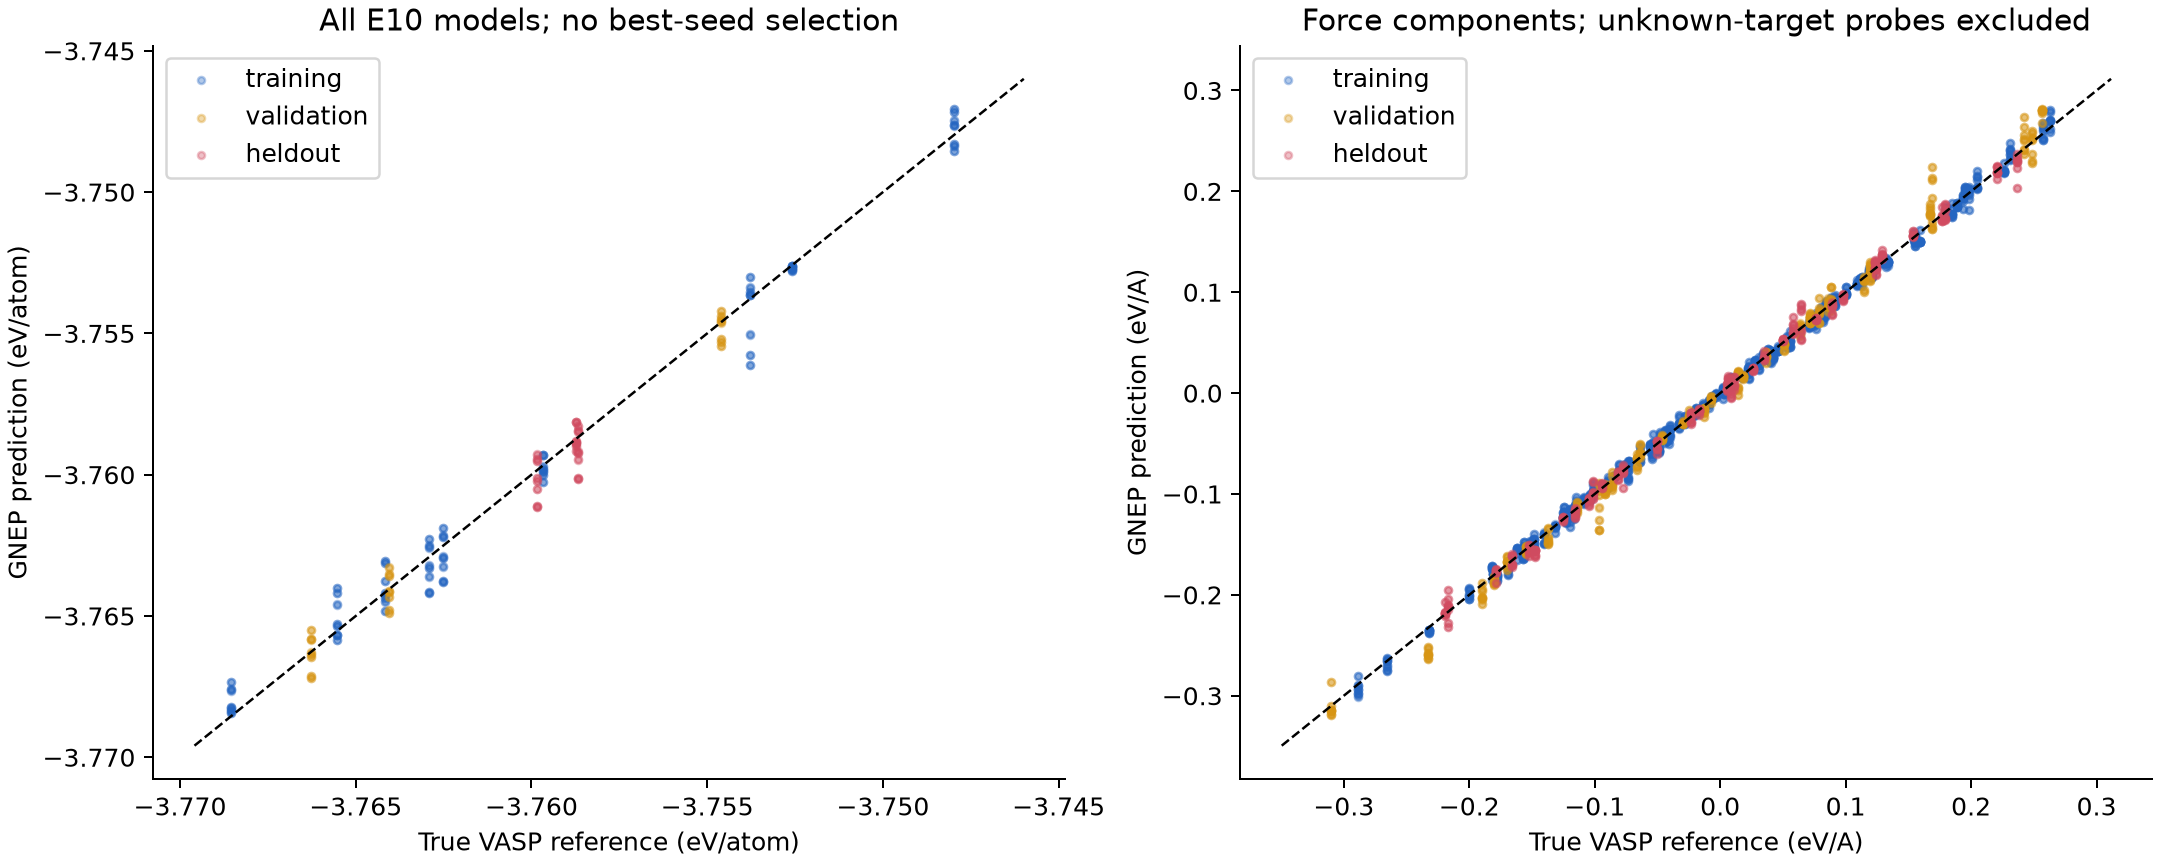
这次先完整保留能量/力权重均为1、5000轮的16个模型;根据训练与验证情况固定了能量权重10、10000轮方案,仍运行全部16个条件。每组均包含P100/V10016G、4个固定随机种子、普通/重启余弦学习率;独立测试没有用于挑选最佳种子。
E10方案的独立能量RMSE为 0.2686–1.1725 meV/原子,力分量RMSE为 0.003051–0.010096 eV/Å。初始方案为0.4555–2.6842 meV/原子、0.004036–0.021750 eV/Å。下面列出全部条件;这些小数据结果不能用于判定算法或GPU型号优劣。
展开32个模型的独立测试数值
| 模型目录 | 能量RMSE(meV/原子) | 力分量RMSE(eV/Å) |
|---|---|---|
| E10-p100-base-s13579 | 0.3893 | 0.003051 |
| E10-p100-base-s24680 | 0.2686 | 0.004625 |
| E10-p100-base-s27182 | 1.1605 | 0.006410 |
| E10-p100-base-s31415 | 0.2802 | 0.009949 |
| E10-p100-restart-s13579 | 0.3468 | 0.003245 |
| E10-p100-restart-s24680 | 0.4747 | 0.004417 |
| E10-p100-restart-s27182 | 1.1725 | 0.007554 |
| E10-p100-restart-s31415 | 0.6079 | 0.008237 |
| E10-v100-base-s13579 | 0.3940 | 0.003057 |
| E10-v100-base-s24680 | 0.2820 | 0.004493 |
| E10-v100-base-s27182 | 1.1605 | 0.006410 |
| E10-v100-base-s31415 | 0.2723 | 0.010096 |
| E10-v100-restart-s13579 | 0.3253 | 0.003093 |
| E10-v100-restart-s24680 | 0.4787 | 0.004416 |
| E10-v100-restart-s27182 | 1.1725 | 0.007553 |
| E10-v100-restart-s31415 | 0.5874 | 0.008241 |
| p100-base-s13579 | 0.4743 | 0.004036 |
| p100-base-s24680 | 2.6842 | 0.009798 |
| p100-base-s27182 | 1.1299 | 0.020038 |
| p100-base-s31415 | 2.0830 | 0.004627 |
| p100-restart-s13579 | 1.1631 | 0.006409 |
| p100-restart-s24680 | 2.3737 | 0.010406 |
| p100-restart-s27182 | 1.2007 | 0.021750 |
| p100-restart-s31415 | 1.9338 | 0.006046 |
| v100-base-s13579 | 0.4555 | 0.004091 |
| v100-base-s24680 | 2.6842 | 0.009797 |
| v100-base-s27182 | 1.1299 | 0.020039 |
| v100-base-s31415 | 2.0738 | 0.004661 |
| v100-restart-s13579 | 1.1815 | 0.006475 |
| v100-restart-s24680 | 2.3737 | 0.010406 |
| v100-restart-s27182 | 1.2007 | 0.021750 |
| v100-restart-s31415 | 1.9338 | 0.006049 |
7. 用GPUMDkit快速检查训练图#
bash plot-kit.sh
脚本复制参考模型的真实 loss.out、energy_train.out、force_train.out 到独立的 tool-plot,加载 gpumdkit/1.5.8 后执行:
gpumdkit.sh -plt train save
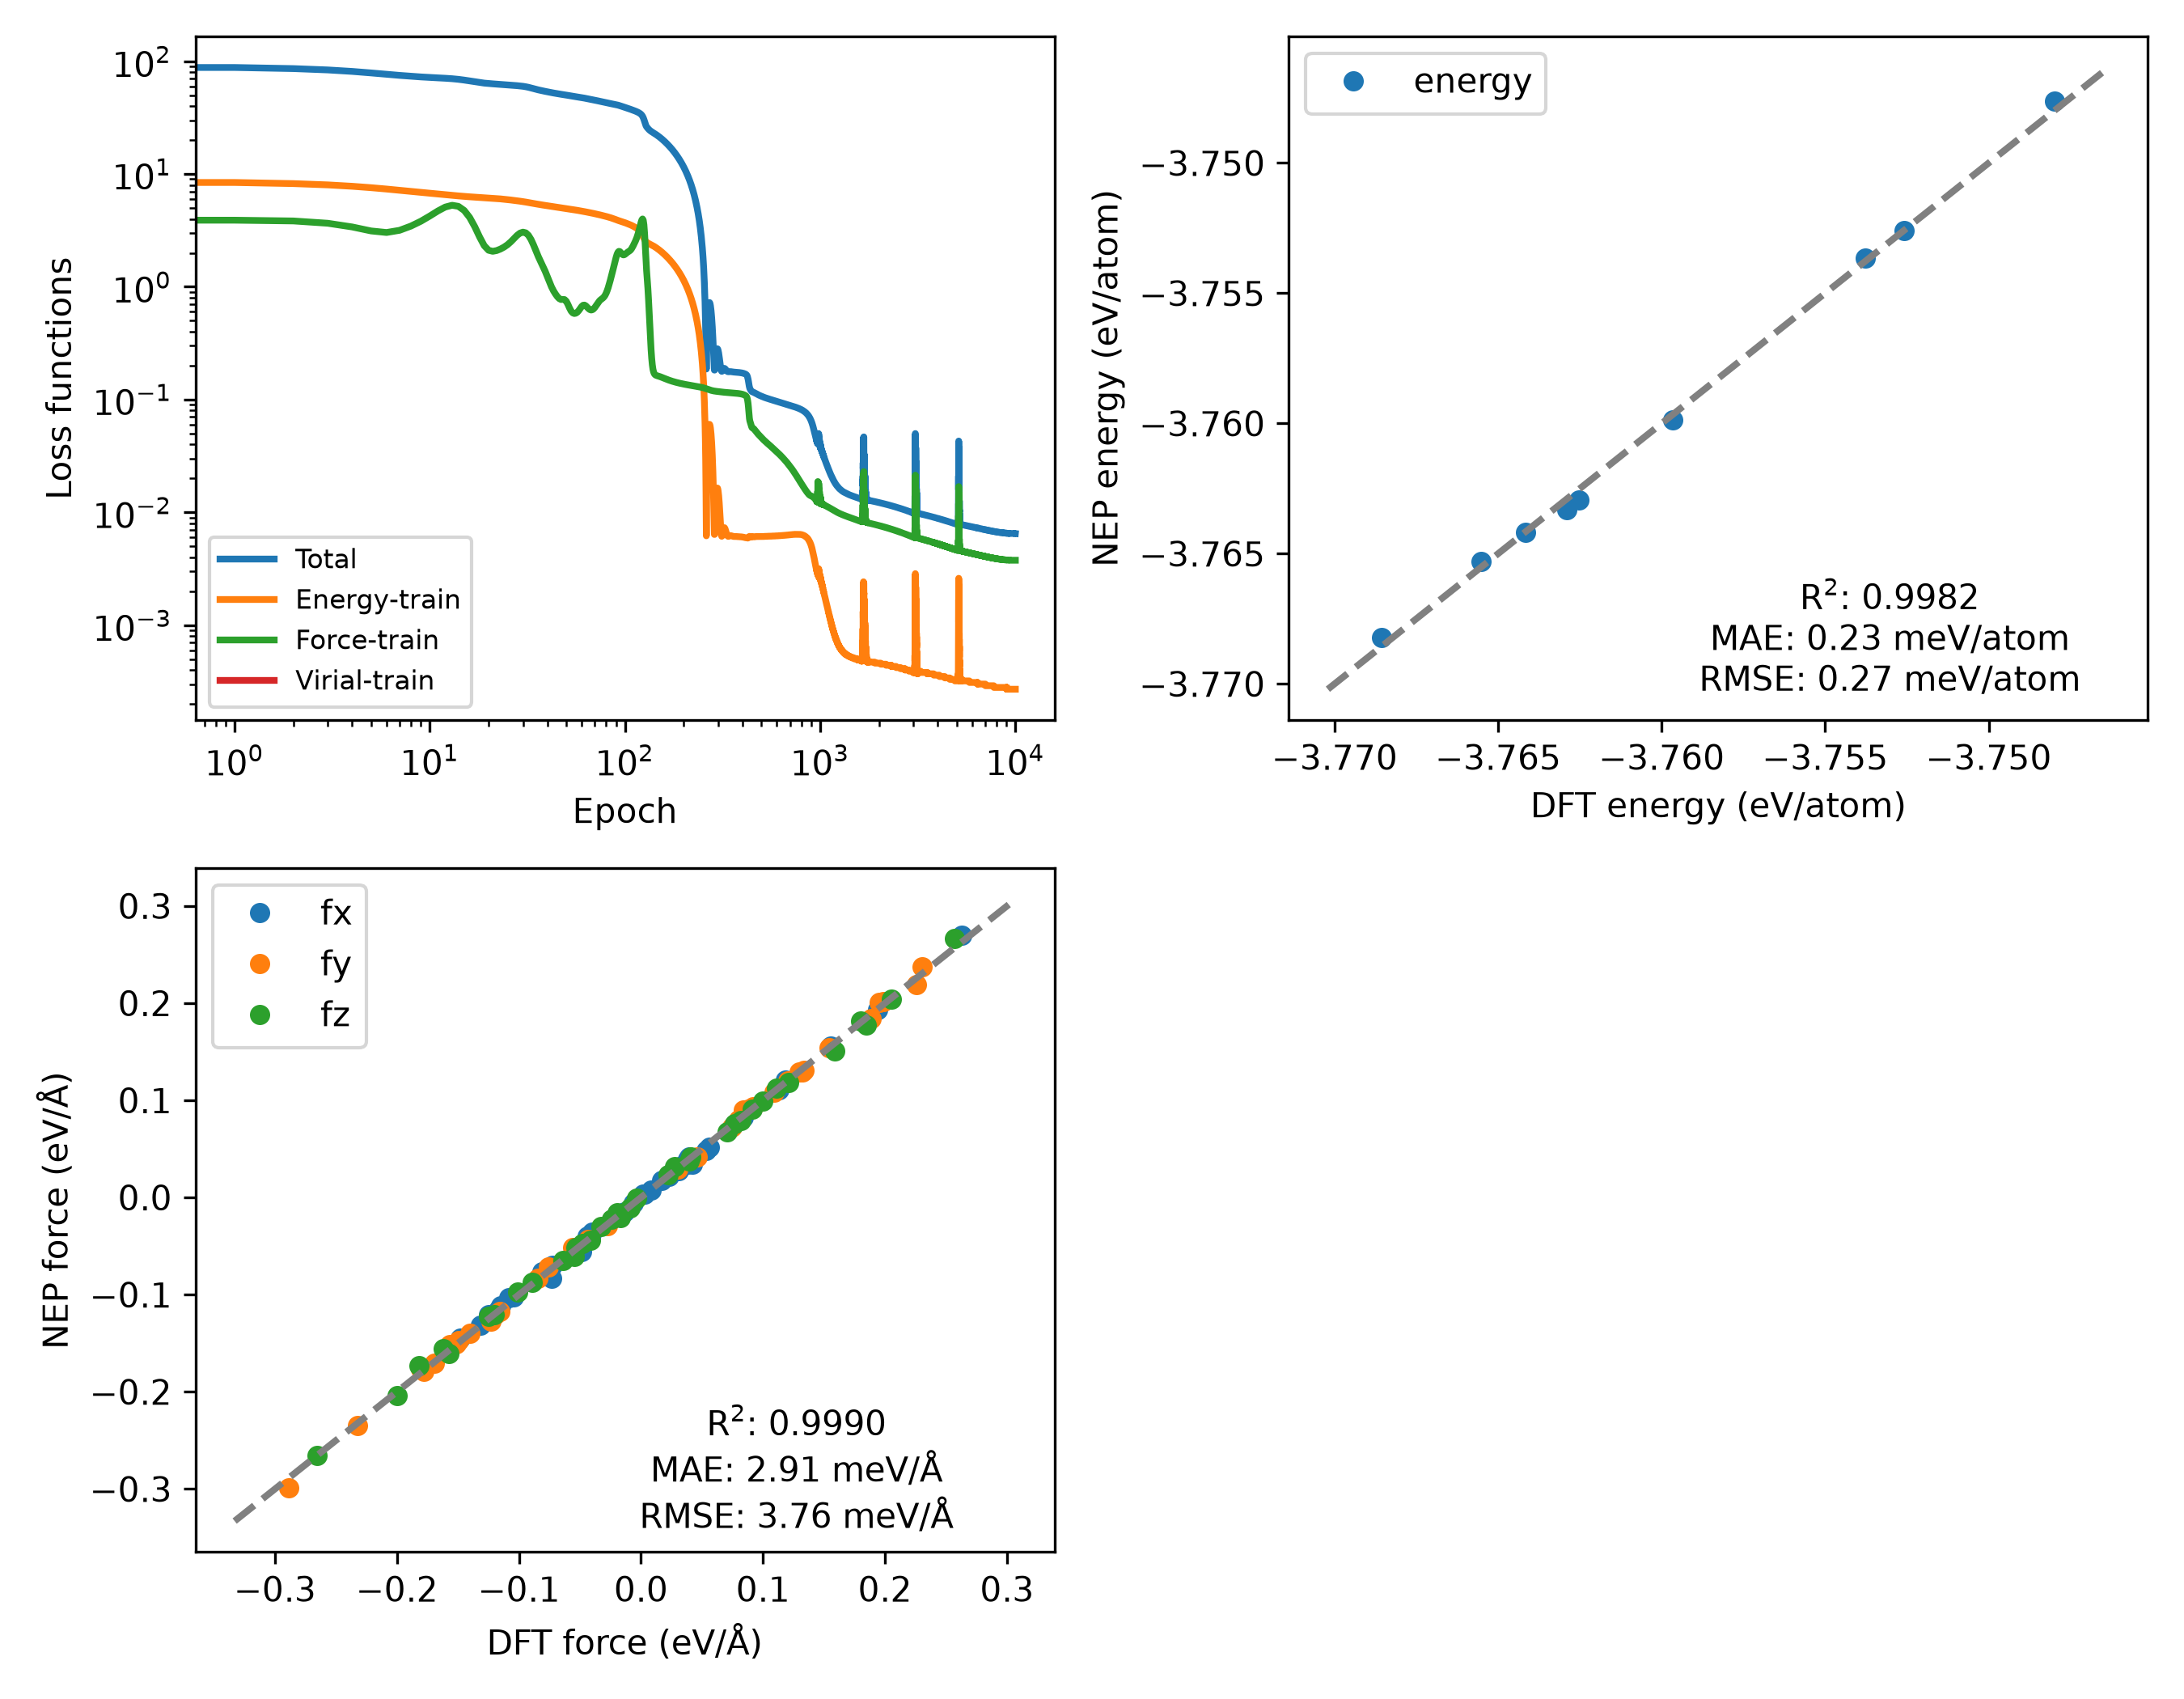
图中是训练集误差,不是独立测试精度。本例不拟合virial,脚本没有复制无参考标签的应力文件,应力面板显示无数据;不从空面板得出任何应力结论。自己重跑的结果也可在独立目录复制这三个同源文件后用同一命令画图。
下一步看预测和模型力梯度。正式建立生产势时还需扩大构型覆盖,加入缺陷、高温、相变等目标场景,并独立检查相应物性。
NEP5模型的独立副本入口#
当前独立gpumd_replica有NEP5实现,按NEP5模型副本与续算提交单卡双副本,比较同模型能量与受力,并从完整检查点续算。P100/V10016G均有真实短例;普通gpumd与nep的NEP5限制保持,不能将不同入口混用。四原子12fs只演示流程,不提供平衡统计或通用铝势结论。