
GPUMD PRD:事件时钟与检查点续算
逐列读取PRD事件,分清MD步与累计时钟,保留完整状态续算,并用实际能量受力和分支结果核对。
阅读本篇目录
接续硅间隙原子PRD。本篇重点是读输出:哪些步计入累计时钟、如何保留完整检查点、怎样核对续算和最小化盆地。全部数值来自同一实例资料包。
1. 先看一段真实事件记录#
在包根目录:
head -n 7 reference-results/p100-T300/direct/prd_events.out
# dynamics_step clock_step physical_time_fs event correlated coincident replica search_steps max_displacement_A quenched_potential_eV quenched_fmax_eV_per_A quench_steps
1 1 0.5 1 1 1 0 1 0.7933050898584044 -297.5080909729004 0.0009052962996065617 134
17 22 11 2 0 1 0 1 1.296322562596438 -297.5080962181091 0.0008974634110927582 135
47 71 35.5 3 0 1 0 1 1.296824428977102 -297.5080914497375 0.0008906400762498379 105
| 列 | 如何理解 |
|---|---|
dynamics_step |
计入run的累计MD步,包含关联与并行阶段 |
clock_step |
PRD累计时钟,不能直接用MD步数替代 |
physical_time_fs |
clock_step乘本例0.5 fs |
event |
从1开始的事件编号 |
correlated |
1为关联阶段的事件,0为并行阶段事件 |
coincident |
同一步被检测为逃逸的副本数 |
replica |
0起始的获胜副本编号 |
search_steps |
本次事件搜索块推进步数,本例event1所以为1 |
max_displacement_A |
该事件两次盆地最小化构型的最大原子位移 |
| 后三列 | 淬火势能、原生fmax、最小化步数 |
盆地判断使用周期最小镜像,但不对整体平移、旋转或原子置换做匹配。因此几何事件不自动等同于长程扩散、化学反应或某个唯一缺陷标签。
2. 时钟怎样累计#
初始参考先经历关联阶段。对本例两个副本:
- 关联阶段只推进当前参考副本,每个MD步时钟加1。
- 并行阶段没有事件时,每个MD步时钟加2。
- 本次并行搜索块推进τ步、最后一步发生事件时,本块时钟贡献为
N×(τ−1)+K;N是副本数,K是获胜副本编号加1。先前并行块的时钟已经计入。 - 去相位试探和最小化不加入这两个计数。墙钟耗时还包含这些额外工作。
本例 event 1,所以并行事件步获胜副本0贡献1,副本1贡献2。若同一步多个副本逃逸,当前实现选编号较小的副本。
上面第1步是关联事件,所以时钟也为1。后续第17步时钟22、对应11 fs,并不是17×0.5 fs。P100、300 K这条最终路径的250步对应125 fs计入的MD步时间,而原生累计时钟为425步、212.5 fs。
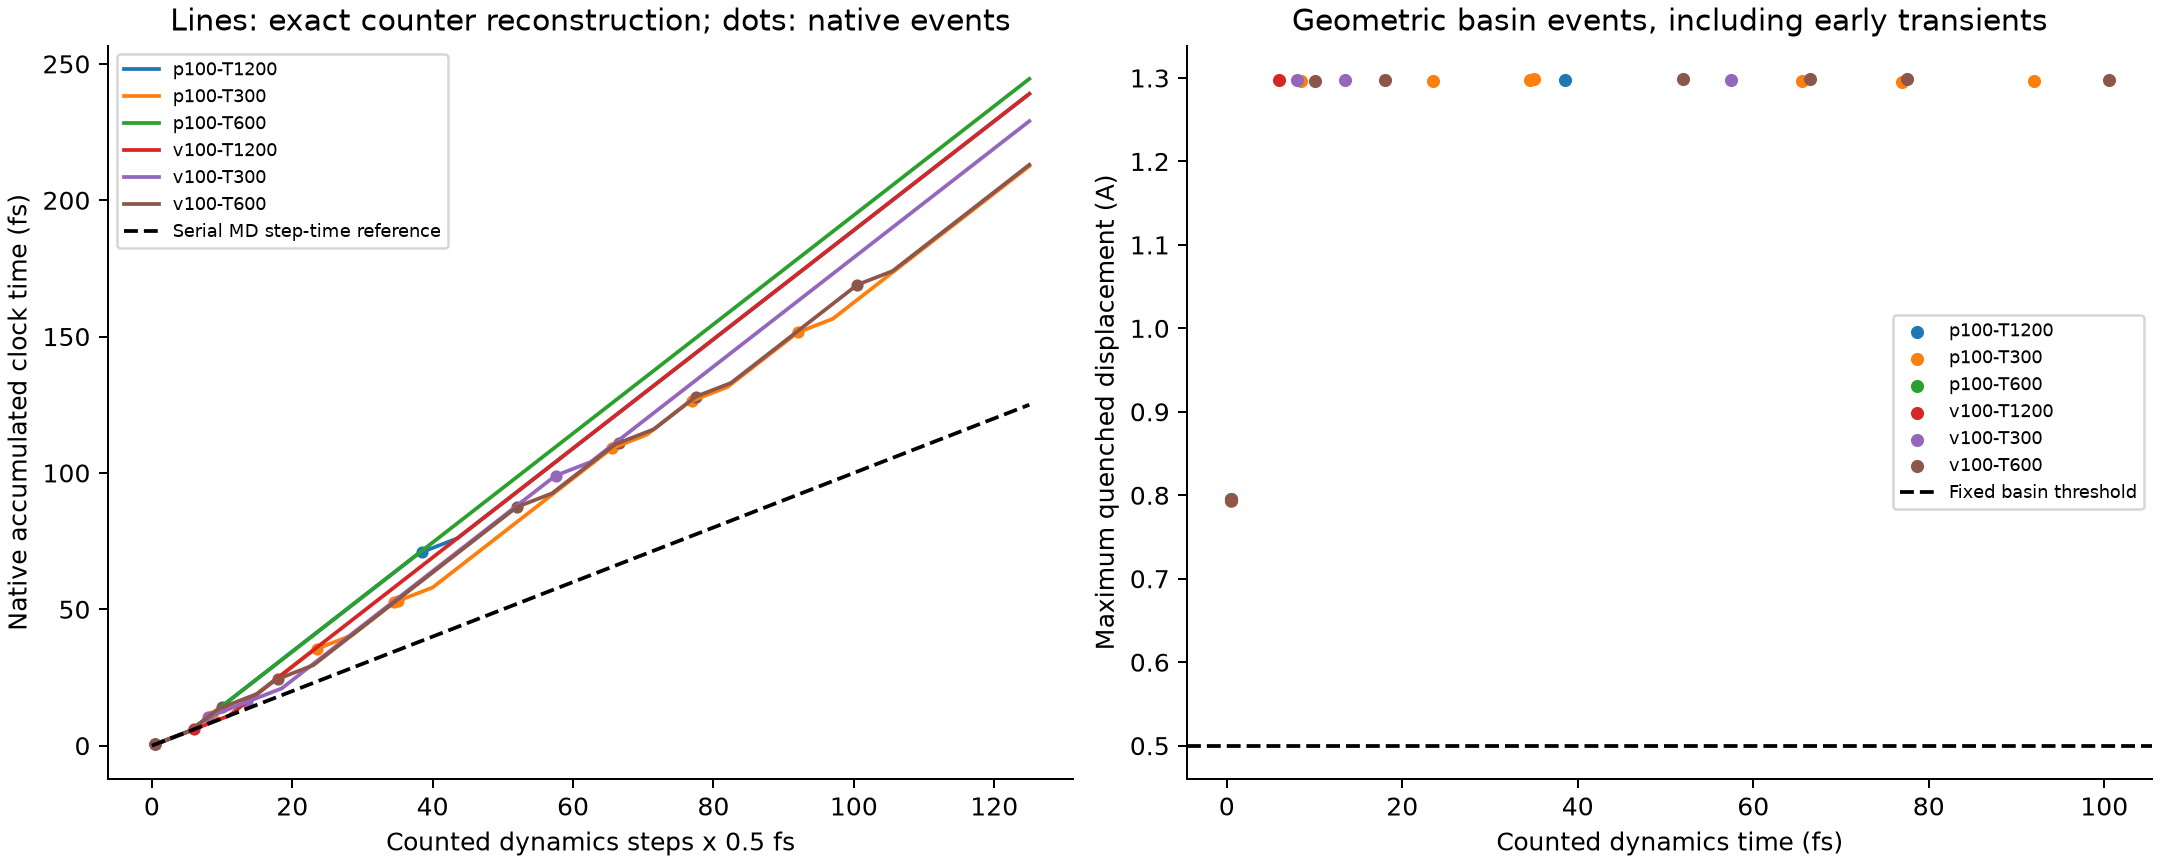
图中圆点来自原生事件输出;连线按明确的关联/并行规则重建每个整数时钟,并与每个原生事件和最终检查点核对。重建的中间值不是新增MD观测,更不是原子轨迹插值。
head -n 12 analysis/clock-reconstruction.csv
head -n 8 analysis/events.csv
native_counter_observed 标识该步是否有原生事件/最终检查点计数。累计时钟与墙钟加速比也不同,不能用212.5/125声称获得相应硬件加速。
3. 第1步就发生事件,该怎样理解#
本例六个条件的第一次事件均在第1步,而且属于关联阶段。说明本起点很快发生几何盆地重排,不能视为已经充分平衡的长寿命盆地。
正式研究应先准备稳定参考盆地,检查势函数与盆地定义,再确定关联和去相位时间。本例各10步、仅5 fs,未验证准平稳分布和独立性,也不能由这些很少的事件给出迁移率、扩散系数、势垒或温度趋势。事件最小化能量十分接近,也不把微小数值差当作能垒。
4. 完整检查点需要保留什么#
ls reference-results/p100-T300/checkpoint150
head -n 22 reference-results/p100-T300/checkpoint150/prd_restart.meta
head -n 2 reference-results/p100-T300/checkpoint150/prd_basin_restart.xyz
请保留整个同源目录,至少包括:
prd_restart.meta:累计MD步、时钟、事件数、当前阶段、关联状态与随机/热浴状态。prd_basin_restart.xyz:当前参考盆地。- 两个
prd_replica_*_restart.xyz:各副本的热态坐标、质量和速度。 - 相同的
nep.txt、model.xyz、事件输出及事件结构文件。
不要混入不同模型、原子顺序、温度或检查参数的文件。restart.xyz 只含坐标速度的普通续算方式,不能代替这套完整PRD状态。
5. 同一检查点分叉继续运行#
参考脚本已经自动完成相当于下面的目录准备:
cp -a checkpoint150 direct
cp -a checkpoint150 fork
继续100步时的 run.in:
potential nep.txt
time_step 0.5
ensemble nvt_bdp 300 300 100
multi_replica prd replicas 2 2 event 1 dephase 10 correlate 10 distance 0.5 quench 0.001 4000 max_dephase_retries 50 resume prd
dump_xyz -1 0 1 events.xyz
run 100
resume prd 指向这组检查点前缀;run 100 是在原150步之后增加100步,不是把总步数设为100。另一条分支先加50、再加50,保持模型和全部协议参数相同。
单独运行自己的PRD输入时,计算节点内的原生命令为:
gpumd_replica > run.log 2>&1
平时放进匹配GPU的Slurm脚本,通过 sbatch 提交。包内参考脚本会生成输入,按上一篇说明修改生成函数或建立自己的独立任务目录,不在登录节点直接启动。
6. 续算和受力的实际核对#
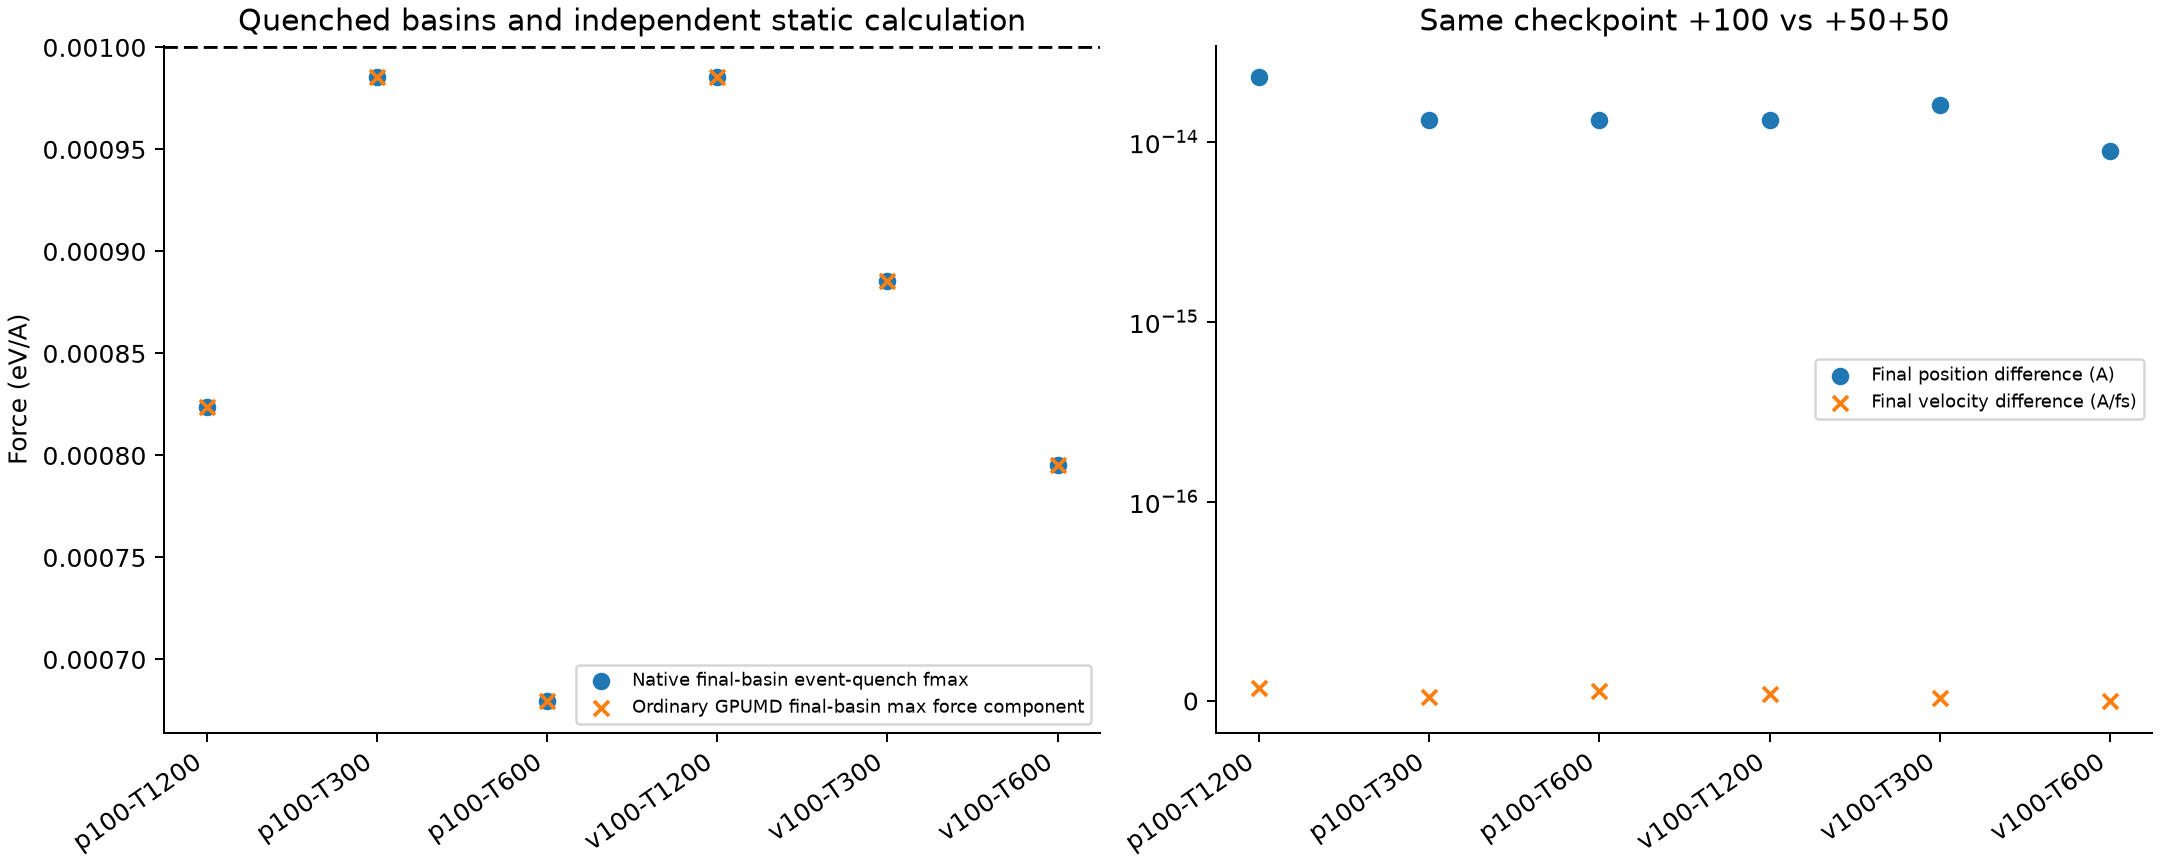
本次六个条件的两条最终分支:
| 核对项 | 最大实际差异 |
|---|---|
| 事件/时钟/阶段计数 | 完全相同 |
| 逐事件淬火能量 | 原生输出精度下0 |
| 最终坐标及盆地坐标 | 2.31×10⁻¹⁴ Å |
| 最终速度 | 6.94×10⁻¹⁸ Å/fs |
所有原生事件的淬火fmax均小于0.001 eV/Å。脚本还用普通 gpumd 对最终盆地做零时间步静态计算,全部受力分量满足本例的小力条件,与同盆地原生能量每原子差小于9×10⁻¹⁶ eV。这是同一模型的数值与接口核对,不是新的DFT准确性验证。
head -n 2 reference-results/p100-T300/static-final-basin/static.xyz
cat analysis/metrics.csv
静态文件包含真实65原子受力,图中把最终原生盆地的fmax与同一盆地普通GPUMD结果比较;CSV同时保留全部事件中的最大fmax,便于检查整个流程。
7. 按命令重新画自己的结果#
module load ase/3.29.0
python3 analyze.py --new --case p100-T300
head -n 8 analysis-new/atom-displacements.csv
head -n 8 analysis-new/clock-reconstruction.csv
ls figures-new
参考数据用 bash view.sh;若同名分析目录已经存在,直接查看,重跑用新解压目录。本包脚本按固定250步协议工作,修改参数时也需调整相应解析设置。
更多格式操作见XYZ、NetCDF与普通续算,分组输出见Si/Ge分组与固定边界。这些普通GPUMD输出命令不全部适用于 gpumd_replica。当前程序与模型选择说明各入口的适用范围。