
GPUMD PRD:准备硅间隙原子并运行
用真实官方硅势建立65原子间隙结构,提交单卡双副本PRD,检查盆地重排与输出文件。
阅读本篇目录
本篇使用鸢算科技集群 GPUMD 5.9.1 的 gpumd_replica,以65原子硅间隙结构演示“准备模型→提交PRD→查看几何盆地事件→读取并画图”。P100和V10016G各运行300、600、1200 K三个条件。
本例是短流程教程,不用于迁移速率或扩散系数。 六个条件都在第1步出现几何盆地重排,起点不代表已建立长寿命平衡盆地。原始早期事件全部保留;参数与结果的含义见下一篇事件时钟与续算。
1. 下载并先读参考结果#
下载完整输入、原生输出和绘图脚本,保存为 gpumd-prd-Si65-wave223.zip:
unzip gpumd-prd-Si65-wave223.zip -d si-prd
cd si-prd
bash view.sh
cat analysis/metrics.csv
ls figures
view.sh 加载 ASE 3.29.0,用ASE读取真实XYZ、检查点和静态受力,再由NumPy/Matplotlib整理。它只处理已提供的数据,不启动GPU计算。逐事件信息在 analysis/events.csv,所有65个原子的位移在 analysis/atom-displacements.csv。
GPUMD本批构建使用 CUDA/nvcc 12.9.86、GCC 13.3.0,P100与V10016G分别对应sm_60和sm_70;PLUMED 2.10.1、NetCDF-C 4.10.1随GPUMD模块提供。新任务使用下面的匹配环境,不需要 mpirun。
2. 结构与势文件#
结构为2×2×2金刚石常规晶胞的64个Si,再在四面体间隙位加入1个Si,固定10.86 Å周期立方盒。势为官方 Si_2022_NEP4_4body.txt,随包命名为 inputs/nep.txt,原始文件头和全部参数未改。
head -n 6 inputs/nep.txt
head -n 10 inputs/model.xyz
展开完整65原子model.xyz
65
Lattice="10.86 0 0 0 10.86 0 0 0 10.86" Properties=species:S:1:pos:R:3 pbc="T T T"
Si 0 0 0
Si 0 2.715 2.715
Si 2.715 0 2.715
Si 2.715 2.715 0
Si 1.3575 1.3575 1.3575
Si 1.3575 4.0725 4.0725
Si 4.0725 1.3575 4.0725
Si 4.0725 4.0725 1.3575
Si 0 0 5.43
Si 0 2.715 8.145
Si 2.715 0 8.145
Si 2.715 2.715 5.43
Si 1.3575 1.3575 6.7875
Si 1.3575 4.0725 9.5025
Si 4.0725 1.3575 9.5025
Si 4.0725 4.0725 6.7875
Si 0 5.43 0
Si 0 8.145 2.715
Si 2.715 5.43 2.715
Si 2.715 8.145 0
Si 1.3575 6.7875 1.3575
Si 1.3575 9.5025 4.0725
Si 4.0725 6.7875 4.0725
Si 4.0725 9.5025 1.3575
Si 0 5.43 5.43
Si 0 8.145 8.145
Si 2.715 5.43 8.145
Si 2.715 8.145 5.43
Si 1.3575 6.7875 6.7875
Si 1.3575 9.5025 9.5025
Si 4.0725 6.7875 9.5025
Si 4.0725 9.5025 6.7875
Si 5.43 0 0
Si 5.43 2.715 2.715
Si 8.145 0 2.715
Si 8.145 2.715 0
Si 6.7875 1.3575 1.3575
Si 6.7875 4.0725 4.0725
Si 9.5025 1.3575 4.0725
Si 9.5025 4.0725 1.3575
Si 5.43 0 5.43
Si 5.43 2.715 8.145
Si 8.145 0 8.145
Si 8.145 2.715 5.43
Si 6.7875 1.3575 6.7875
Si 6.7875 4.0725 9.5025
Si 9.5025 1.3575 9.5025
Si 9.5025 4.0725 6.7875
Si 5.43 5.43 0
Si 5.43 8.145 2.715
Si 8.145 5.43 2.715
Si 8.145 8.145 0
Si 6.7875 6.7875 1.3575
Si 6.7875 9.5025 4.0725
Si 9.5025 6.7875 4.0725
Si 9.5025 9.5025 1.3575
Si 5.43 5.43 5.43
Si 5.43 8.145 8.145
Si 8.145 5.43 8.145
Si 8.145 8.145 5.43
Si 6.7875 6.7875 6.7875
Si 6.7875 9.5025 9.5025
Si 9.5025 6.7875 9.5025
Si 9.5025 9.5025 6.7875
Si 2.715 2.715 2.715
模型与许可来源见 DATA-SOURCE.md 和 LICENSES。这是官方示例势在本例结构上的实际计算,不据此保证所有硅缺陷物性的精度。
3. 生成目录,提交一个条件#
source /etc/profile
module load ase/3.29.0
python3 prepare.py
cd cases/p100-T300
sbatch job.slurm
squeue -u "$USER"
V10016G用户选择 cases/v100-T300,也可按目录名选择600或1200 K。六个模板供对照,第一次提交一个匹配自己GPU的条件即可。默认脚本为核时分区;套餐用户先用 yskit 选择本人可用分区和同型号GPU环境。
展开完整P100提交脚本
#!/bin/bash
#SBATCH --job-name=Si-interstitial-PRD
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --time=00:20:00
#SBATCH --output=prd-%j.out
set -eo pipefail
source /etc/profile
module purge
module load cuda/12.9 gpumd/5.9.1-p100
export OMP_NUM_THREADS=1 OPENBLAS_NUM_THREADS=1 MKL_NUM_THREADS=1
cd "$SLURM_SUBMIT_DIR"
python3 -B ../../run_prd.py
python3 -B ../../run_static.py
每个作业只申请1张GPU、1个CPU核心,2个副本同卡运行。程序在计算节点执行;不要在登录节点直接启动 gpumd_replica。
4. 看懂PRD输入#
第一个150步计算的 checkpoint150/run.in:
potential nep.txt
time_step 0.5
ensemble nvt_bdp 300 300 100
multi_replica prd replicas 2 2 event 1 dephase 10 correlate 10 distance 0.5 quench 0.001 4000 max_dephase_retries 50
dump_xyz -1 0 1 events.xyz
run 150
potential读取原始NEP4硅势,time_step 0.5表示0.5 fs。- PRD使用固定温度的
ensemble nvt_bdp T T tau。300 300 100是300 K、耦合参数100步。 replicas 2 2是2个独立副本、每GPU最多2个,不是空间扩胞。event 1每个计入的MD步检查事件,最小化次数较多,适合本例清楚展示时钟。较大检查间隔可能漏掉块内离开后又返回的事件。correlate 10要求连续10个无事件步;发生关联事件后重新累计。新参考轨迹也先经过关联阶段。dephase 10要求去相位试探连续10步留在同一盆地,逃逸试探会重置并重新赋速;max_dephase_retries 50限制试探次数。distance 0.5是两次最小化构型的最大原子最小镜像位移阈值,单位Å;必须小于最短周期盒厚度的一半。quench 0.001 4000是原生最小化的受力阈值0.001 eV/Å和最多4000步。最小化不收敛时先检查结构、势和参数。- PRD的
dump_xyz -1 0 1 events.xyz保存淬火盆地坐标。当前PRD入口不接受普通GPUMD的所有输出选项,也不输出热速度轨迹。
这些5 fs的关联/去相位窗口只为演示操作,没有证明满足正式稀有事件动力学条件。若要换成自己的体系,应先确认盆地稳定性、模型范围和合适的时间尺度。
5. 实际执行顺序#
一次提交自动完成:
- 150个计入的MD步建立完整检查点。
- 从同一检查点分叉,一条继续100步,另一条继续50步再50步。
- 对最终保存的同一个盆地,用普通
gpumd做零时间步静态能量与受力核对。
两条最终路径均到250步、125 fs;另一条重复路径用于比较续算,不是独立统计样本。run 不计去相位和最小化等额外工作。
ls checkpoint150 direct fork static-final-basin
head -n 8 direct/prd_events.out
head -n 2 direct/events.xyz
prd_events.out 记录事件计数、累计时钟、获胜副本、最大位移和最小化结果;events.xyz 第一个结构是初始盆地,之后每帧对应一个事件。完整检查点的文件和续算方法见下一篇。
6. 结构图与六个实际结果#
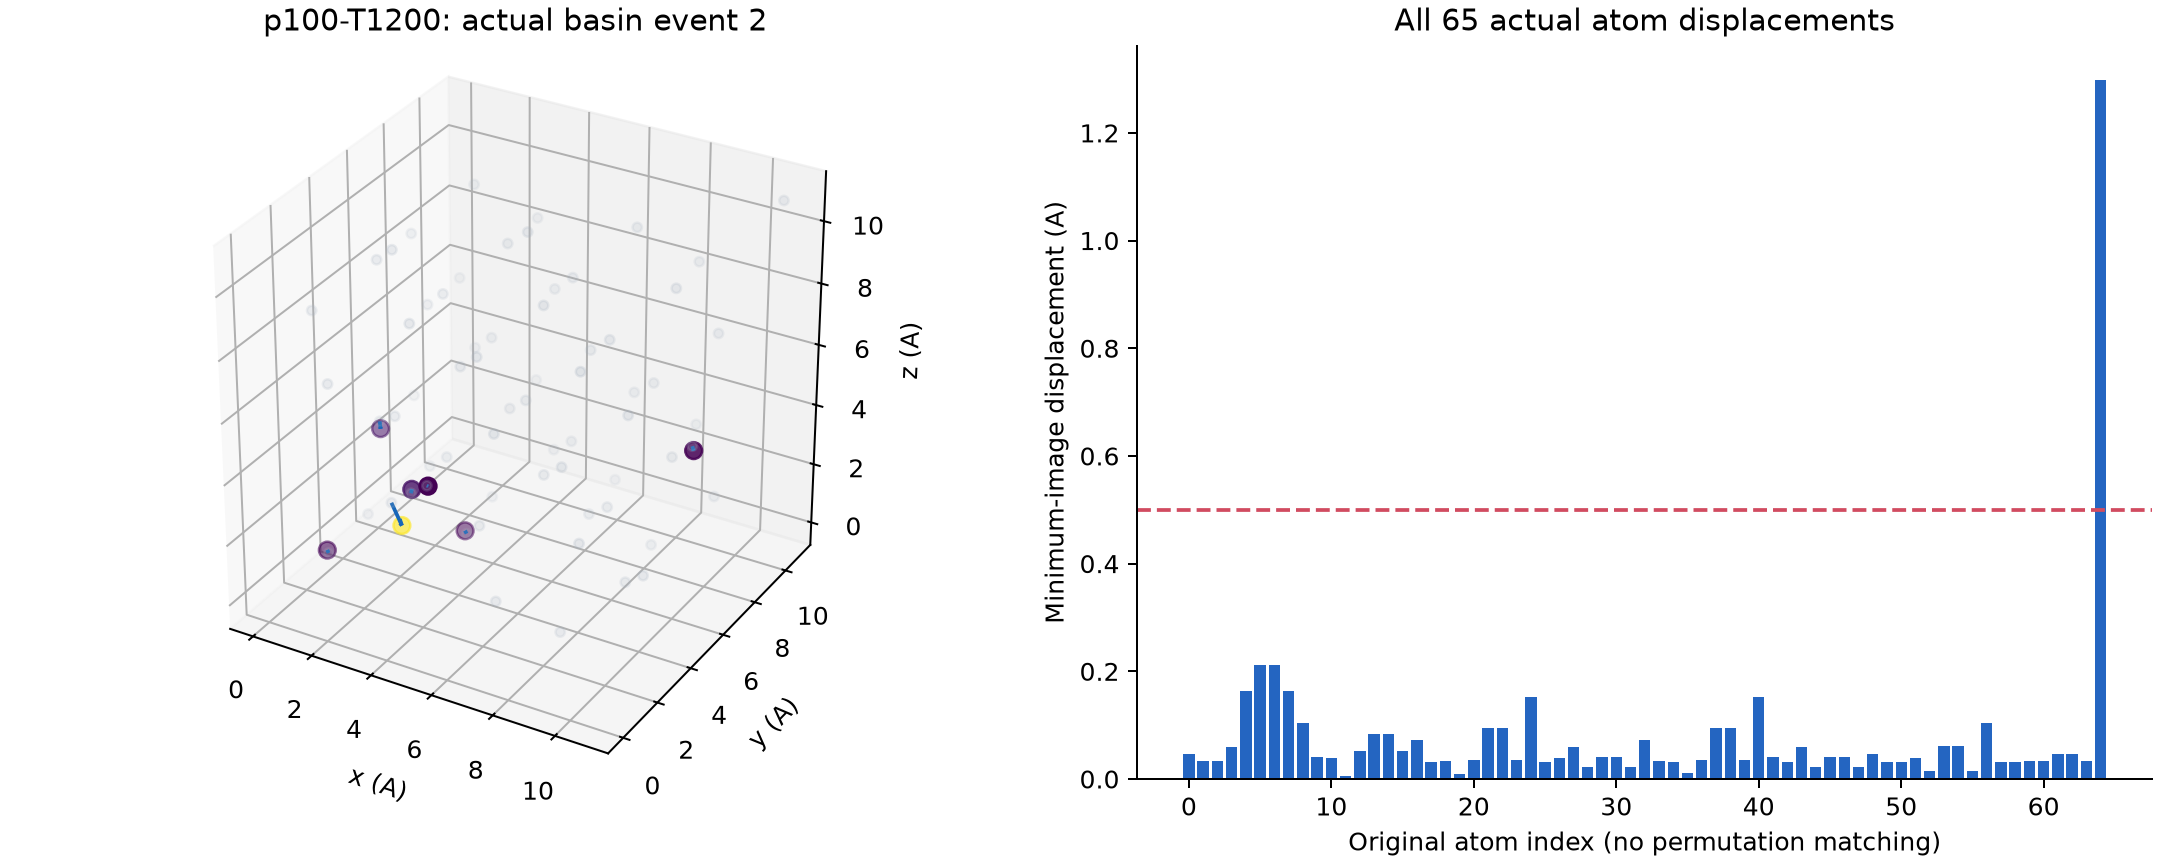
图示为P100、1200 K条件的第2个事件:灰色点是上一盆地,着色点与箭头展示新盆地中位移超过0.15 Å的原子,右图列出全部65个原子的最小镜像位移。最大位移约1.3 Å,体现局域几何重排;不据此直接称为长程缺陷扩散。
下表取各条件的 direct 最终分支,未重复统计另一条相同检查点分支:
| 条件 | 事件总数 | 其中关联事件 | 最终时钟步数 | 累计时钟时间(fs) |
|---|---|---|---|---|
| p100-T1200 | 2 | 1 | 478 | 239.0 |
| p100-T300 | 8 | 2 | 425 | 212.5 |
| p100-T600 | 1 | 1 | 489 | 244.5 |
| v100-T1200 | 2 | 1 | 478 | 239.0 |
| v100-T300 | 4 | 1 | 458 | 229.0 |
| v100-T600 | 7 | 1 | 426 | 213.0 |
所有条件的计入MD步数均为250、步长0.5 fs。不同温度/设备的少量事件数不用于比较迁移速率或硬件性能;随机初态、早期重排、盆地定义和短采样都会影响这些数值。
7. 重新分析自己的结果#
任务结束后回到包根目录:
cd ../..
module load ase/3.29.0
python3 analyze.py --new --case p100-T300
cat analysis-new/metrics.csv
head -n 8 analysis-new/events.csv
ls figures-new
替换为自己完成的目录名,重跑使用新解压目录。分析脚本按本包固定步数与格式整理,改动体系或流程后也要相应调整解析参数。输入生成函数在 run_prd.py 的 inputs(),参考脚本会重新生成子目录输入;不要只改某个已生成的 run.in 就期待下一次脚本沿用改动。