
GPUMD 黏度统计:多种子、积分窗口与噪声
比较 Ar108、Ar256 的四种子真实结果,用积分窗口与 Student t 区间识别短轨迹噪声,避免把末点作为黏度。
阅读本篇目录
液体黏度实操已经得到原生应力相关和累计积分。本篇继续看:该取哪个相关时间、几个种子怎样平均、曲线看起来平了是否就能给材料数值。
下载完整输入、16 条真实轨迹和统计脚本。两种规模为 Ar108、Ar256;P100 与 V100 16G 分别各用 13579、24680、31415、27182 四个初速度种子,生产阶段各 40 ps。这里的 LJ 模型和短轨迹用于教学,没有给出收敛的真实氩黏度。
1 先生成所有实际曲线#
将下载文件保存为 gpumd-viscosity.zip,在新目录解压后执行:
unzip gpumd-viscosity.zip -d gpumd-viscosity
cd gpumd-viscosity
bash view.sh
ls analysis/figures
查看逐种子与聚合数据:
head analysis/p100-Ar108-seed-statistics.csv
head analysis/p100-Ar256-seed-statistics.csv
head analysis/SUMMARY.json
每个统计 CSV 包含相关时间、四个种子的剪切黏度积分、四种子均值和 95% 区间半宽,单位为 Pa·s。图上改用 mPa·s,数值乘 1000。
2 先分清三种时间#
本例有三个不同概念:
| 时间 | 本例设置 | 作用 |
|---|---|---|
| 生产轨迹时长 | 40 ps | 提供时间原点和应力样本 |
| 相关时间 | 0–9.98 ps | 一个应力样本与其后样本相隔多久 |
| 对积分曲线取平均的窗口 | 1–3、3–5、5–8 ps | 观察不同截断区间对估计值的影响 |
最大相关时间越长,可用样本对越少,噪声通常越大;增加相关窗口不等于增加轨迹长度。
本例三个积分窗口在统计前固定选定,用来比较变化。它们来自同一条累计积分曲线,彼此相关,不能把三个窗口当作三条独立轨迹来虚增重复次数。
3 多种子结果真实是什么样#
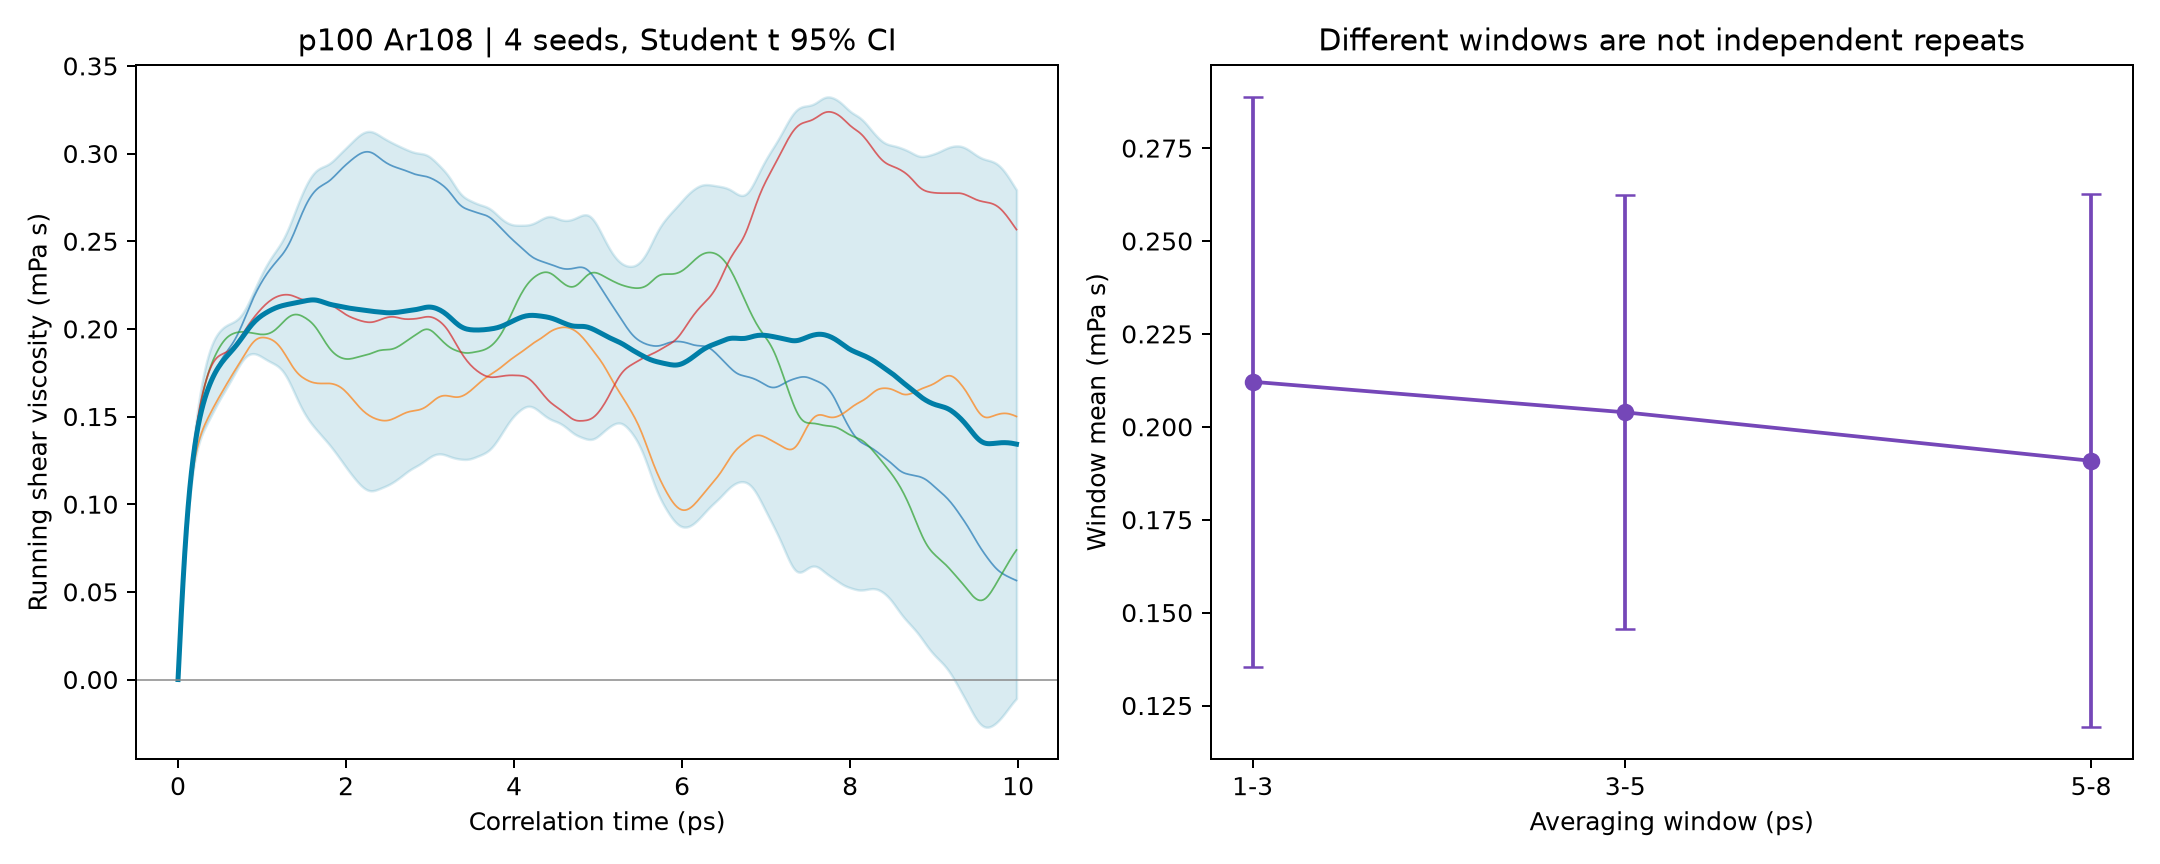
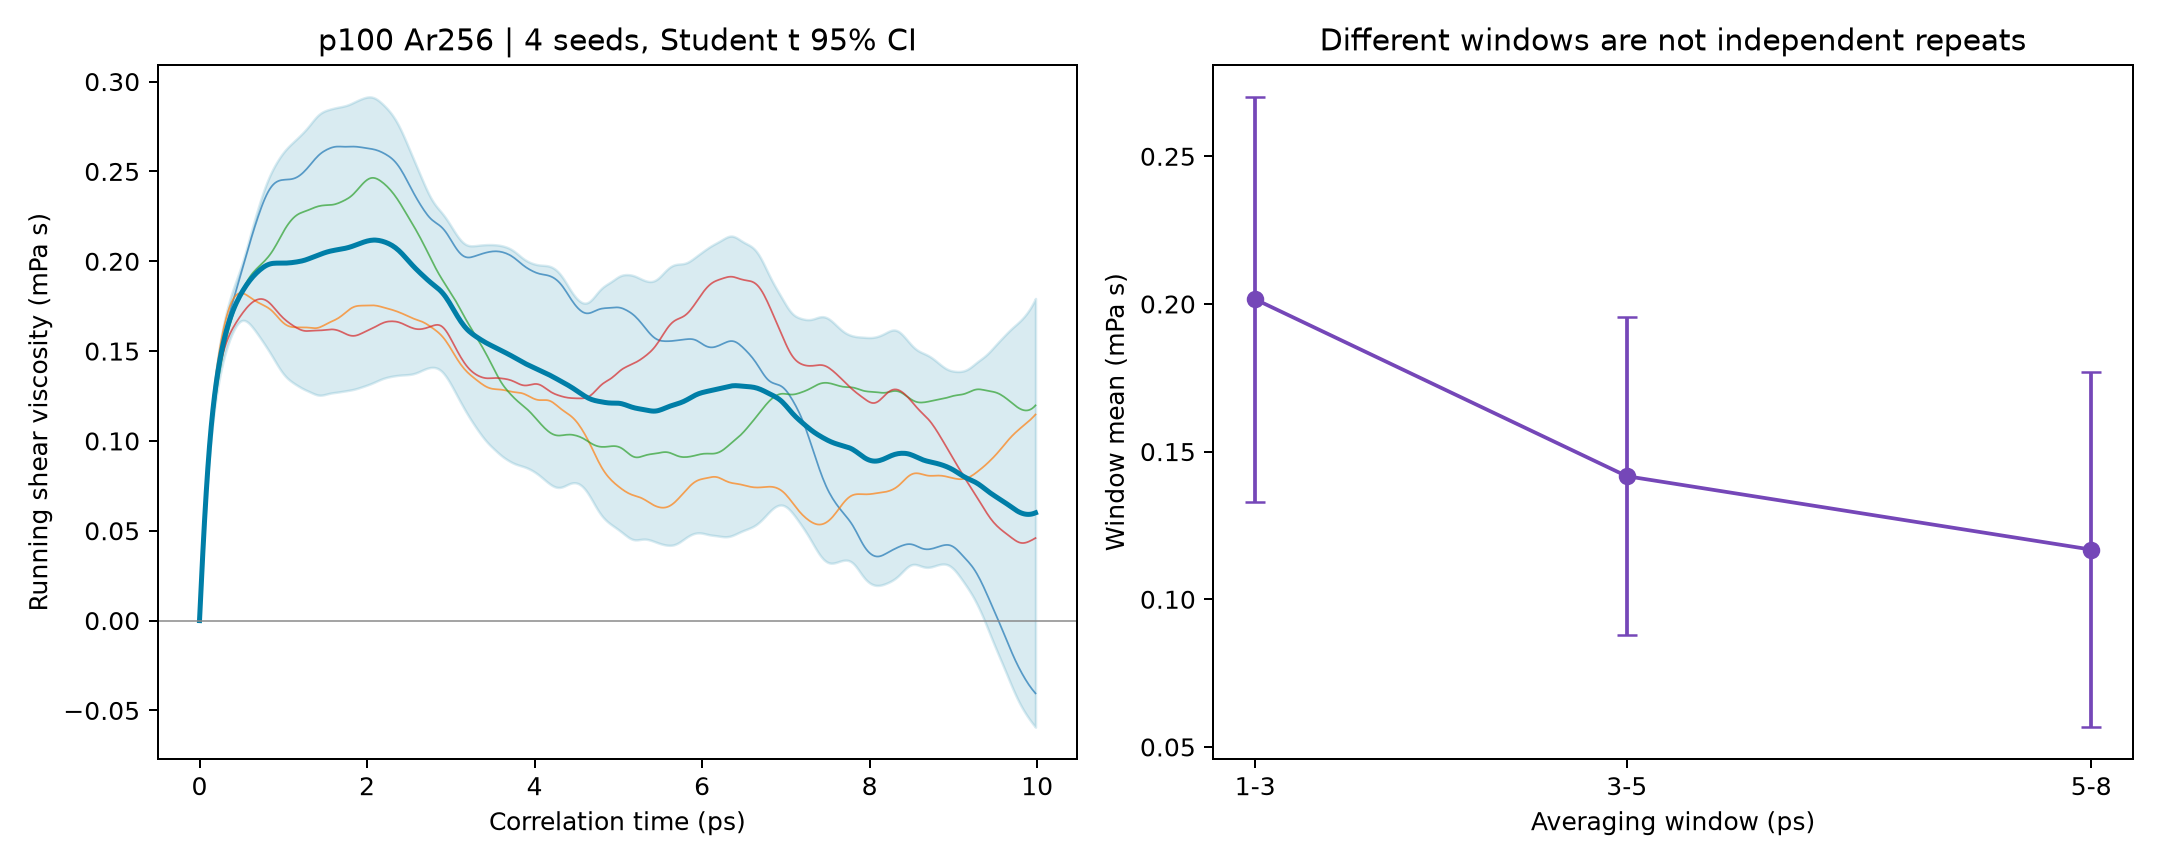
左侧细线是各个种子的实际结果,粗线为四种子平均,阴影为每个相关时间点的 Student t 95% 区间;右侧是在三个预定窗口中取平均后的结果及区间。
这些区间是逐点估计,不能理解为整条曲线同时具有 95% 覆盖率。只有四个重复时,区间对个别轨迹较敏感;还需要增加独立重复和生产时长。
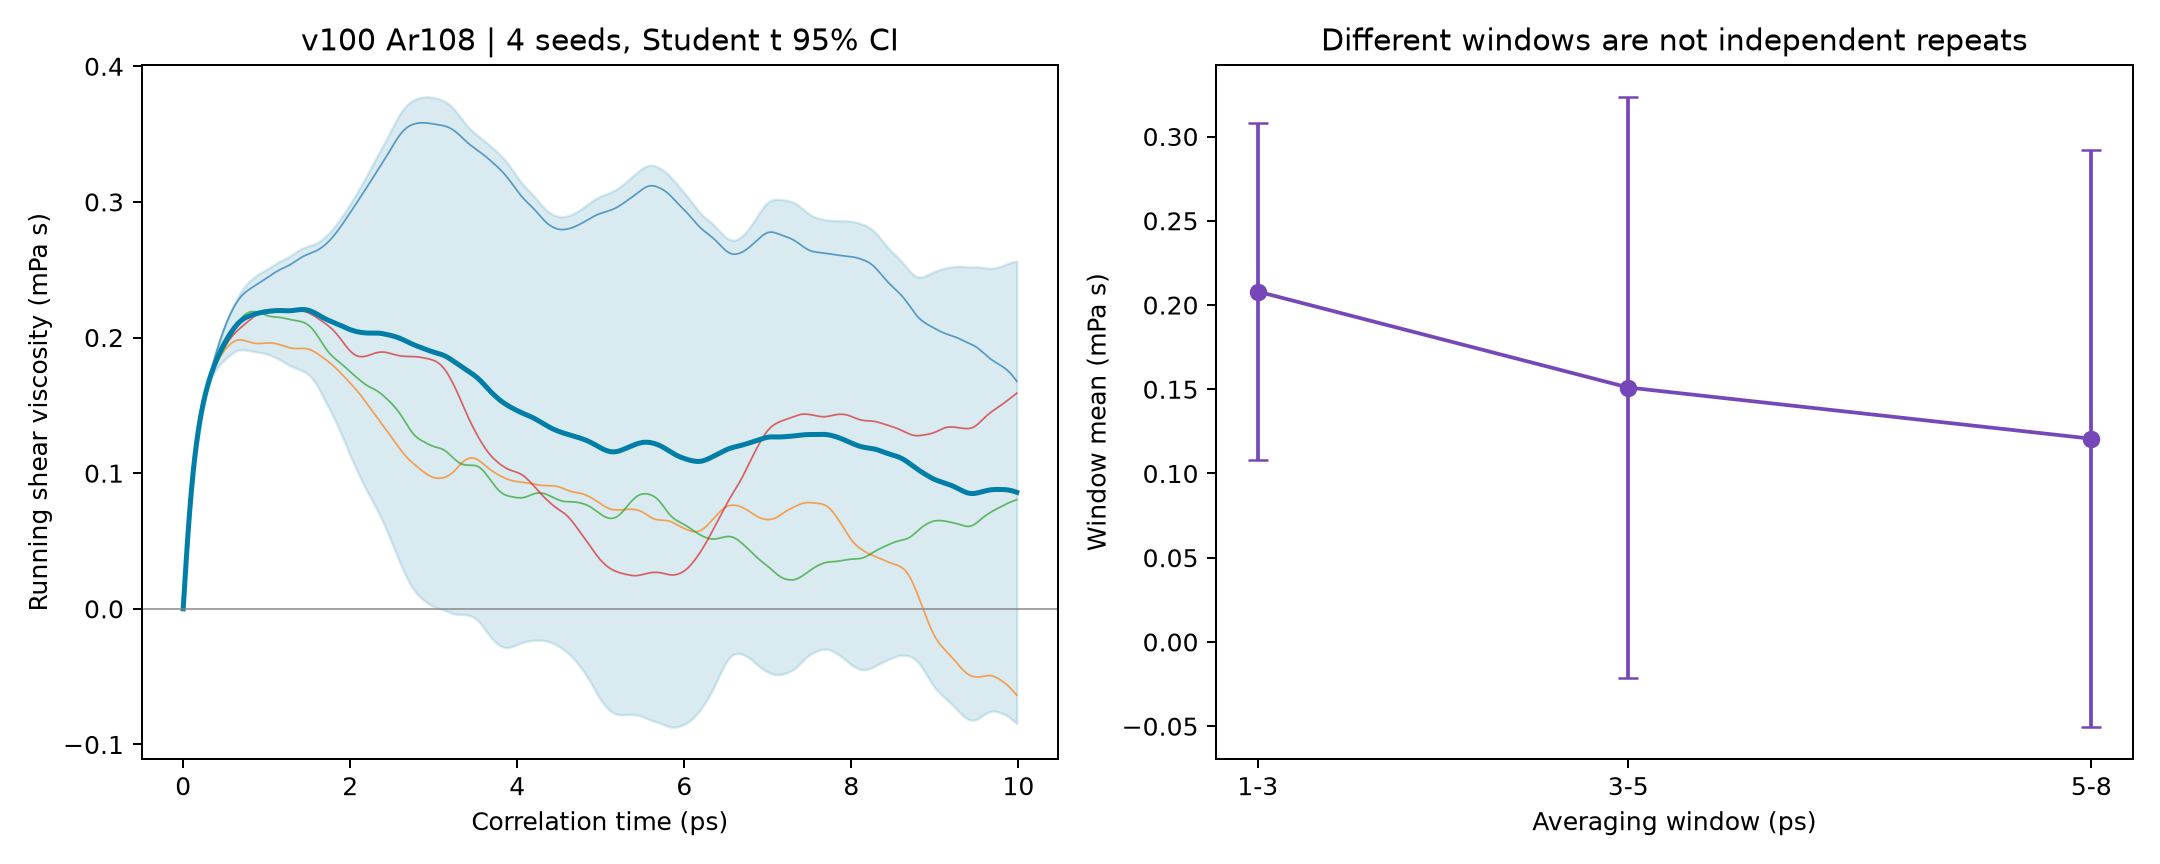
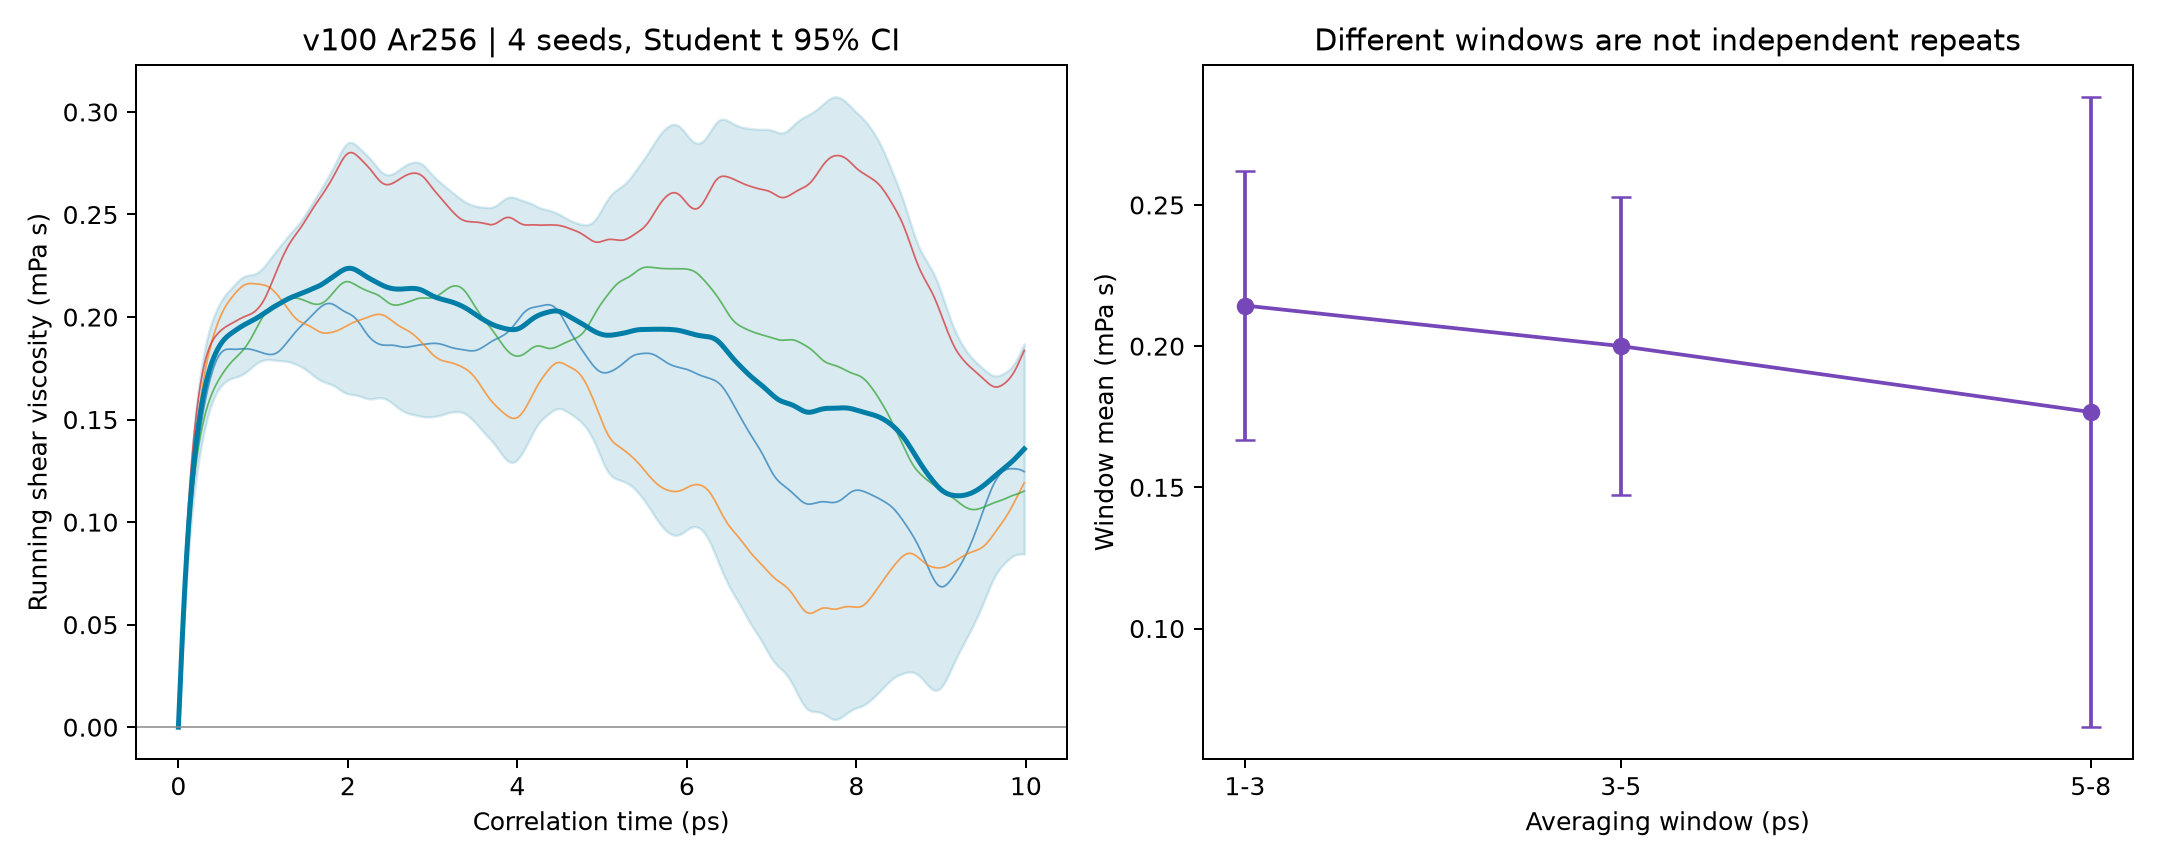
两种显卡的随机轨迹分别保留,没有人为对齐曲线或删掉波动较大的种子。它们说明相同教学流程在两种平台上可执行;采样噪声不能用来判断显卡的计算速度。
4 实际窗口均值如何读#
先看 1–3 ps 窗口;表中的“±”为四种子 Student t 95% 区间半宽,单位 mPa·s:
| 实际数据组 | 窗口均值与区间半宽 |
|---|---|
| P100,Ar108 | 0.212121 ± 0.076649 |
| P100,Ar256 | 0.201567 ± 0.068538 |
| V100 16G,Ar108 | 0.207990 ± 0.099935 |
| V100 16G,Ar256 | 0.214370 ± 0.047605 |
不能因为这一个窗口的四个均值接近,就跳过后续窗口。例如 P100、Ar108 的三个窗口均值依次约为 0.212121、0.203895、0.190848 mPa·s,而 P100、Ar256 依次约为 0.201567、0.141680、0.116818 mPa·s。窗口拉长后,均值与区间都有变化。
部分较长窗口的置信区间跨过零,表示有限样本无法把该窗口的积分估计与零清楚区分,不能解释成材料具有负剪切黏度,也不应只保留正值种子。
5 Student t 区间怎样计算#
对某个固定窗口,每条独立轨迹先给出一个窗口均值 x,再对四个 x 统计:
mean = average(x1, x2, x3, x4)
s = sample_standard_deviation(x1, x2, x3, x4)
95% halfwidth = t(0.975, df=3) × s / sqrt(4)
t(0.975, df=3) ≈ 3.182446
资料包使用 SciPy 计算 t 分位数,保留每个种子的数值。独立重复单位是不同初始条件的完整轨迹;不能把相邻应力帧、三个剪切方向或几个重叠窗口当作新的独立样本。
这种区间反映相同参数下有限重复的统计差别,不能覆盖势函数误差、有限尺寸、截断方式或平衡不足等系统误差。
6 下一步该延长什么#
先查看原始数据和曲线,再决定:
- 若 RDF、MSD、温度或能量还在明显变化,先检查体系状态和延长平衡。
- 若相关函数的短时间部分可重复,而长时间尾部很吵,增加生产长度和独立种子,保留合理的相关窗口对照。
- 若换积分窗口后均值持续漂移,继续检查尾部噪声与平台,不直接取最后一点。
- 若两个规模仍有显著差别,继续增加尺寸并保持密度、势函数和统计定义一致。
当前这批 40 ps 生产结果仍有明显种子和窗口差异,应作为方法示例与继续采样的起点。
修改输入时,在独立新目录编辑 run.in,同时注意:
compute_viscosity 10 500
run 20000
第二行决定生产步数;10×500×2 fs 决定相关窗口长度。只改 500 会增加相关窗口,不能代替增加生产样本。
本资料包的 analyze.py 对给定 2000 个样本和 500 个相关点做读取与核对。延长自己的任务后,要同步调整分析程序的长度检查,不能只把新文件覆盖进参考目录。
7 使用 GPUMDkit 与统计脚本各看什么#
单条原生输出可以直接:
module load gpumdkit/1.5.8
gpumdkit.sh -plt viscosity save
多种子与窗口统计使用资料包的 bash view.sh,或读取各自 seed-statistics.csv 做进一步分析。一个便于操作的顺序是:先看单条应力相关和积分,再比较四个种子,再比较窗口和规模,最后才给经过统计支持的材料结论。
NVE 实际温度与黏度分母#
当前原生黏度分母沿用恒温阶段的目标温度。先读取 NVE 实际均温;同一轨迹改用实际温度分母时乘 Ttarget/Tmean,不要使用热导的平方因子。此操作只改归一化,不把采样温度变回目标值,也不消除短轨迹噪声。真实 Si 与 LJ 操作对照见NVE 温度与输运归一化。