
GPUMD 液体黏度:从输入到应力相关积分
用 Ar108、Ar256 的实际 LJ 液体轨迹,完成熔化、平衡、NVE 生产、GPUMDkit 作图与黏度单位核对。
阅读本篇目录
本篇使用简单 LJ 液体,说明 GPUMD 的 compute_viscosity 怎样从应力自相关得到 Green–Kubo 黏度。流程为:准备结构和势文件,熔化,降温平衡,NVE 生产,读取应力相关和积分,再检查种子与窗口差异。
下载完整输入、真实轨迹、原生输出和后处理程序。包含 P100、V100 16G,两种规模各四个初速度种子,共 16 条实际生产轨迹。统计分析接多种子、积分窗口与噪声。
1 先看体系:简单液体模型#
初始结构为 FCC Ar,常规胞晶格常数 5.74 Å,分别复制为 108 原子和 256 原子。周期盒边长为 17.22 Å、22.96 Å,质量密度约 1.40 g/cm³。经过熔化和平衡后再进行生产。
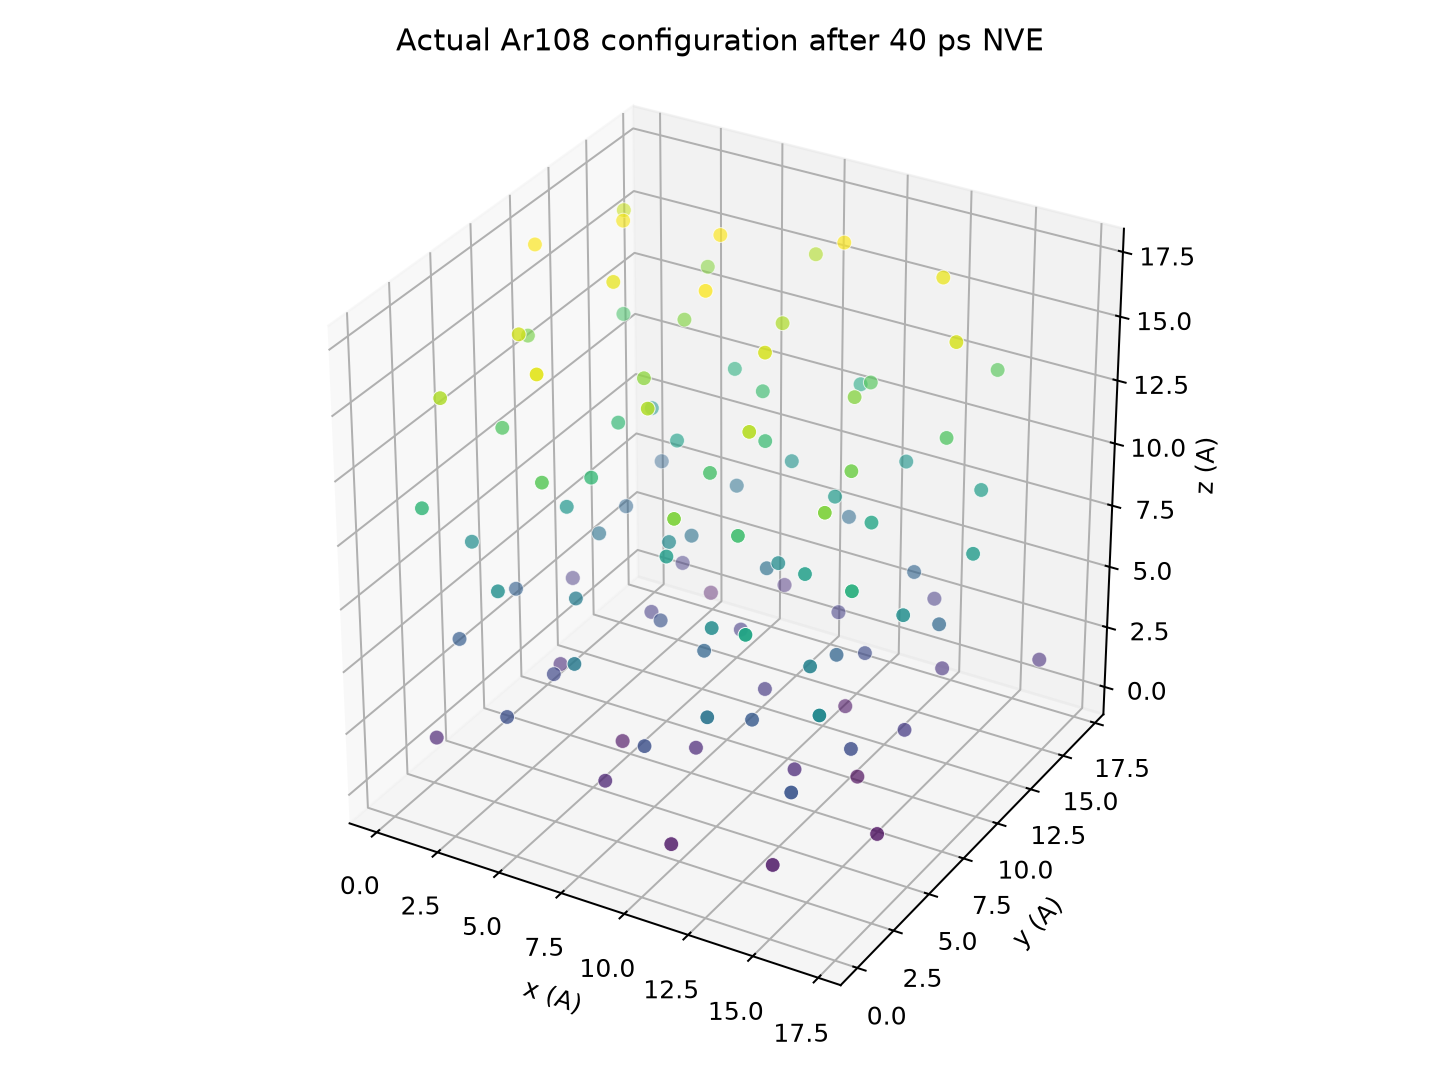
图中是实际末帧坐标,使用周期边界;初始 FCC 排列与最终液体构型应区分。生产阶段的实际 MSD 在 9.98 ps 相关时间处已明显超过 1 Ų,配合 RDF 和轨迹观察扩散运动。
potential.txt 完整内容为:
lj 1 Ar
0.01042 3.405 8.5
依次是 ε=0.01042 eV、σ=3.405 Å、势截断 8.5 Å。GPUMD 的这个 LJ 入口使用未平移、未平滑的截断势,截断处有不连续性,需要查看能量变化。本例用于教操作和单位,未建立真实氩的高精度输运参数。
2 先处理配套结果,再提交一个新任务#
将下载文件保存为 gpumd-viscosity.zip,在新目录解压:
unzip gpumd-viscosity.zip -d gpumd-viscosity
cd gpumd-viscosity
bash view.sh
ls analysis/figures
view.sh 处理已提供的实际数据,调用 ASE 读取结构、独立应力相关计算、Student t 统计和 GPUMDkit 作图,不提交 MD。
开始一个新的 P100 算例:
python3 prepare.py
cd cases/p100-Ar108-s13579
sbatch job.slurm
squeue -u "$USER"
使用 V100 16G 时选择 cases/v100- 开头的对应目录。每个脚本申请 1 GPU、1 CPU,先做固定构型的能量与力检查,再运行 MD。当前程序为 GPUMD 5.9.1,GCC 13.3、CUDA 12.9 构建;GPUMDkit 为 1.5.8。
3 完整的 MD 输入#
108 原子、种子 13579 的 md/run.in 为:
potential potential.txt
velocity 200 seed 13579
time_step 2
ensemble nvt_bdp 200 200 100
run 10000
ensemble nvt_bdp 100 100 100
run 10000
ensemble nve
compute_viscosity 10 500
compute_msd 10 500
compute_rdf 6.5 130 100
dump_thermo 10
dump_xyz 1000 trajectory.xyz velocity force precision double
run 20000
每步 2 fs:先在 200 K 运行 20 ps,随后在 100 K 平衡 20 ps,再做 40 ps NVE 生产。需要检查实际轨迹、温度、能量和扩散行为,不能仅凭写了高温阶段就认定体系已熔化。
compute_viscosity 10 500 表示每 10 步采一个应力样本,样本间隔 20 fs;生产阶段有 2000 个应力样本,输出 500 个相关点,相关时间从 0 到 9.98 ps。40 ps 生产时长与 9.98 ps 相关窗口是两件事。
RDF 的统计半径与势截断分别设置。当前 RDF 实现要求周期方向厚度至少覆盖约 2.5 倍 RDF 半径,因此小盒采用 6.5 Å;256 原子大盒采用 compute_rdf 8.5 170 100。两种盒的物理势截断均为 8.5 Å,未改变相互作用模型。比较 RDF 时看共同的距离范围。
velocity ... seed 控制初始速度。BDP 热浴还有自身随机过程,因此重复计算应比较流程和统计分布,不要求整条轨迹逐位相同。
4 提交脚本的核心内容#
资料包已给出全部模板。单独组织任务时,使用相应模块和资源:
#!/bin/bash
#SBATCH --job-name=LJ-viscosity
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --time=00:20:00
#SBATCH --output=md-%j.out
set -eo pipefail
source /etc/profile
module purge
module load cuda/12.9 gpumd/5.9.1-p100
export OMP_NUM_THREADS=1
cd "$SLURM_SUBMIT_DIR"
gpumd
这是直接在放有四个输入文件的 MD 目录运行的写法。配套模板的入口为 run_native.py,会自动建立静态与 MD 子目录并写入输入;自行修改物理参数时,可以复制生成的输入到独立新目录,再按上面的脚本提交。
5 先检查输出,再作图#
任务结束进入 MD 子目录:
head thermo.out
head viscosity.out
head msd.out
head rdf.out
thermo.out 给出温度、动能、物理势能、应力和晶胞;动能与势能相加后查看 NVE 能量变化。trajectory.xyz 的 Time 包含前面的熔化和平衡时间;资料包应力分析的时间从生产阶段重新计起,不把前 40 ps 平衡数据混入生产相关函数。
viscosity.out 共 19 列:
| 列(从 1 开始) | 内容 | 单位 |
|---|---|---|
| 1 | 相关时间 | ps |
| 2–10 | xx、yy、zz、xy、xz、yz、yx、zx、zy 的应力相关 | eV² |
| 11–19 | 对应分量的累计积分 | Pa·s |
这里参与相关的是包含动能项与 virial 的广延应力张量,不是直接把 GPa 数值平方。本实现先减去整条生产轨迹各分量均值,再对每个时滞的有效样本对求平均。
6 优先用 GPUMDkit 看原生曲线#
在含有 viscosity.out 的目录执行:
module load gpumdkit/1.5.8
gpumdkit.sh -plt viscosity save
ls viscosity.png
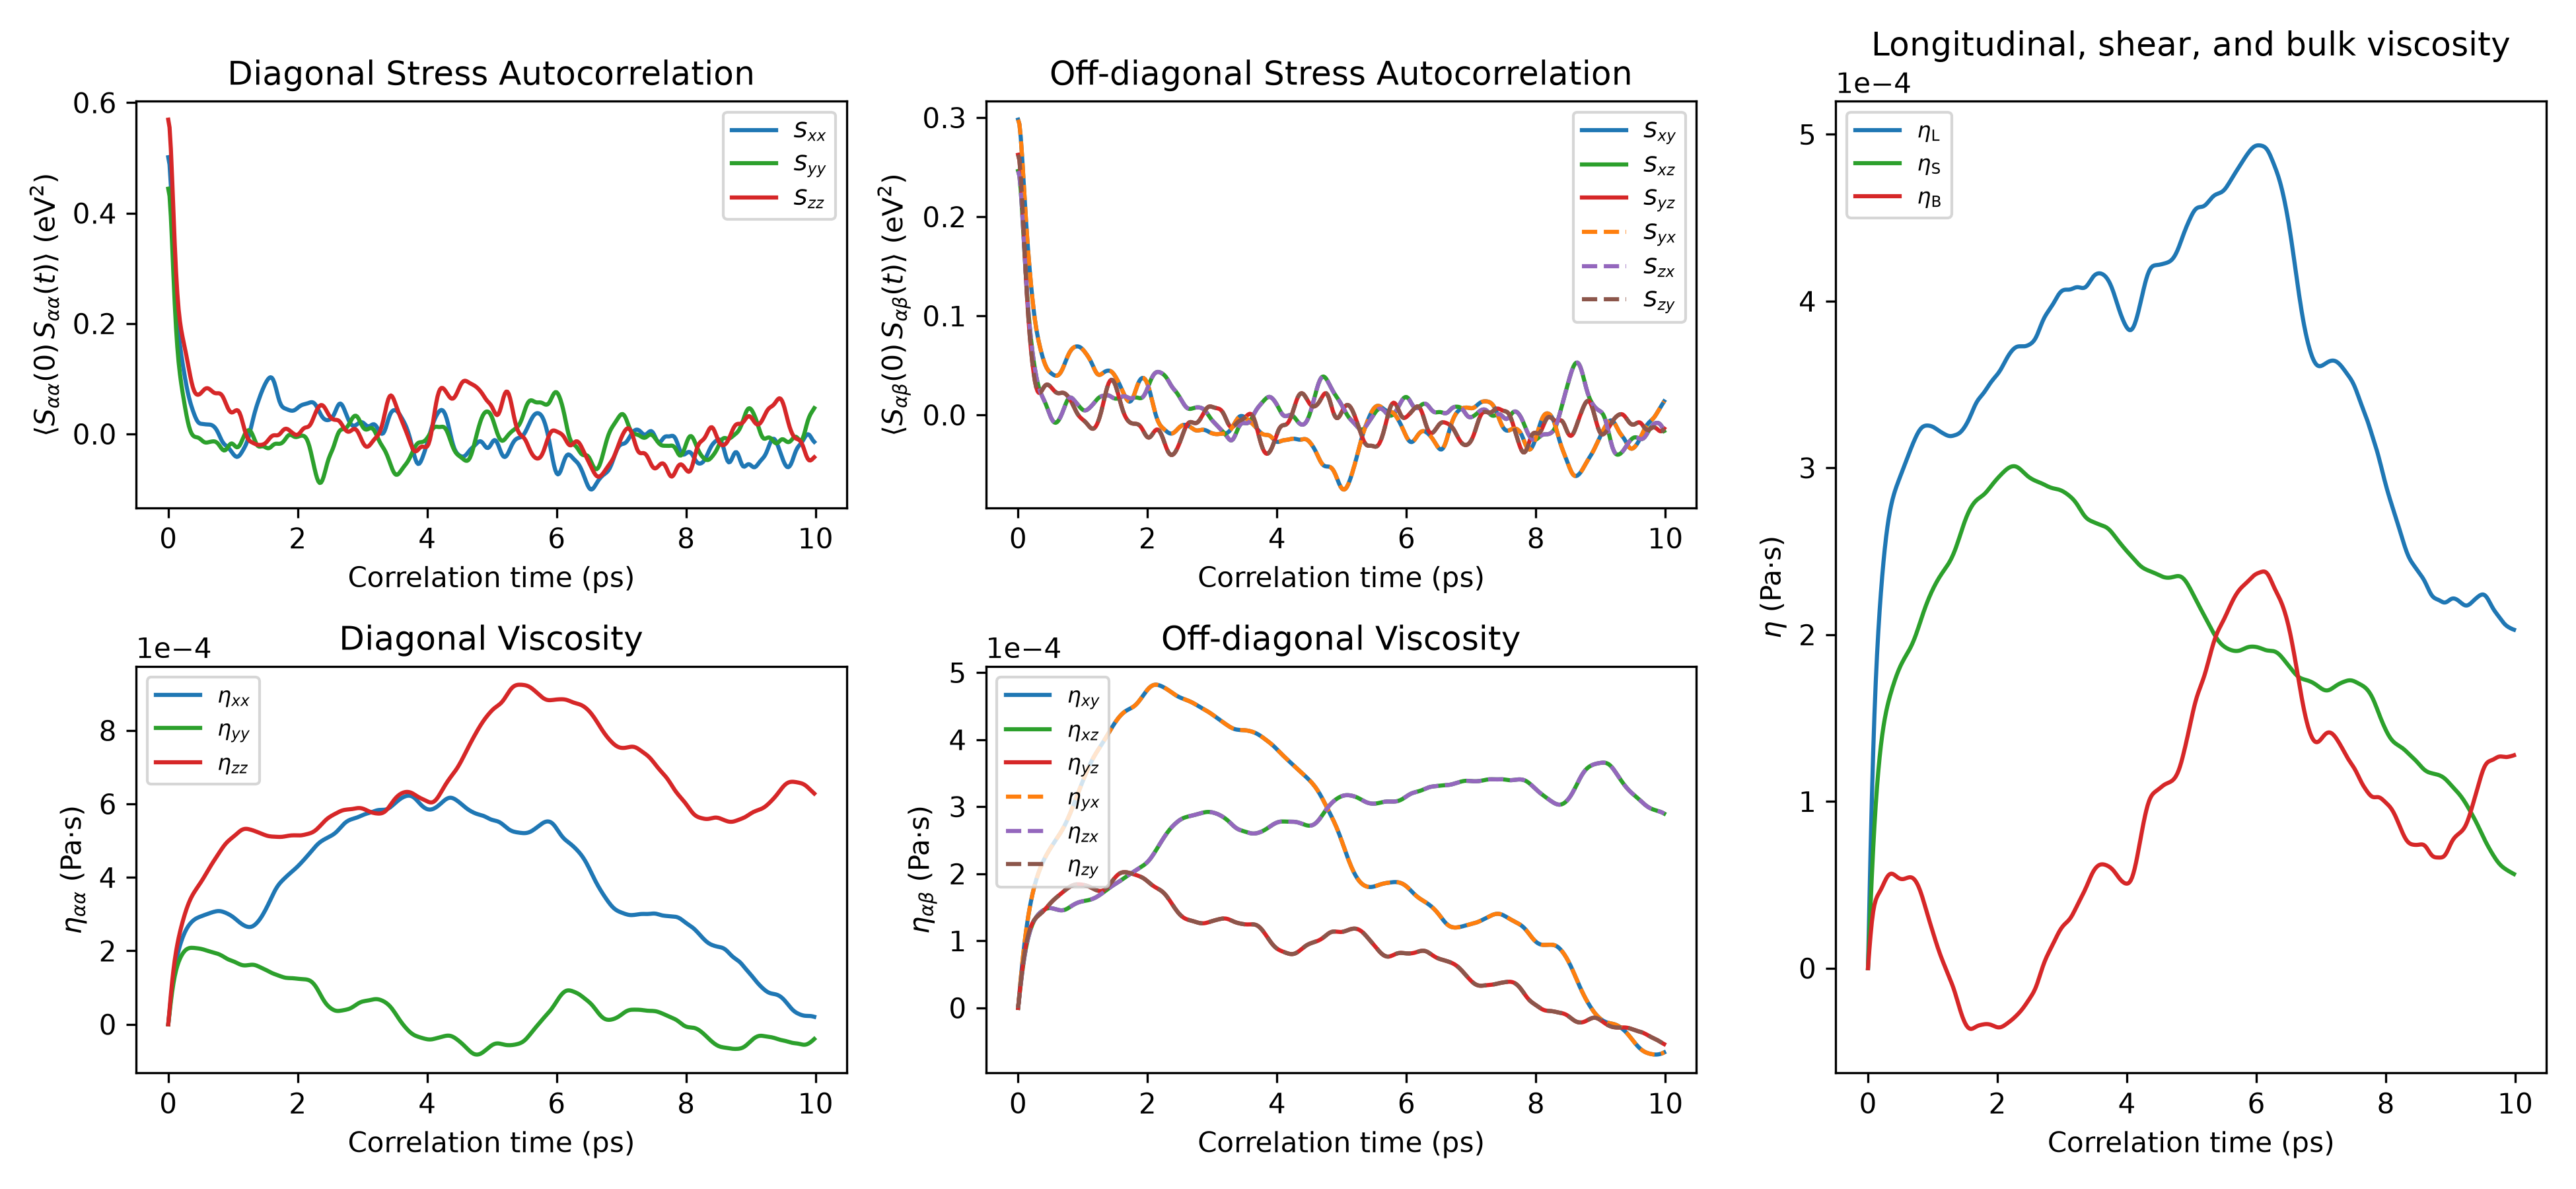
面板中包含多个张量分量和由分量组合得到的曲线。本例关注剪切黏度:
eta_shear(t) = [eta_xy(t) + eta_xz(t) + eta_yz(t)] / 3
1 Pa·s = 1000 mPa·s
不要把 xx、yy、zz 与剪切分量混合平均;也不要把每条曲线末点直接作为材料黏度。纵向、体积组合及短轨迹中的负值需要结合对应定义、物理条件和统计误差判断。
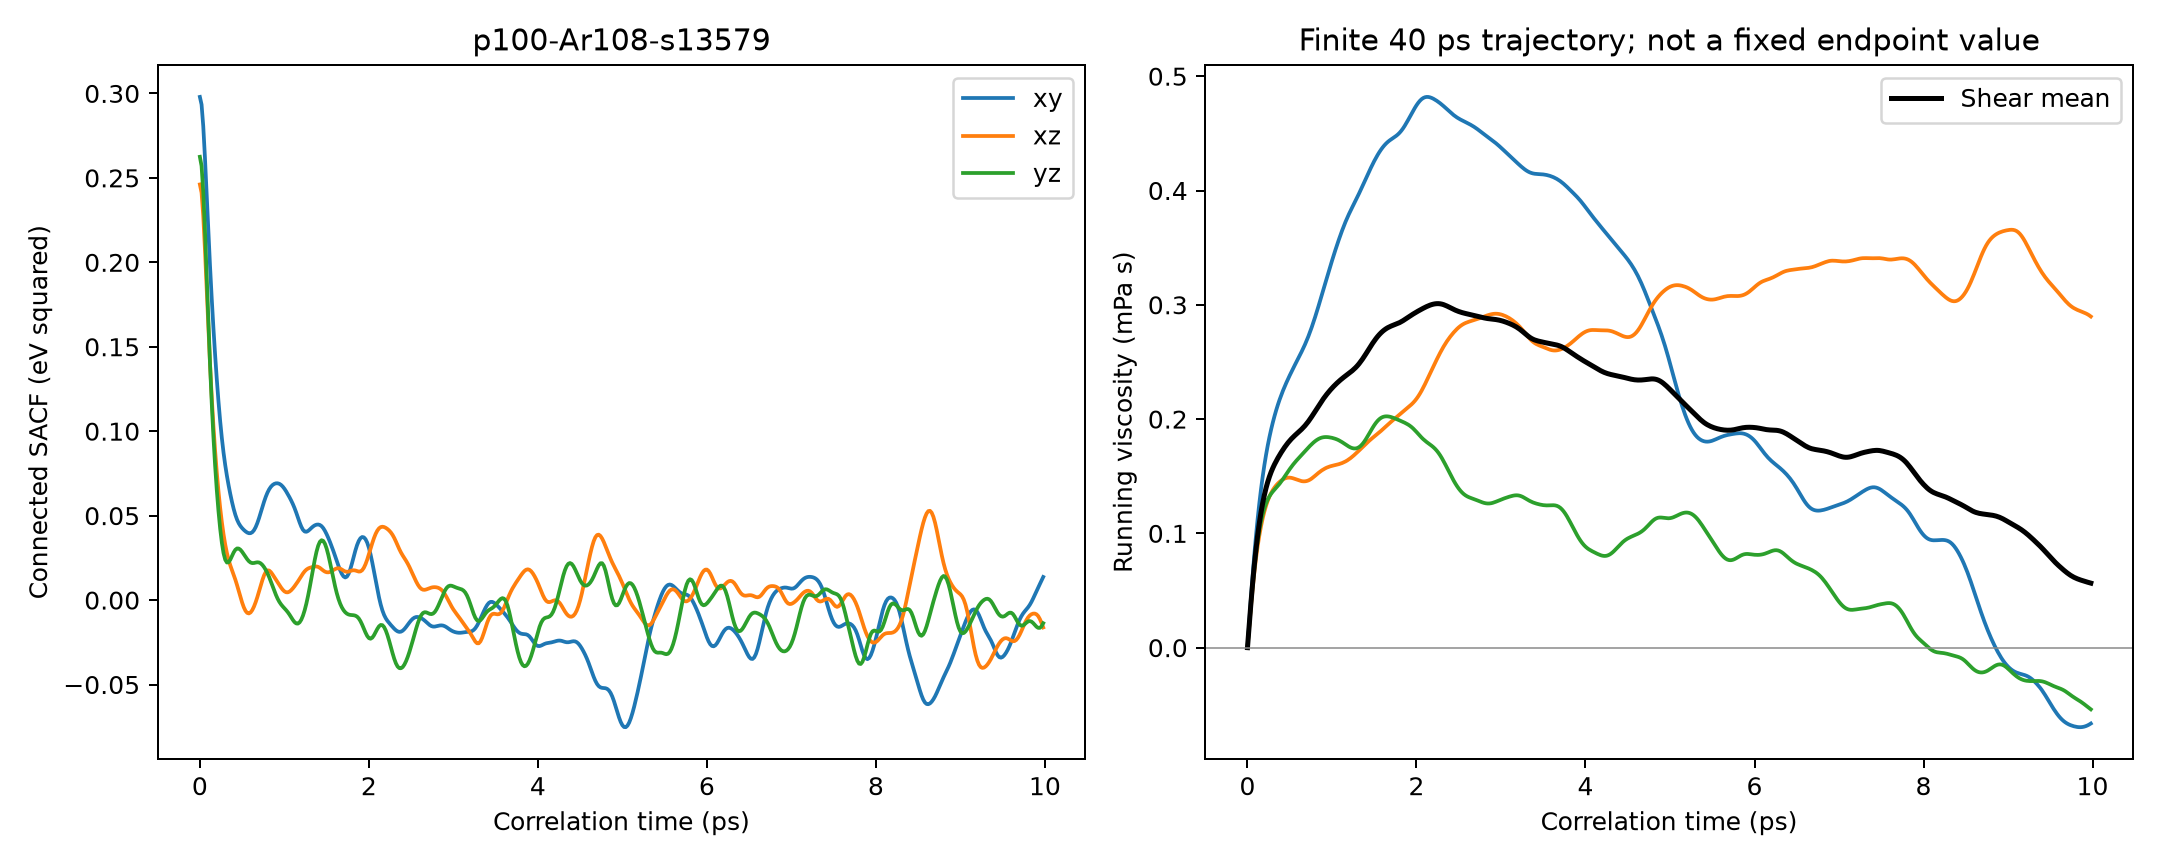
本图保留原始分量与符号。累计积分可能在较长相关时间处明显波动,下一篇用四个种子和三个窗口说明怎样判断。
7 从 thermo.out 独立核对相关函数与单位#
回到资料包根目录:
head analysis/p100-Ar108-s13579/SACF-check.csv
head analysis/p100-Ar108-s13579/viscosity-check.csv
程序先按 S = stress × V / 160.2177,将 GPa 和 ų 恢复为 eV;随后减均值并计算相关。时滞为 k、样本数为 N 时,使用 N−k 个有效样本对;FFT 结果另与直接点乘对照。
积分使用 eta = integral(C dt)/(kBT V),并做 GPa·ps 到 Pa·s 的换算。本例原生 NVE 黏度入口沿用前一个恒温阶段的 100 K 目标作温度分母,实际生产温度分布单独保留。
16 条生产轨迹中,从原生热力学应力独立重建的相关函数最大差约 5.80×10⁻¹² eV²,黏度积分最大差约 8.86×10⁻¹⁵ Pa·s。这说明读取、列顺序和单位转换一致,不能据此认为有限轨迹的统计噪声已经消失。
当前原生黏度入口采用 Green–Kubo。deform 的仿射变形本身不能自动替代带流速扣除、恒温处理和稳态检查的 SLLOD 剪切黏度方法;本例不把变形后的瞬时应力除以剪切率来报告稳态黏度。
格式可对照 compute_viscosity、viscosity.out,模型说明见 LJ 势。
NVE 实际温度与黏度分母#
当前原生黏度分母沿用恒温阶段的目标温度。先读取 NVE 实际均温;同一轨迹改用实际温度分母时乘 Ttarget/Tmean,不要使用热导的平方因子。此操作只改归一化,不把采样温度变回目标值,也不消除短轨迹噪声。真实 Si 与 LJ 操作对照见NVE 温度与输运归一化。