
GPUMD EMD:热流相关、积分与输出平均
用真实 Si 短任务讲清 compute_hac 的三个参数、hac.out 列顺序、原生积分、GPUMDkit 导出和输出平均。
阅读本篇目录
本篇把 EMD 操作分成准备输入、提交、读取热流相关、检查积分、画图与理解输出平均。多种子与尺寸对照接已有 EMD 统计教程,实际温度的影响见NVE 温度与输运归一化。
下载原始输入、已有 1 ns 数据、新短任务与绘图程序。旧数据为 Si512、Si1728 各四个初速度种子;新短任务在 P100、V100 16G 各运行一次,用于看清未经输出平均的相关值和积分,不替代长轨迹统计。
1 先运行配套后处理#
将下载文件保存为 gpumd-emd.zip,在新目录执行:
unzip gpumd-emd.zip -d gpumd-emd
cd gpumd-emd
bash view.sh
ls analysis/figures
该入口读取配套真实数据,生成 CSV 和图片,并调用 GPUMDkit;不提交新的 MD。新的短任务可以:
python3 prepare.py
cd cases/p100-Si512-fine-HAC
sbatch job.slurm
squeue -u "$USER"
V100 16G 使用相应的 v100-Si512-fine-HAC 目录。模板各申请 1 GPU、1 CPU,程序为 GCC 13.3、CUDA 12.9 构建的 GPUMD 5.9.1;工具为 GPUMDkit 1.5.8。
2 结构与势文件#
本例是金刚石 Si,常规胞晶格常数 5.431 Å,4×4×4 复制后为 512 原子,周期盒边长 21.724 Å。完整坐标在 model.xyz,文件开头为:
512
Lattice="21.724 0.0 0.0 0.0 21.724 0.0 0.0 0.0 21.724" Properties=species:S:1:pos:R:3 pbc="T T T"
Si 0 0 0
Si 1.35775 1.35775 1.35775
Si 0 2.7155 2.7155
Si 1.35775 4.07325 4.07325
potential.txt 使用原始公开 Si_Fan_2019.txt 的相同内容:
tersoff_mini 1 Si
3.21481 1.43134 2.23801 2 0.282818 0.602568 -0.641048 2.8 3.2
这是本例的 tersoff_mini 参数,不是 NEP 模型。改变材料或势函数后,需要重新检查参数适用范围,不能直接套用本文数值。
3 完整的短任务输入#
potential potential.txt
velocity 300 seed 27101
time_step 1
ensemble nvt_nhc 300 300 100
run 50000
ensemble nve
compute_hac 10 1000 1
dump_thermo 100
dump_xyz 10000 trajectory.xyz velocity force precision double
run 200000
先做 50 ps NVT,再做 200 ps NVE。compute_hac 10 1000 1 的三个参数分别是:
| 参数 | 本例 | 含义 |
|---|---|---|
| 热流采样间隔 | 10 | 每 10 个 MD 步采一个热流样本,即 10 fs |
| 相关点数 | 1000 | 底层时滞为 0、0.01、…、9.99 ps |
| 输出平均间隔 | 1 | 每个相关点单独输出,不做多点平均 |
因此生产时长是 200 ps,底层最大相关时滞约 10 ps。两者不要混为一谈。
已有 1 ns 数据使用 compute_hac 10 10000 10:底层相关窗口约 100 ps,每 10 个相关点平均输出一次,最后同样得到 1000 行。输出文件行数相同,不代表两个任务的生产时长和相关窗口相同。
4 自己改输入时,先复制到新目录#
在资料包根目录只复制输入:
mkdir my-emd
cp fine-results/p100-Si512-fine-HAC/{model.xyz,potential.txt,run.in} my-emd/
cd my-emd
nano run.in
再写 job.slurm:
#!/bin/bash
#SBATCH --job-name=Si-EMD
#SBATCH --partition=gpu-8p100-hs
#SBATCH --nodes=1
#SBATCH --ntasks=1
#SBATCH --cpus-per-task=1
#SBATCH --gres=gpu:p100-16g:1
#SBATCH --time=00:20:00
#SBATCH --output=emd-%j.out
set -eo pipefail
source /etc/profile
module purge
module load cuda/12.9 gpumd/5.9.1-p100
export OMP_NUM_THREADS=1
cd "$SLURM_SUBMIT_DIR"
gpumd > run.log 2>&1
sbatch job.slurm
换显卡时同时换分区、GPU 类型和 GPUMD 模块。配套一键模板通过 run_native.py 生成固定教程输入;独立修改时用本节目录直接编辑 run.in,不要把旧 hac.out 复制进去继续追加。
5 先读列,再看积分#
head thermo.out
head hac.out
wc -l hac.out
hac.out 共 11 列:
| 列(从 1 开始) | 内容 |
|---|---|
| 1 | 输出时间标签,ps |
| 2、3 | x 方向 in、out 热流相关分量 |
| 4、5 | y 方向 in、out 热流相关分量 |
| 6 | z 方向总热流相关 |
| 7、8 | x 方向 in、out 热导积分 |
| 9、10 | y 方向 in、out 热导积分 |
| 11 | z 方向总热导积分 |
热流相关单位为 eV³/amu,积分结果为 W/(m·K)。三维材料中:
kappa_x = column7 + column8
kappa_y = column9 + column10
kappa_z = column11
isotropic_mean = (kappa_x + kappa_y + kappa_z) / 3
不要对五个分量直接除以 5。二维材料的方向和有效厚度需要单独约定,也不能直接照搬这里的三方向平均。
当前安装版本的时间列按每个输出块的名义中心标记。输出间隔为 1 时,第一行时间标签为 0.005 ps,但其底层相关时滞为 0,积分从零开始;输出间隔为 10 时,首个标签为 0.05 ps,对应前 10 个相关点组成的输出块。资料包 CSV 同时保留原生时间标签与底层时滞,原文件没有改动。
6 优先使用 GPUMDkit#
在含有 run.in 和 hac.out 的目录执行:
module load gpumdkit/1.5.8
gpumdkit.sh -plt emd x --save --save-data
gpumdkit.sh -plt emd2 save
ls emd.png emd2.png data_emd.txt data_emd.npz
head data_emd.txt
第一条看 x 方向并导出数据,第二条看三个方向。TXT 的时间单位标为 ns,原生 hac.out 为 ps,导入 Origin 等工具时看清表头。
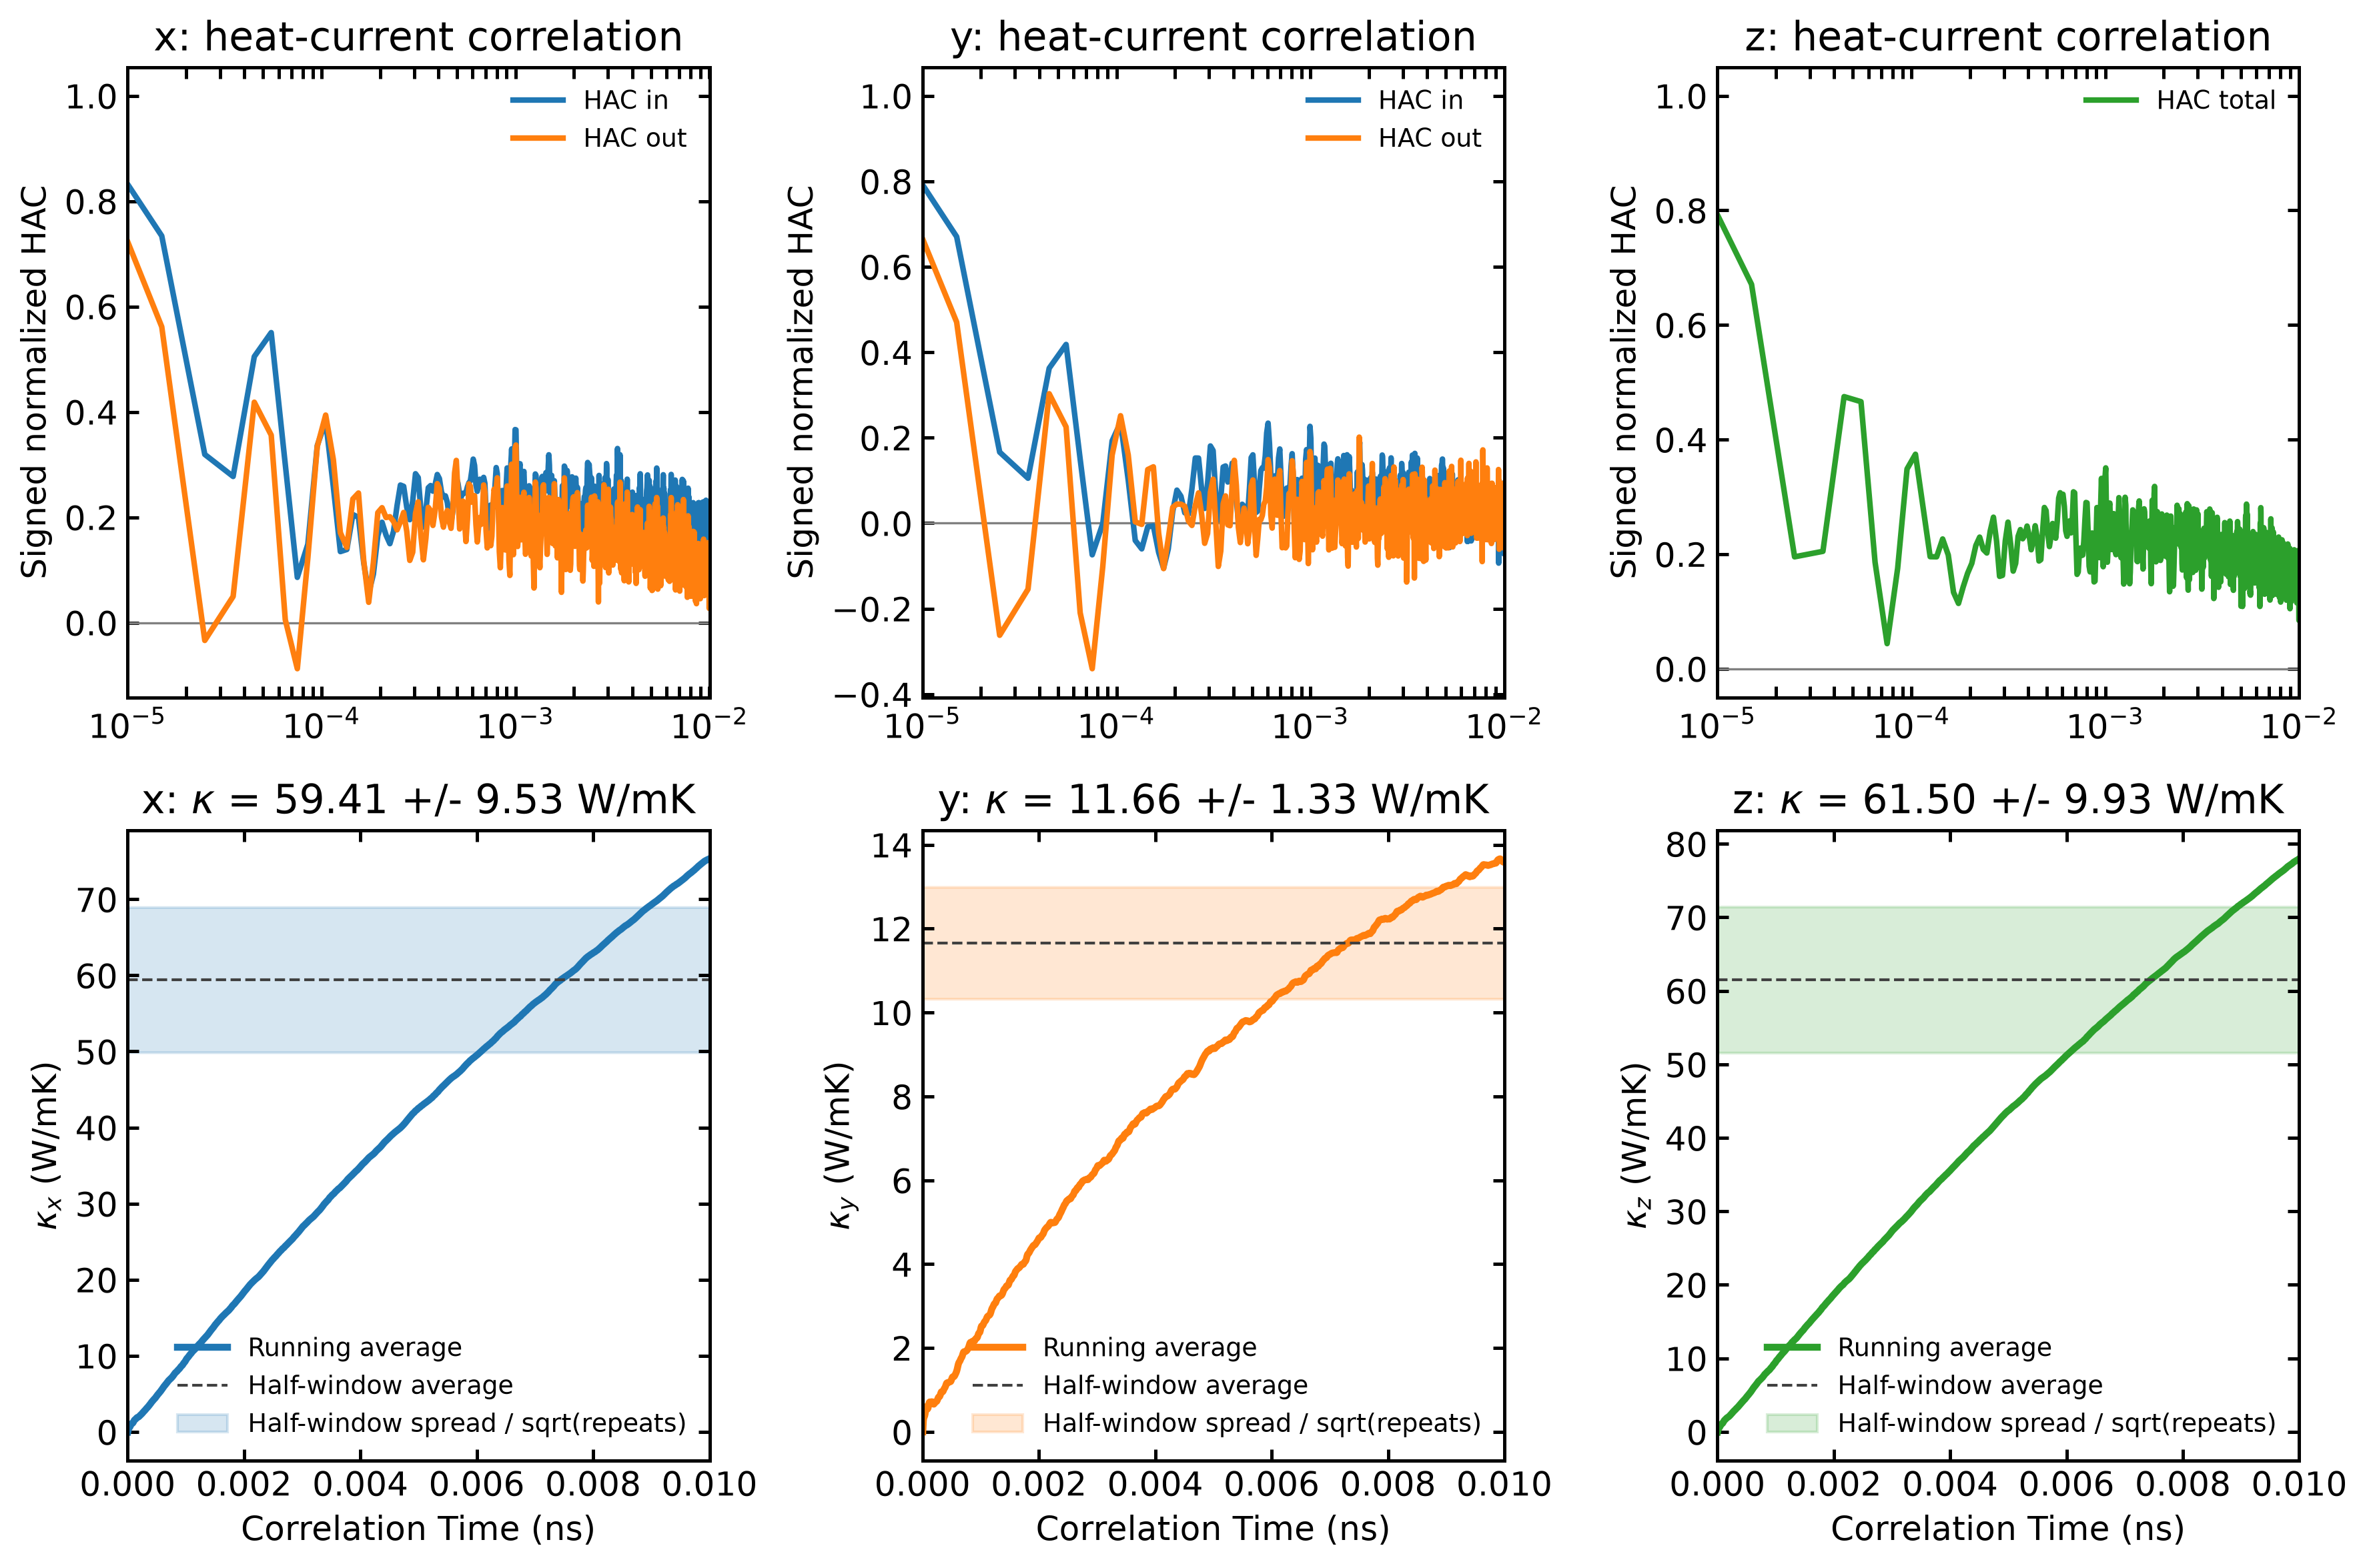
工具默认“±”来自其选取的相关曲线后半段点离散,并按识别出的输出块重复数缩放;它与四个独立初速度的 95% Student t 区间不同。不要把单个目录中的工具摘要直接当作多种子误差条。
7 核对未经平均的积分#
head analysis/p100-Si512-fine-HAC-fine-integration.csv
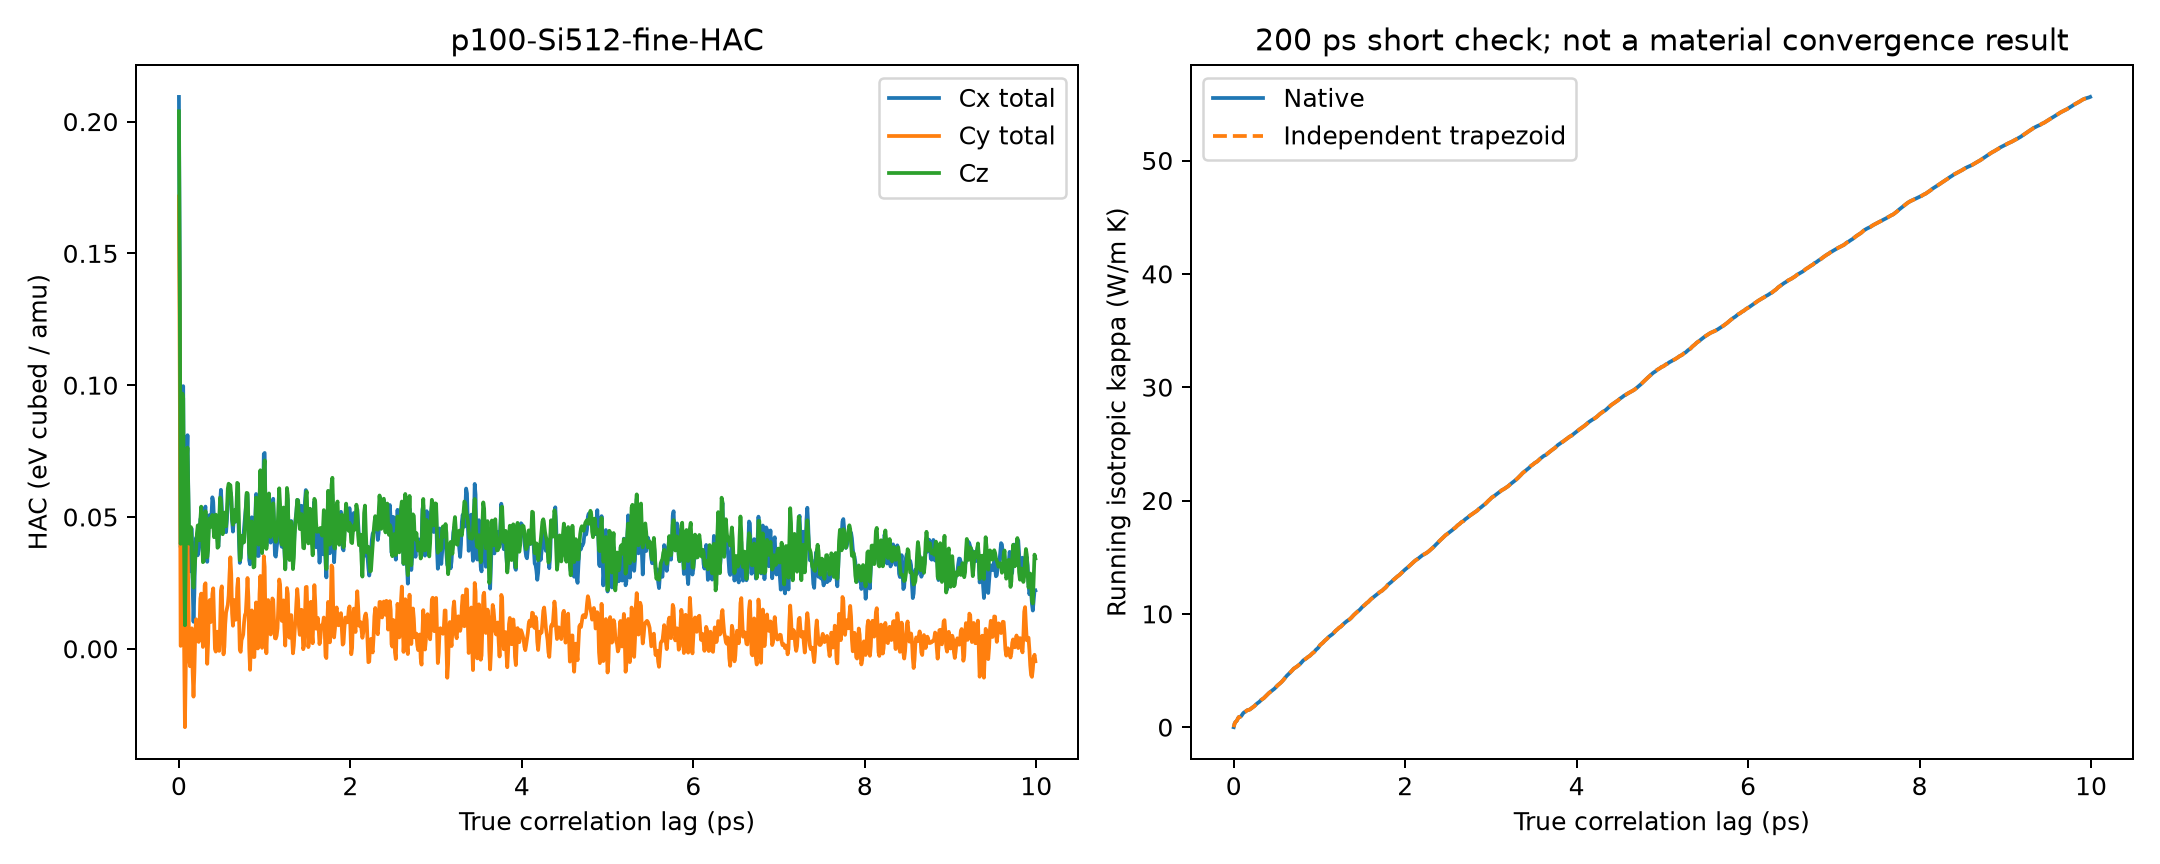
程序对五个原生相关分量逐项做梯形积分,再检查列组合和单位。P100、V100 16G 两个短例中,原生与独立积分最大差约 2.84×10⁻¹⁴ W/(m·K)。采用 CODATA 常数直接换算 SI 时,与程序原有单位常数的相对差约 1.68×10⁻⁶。
这些检查说明读取与换算一致,不证明材料热导已收敛。图中原生积分使用 300 K 目标温度作分母,而新短例实际 NVE 平均温度约 312.53 K,需按温度说明解释。
8 为什么不能对平均后的相关函数再积分#
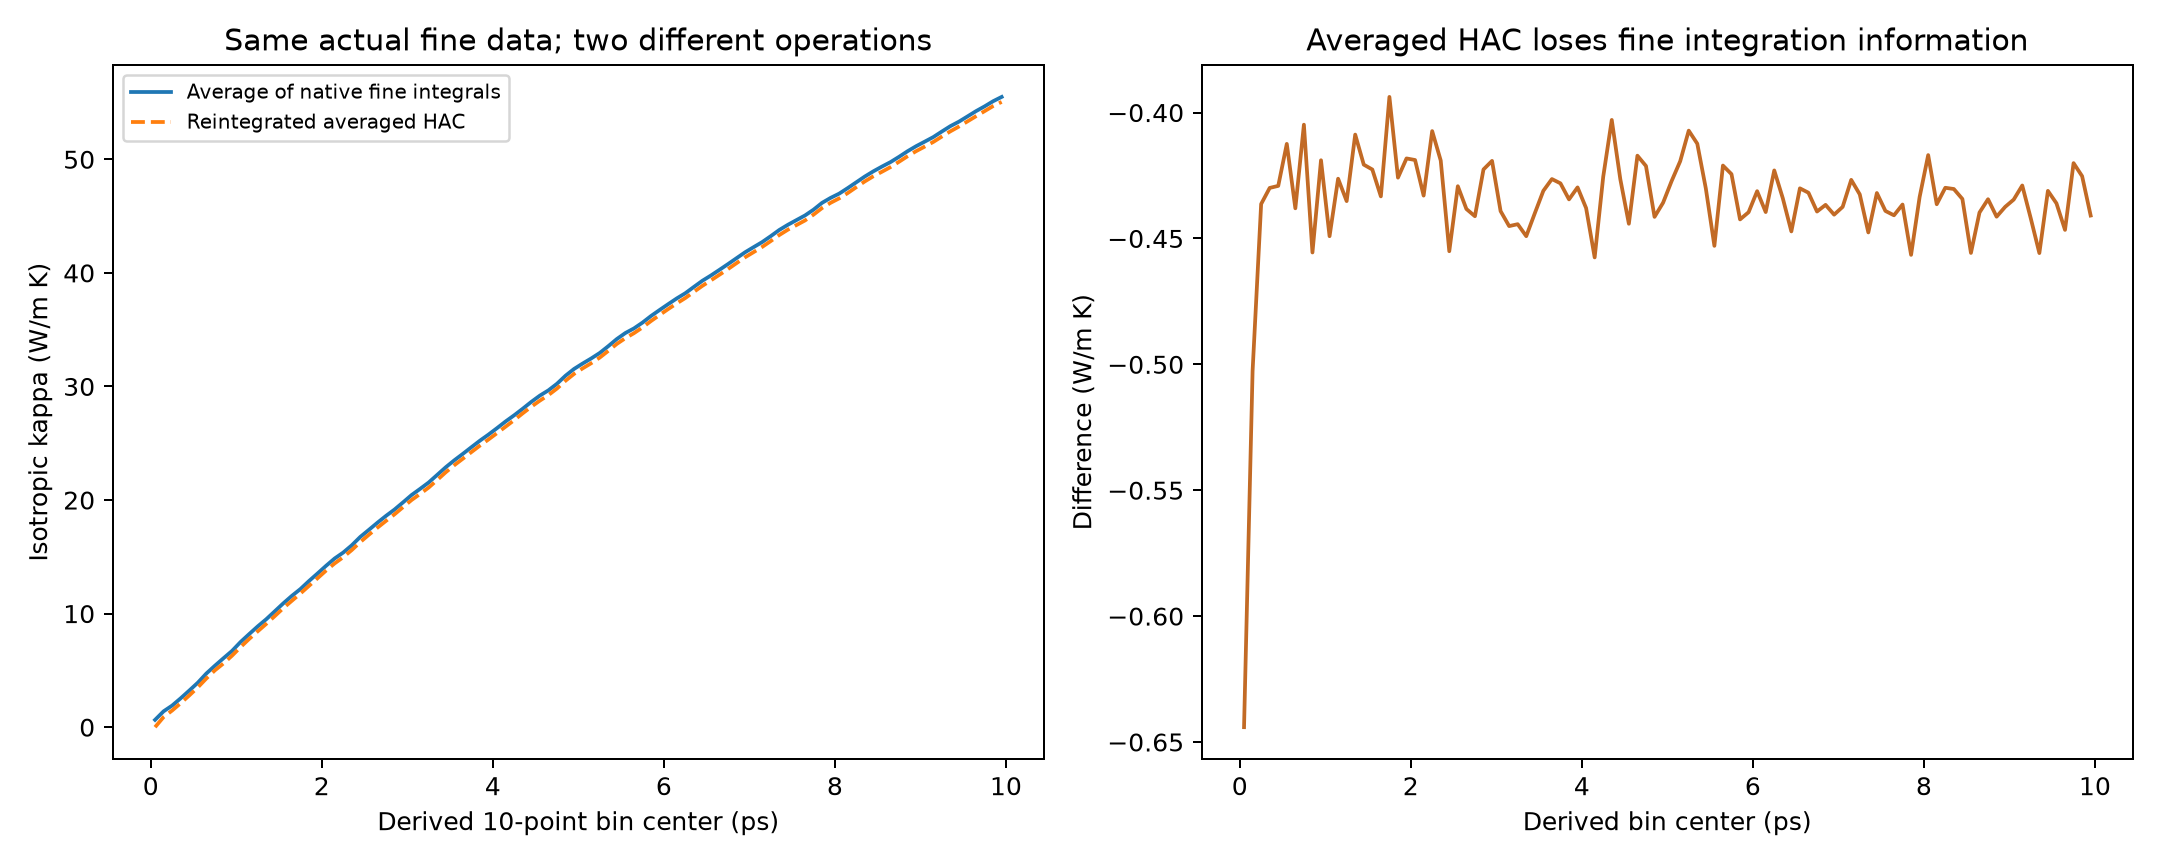
上图把实际细网格数据按 10 点一块重组,比较:
- 先在细网格上积分,再平均 10 个积分值;
- 先平均 10 个相关值,再在粗网格上重新积分。
二者通常不完全相同,细网格内的信息已经被平均。本例五个分量的最大差约 0.749 W/(m·K)。这张图是同一真实短轨迹输出的数学重组,不是额外跑出的第二条轨迹。
日常画图直接读取 hac.out 已给出的热导列。需要重新检查积分细节时,提前使用输出间隔 1,并保存足够细的相关值。
本原生入口只包含势能部分热流;液体、多组分等对流贡献重要的体系,应另行输出并处理适当的总热流。参数和分量定义见 compute_hac、hac.out。