
GPUMD HNEMD热流与二维厚度换算
实际读取势部分热流独立重建HNEMD热导,区分真空盒体积与二维有效厚度,并使用GPUMDkit处理四种子Si长轨迹。
阅读本篇目录
本篇使用石墨烯HNEMD实操的同一批真实数据,解决两个常见问题:如何确认五列热导与原生热流对应;有真空层时,热导率为什么需要注明厚度。
1 重现数据和图片#
下载完整资料包,进入解压目录:
cd hnemd-example
bash view.sh
head -n 4 analysis/p100-graphene-N240-x-F0.0002-s13579/current-kappa.csv
compute.out来自 compute 0 1 1000 jp,每一行有x/y/z三个势部分总热流量,原生热导来自相同的1000步区间。两者分别求和和输出,可以独立核对列合并、体积、驱动力和单位转换。
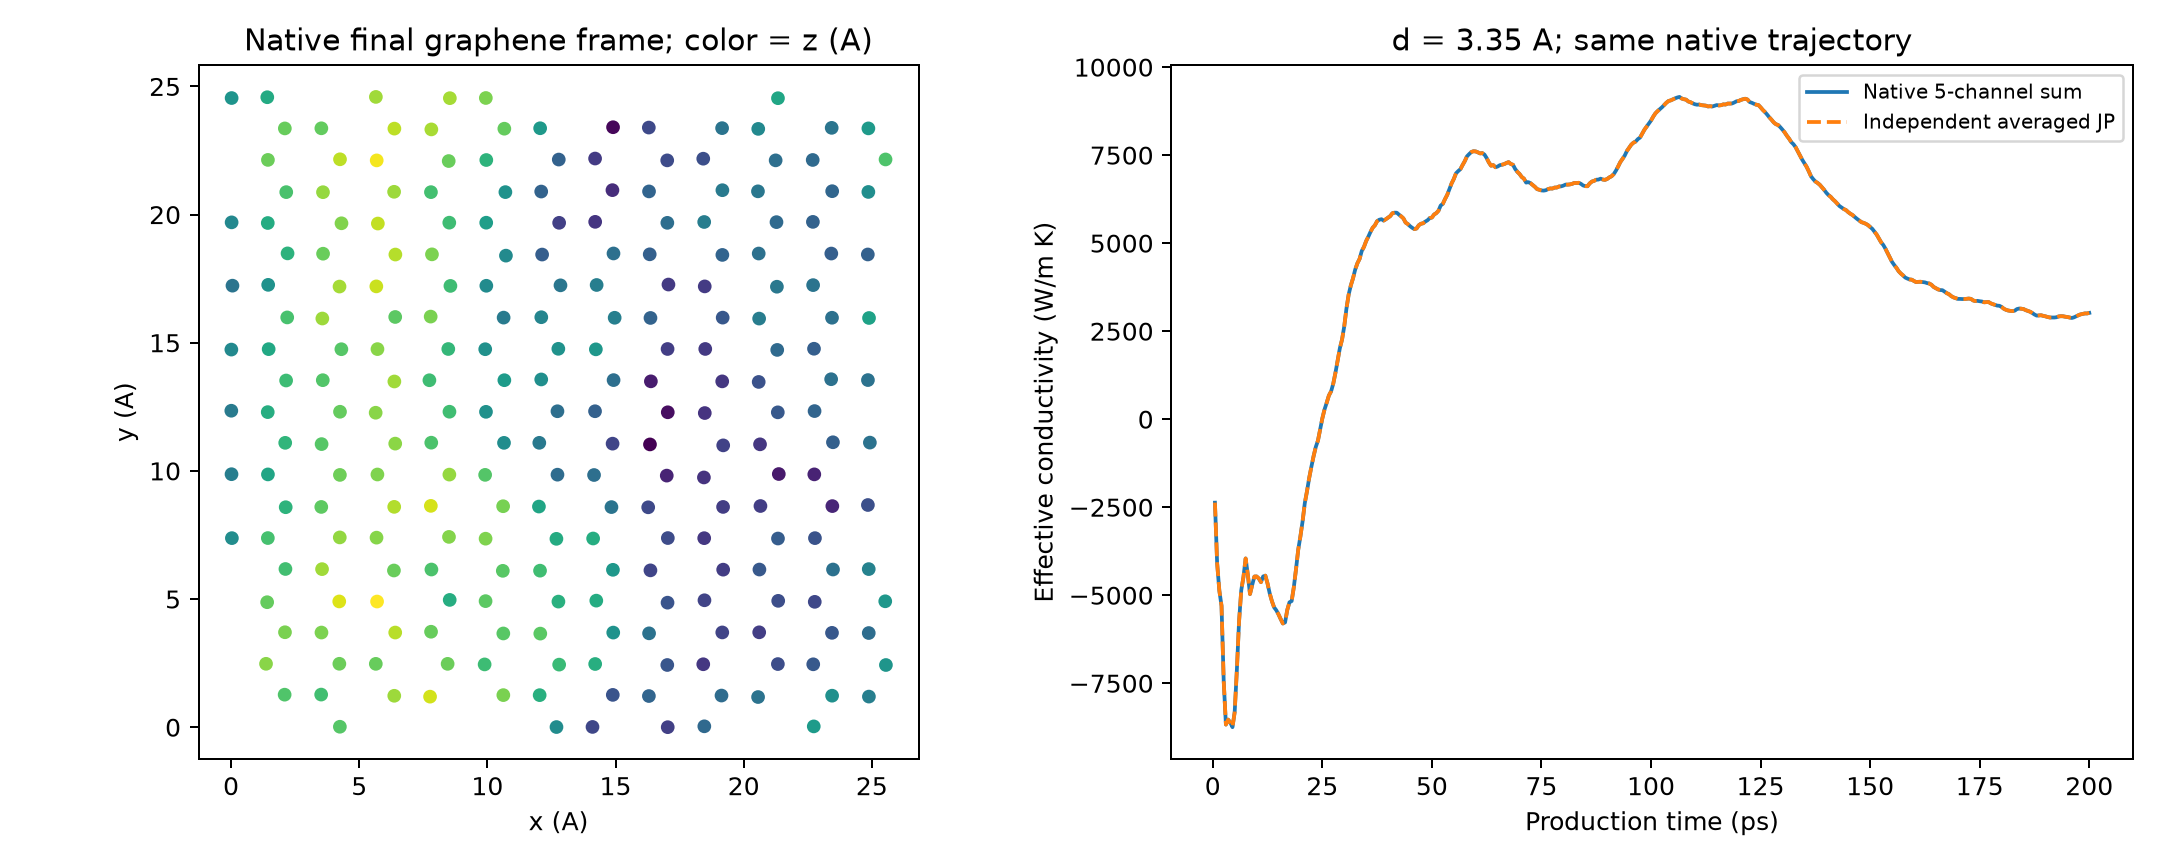
这里的HNEMD原生输出只计势部分热流。本例是稳定的固体片层,不把这一公式直接推广到对流贡献显著的流体;流体要先确认方法及程序实现。kappa.out适用范围
2 从热流重建原生热导#
在当前GPUMD单位下,可使用同一输出区间的平均JP重建:
kappa_native = JP_average * 157376.9 / (Vbox * Ttarget * abs(Fe))
Vbox单位ų,Ttarget=300 K,Fe单位Å⁻¹;本例每次只沿一个正方向驱动。157376.9对应当前程序中的单位转换常数,不能给别的软件、别的JP单位直接套用。
module load ase/3.29.0
python3 - <<'PY'
from pathlib import Path
import numpy as np
from ase.io import read
c=Path('reference-graphene/p100-graphene-N240-x-F0.0002-s13579')
a=read(c/'model.xyz')
jp=np.loadtxt(c/'compute.out')
k=np.loadtxt(c/'kappa.out')
x=jp[:,0]*157376.9/(a.get_volume()*300*0.0002)
y=k[:,0]+k[:,1]
print('max difference W/(m K):',abs(x-y).max())
PY
该例最大差约 1.04×10⁻⁴ W/(m·K),来自JP文本的有效位数;48组的最大绝对差约 2.084×10⁻³ W/(m·K)。这些比较核对的是同一条轨迹的数学与单位处理,并不能证明材料热导已收敛。
3 真空盒长、有效厚度与片层导热量#
本例石墨烯的z盒长为20 Å,原生热导分母使用包含真空的整个盒体积。如果采用3.35 Å有效厚度,换算为:
kappa_effective = kappa_native * Lz / d_effective
                = kappa_native * 20 / 3.35
sheet_conductance = kappa_native * (20e-10)
                  = kappa_effective * (3.35e-10)   # W/K
这只是同一热流数据的几何归一化,不能称为改变了物理采样,更不能只修改z盒长就声称材料热导提高。片层导热量不依赖任选的有效厚度,报告二维结果时可与所用厚度一起给出。
例如P100、240原子、x方向、Fe=2E-4、种子13579,最后125–200 ps窗口的数值为:
| 量 | 实际结果 |
|---|---|
| 按20 Å盒长归一化 | 815.3708 W/(m·K) |
| 按3.35 Å有效厚度归一化 | 4867.8855 W/(m·K) |
| 片层导热量 | 1.63074×10⁻⁶ W/K |
这是用强场短轨迹示范换算,不是推荐的石墨烯材料热导值。原生五列、几何换算列和片层导热量在CSV中分别保留。
4 区间平均与累计平均#
原生每行已经是1000步的区间平均。各区间长度相同时,前n个区间的累计平均可以直接用算术平均:
python3 - <<'PY'
import numpy as np
k=np.loadtxt('reference-graphene/p100-graphene-N240-x-F0.0002-s13579/kappa.out')
y=(k[:,0]+k[:,1])*20/3.35
t=np.arange(1,len(y)+1)*0.5
m=np.cumsum(y)/np.arange(1,len(y)+1)
np.savetxt('my-cumulative.csv',np.c_[t,y,m],delimiter=',',
           header='time_ps,block_effective_WmK,cumulative_effective_WmK',comments='')
PY
对已经平均过的区间值再做梯形积分,会改变第一、末区间的权重。为了保留完整区间的原有权重,本例统计采用上述算术累计平均。
5 使用GPUMDkit处理Si四种子数据#
附件中的 tool-inputs/weak 和 tool-inputs/strong 分别将同一场强的四条Si原生20 ns热导文件按种子顺序拼接,原始数据块没有改动。这是GPUMDkit支持的重复轨迹布局,不是重新计算,也不是把同一条轨迹复制四次。
module load gpumdkit/1.5.8
cd tool-inputs/weak
gpumdkit.sh -plt hnemd 1 --save --save-data
ls hnemd.png data_hnemd.npz data_hnemd.txt
数值 1 是有效截面积换算因子;Si没有二维真空厚度换算。方向从 run.in 读取,这里不能把x/y当作第一个参数。也可以回到资料包顶层执行 bash plot_toolkit.sh,一次生成弱场和强场两张图。
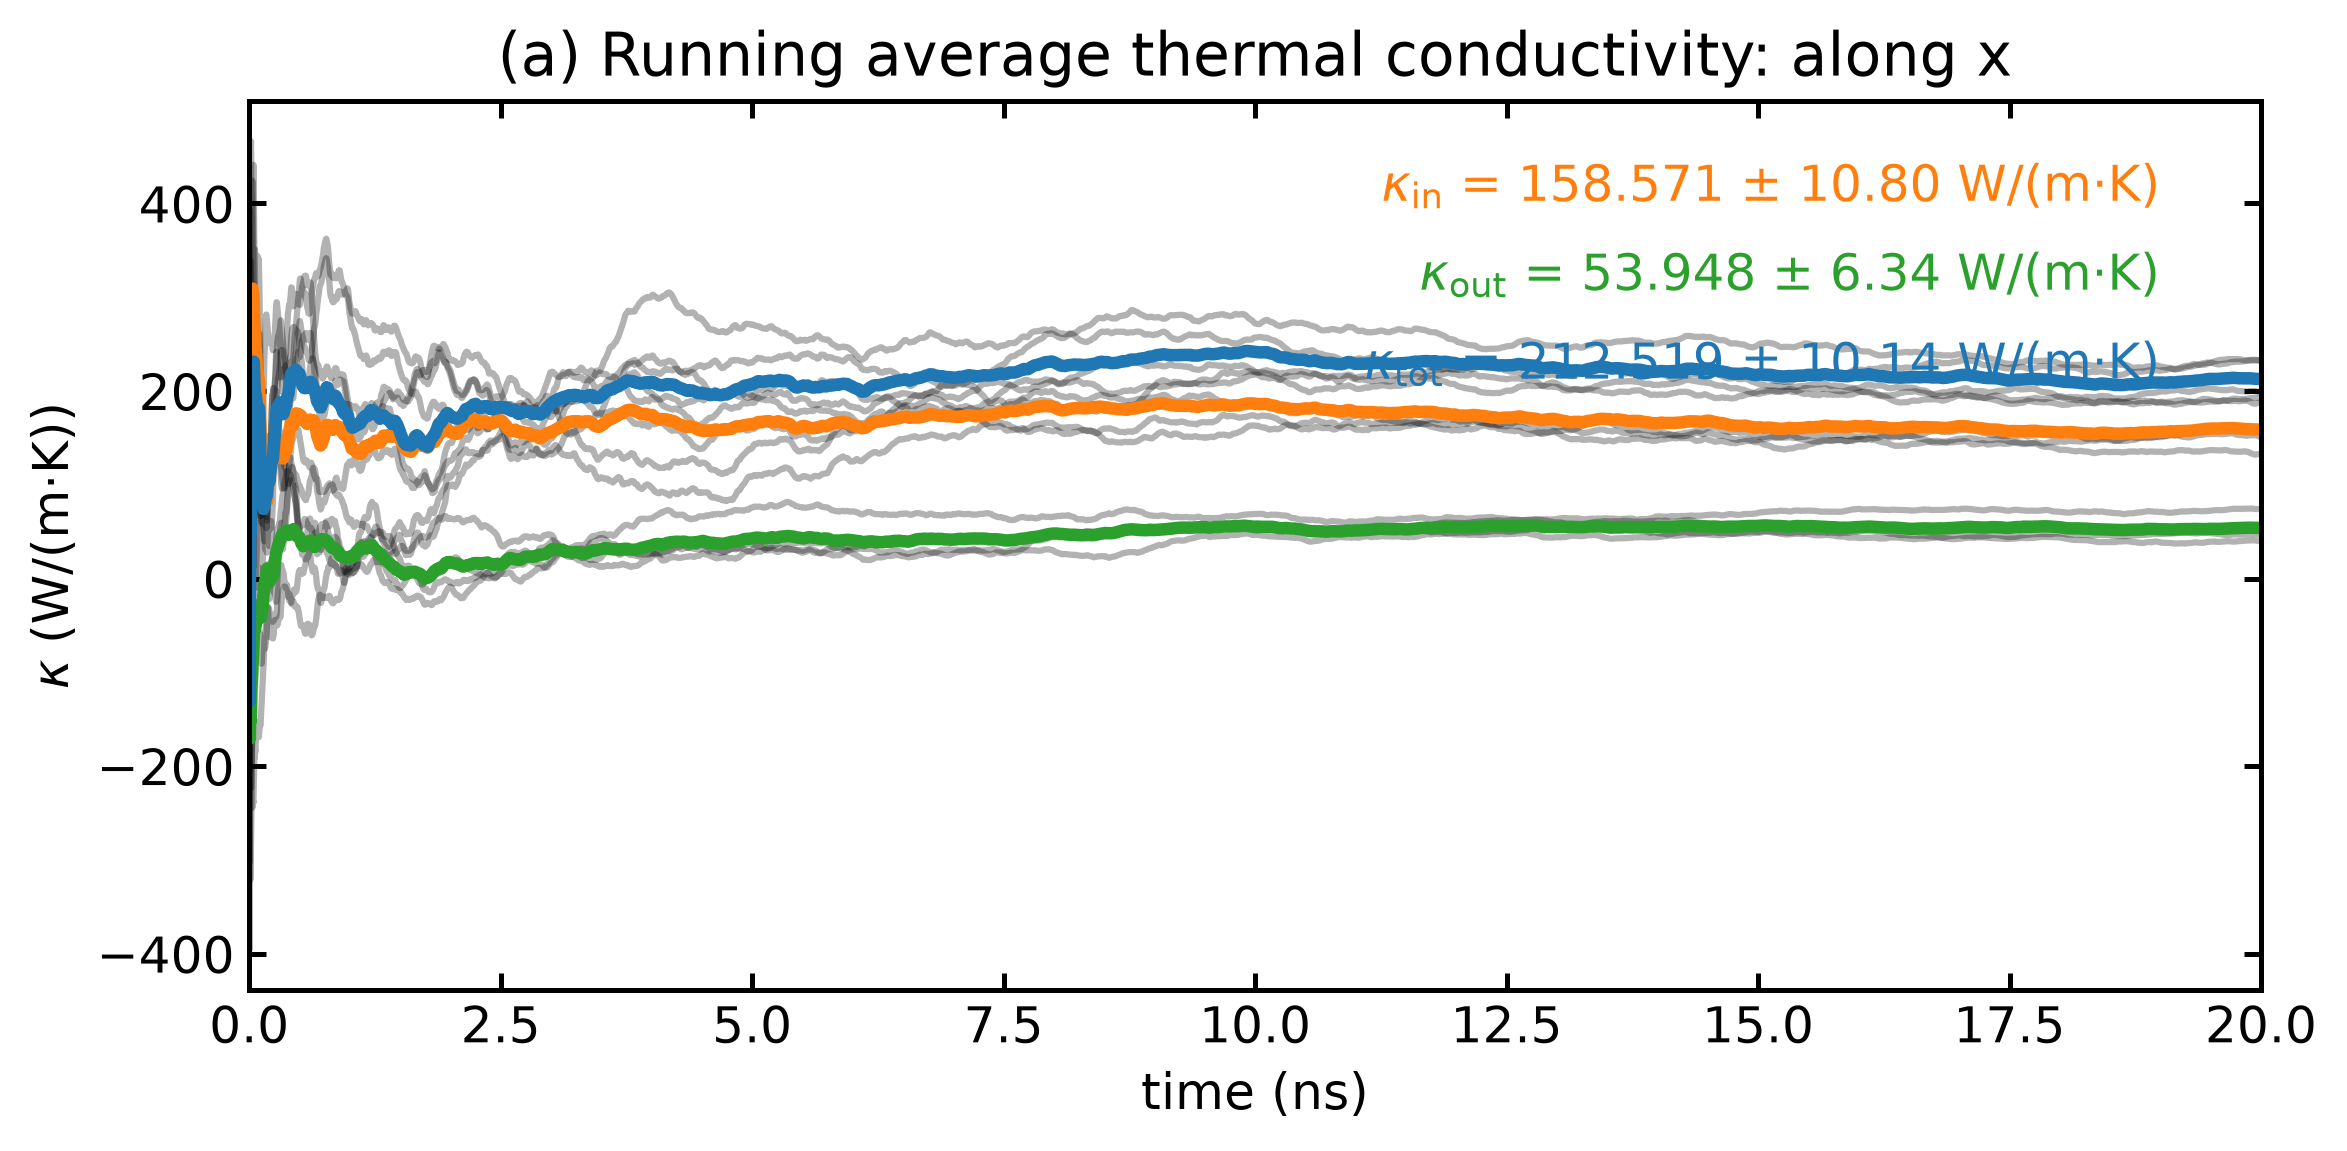
当前1.5.8脚本导出的时间轴固定按每行1 ps处理,附件中Si的1 fs步长、1000步输出恰好满足这一条件。石墨烯使用0.5 fs步长,每行实际0.5 ps,应使用本包的 analyze.py 按真实间隔画图;不要把这个版本的默认时间标签直接用于石墨烯。
该工具的运行平均采用梯形积分,首点为0;本包的窗口和种子统计采用原生等长区间的算术平均。两种处理的端点有小差异,不能要求它们逐位相同。工具输出的“±”是按四条轨迹端点计算的标准误形式,和统计教程中的四种子95% Student-t区间不同。NPZ数值数组和原始TXT均可继续用于自己的绘图,比较数据前先确认这些定义。
例如弱场Si四种子,原生区间算术均值为212.506 W/(m·K),四种子95% t区间半宽37.286;GPUMDkit梯形端点均值约212.519,输出标准误约10.144。两组“±”的定义和覆盖概率不同,不能互相替代。