
GROMACS 膜面积、厚度与取向提取
用原生energy、traj、density和gangle处理真实双层膜轨迹,独立提取每脂质面积、PO4中心间距及粗粒化尾链向量取向。
阅读本篇目录
建膜和提交见脂质膜建模教程。本篇在真实1 ns轨迹上依次提取温度、盒尺寸、面积、头基分布和尾链取向;先给每个指标下定义,再比较数据。
1 下载与查看#
下载DPPC、DOPC和混合膜输入、完整生产轨迹与分析脚本,约200 MiB,包含12个真实实例:
unzip gromacs-Martini3-bilayers-wave231*.zip -d membrane-example
cd membrane-example
sha256sum -c MANIFEST.sha256
bash view.sh
ls analysis/figures
view.sh只处理参考数据,不提交模拟。它使用集群现有的MDAnalysis2.9.0、NumPy和Matplotlib环境;该Python环境路径名称中带有qvasp,但这里不调用qvasp,也不运行VASP。其他机器可通过 ANALYSIS_PYTHON 指向具有相同依赖的Python。
2 先调用原生工具#
新作业完成后,在对应案例目录执行:
module load gromacs/2026.4-p100-threadmpi
python3 ../../export_native.py
ls native-analysis
这一步顺序调用 gmx energy、gmx traj、gmx density 和 gmx gangle。也可以逐条执行,交互时选择下列组名。参考数据已经带有导出结果,直接 bash view.sh 即可画图,不必重复导出。
温度、盒尺寸与密度#
gmx energy -f md.edr -o energy.xvg
# 依次输入需要的名称,最后输入0:
# Temperature  Box-X  Box-Y  Box-Z  Density  Potential  T-Bilayer  T-Solvent
程序输出列的顺序可能按内部能量条目排序,而不是按输入名称顺序。读取XVG时核对 @ s0 legend 等字段,不能假设“第二列一定是温度”。本例温度应同时看Bilayer、Solvent和总体系。
原子坐标与盒向量#
gmx traj -f md.xtc -s md.tpr -n analysis-index.ndx -ox phosphates.xvg -ob box.xvg
# 选择 Phosphates
生产每2 ps保存一帧,0至1000 ps共501帧。Phosphates含200个PO4珠,输出坐标按索引顺序展开。原生GROMACS导出长度用nm;MDAnalysis默认读取为Å,独立分析时必须先除以10。
3 每脂质面积怎么计算#
本例上下叶层各100个脂质,平面面积为 A=Lx·Ly,所以每脂质面积为 A/100,也就是 2·Lx·Ly/N_total_lipids。不能直接用 A/200,否则少一倍。
面积应逐帧计算再统计,NPT里不要使用初始8×8 nm替代所有帧。混合膜这里得到整个叶层的平均每脂质面积,并不自动给出DPPC、DOPC各自的局部面积;那需要额外的几何划分与定义。
4 膜厚度先明确是哪一种#
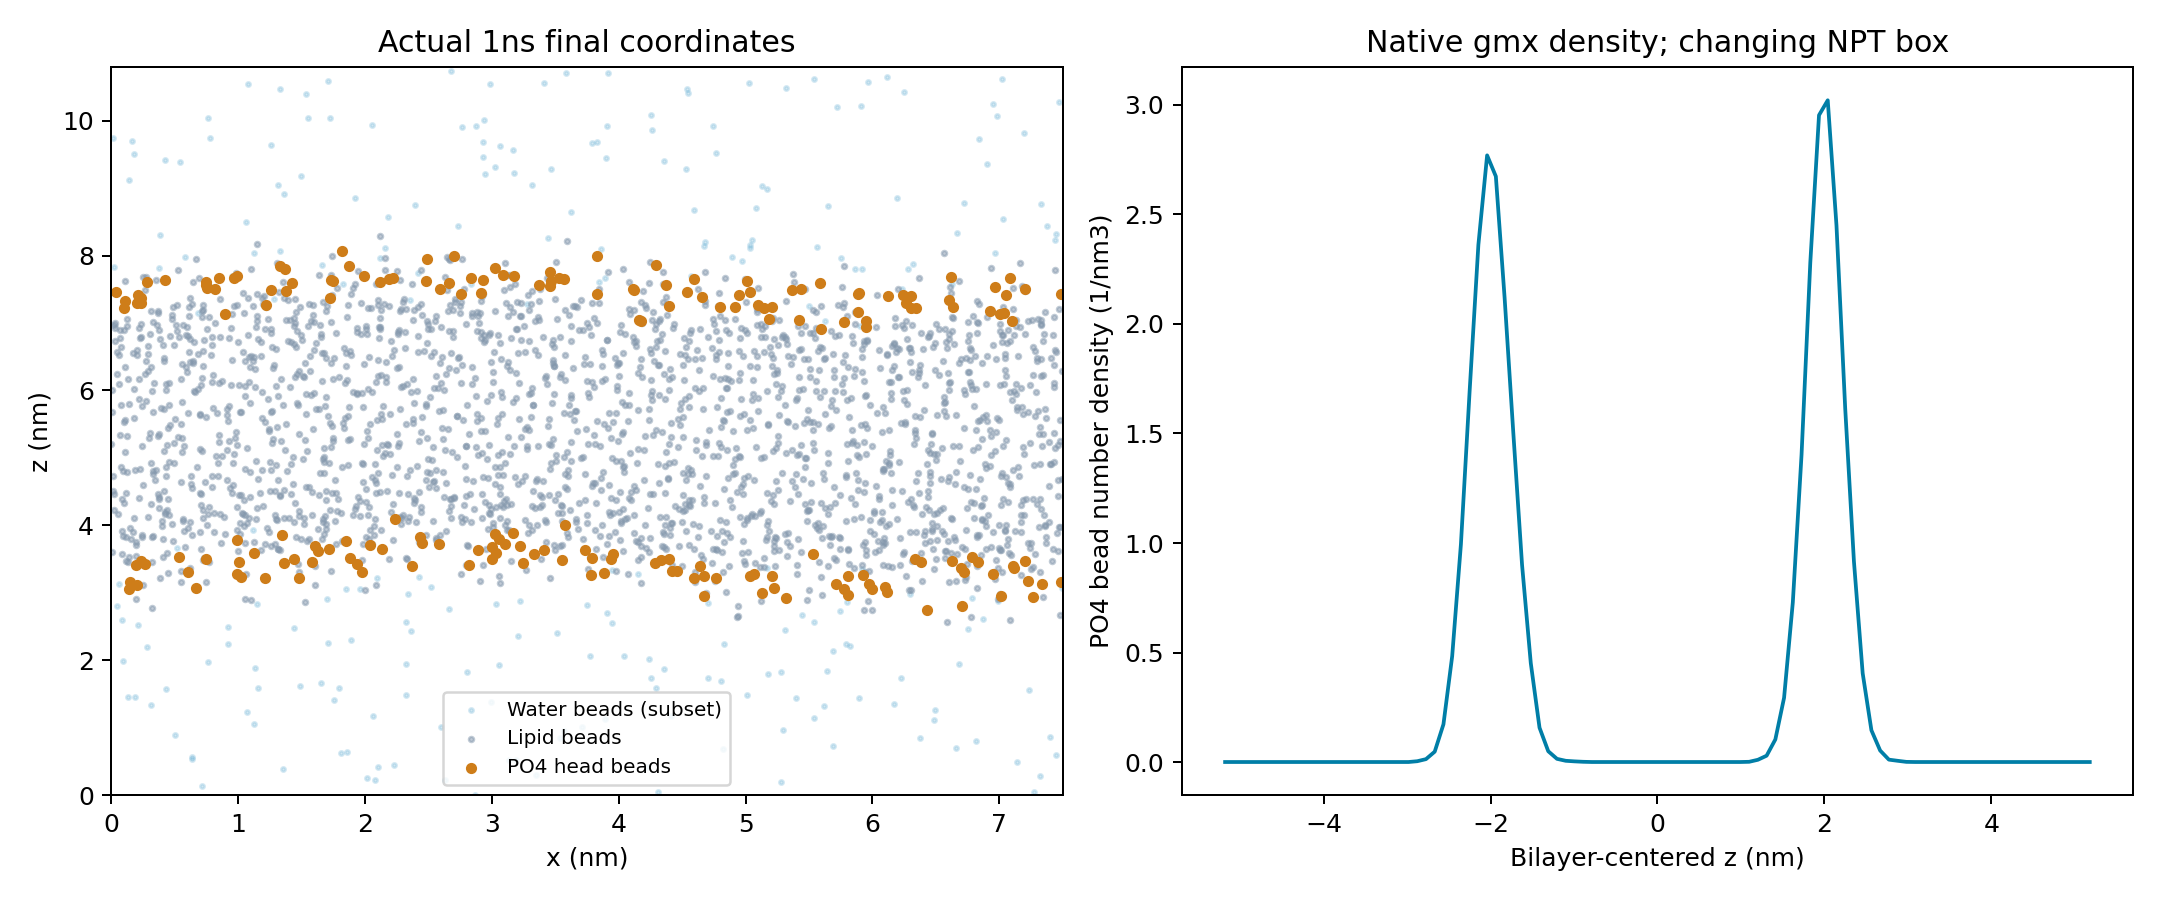
本例厚度定义为两个叶层PO4珠的z向中心位置之差。先沿周期z方向找到膜中心、处理跨边界,再对固定叶层分别平均。它不同于疏水尾链厚度,也不同于磷酸头基数密度两个峰的位置差。
原生头基密度可这样提取:
gmx density -f md.xtc -s md.tpr -n analysis-index.ndx -d Z -sl 100 -dens number -center -o phosphate-density.xvg
# 第一次选择 Bilayer,第二次选择 Phosphates
-center让每帧相对膜中心分箱,减少整体平移和盒尺寸涨落造成的展宽;本例使用珠数密度,不是电子密度。NPT总体质量密度应读 gmx energy。密度与膜中心处理
5 粗粒化尾链取向#
附件索引 TailVectors按每个脂质的C1A、C4A珠成对排列,先用原生工具计算向量与z轴的夹角:
gmx gangle -f md.xtc -s md.tpr -n analysis-index.ndx -g1 vector -g2 z -group1 'group "TailVectors"' -oall tail-angles.xvg -oav tail-angle-mean.xvg
逐向量计算 P₂=(3·cos²θ−1)/2,再求平均。不能先平均上下两个叶层的夹角,再代入公式;两层向量朝向相反,平均角可能接近90°,但P₂并不会因此自动为−0.5。
这里的P₂是粗粒化C1A→C4A整段向量的取向指标,不是全原子C–D键的氘序参量。不要直接拿它与实验氘NMR序参量逐碳比较。向量与z轴角度
6 一次提取全部指标并画图#
回到附件根目录,使用带有MDAnalysis的Python处理新计算:
cd ../..
/public/toolkit/miniconda3/envs/qvasp-2.26/bin/python analyze.py --cases cases --case p100-DPPC-s13579 --output analysis-new
head -5 analysis-new/p100-DPPC-s13579/membrane-time-series.csv
cat analysis-new/p100-DPPC-s13579/metrics.json
在其他Python环境中替换解释器路径即可。脚本从GRO/XTC独立读取坐标与盒长,核对原生坐标和向量角度,不采用根据珠名称猜测的原子质量。不要把“W珠”猜成钨元素,再计算膜溶液质量密度。
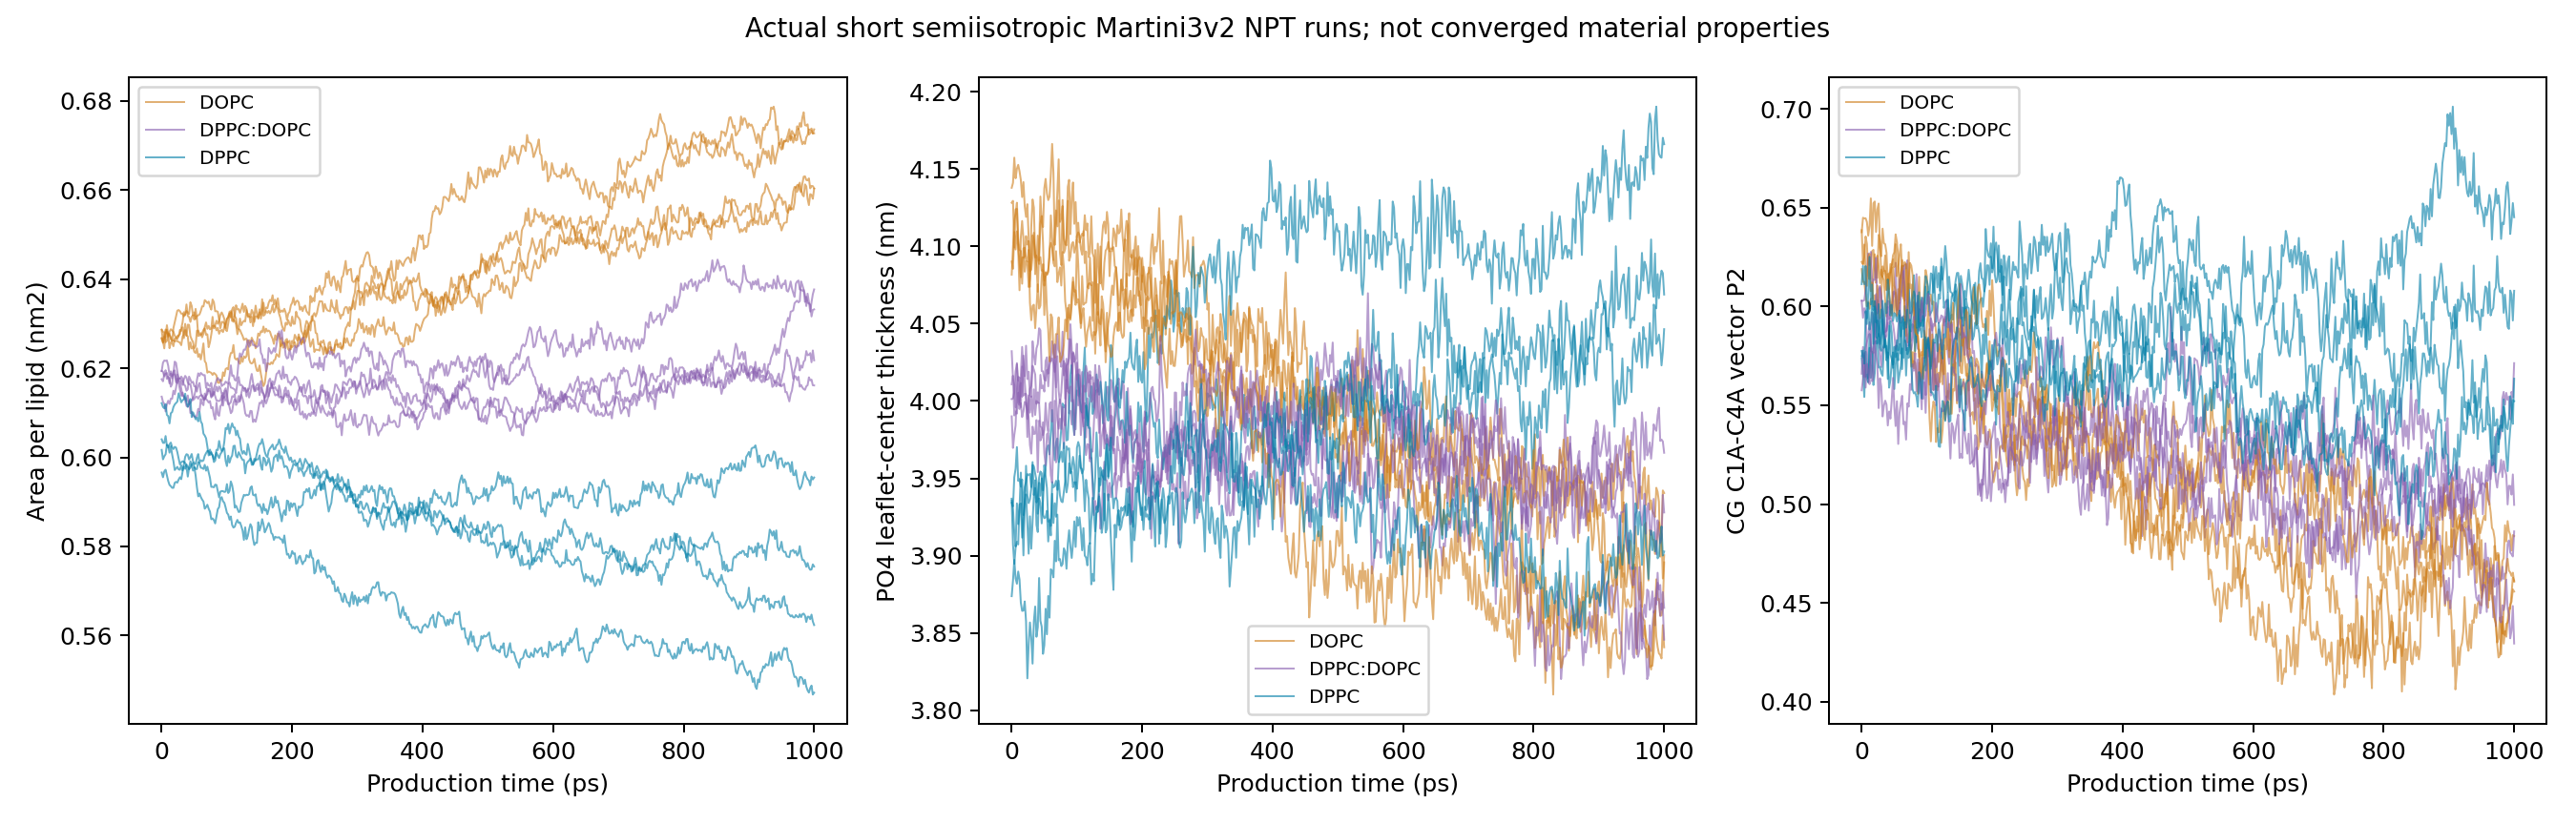
下面列出所有实例生产后500 ps的简单均值。它们用于展示提取方式和有限轨迹的差异,不是收敛物性或误差区间:
| 实例 | 后500 ps面积/nm²·脂质⁻¹ | PO4叶层中心间距/nm | 粗粒化尾链向量P₂ |
|---|---|---|---|
| p100-DOPC-s13579 | 0.65103 | 3.94598 | 0.49841 |
| p100-DOPC-s24680 | 0.66014 | 3.90957 | 0.45461 |
| p100-DPPC-DOPC-s13579 | 0.63136 | 3.89553 | 0.48992 |
| p100-DPPC-DOPC-s24680 | 0.61603 | 3.96813 | 0.53343 |
| p100-DPPC-s13579 | 0.57418 | 4.02939 | 0.58020 |
| p100-DPPC-s24680 | 0.55612 | 4.11177 | 0.62776 |
| v100-DOPC-s13579 | 0.65238 | 3.94987 | 0.48959 |
| v100-DOPC-s24680 | 0.66724 | 3.87635 | 0.45667 |
| v100-DPPC-DOPC-s13579 | 0.61665 | 3.95312 | 0.49798 |
| v100-DPPC-DOPC-s24680 | 0.61692 | 3.96178 | 0.51656 |
| v100-DPPC-s13579 | 0.57927 | 4.01669 | 0.56644 |
| v100-DPPC-s24680 | 0.59370 | 3.90782 | 0.53331 |
不同平台上并非同一条逐帧轨迹,控温与控压还有随机过程。这里是两组建模/初速度种子、两个平台的实际运行,不应当作四个不同初速度种子计算置信区间,也不是GPU性能对比。
7 得到这些图之后怎么继续#
先看面积、膜厚是否仍有系统漂移,再延长平衡;对生产段划时间窗并增加独立初态,最后检查膜平面尺寸、力场版本、温度与组成。混合膜局部结构、相分离或扩散等慢过程,通常不能仅靠这段1 ns得出结论。
本包最终提供501帧逐帧CSV、实际拓扑和完整生产XTC/TPR/EDR,方便继续用原生工具分析。实际结构图来自生产末帧;原始轨迹、各个实例和带有漂移的曲线都保留,不按结果好坏挑选某一条。