
Phonopy 机器学习势训练数据整理
把真实VASP结构、能量、力和应力整理为HDF5,按体积分组并读回检查,说明后续训练前提。
阅读本篇目录
unzip phonopy-response-electronic-data-wave244-*.zip -d phonopy-data-practice
cd phonopy-data-practice
在已分配CPU资源内,用普通账号选择一种入口:bash run.sh一次生成全部数值和三张图;或者在一份新的解压目录只运行本篇指定的Python程序。输出目录已存在时另解压,避免覆盖。完整运行每次1个CPU,无需GPU,不提交新DFT,也不会训练一个势模型。
环境为Phonopy4.8.3、Python3.11.16、NumPy2.3.5、GCC13.3 C/OpenMP、phonors0.6.0与symfc1.7.3。包内是实际计算的数值资料和经过选取的结构/响应字段;不包含完整原始VASP输出、势文件或波函数。
1. 这一步会得到什么#
先完成不同结构的VASP计算,再提取每份输出的最终结构、能量、逐原子力和应力,组成结构数据集;随后划分数据、检查单位,最后才进入势模型的配置、训练与独立评估。
本例完成训练前的数据整理。使用本集群已有Si16正、负位移计算:98%、100%、102%三个体积,每个体积两个位移,共六帧。源计算为VASP6.6.1 GPU、ENCUT550 eV、EDIFF1E-6、电子4×4×4网格;构建为NVHPC25.3、CUDA12.8、HPC-X2.22.1与MKL2023.2。实际位移输入见位移和力收集与QHA资料包。
2. 从自己的真实输出导出#
假设六份完整输出按明确顺序保存为output/01.xml至output/06.xml:
module load phonopy/4.8.3
phonopy-vasp-mlp-dataset output/{01..06}.xml \
  -o polymlp_dataset.hdf5
ls -lh polymlp_dataset.hdf5
这个入口既可读vasprun.xml,也可读真实vaspout.h5。它提取每个文件的最后一个离子步;需要多个轨迹帧时,应先按自己的轨迹数据流程准备相应结构,不能把“一个文件”自动当作“全部MD帧”。
本包提供由这六份实际输出导出的数值HDF5,不包含完整原始电子计算输出。整理数据不要求先安装pypolymlp训练程序;后续真正拟合模型是另一个阶段。
3. 检查HDF5内容#
在新解压目录:
python - <<'PYCODE'
import h5py
with h5py.File('inputs/polymlp_dataset.hdf5') as h:
    for name in h:
        print(name, h[name].shape)
    print('atoms:', h['n_atoms'][:])
PYCODE
本例主要数组如下:
| 字段 | 本例形状 | 单位或含义 |
|---|---|---|
n_atoms |
(6,) |
每帧16个原子 |
lattices |
(6,3,3) |
晶格矢量,Å |
numbers |
(96,) |
各帧原子序数连续排列 |
scaled_positions |
(96,3) |
分数坐标,无量纲 |
energies |
(6,) |
每个结构的总能量,eV |
forces |
(96,3) |
原子力,eV/Å |
stresses |
(6,3,3) |
应力,GPa |
逐原子数组连续存放,所以力是96×3,不是直接写成6×16×3;n_atoms用来确定每帧的边界,这种布局可以容纳不同原子数的结构。
应力由原VASP XML的kbar除以10转换到GPa,保持原读入约定。它不是模型训练中的eV单位virial;需要训练时应通过相应适配器转换。若一组输入并非全部有应力,当前整理器可能不写整组应力字段,读数据时先检查键是否存在。
4. 用结构数据API读取#
python - <<'PYCODE'
from phonopy.interface.pypolymlp import read_pypolymlp_structure_dataset
x = read_pypolymlp_structure_dataset('inputs/polymlp_dataset.hdf5')
print('frames:', len(x))
print('first atoms:', len(x.structures[0]))
print('first forces:', x.forces[0].shape)
print('energies:', x.energies)
PYCODE
得到六帧,每帧16个Si,首帧力为(16,3)。这是保存完整晶格和结构的PypolymlpStructureData,不同于只记录相对同一参考超胞位移的另一类数据对象。
5. 按来源分组,避免相关帧混在一起#
本例顺序是98%体积两帧、100%两帧、102%两帧。示范把前两组四帧与最后一组两帧分开:
python dataset.py
ls dataset/train.hdf5 dataset/holdout.hdf5
cat dataset/training-data-summary.csv
脚本实际使用的API形式是:
from phonopy.interface.pypolymlp import write_pypolymlp_structure_dataset
train = x[[0,1,2,3]]
holdout = x[[4,5]]
write_pypolymlp_structure_dataset(train, 'train.hdf5')
write_pypolymlp_structure_dataset(holdout, 'holdout.hdf5')
自己的数据应按真实来源和相关性分组,不机械套用这六个编号。正负位移帧高度相关,随意随机拆分容易让两组数据过于相似;按体积分组只是本例的数据整理示范,也不代表六帧已经足够训练可泛化的势。
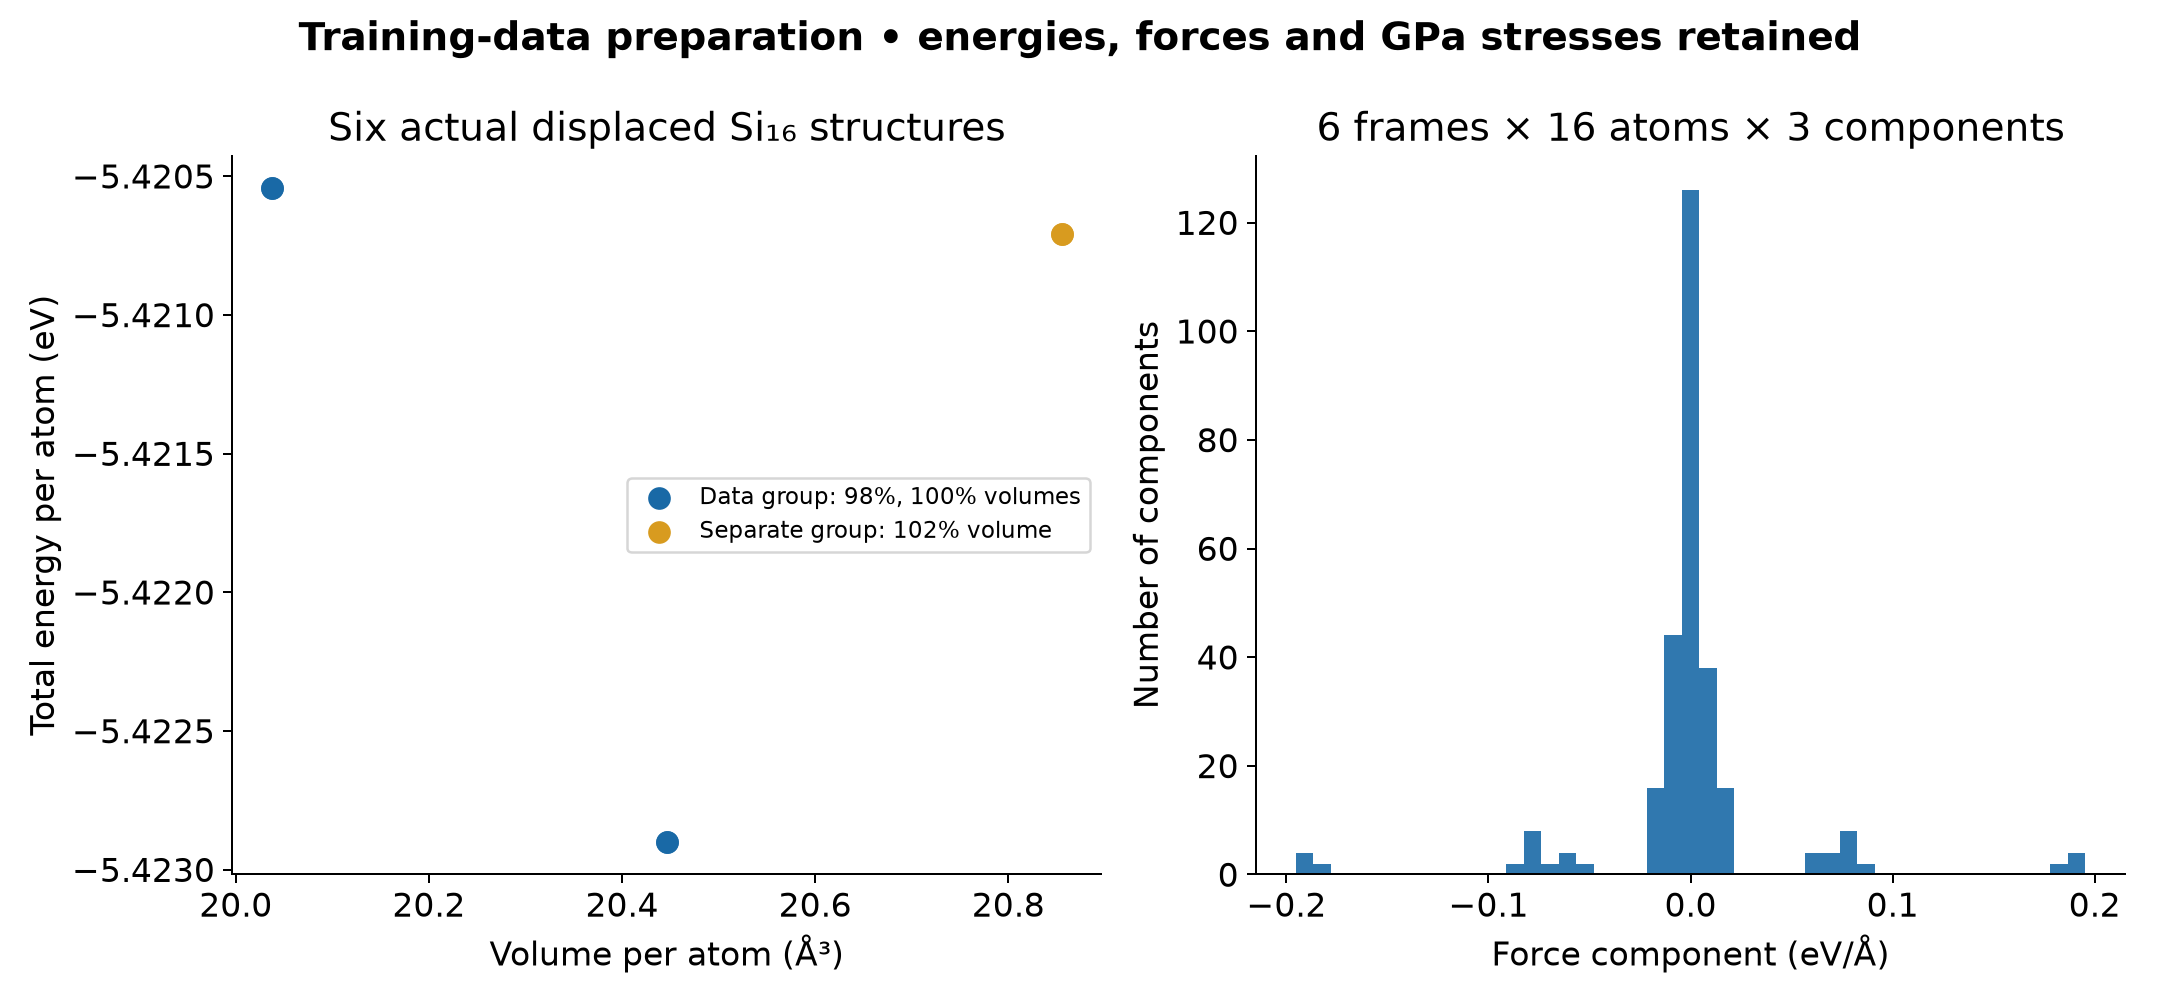
正负位移能量很接近,图中两个点可能重合;实际CSV仍有六帧。左图能量除以原子数用于展示,原HDF5的energies仍为每个结构总能,不能混用。右图统计六帧共288个力分量。
6. 接下来才进入势训练#
训练还需要匹配的pypolymlp依赖、模型参数、更充分的结构覆盖与独立测试;当前公共Phonopy环境没有增装该训练依赖。本文没有生成势文件,也没有给出模型误差或泛化结论。
本包dataset.py将分组数据写回后再读取,结构、能量、力、应力均与原数值对应。完整图表可在另一份新解压目录运行bash run.sh生成。后续接口背景见Phonopy与pypolymlp流程,不要把命令能显示帮助理解为所有训练前提都已经具备。