
LAMMPS 分组偶极与GPU运行
用中性和带净电荷分组解释偶极原点修正,并给出GPU包与KOKKOS的实际运行方式。
阅读本篇目录
下载分组统计实例包,在已分配的兼容CPU资源中运行:
unzip lammps-chunk-observables-wave250.zip -d chunk-practice
cd chunk-practice
bash run.sh
使用ase/3.29.0提供Python绘图环境,计算模块为lammps/30Sep2026-8173m,CPU构建使用Intel oneAPI2024.2与Intel MPI2021.13。流程只用1个CPU线程,输出results-cpu/、analysis/与figures/。重新练习请用新解压目录,避免覆盖已有文件。
这是一个16个点粒子、4个分组的受控运动例子。采用LJ约化单位,粒子质量为1或2,分子ID为7、23、41、99;没有键约束、库仑相互作用,LJ势的epsilon特意设为0。电荷用于演示偶极统计。它帮助看懂命令、单位、数组与周期边界,不代表真实材料的相互作用模型,也不是扩散或温度平衡的生产计算。
1 中性组与带净电荷组#
cat inputs/free_neutral/initial.json
cat inputs/free_charged_mass_geometry/initial.json
每个中性组4个电荷为1、−1、0.5、−0.5;另一组将第二个电荷改为−0.5,所以每组净电荷为+0.5。坐标和质量相同,方便单独比较电荷与参考中心的影响。
compute mols all chunk/atom molecule compress yes nchunk once ids once
compute dip all dipole/chunk mols mass
compute dipgeo all dipole/chunk mols geometry
输出四列为偶极矢量x/y/z及其模长。净电荷不为零时,程序从Σqᵢrᵢ中减去Q乘参考中心:mass用质心,geometry用几何中心。两种约定都需明确写出,不要当作两种不同的材料极化。
2 实际数字与原点修正#
head -n 9 results-cpu/free_neutral/dip.dat
head -n 9 results-cpu/free_charged_mass_geometry/dip.dat
head -n 9 results-cpu/free_charged_mass_geometry/dipgeo.dat
初始7号中性组偶极为(1.3,−0.4,0.95),模长1.659066。带+0.5净电荷组按质心修正得到(1.191667,−0.175,0.883333),模长1.493644;按几何中心修正得到(1.125,−0.15,0.825),模长1.403122。
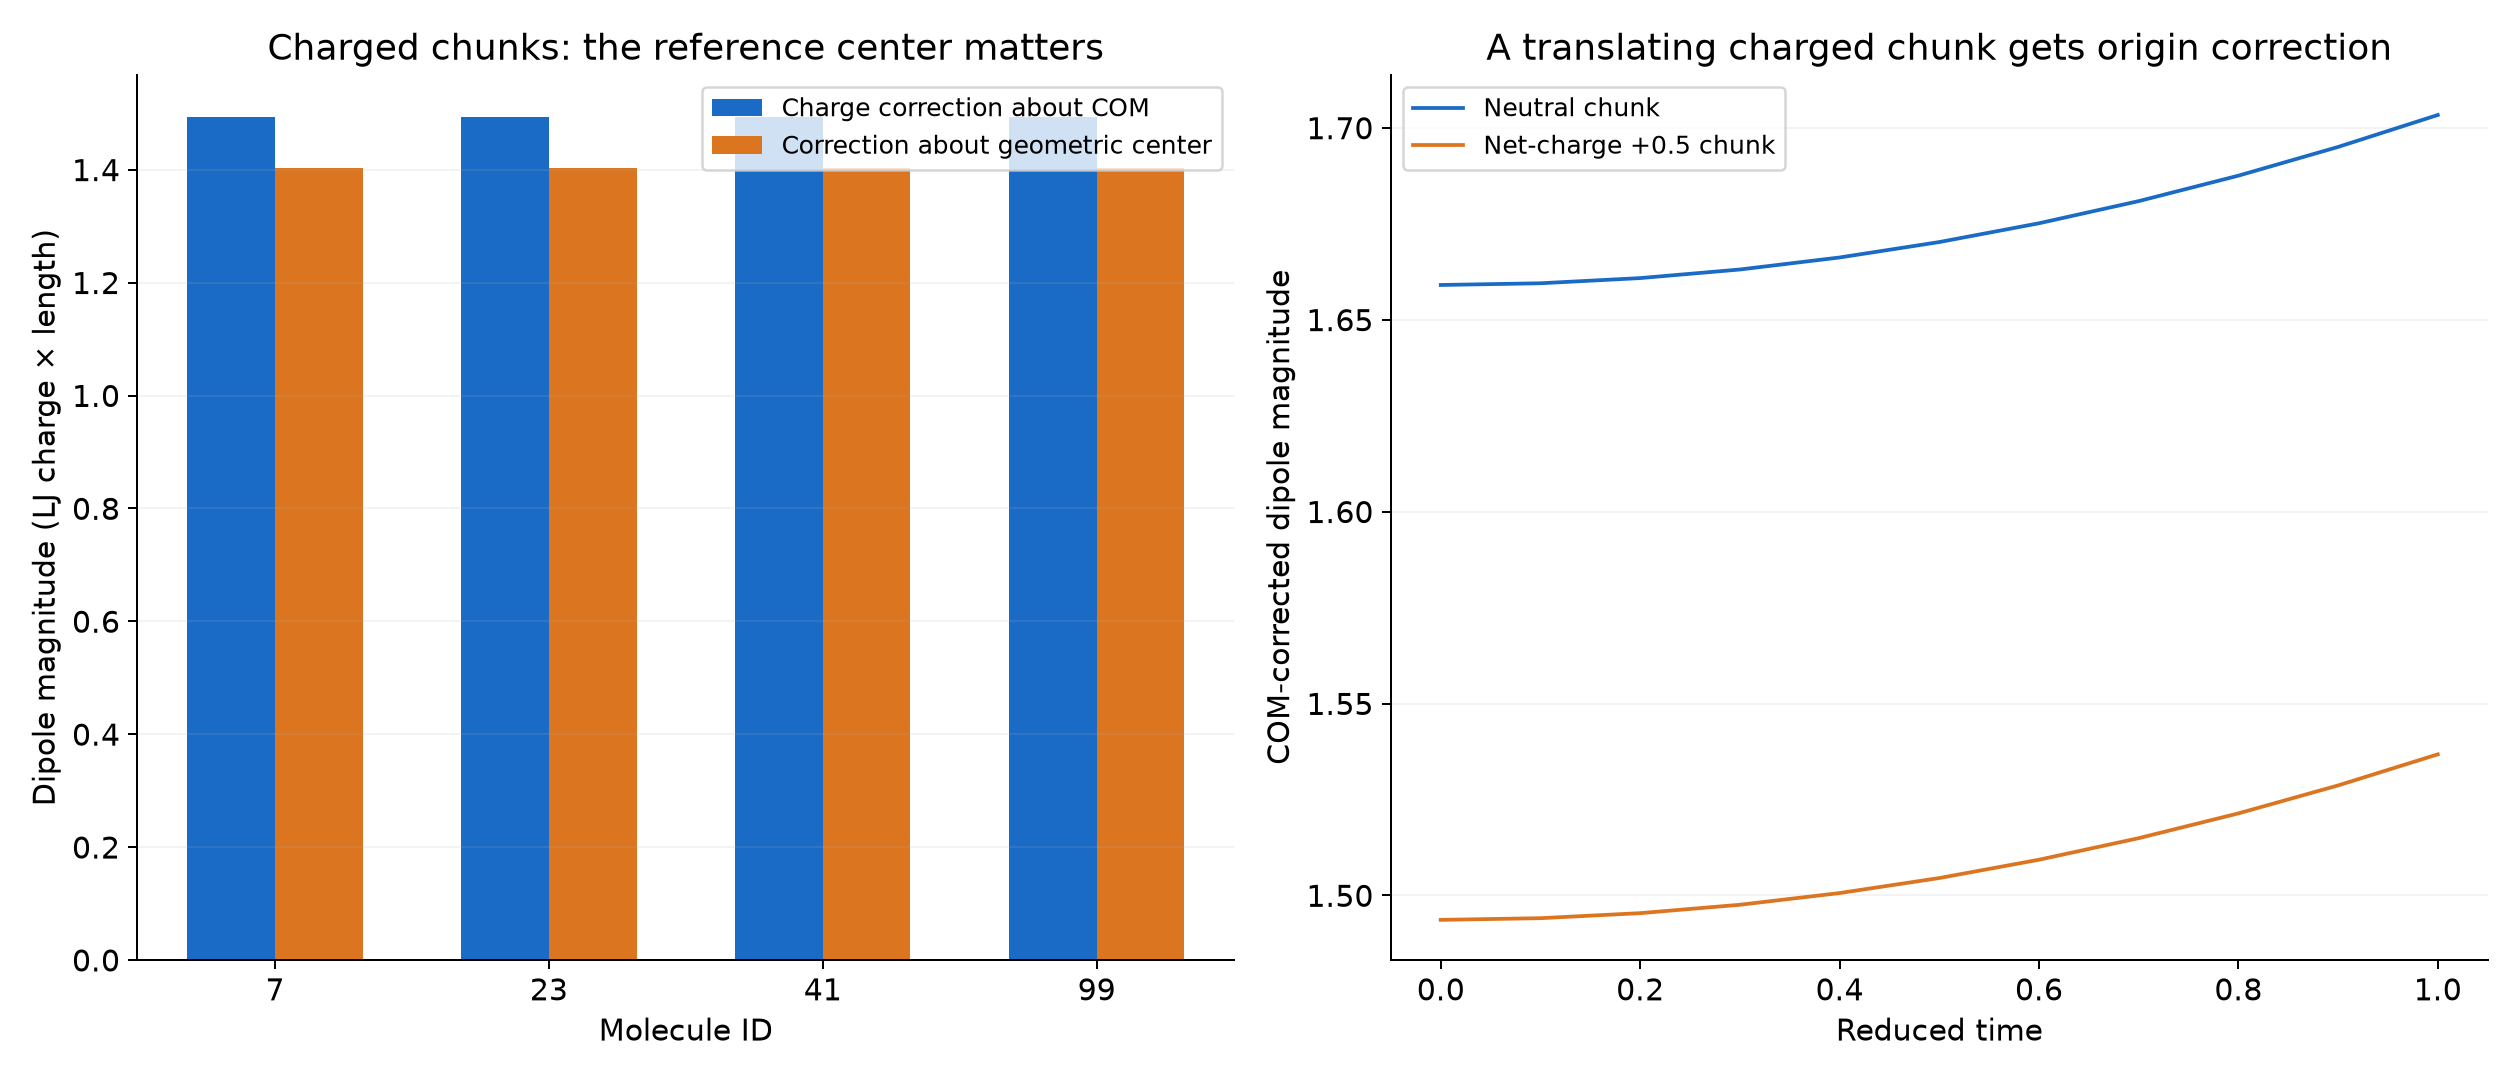
质量不等使质心与几何中心不同。四个组被放在盒内不同位置,初始修正后值一致,说明整体平移不应引入净电荷乘位置的额外漂移。但粒子相对运动会改变分布和偶极,修正不代表偶极随时间必须恒定。
这里电荷仅是统计标签,输入没有库仑势,不能将这条轨迹解释为真实带电分子的动力学;也不能把局域分组偶极直接当作周期晶体Berry-phase极化。
3 GPU包与KOKKOS的不同启动方式#
本例已在P100和V100 16G计算资源上分别运行GPU包与KOKKOS,使用GCC13.3、OpenMPI5.0.10、CUDA12.8构建;GPU包mixed精度,KOKKOS double精度。
**每条操作使用新的解压目录,并先申请对应Slurm资源。**同一份实例包可在分配到的P100 GPU资源中运行:
bash run-gpu.sh p100 gpu
V100 16G的KOKKOS资源中运行:
bash run-gpu.sh v100 kk
本例GPU包输入显式使用package gpu 1、newton off和lj/cut/gpu。KOKKOS使用:
package kokkos neigh half
newton on
atom_style full/kk
pair_style lj/cut/kk 2.5
pair_coeff * * 0.0 1.0
fix integration all nve/kk
run_style verlet/kk
启动时再加lmp -k on g 1 -in in.kk。run-gpu.sh已连接对应模块和命令。不能只把pair style换成/kk,却继续用普通atom style和默认Verlet。
统计compute中没有相应加速实现的部分仍可在CPU执行;选择GPU构建不等于所有统计操作都在GPU。本例零相互作用用于核对数据路径、分组和数值含义,不测试真实LJ受力精度或加速比。实际材料仍需使用有物理意义的势参数、先核对受力,再做性能比较。
4 按自己的任务调整#
保持molecule ID与image flags正确,再把分组统计命令加入已有可靠的材料输入。真实水体系需用匹配的电荷、力场和约束;TIP4P的负电荷位置与原子位置不同,应按实际势使用专门的dipole/tip4p/chunk,本教程没有把普通4点分组当作TIP4P实测。
参数定义见官方dipole/chunk;GPU资源、模块与提交完整流程看LAMMPS GPU使用指南。