
Phonopy MLP与SSCHA实操
用已训练的小型Si势运行两个随机种子的短SSCHA流程,读取自由能、抽样误差和力常数历史。
阅读本篇目录
下载拟合、声子与短SSCHA操作包。在已分配的CPU资源中,以普通账号解压到新目录:
unzip phonopy-optional-alm-mlp-sscha-wave246.zip -d phonopy-optional
cd phonopy-optional
bash setup.sh
bash run.sh
setup.sh按包内实际使用的Linux x86_64版本清单创建个人.env,不修改公共模块;需要联网下载conda-forge包和足够的个人目录空间。run.sh依次拟合ALM及多项式势,计算势函数声子,运行两组短SSCHA,再提取数据和画图。计算均使用1个CPU线程,不需要GPU;结果放在fit/、native/、analysis/、figures/,已有结果目录不覆盖。
可选环境使用Phonopy4.8.3、pypolymlp0.22.1、symfc1.7.3、Python3.11.18、NumPy2.4.6;由conda-forge预编译包组成,实际C/C++运行库libgcc/libstdcxx为16.2.0。ALM的conda包版本为2.0.0_dev.2,Python元数据显示1.2.0;这里的ALM是ttadano/ALM力常数拟合库,不要安装PyPI中同名的金融建模ALM0.0.1。绘图另用集群phonopy/4.8.3模块中的Matplotlib。
本例复用实际Si位移—力数据:Si16,晶格常数5.43 Å,共65个构型,其中48个训练、8个验证、8个独立测试以及1个平衡参考。标签来自此前集群实际运行的GPUMD5.9.1 Si NEP势计算,不是DFT标签。固定原子序、位移和数据划分,测试集不参与拟合或选参数。模型输出中的dataset_type: vasp是库的默认格式字段,不改变本例标签来源。
1 先准备模型和起始谐力常数#
run.sh先训练模型,并通过有限位移得到native/starting-harmonic.yaml。然后分别运行种子24601与24602。两个工作目录互相独立,避免覆盖:
ls native/sscha-24601/
ls native/sscha-24602/
cat analysis/sscha-iterations.csv
每组使用300 K、每次64个快照、3次迭代,保留全部力常数历史和最后一次数据集。这是短流程教学,不用它宣称收敛的温度重整化频率或材料自由能。
2 原生命令里哪些参数需要看懂#
需要单独重做一组SSCHA时,新建目录并复制模型,采用与脚本相同的参数:
mkdir manual-sscha
cp fit/polymlp.yaml manual-sscha/
cd manual-sscha
../.env/bin/phonopy-mlpsscha ../native/starting-harmonic.yaml \
  --temperature 300 --snapshots 64 --iterations 3 \
  --mesh 16 --random-seed 24601 \
  --save-dataset --all-force-constants -v
cd ..
--snapshots是每次迭代的构型数,不是MD步数;--random-seed使整个流程可复现,各迭代使用不同的派生随机种子。--mesh 16在此命令中是网格密度长度,本例实际得到5×5×5 q网格,不能写成16³。
每次迭代的顺序是:从当前谐分布采样构型,用多项式势计算能量和力,计算当前力常数对应的谐自由能与非谐修正,然后用新标签重新拟合力常数。需要足够好的势能面和采样,才有条件讨论物理结果。
3 读取实际自由能#
cat analysis/sscha-iterations.csv
下表单位均为meV/2Si原胞,自由能相对本模型平衡结构能量E0;不是相对孤立原子的形成自由能。误差列是固定当前力常数条件下的抽样均值标准误差:
| 种子 | 迭代1 F±误差 | 迭代2 F±误差 | 迭代3 F±误差 |
|---|---|---|---|
| 24601 | 60.1764±0.3538 | 60.4693±0.3227 | 60.2361±0.3080 |
| 24602 | 60.8571±0.2799 | 60.3998±0.3092 | 60.4705±0.3236 |
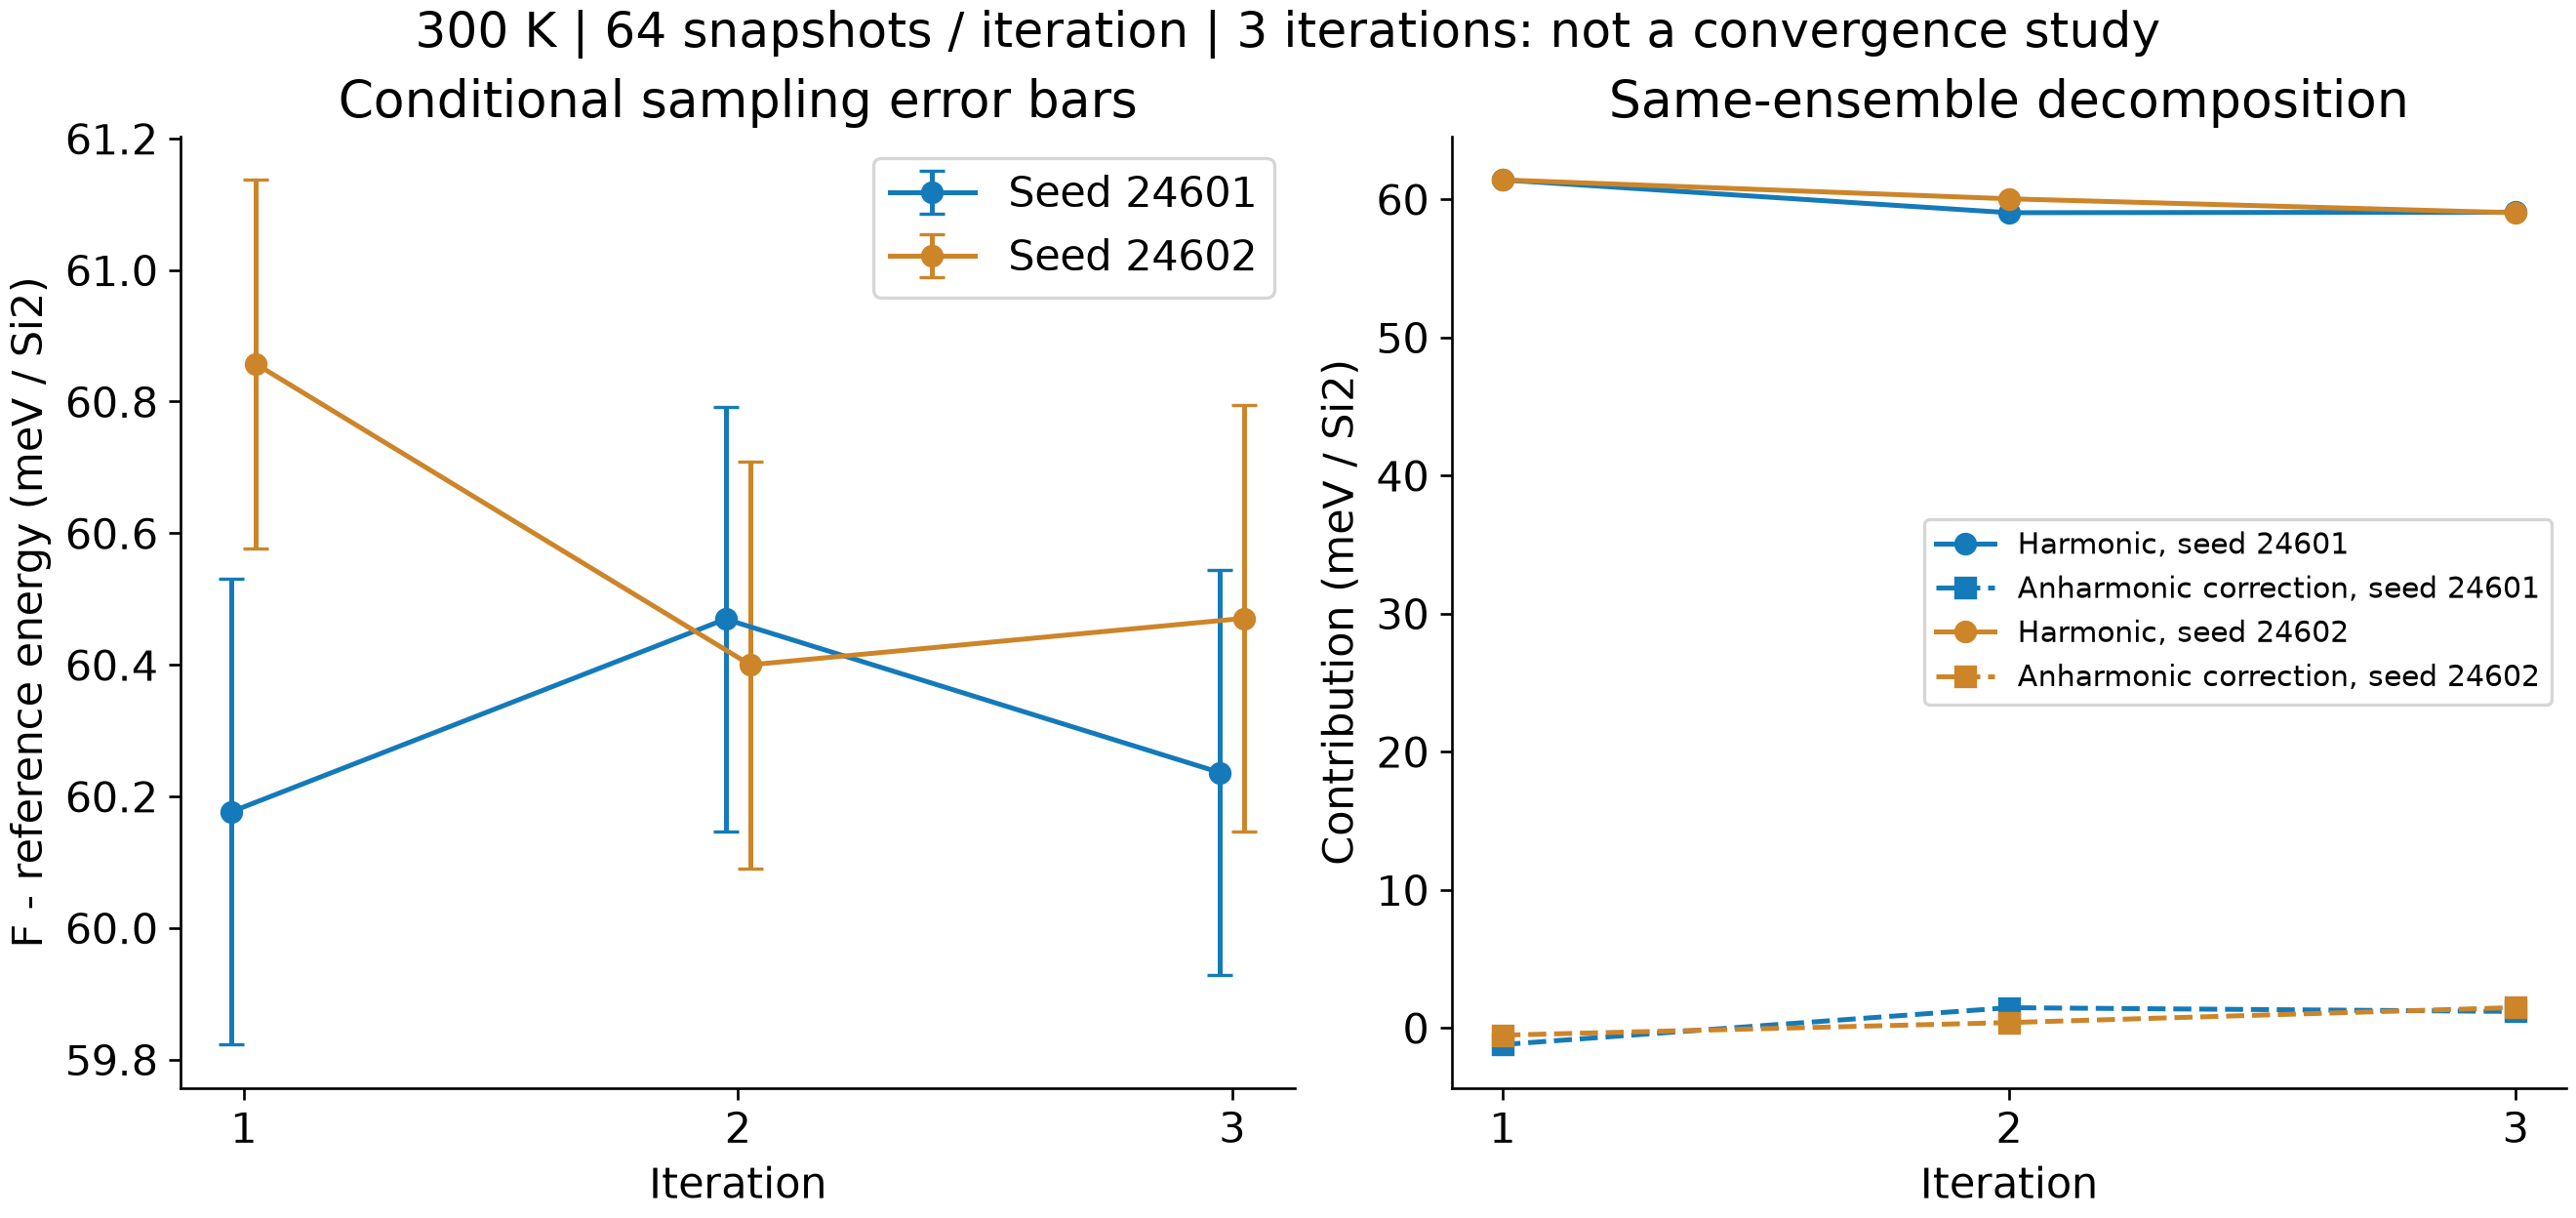
该误差不包含随机拟合力常数本身的不确定度。前几次迭代可能处于过渡段;3次迭代不足以证明已经达到稳态,更不能仅凭两个误差棒重叠就认为模型或温度性质收敛。
4 结果文件与正确的数据对应#
ls native/sscha-24601/mlpsscha.hdf5
ls native/sscha-24601/phonopy_mlpsscha_dataset.yaml.xz
mlpsscha.hdf5记录自由能、误差、模型参考能量、势能与谐势能均值、力常数及历史,单位属性为eV/primitive_cell。这里的FC2以紧凑2×16×3×3保存,并带p2s_map,不是缺少了14行;展开后是16×16×3×3。
历史力常数对应产生该次抽样分布的矩阵;最后保存的力常数已用最后一次标签重新拟合。重建F=F_harm+⟨V−V_harm⟩时,谐项和抽样必须属于同一套力常数,不能拿最终重拟合矩阵拼接前一次抽样。
最后一次压缩YAML含64个16Si构型及势函数力。analysis/sscha-24601-last-samples.npz保留这些构型对应的位移、力和能量;analyze.py重新用模型求力,并从同一抽样独立重建均值和标准误差。无需重新跑DFT。
5 检查模型是否覆盖热采样范围#
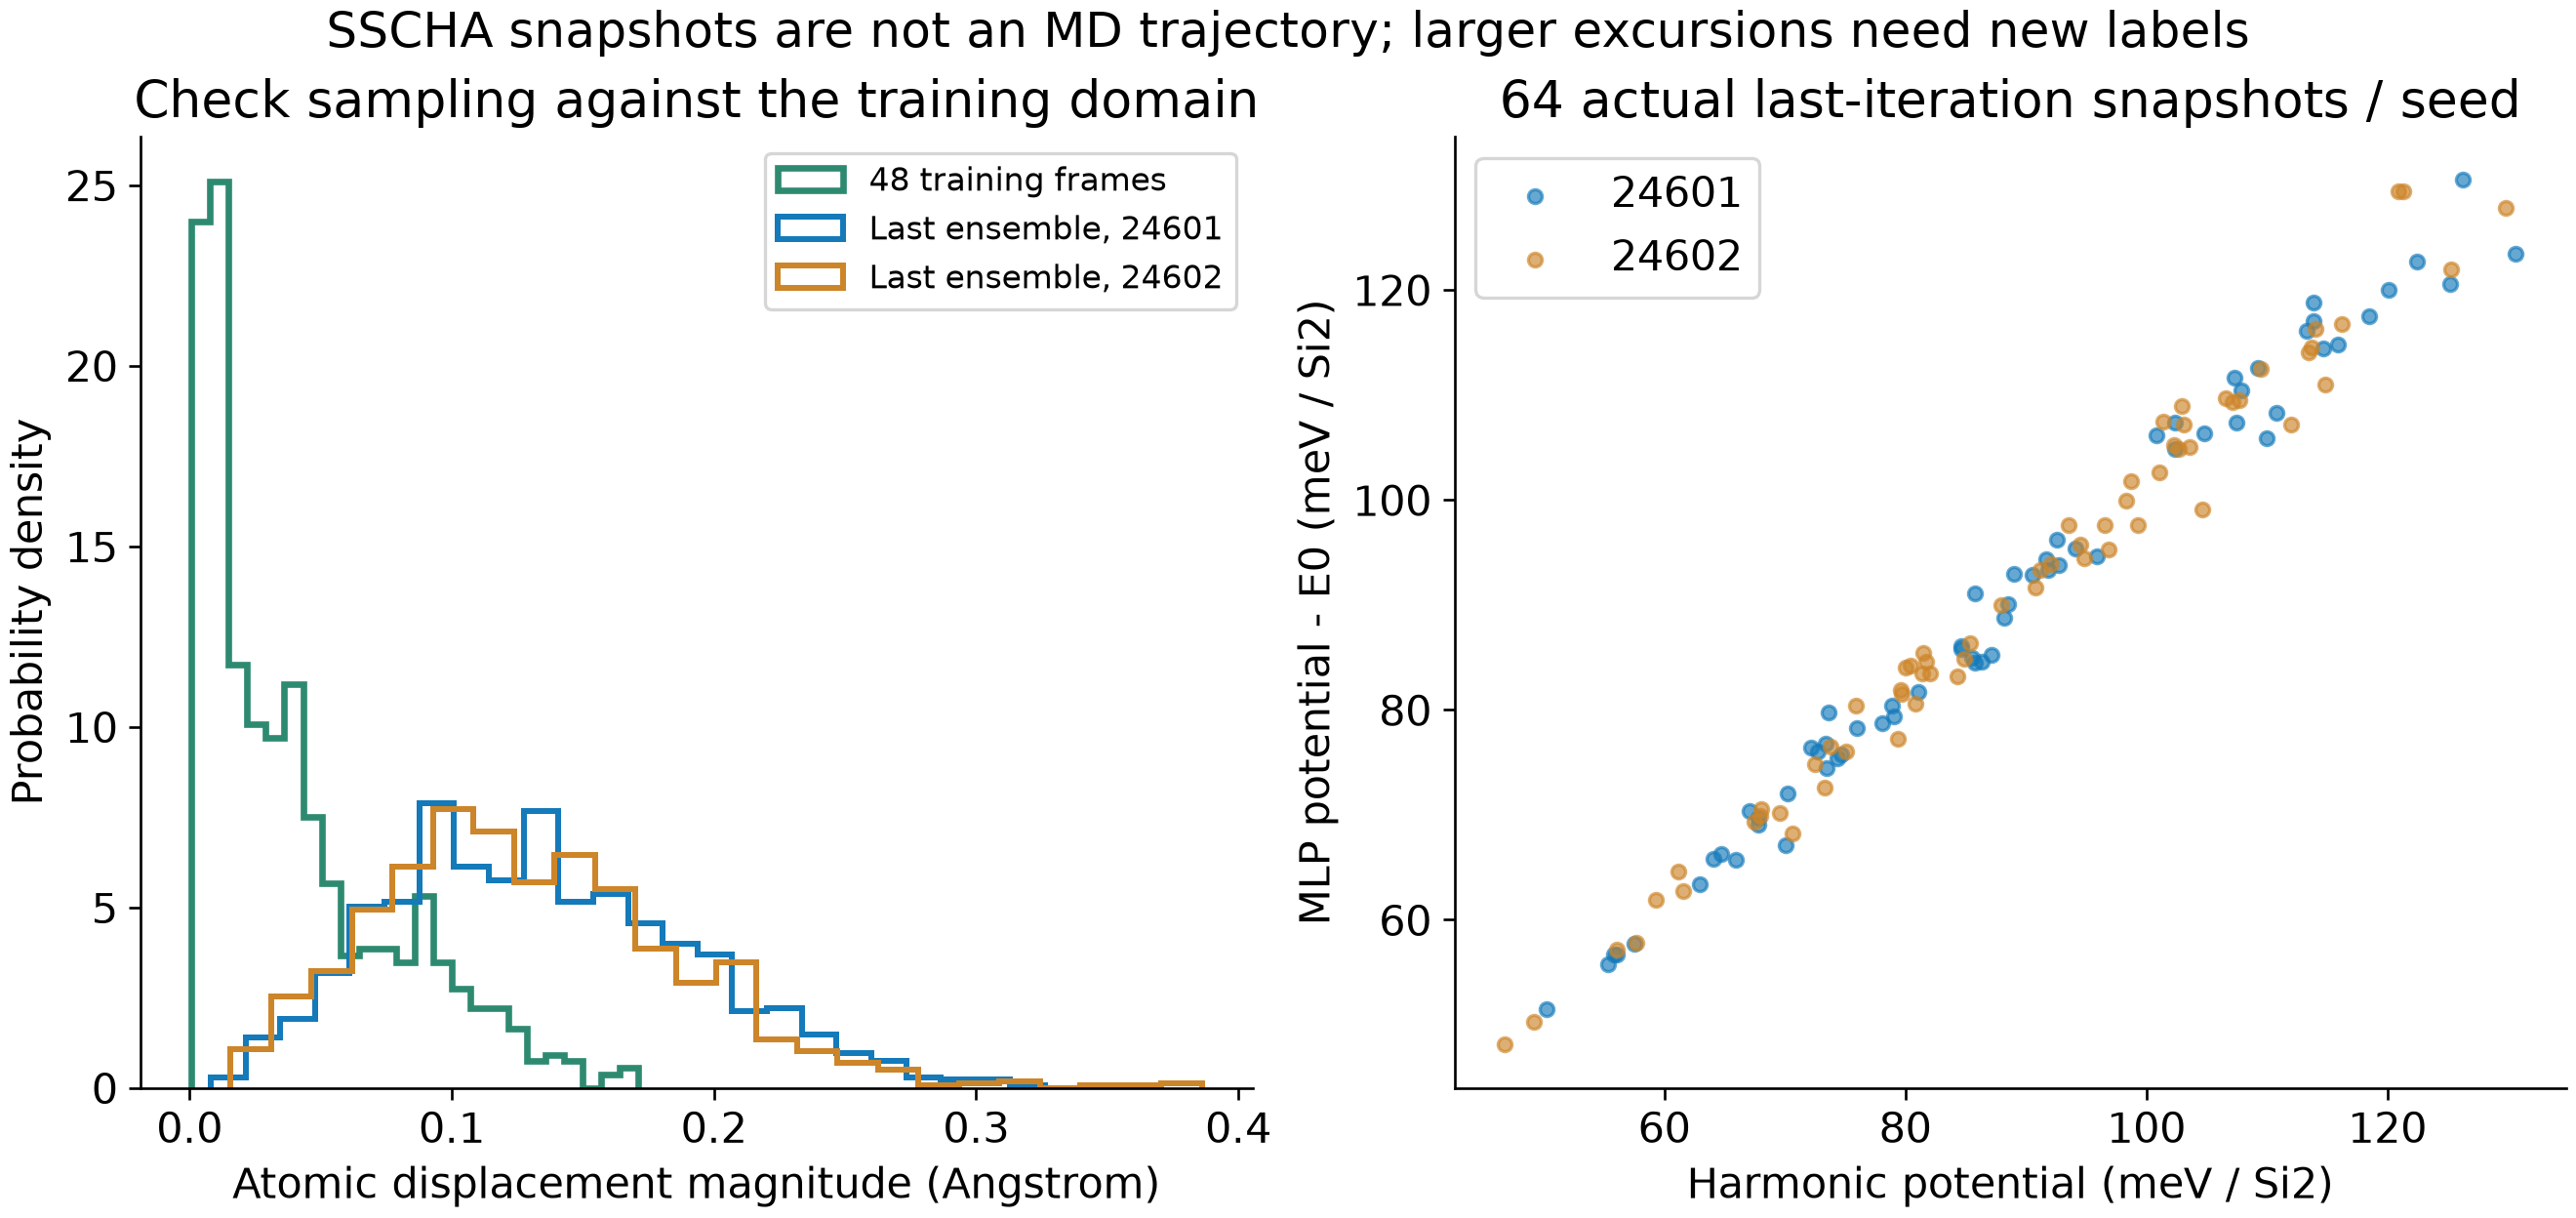
本例热采样的一部分位移明显超过训练数据的范围。因此这些数据适合学习命令、文件与统计流程,不能据此认定Si高温势能面已可靠。实际项目应补充对应温度、体积和较大位移的可信能量—力标签,重新训练并检查独立测试,再比较快照数、迭代数、超胞与q网格。
SSCHA快照不是连续时间轨迹,不能把相邻快照用于扩散系数或时间自相关。势训练和谐声子步骤见多项式势训练与声子;与QHA的不同之处可结合原生QHA热膨胀阅读。方法与新命令说明见Phonopy温度相关力常数文档,命令以实际4.8.3环境为准。