
MACE与ASE结构优化、分子动力学
用Si八原子模型做固定晶胞原子优化和短NVE,并解释力阈值、时间步长及能量漂移。
阅读本篇目录
下载本专题输入、Si实算数据、教学模型与工具(ZIP)。这里使用自己训练的 scratch64-s13 模型。结构和轨迹来自MACE势能面,不是每一步都调用VASP。
1 运行优化与NVE#
bash calculate.sh ase
cat work/ase/RESULTS.json
脚本先把Si八原子测试构型做BFGS优化,再从原始同一构型独立启动NVE。这样可以与LAMMPS联用使用完全相同的MD初态。
cat work/ase/BFGS.log
cat work/ase/NVE.log
head -n 5 work/ase/relaxed.xyz
2 原子位置优化与晶胞优化不同#
本例只优化原子位置,晶胞向量保持固定。实际核心代码为:
from ase.io import read
from ase.optimize import BFGS
from mace.calculators import MACECalculator
atoms = read("data/Si8-test.POSCAR")
atoms.calc = MACECalculator(model_paths="models/scratch64-s13.model",
                            device="cpu", default_dtype="float64")
BFGS(atoms, logfile="BFGS.log").run(fmax=0.02, steps=200)
fmax=0.02 的单位是eV/Å,指最大原子力范数,不是某一个笛卡尔分量。这个小例子最终为0.00788 eV/Å。需要连晶胞一起优化时,应另外使用ASE晶胞过滤器,并先确认模型应力精度;不能把上面几行当成变胞优化。
3 NVE关键设置#
from ase import units
from ase.md.verlet import VelocityVerlet
from ase.md.velocitydistribution import MaxwellBoltzmannDistribution, Stationary
import numpy as np
MaxwellBoltzmannDistribution(atoms, temperature_K=300,
                            rng=np.random.default_rng(260040))
Stationary(atoms)
dyn = VelocityVerlet(atoms, 0.5 * units.fs, logfile="NVE.log")
dyn.run(20)
完整脚本在 practical.py。实际质量统一设为28.085,初始速度分布使用固定种子;去掉质心运动后,不额外强制缩放成恰好300 K。300 是初始速度分布参数,NVE过程中没有恒温器。
4 观察能量与轨迹#
bash run.sh
cat analysis/NVE.csv
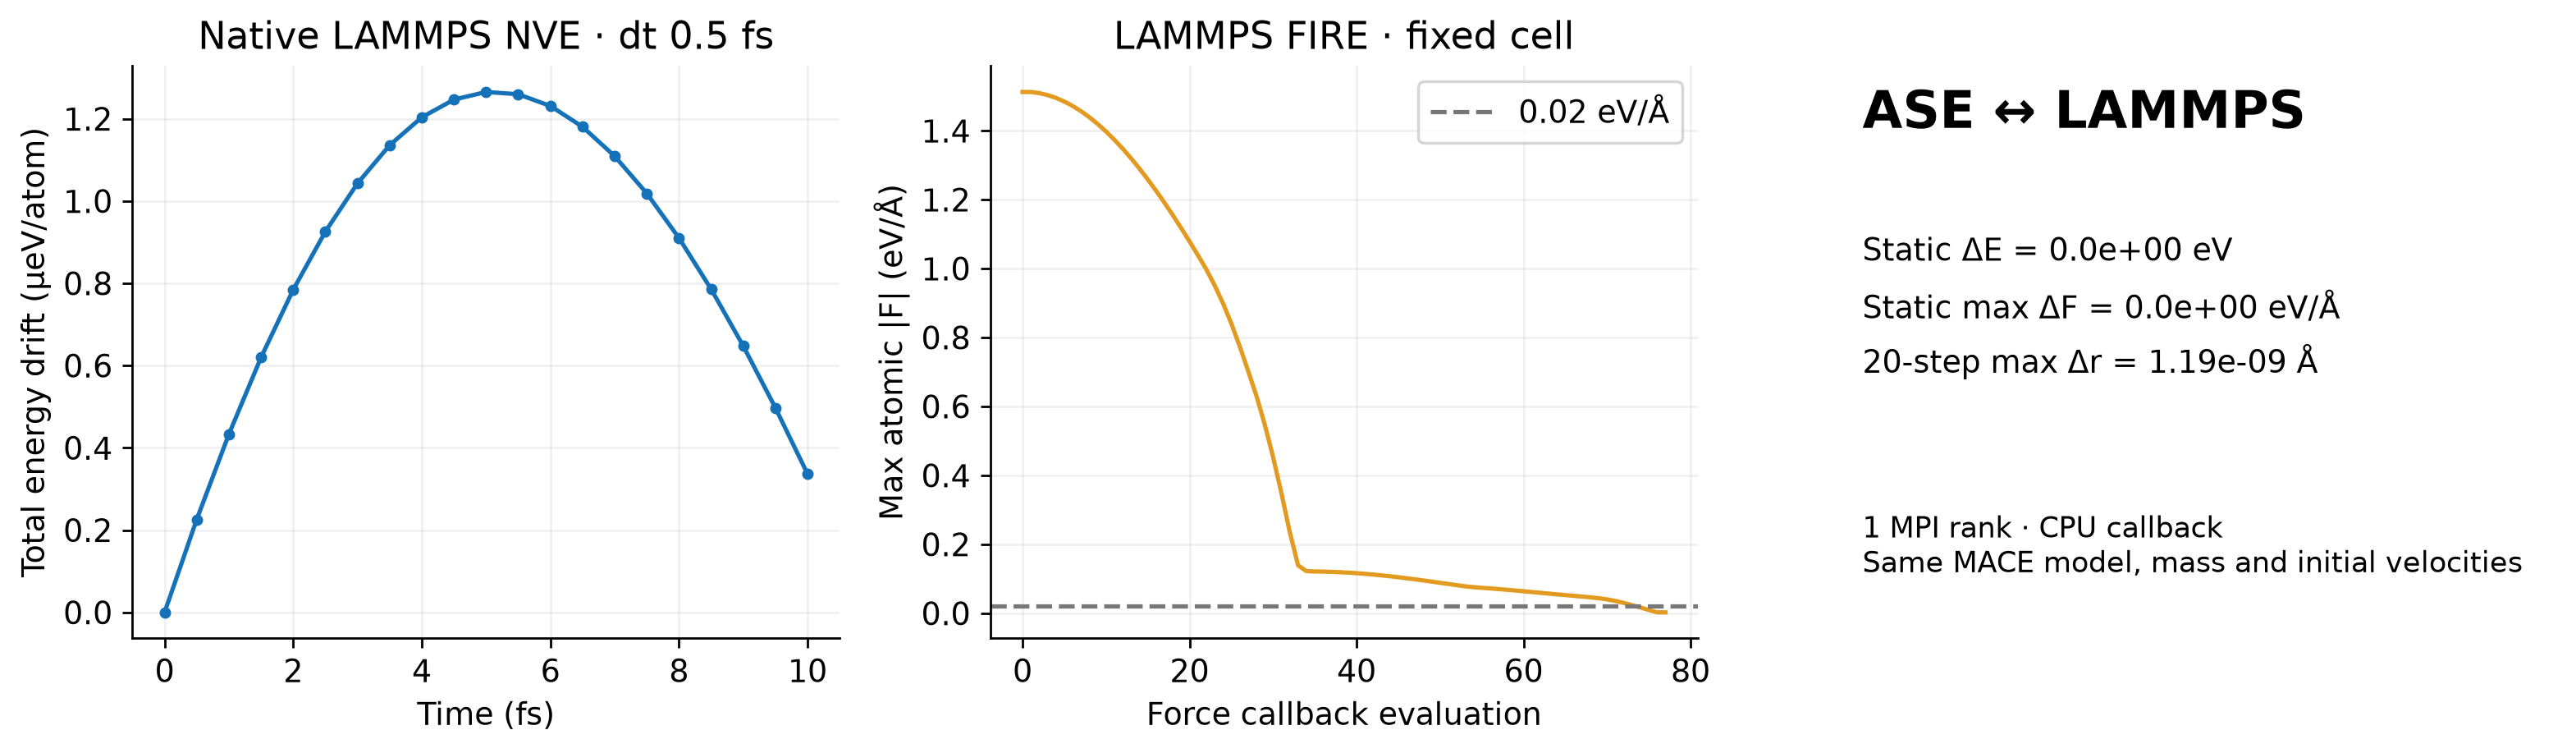
图左为同模型、同初态的原生LAMMPS 20步NVE,时间步0.5 fs,总长10 fs;最大总能量漂移约 1.27E-6 eV/原子。ASE与LAMMPS在20步末的最大坐标差为 1.19E-9 Å。中图为LAMMPS固定晶胞FIRE,右侧为两程序的静态和轨迹对照。
这个短轨迹用于理解积分与程序衔接,不用于提取扩散系数、热导率、相变温度或长时间稳定性。正式MD需要更大的数据覆盖、平衡过程和足够长采样。ASE接口官方说明提供了其他积分器的用法。
需要根据你的体系选择资源?联系讨论计算需求。实际可用软件与权限,以当前账户和运行环境为准。